근처 검색: Geohash vs 공간 인덱스
위치 기반 앱의 근처 검색, Geohash와 공간 인덱스 비교: 벤치마크, PostGIS 예제, 반경 vs 등시선 트레이드오프와 추천 선택지를 정리했습니다.
 Marcus Rodriguez
누군가 위키백과를 보여주는 사이트를 만들었습니다. 다만 지금 서 있는 곳에서 걸어서 30분 안에 있는 것들에 관한 문서만 보여 줍니다. 재미있는 아이디어라 입소문을 탔고, 위치 인식 애플리케이션이 결국 맞닥뜨리는 문제를 이야기하기에도 완벽한 계기입니다. 바로 geohash vs 공간 인덱스, 그리고 수백만 행에서 '이 지점 근처에 뭐가 있지?'라는 질문에 답해야 할 때 반경과 등시선 중 무엇을 택할지라는 더 깊은 질문입니다.
이 쿼리는 셀 수 없이 많이 만들어 봤습니다. 식당 찾기, 자산 추적, 거의 데이터베이스를 쓰러뜨릴 뻔한 배달 반경 기능까지요. 누구나 처음 쓰는 순진한 버전은 WHERE 절에 거리 공식을 넣은 전체 테이블 스캔입니다. 개발 환경의 500행에서는 잘 동작하지만 운영 환경의 500만 행에서는 무너집니다. 그래서 실제로 규모를 견디는 두 가지 접근법, 즉 geohash 기반 버킷팅과 PostGIS의 GiST 같은 제대로 된 공간 인덱스를 비교해 보겠습니다. 대부분의 경우 한쪽이 이기는데, 어느 쪽인지 알려 드리겠습니다.
모두가 처음 쓰고 나중에 후회하는 쿼리
영어 위키백과만 해도 백만 개가 넘는 지오코딩된 문서가 있고, 모든 문서는 page나 geo_tags 테이블에 위도와 경도를 가지고 있습니다. 여러분의 데이터셋은 매장, 사용자, IoT 센서 등 무엇이든 될 수 있습니다. 순진한 쿼리는 다음과 같습니다:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
이것은 하버사인 공식이며, 계산 자체는 정확합니다. 하지만 인덱스를 탈 수 없습니다. 데이터베이스는 요청마다 모든 행에 대해 삼각함수를 계산해야 합니다. 얼마 전 벤치마크한 백만 행 테이블에서 Postgres 웜 캐시 기준으로 쿼리당 약 800ms가 나왔습니다. 데모로는 괜찮지만, 초당 50 요청이면 매초 40초어치 계산을 해야 하는 셈이라 재앙입니다. 큐가 쌓이고 커넥션이 몰리면서 어느새 장애 채널의 주인공이 되어 있을 겁니다.
두 가지 실질적인 해법은 같은 트릭을 씁니다. 비싼 행별 거리 계산을 저렴한 후보 필터로 바꾸는 것입니다. 인덱스로 백만 행을 수백 개의 후보로 줄인 다음, 그 소수에만 정확한 거리 계산을 수행합니다. Geohash와 공간 인덱스는 이 후보 필터링을 하는 두 가지 다른 방법입니다. 이것이 우리가 비교해야 할 핵심입니다.
Geohash는 지리 정보를 문자열 접두사로 바꿉니다
Geohash는 위도/경도 쌍을 지구를 반복해서 이등분하여 짧은 문자열로 인코딩합니다. 문자를 하나 추가할 때마다 셀 크기가 절반이 됩니다. 「u4pruydqqvj」는 런던의 벤치 하나이고, 「u4pruyd」는 그 벤치를 포함하는 약 150m 정사각형, 「u4p」는 런던 남부 절반을 포함하는 약 40km 정사각형입니다. 아름다운 점은 가까운 점들이 문자열 접두사를 공유한다는 것이고, 접두사 매칭은 평범한 B-트리 인덱스가 아무 노력 없이 잘하는 일입니다.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
작업 흐름은 이렇습니다. 쓰기 시점에 각 행의 geohash를 계산합니다(순수 함수라 마이크로초 단위). 조회 시점에는 반경과 대략 맞는 정밀도에서 내 지점을 덮는 geohash 셀을 계산하고, 그 셀의 인접한 8개 이웃도 함께 계산합니다. 이 부분을 사람들이 종종 잊는데, 셀 경계 근처의 점은 경계 너머에 이웃이 있기 때문입니다. 접두사로 후보를 거른 뒤 살아남은 것에 정확한 하버사인을 적용합니다. 백만 번의 거리 계산이 수백 번 정도로 줄어듭니다.
이 방식의 장점은 이식성입니다. Geohash 접두사 쿼리는 문자열을 인덱싱하는 어떤 시스템에서도 동작합니다. DynamoDB 정렬 키, Elasticsearch, Redis 정렬 집합(GEOADD가 내부적으로 쓰는 방식으로, ZSET에 geohash 인코딩 점수를 저장합니다), SQLite, 디스크의 정렬된 파일 등이 그렇습니다. 확장도 필요 없고 특수한 컬럼 타입도 필요 없습니다. 인프라가 NoSQL 저장소이거나 공간 기능이 없는 관리형 서비스라면 geohash가 사실상 유일한 현실적 선택인 경우가 많습니다. 또한 샤딩이 매우 쉬워서 위치 데이터를 여러 노드에 나눠 저장하는 시스템에서 자주 등장합니다.
단점도 분명합니다. 정밀도가 양자화되어 있습니다. 반경을 포함하는 조금 큰 셀을 고르고 초과 조회를 감수하거나, 더 작은 셀을 고르고 접두사 쿼리를 더 많이 날려야 합니다. 셀 크기는 위도에 따라 왜곡되기도 합니다. 5자 셀은 가로보다 세로가 훨씬 길고, 적도에서 멀어질수록 가로세로 비율이 달라집니다. 게다가 비정규화된 컬럼을 직접 관리해야 하므로 업데이트 일관성 문제도 따라옵니다. 문자열 인덱스 위에 얹은 영리한 꼼수이고, 실제로 그 꼼수처럼 동작합니다.
공간 인덱스: PostGIS GiST와 R-트리 계열
대안은 데이터베이스가 기하 구조를 네이티브로 이해하게 하는 것입니다. PostGIS는 Postgres에 geography 타입과 그 위의 GiST(일반화된 검색 트리) 인덱스를 제공합니다. 내부적으로는 경계 상자를 계층적으로 중첩하는 R-트리입니다. 쿼리는 민망할 정도로 단순해집니다:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;ST_DWithin은 인덱스를 직접 사용합니다. 직접 관리해야 하는 후보 후 정제 단계도, 이웃 셀 로직도, 정밀도 튜닝도 없습니다. geography가 지구의 모양을 고려하므로 데이터베이스가 경계 상자 사전 필터와 정확한 타원체 거리 계산을 하나의 연산자로 처리하며, 미터 단위 의미도 정확합니다. 백만 행 테이블에서 제가 직접 전후를 비교해 보니, 같은 반경에서 하버사인 스캔의 800ms가 GiST 인덱스의 약 4ms로 줄었습니다. 튜닝으로 얻은 개선이 아니라 아예 다른 종목의 경기입니다.
속도 외에도 정확성은 덤으로 얻고, 조합 가능성이라는 보너스도 따라옵니다. 원 대신 '이 다각형 안'을 원하면 ST_Intersects를 씁니다. 경로 선 주변에 버퍼를 원하면 선분에 대해 ST_DWithin을 씁니다. 반경을 미리 모르고 K-최근접 이웃을 원하면 GiST 인덱스와 함께 쓰는 <-> 연산자가 인덱스 순서대로 KNN을 수행합니다. 이는 지역 위키백과 사이트가 구현한 '근처에 25개 미만? 그러면 6마일 안에서 가장 가까운 25개를 보여준다'는 동작에 정확히 필요한 기능입니다. geohash 접두사 위에 계층형 대체 로직을 쓰면 여러 반경 시도를 손으로 짜야 하지만, KNN에서는 인덱스를 계속 훑는 쿼리 하나면 됩니다.
대가는 의존성입니다. Postgres와 PostGIS 확장이 필요합니다(지금은 관리형 Postgres 대부분에 기본 포함되어 있습니다. RDS, Cloud SQL, Supabase 모두 제공합니다). 또는 MySQL의 공간 기능(작동은 하지만 거친 부분이 있고 역사적으로 인덱싱이 약함), 또는 SpatiaLite가 붙은 SQLite를 쓸 수 있습니다. 운영 부담도 따릅니다. SRID를 맞춰야 하고, 쓰기는 조금 무거워지며, 작은 테이블에서는 플래너가 공간 인덱스를 실제로 쓰도록 살짝 떠밀어 줘야 할 때도 있습니다.
벤치마크와 솔직한 트레이드오프 표
이런 종류의 작업에 대해 최근 다시 돌린 벤치마크 수치입니다. 120만 개 점(대략 위키백과 지오코딩 문서 규모), Postgres 16, 도시 무작위 좌표에서 3km 반경 쿼리, 웜 캐시 기준입니다:
- 전체 테이블 하버사인 스캔: 약 800ms. 경고용 사례로만 포함했습니다.
- Geohash 접두사(5자 셀 + 이웃 8개) + 하버사인 정제: 중앙값 약 12ms, 하지만 도심처럼 밀집된 지역에서 셀이 과다 조회되면 p95가 약 40ms까지 올라갑니다.
- PostGIS GiST와 ST_DWithin: 중앙값 약 4ms, p95 약 8ms이며, 밀도가 올라가도 거의 평평합니다.
- 가장 가까운 25개를 위한 PostGIS KNN (
<->): 약 2ms이며, 반경을 몇으로 정했을지는 신경 쓰지 않습니다. - Redis GEOSEARCH (내부적으로 geohash 사용): 1ms 미만이지만, 전체 데이터셋이 RAM에 올라가야 하고 캐시일 뿐 원본 데이터 저장소가 아닙니다.
하드웨어와 데이터 형태에 따라 결과는 달라질 수 있지만, 제가 해 본 모든 테스트에서 순서는 일관되었습니다. 공간 인덱스 < B-트리 위의 geohash < 원시 스캔. geohash 방식의 약점은 가장 중요한 곳, 즉 사용자가 몰리고 한 셀에 하버사인으로 다시 검사해야 할 후보가 수만 개씩 들어가는 도심 핵심부에서 정확히 드러납니다.
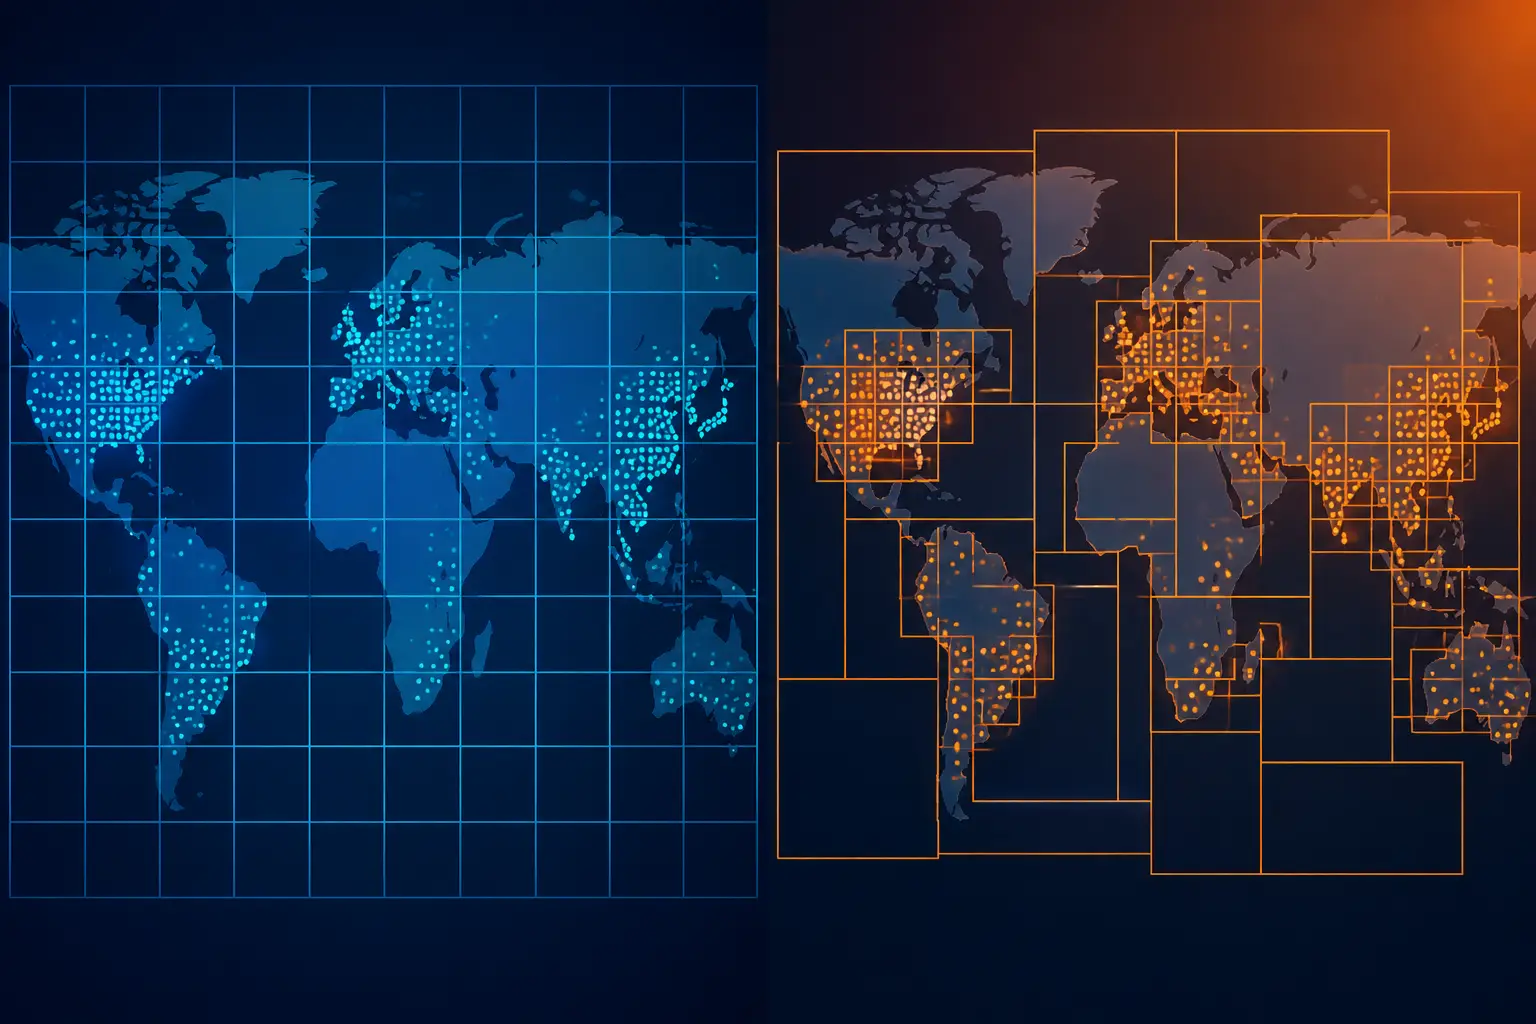
Geohash가 만회하는 지점은 데이터베이스 바깥의 운영 단순성입니다. 읽기 경로가 Redis(1ms 미만 GEOSEARCH)이거나 DynamoDB(geohash 접두사를 정렬 키 조건으로 사용)이거나, 정적 데이터셋을 엣지에 올리고 브라우저에서 JavaScript 문자열 접두사로 조회하는 경우에는 geohash가 타협이 아니라 아키텍처 그 자체입니다. '지역 발견' 사이드 프로젝트 중 여럿이 이런 방식으로 완전히 클라이언트에서 동작합니다. 이 패턴은 제가 인터넷에서 작은 웹이 가장 좋은 부분인 이유에서 다뤘던 작은 자체 완결형 웹 프로젝트와 잘 어울립니다. 정적 사이트, 미리 계산된 인덱스, 서버 제로입니다.
반경 vs 등시선: 실제로 제공하는 추상화
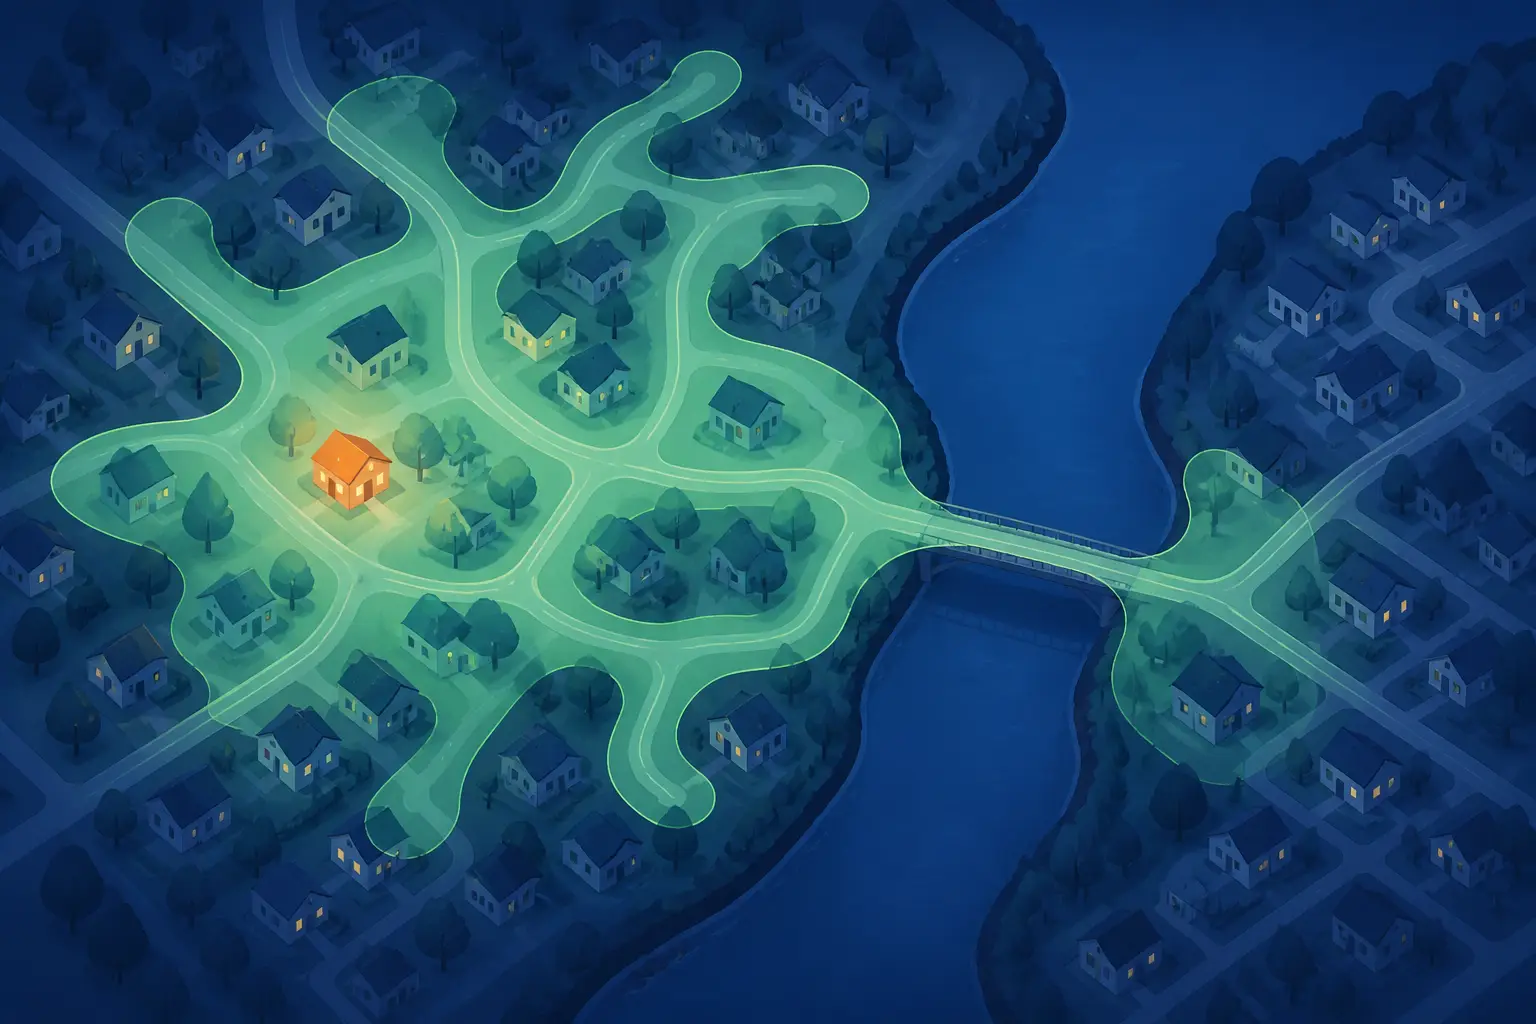
지역 위키백과 프로젝트가 살짝 놀림을 받은 이유가 바로 이것입니다. '걸어서 30분'이라고 해 놓고 실제로는 직선거리 3km 원을 그립니다. 다리 없는 강, 고속도로, 울타리 쳐진 철도 야드, 원은 그런 것을 모릅니다. 진짜 30분 도보 범위는 등시선, 즉 실제 보행 네트워크를 따라 30분 안에 도달할 수 있는 모든 곳을 나타내는 불규칙한 영역입니다. 직선으로 1km 떨어진 두 점도 사이에 하구가 있으면 도보로는 40분 떨어져 있을 수 있습니다.
등시선을 계산하려면 라우팅 엔진이 필요합니다. OSRM, Valhalla, GraphHopper 같은 도구로 OpenStreetMap 데이터를 처리하고, 이동 시간이 예산에 도달할 때까지 내 지점에서 최단 경로 트리를 확장한 뒤, 도달 가능한 영역을 등고선처럼 그려 다각형을 만듭니다. 지역별로 그래프 전처리에 몇 분이 걸리고 쿼리당 수십 밀리초가 걸리는데, 원은 마이크로초면 됩니다. 하지만 다각형을 얻은 뒤의 포함 여부 쿼리는 그냥 ST_Intersects이고, 같은 공간 인덱스가 훌륭하게 처리합니다. 이것은 공간 인덱스 진영이 더 멀리 앞서 나가는 경우 중 하나입니다. 다각형이 1급 시민이지만, geohash 접두사 기법은 임의의 모양에서는 정말 어색해집니다. 다각형을 여러 셀로 덮어야 하는데, 가능은 하고 Z-order나 S2 라이브러리도 있지만 그 자체로 프로젝트가 됩니다.
제 솔직한 생각은 이렇습니다. 대부분의 제품에서는 원이 올바른 거짓말입니다. 사용자는 보행 모델을 감사하지 않고, 결과가 빠르고 대략 합리적인지만 봅니다. '3km 이내'는 '근처'와 충분히 잘 맞아서, 콘텐츠 탐색 기능에 라우팅 엔진의 추가 인프라를 정당화하기 어렵습니다. 배달 예상 도착 시간, 택배 배차, 응급 대응 범위처럼 결과가 따르는 약속을 하는 순간 원은 부채가 되고 등시선이 비용을 회수합니다. 추상화는 틀렸을 때 돈을 잃는지, 아니면 약간 놀라는 정도인지에 따라 고르세요.
데이터 확보: 지오코딩된 위키백과와 주소 검색
이런 방향으로 무언가를 만들고 싶다면 데이터 작업은 생각보다 훨씬 접근하기 쉽습니다. 위키백과 좌표는 GeoHack 템플릿 시스템에서 오며, MediaWiki API의 list=geosearch 엔드포인트로 조회할 수 있습니다. 이 엔드포인트 자체가 공간 인덱스 위의 반경 쿼리이고, 프로젝트의 '근처' 기능이 감싸고 있는 부분입니다. 다국어나 문서가 아닌 엔티티가 필요하다면 Wikidata의 P625(좌표 위치) 속성이 영어 위키백과보다 훨씬 넓게 다룹니다. 주소 조회는 이 프로젝트가 OpenStreetMap의 Nominatim 데이터를 기반으로 만든 Elasticsearch 기반 지오코더 Photon을 씁니다. 직접 호스팅은 무료이고, 너그러운 사람들이 운영하는 공개 데모 엔드포인트도 있지만 운영 환경에서는 과하게 두드리면 안 됩니다.
가져다 쓸 만한 설계 결정 하나: 이 사이트는 위치 정보를 브라우저에만 보관하고 공유 가능한 URL에는 절대 넣지 않습니다. 올바른 기본값이며, 피트니스 앱이 위치 데이터와 OPSEC에 대해 가르쳐 주는 것과 같은 교훈입니다. 사용자의 좌표는 앱이 보관하는 문자열 중 가장 민감한 것이고, 이를 보호하는 가장 저렴한 방법은 서버로 아예 보내지 않는 것입니다. 지오코딩은 클라이언트에서 하거나, 브라우저가 직접 통신하는 제3자 지오코더를 쓰세요. 무언가를 꼭 로그로 남겨야 한다면 반올림한 좌표만 남기면 되고, 그러면 개인정보 보호 태세는 자연스럽게 갖춰집니다.
'반경과 무관하게 가장 가까운 N개'를 위한 대체 로직으로 반경 확장 재시도 루프를 구현하고 싶은 충동은 참으세요. PostGIS의 KNN 연산자가 인덱스 쿼리 하나로 처리합니다:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
이 한 줄이 많은 코드베이스에서 보이는 '3km, 그다음 6km, 그다음 10km' 재시도 사다리 전체를 대체합니다. 그리고 사다리를 한 번 도는 것보다 빠릅니다.
추천
이 비교에서 한 가지만 가져가야 한다면 이것입니다. PostGIS와 GiST 인덱스로 시작하고, 저장소 계층이 강제할 때만 geohash를 집으세요.
이유는 간단합니다. 공간 인덱스는 중앙값 지연 시간에서 이기고, 밀집 지역의 p95에서는 더 크게 이기며, 정확성에서도 이깁니다(미터 단위 타원체 거리, 셀 경계 버그 없음). 기능에서도 이기고(다각형, KNN, 등시선 포함 여부가 모두 한 줄), 직접 작성하고 유지보수할 코드도 적습니다. geohash 방식은 이웃 셀 계산, 정밀도 선택, 두 단계 필터를 정확히 구현해야 하며, 그렇게 해도 여전히 더 느린 성능을 얻기 위해 틀릴 수 있는 세 군데를 만들게 됩니다.
Geohash가 제 자리를 얻는 경우는 정확히 세 가지입니다. 데이터 저장소에 공간 기능이 없을 때(DynamoDB, 순수 Redis, CDN의 정적 JSON 파일), 노드 간 위치 기반 샤딩이 필요할 때, 또는 쿼리를 클라이언트로 밀어내고 의존성을 제로로 두고 싶을 때입니다. 이런 경우에는 이웃 셀 계산을 직접 짜기보다 검증된 라이브러리를 쓰세요. Node에서는 ngeohash, Python에서는 python-geohash, 다각형을 덮어야 하면 S2 geometry가 있습니다.
제품 측면에서는 이렇게 하세요. 먼저 원을 출시하고, 정직하게 이름 붙이세요('걸어서 30분'이 아니라 '3km 이내'). 반경은 설정 가능하게 만드세요. 시골 사용자와 도시 사용자는 밀도가 전혀 다른 세계에 살기 때문입니다. 직선거리 거짓말이 측정 가능한 비용을 치르게 되는 순간에만 등시선으로 넘어가세요. 지역 위키백과 프로젝트는 최고의 기능이 종종 친근한 아이디어를 입은 좋은 공간 쿼리일 뿐이라는 것을 보여 주는 멋진 사례입니다. 백만 개의 문서, 하나의 인덱스, 잘 고른 하나의 반경. 그러면 인터넷에서 가장 큰 백과사전이 마치 당신의 동네에 대해 쓰인 것처럼 느껴지기 시작합니다.