Geohash ou index spatial : la recherche de proximité
Geohash ou index spatial pour les apps géolocalisées : benchmarks, exemples PostGIS, compromis rayon contre isochrone et choix pour la recherche de proximité.
 Marcus Rodriguez
Quelqu'un a créé un site qui vous affiche Wikipédia, mais seulement les articles sur les choses situées à moins d'une demi-heure de marche de l'endroit où vous vous trouvez. C'est réjouissant, ça a fait le tour du web, et c'est aussi un excellent prétexte pour parler du problème que chaque application géolocalisée finit par rencontrer : geohash ou index spatial — et la question plus profonde du rayon contre l'isochrone quand on doit répondre à « qu'est-ce qui est près de ce point ? » sur des millions de lignes.
J'ai écrit cette requête plus de fois que je ne saurais le compter : des moteurs de recherche de restaurants, du suivi d'actifs, une fonctionnalité de rayon de livraison qui a failli faire tomber une base de données. La version naïve que tout le monde écrit en premier est un parcours complet de table avec une formule de distance dans la clause WHERE. Ça marche en dev avec 500 lignes. Ça meurt en production avec 5 millions. Voyons donc les deux approches qui tiennent vraiment à l'échelle : le bucketing basé sur les geohash et un vrai index spatial comme le GiST de PostGIS. L'une des deux gagne la plupart du temps, et je vous dirai laquelle.
La requête que tout le monde écrit en premier (et regrette)
Wikipédia compte plus d'un million d'articles géocodés rien qu'en anglais, chacun avec une latitude et une longitude dans les tables page ou geo_tags. Votre propre jeu de données peut contenir des magasins, des utilisateurs, des capteurs IoT, peu importe. La requête naïve ressemble à ceci :
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
C'est la formule de haversine, et elle est correcte. Elle est aussi impossible à indexer. La base doit calculer de la trigonométrie pour chaque ligne, à chaque requête. Sur une table d'un million de lignes que j'ai benchmarkée il y a quelque temps, ça tournait autour de 800 ms par requête sur Postgres avec cache chaud. Acceptable pour une démo. Catastrophique à 50 requêtes par seconde, où il faut alors faire 40 secondes de calcul à chaque seconde. La file d'attente grossit, les connexions s'accumulent, et vous devenez soudain le personnage principal du canal d'incident.
Les deux vraies solutions partagent la même astuce : remplacer le calcul de distance coûteux, ligne par ligne, par un filtre de candidats bon marché. On réduit le million de lignes à quelques centaines de candidats grâce à un index, puis on applique le calcul exact de distance uniquement sur ceux-là. Les geohash et les index spatiaux sont deux façons différentes de faire ce filtrage de candidats. C'est cette comparaison qui compte.
Comment les geohash transforment la géographie en préfixes de chaînes
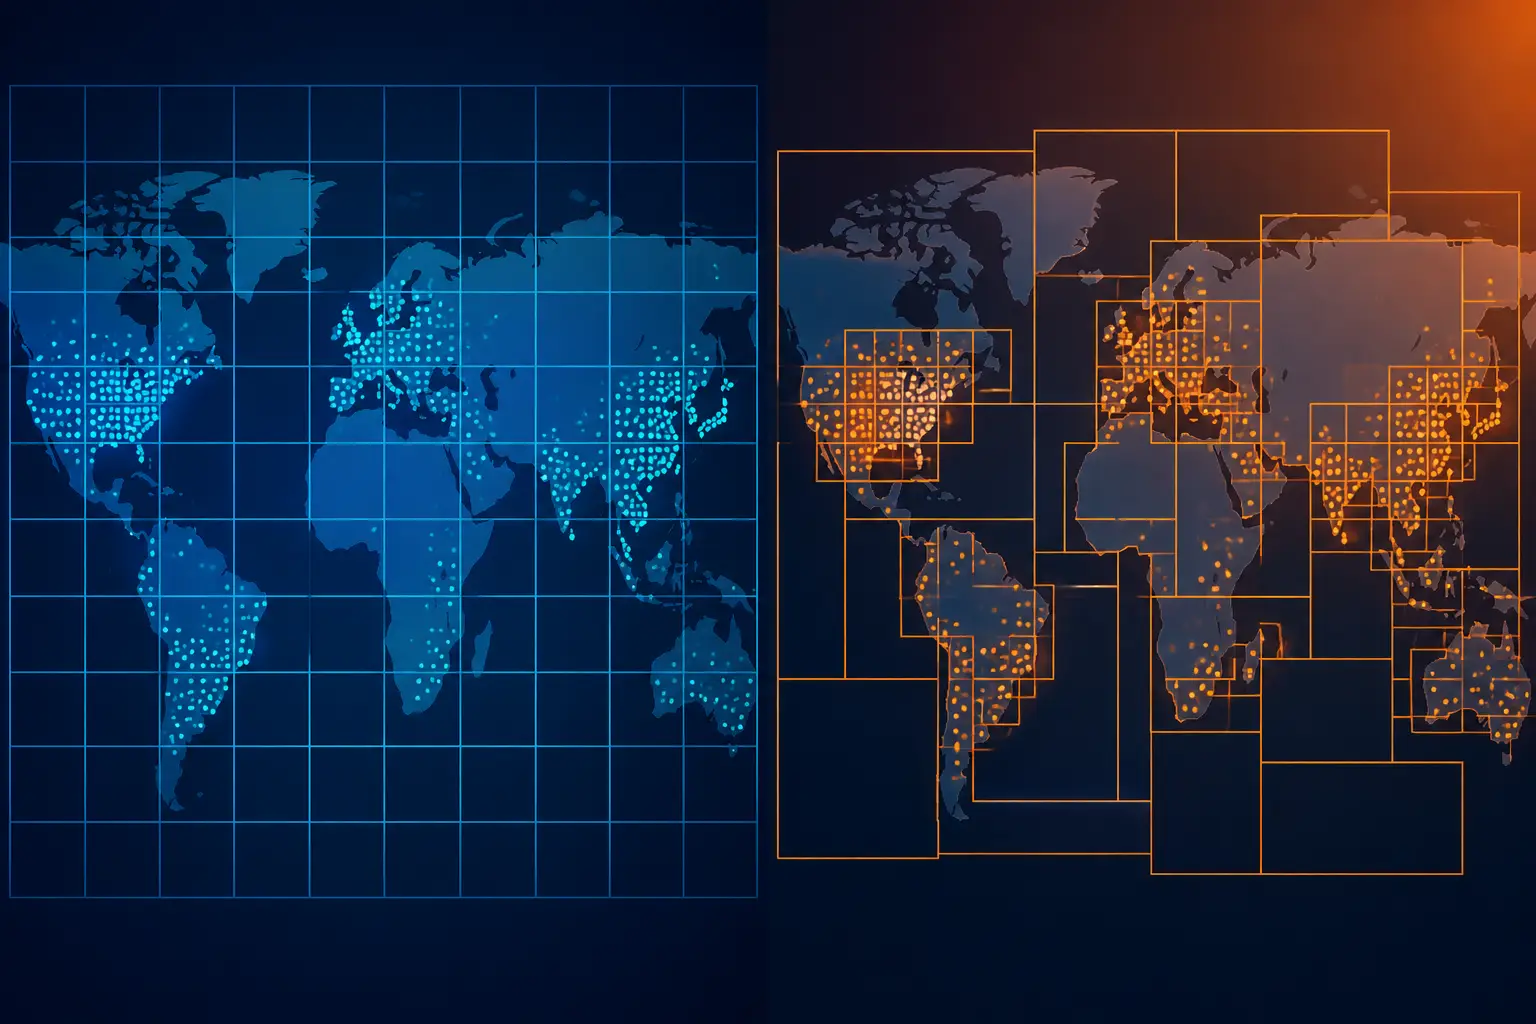
Un geohash encode une paire latitude/longitude sous forme de courte chaîne, en bissectant sans cesse le globe. Chaque caractère ajouté divise la cellule par deux. « u4pruydqqvj » désigne un banc à Londres ; « u4pruyd » est un carré d'environ 150 m contenant ce banc ; « u4p » est un carré d'environ 40 km couvrant la moitié du sud de Londres. La propriété remarquable : les points voisins partagent des préfixes de chaîne, et la correspondance de préfixes est exactement ce qu'un simple index B-tree fait les yeux fermés.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
Le fonctionnement : au moment de l'écriture, on calcule le geohash de chaque ligne (une fonction pure, quelques microsecondes). Au moment de la requête, on calcule la cellule geohash qui couvre votre point à une précision dont la taille correspond à peu près à votre rayon, puis on calcule aussi ses huit voisines. C'est la partie que les gens oublient, car un point proche du bord d'une cellule aura des voisins de l'autre côté de la frontière. On filtre les candidats par préfixe, puis on applique haversine exact aux survivants. On passe d'un million de calculs de distance à quelques centaines, peut-être.
L'attrait tient à la portabilité. Les requêtes par préfixe de geohash fonctionnent dans tout ce qui indexe des chaînes : clés de tri DynamoDB, Elasticsearch, ensembles triés Redis (c'est ce qu'utilise GEOADD en interne, un score encodé en geohash dans un ZSET), SQLite, un fichier trié sur disque. Pas d'extensions, pas de types de colonnes exotiques. Si votre infrastructure est un NoSQL ou un service managé sans support spatial, les geohash sont souvent votre seule vraie option. Ils se shardent aussi trivialement, ce qui explique leur présence dans les systèmes qui répartissent des données de localisation entre plusieurs nœuds.
Les faiblesses sont pourtant bien réelles. La précision est quantifiée : soit on choisit une taille de cellule qui englobe largement le rayon et on accepte le surplus de données récupérées, soit on prend des cellules plus petites et on multiplie les requêtes par préfixe. Les tailles de cellules se déforment aussi avec la latitude : une cellule de 5 caractères est beaucoup plus haute que large, et le rapport d'aspect change à mesure qu'on s'éloigne de l'équateur. Et vous maintenez vous-même une colonne dénormalisée, avec toutes les joyeusetés de cohérence de mise à jour que cela implique. C'est une astuce ingénieuse posée sur un index de chaînes, et elle se comporte comme tel.
Index spatiaux : PostGIS GiST et la famille des R-tree
L'alternative consiste à laisser la base comprendre la géométrie nativement. PostGIS apporte à Postgres un type geography et un index GiST (generalized search tree) dessus, qui est en interne un R-tree imbriquant hiérarchiquement des boîtes englobantes. La requête devient presque ridiculement simple :
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin utilise directement l'index : pas d'étape de candidats puis de raffinage à gérer à la main, pas de logique de cellules voisines, pas de réglage de précision. La base fait le préfiltrage par boîte englobante et le calcul de distance exacte sur le sphéroïde dans un seul opérateur, avec une sémantique correcte en mètres, car geography prend en compte la forme de la Terre. Dans mon propre avant/après sur cette table d'un million de lignes : le scan haversine à ~800 ms est devenu ~4 ms avec l'index GiST pour le même rayon. Ce n'est pas un gain de réglage, c'est un autre sport.
Au-delà de la vitesse brute, on obtient la correction gratuitement et une bonne composabilité en prime. Vous voulez « dans ce polygone » plutôt qu'un cercle ? ST_Intersects. Vous voulez un tampon autour d'un tracé ? ST_DWithin contre une linestring. Vous voulez les K plus proches voisins sans connaître le rayon à l'avance ? L'opérateur <-> avec un index GiST effectue un KNN ordonné par l'index, exactement ce qu'il faut pour le comportement « moins de 25 résultats à proximité ? on prend les 25 plus proches dans un rayon de 10 km » qu'implémente le site Wikipédia local. Écrire une logique de repli par paliers au-dessus des préfixes de geohash oblige à coder soi-même plusieurs tentatives de rayon ; avec le KNN, c'est une seule requête qui parcourt simplement l'index.
Le prix à payer, c'est la dépendance. Il faut Postgres avec l'extension PostGIS (quasiment universelle sur Postgres managé aujourd'hui : RDS, Cloud SQL, Supabase la proposent toutes), ou le support spatial de MySQL (fonctionnel mais avec des aspérités et un indexage historiquement plus faible), ou SQLite avec SpatiaLite. On hérite aussi d'un certain poids opérationnel : des SRID de géométries à garder en ordre, des écritures un peu plus lourdes, et un planificateur qui a parfois besoin d'un coup de pouce pour réellement utiliser l'index spatial sur les petites tables.
Benchmarks et tableau de compromis honnête
Chiffres issus d'un benchmark que j'ai relancé récemment pour ce type de charge : 1,2 million de points (à peu près l'échelle des articles géocodés de Wikipédia), Postgres 16, requêtes à 3 km de rayon sur des coordonnées urbaines aléatoires, cache chaud :
- Scan complet haversine : ~800 ms. Présent uniquement à titre d'avertissement.
- Préfixe geohash (cellule de 5 caractères + 8 voisines) + raffinage haversine : ~12 ms en médiane, mais ~40 ms au p95 quand la cellule récupère trop de données dans les zones denses comme les centres-villes.
- PostGIS GiST avec ST_DWithin : ~4 ms en médiane, ~8 ms au p95, et à peu près stable quand la densité augmente.
- KNN PostGIS (
<->) pour les 25 plus proches : ~2 ms, et il se moque du rayon que vous auriez choisi. - Redis GEOSEARCH (geohash sous le capot) : sous la milliseconde, mais tout votre jeu de données vit en RAM et c'est un cache, pas une source de vérité.
Vos résultats varieront selon le matériel et la forme des données, mais l'ordre reste stable dans tous les tests que j'ai jamais faits : index spatial < geohash sur B-tree < scan brut. La faiblesse de l'approche geohash apparaît précisément là où ça compte le plus : les cœurs urbains denses, les endroits où se trouvent les utilisateurs et où une seule cellule contient des dizaines de milliers de candidats à revérifier avec haversine.
Là où les geohash reprennent du terrain, c'est sur la simplicité opérationnelle hors de la base. Si votre chemin de lecture passe par Redis (GEOSEARCH sous la milliseconde), ou par DynamoDB (préfixe geohash comme condition sur la clé de tri), ou si vous livrez un jeu de données statique en périphérie et interrogez avec des préfixes de chaînes en JavaScript dans le navigateur, le geohash n'est pas un compromis, c'est l'architecture. Plusieurs projets annexes de « découverte locale » fonctionnent entièrement côté client de cette façon, et comme pattern il se marie bien avec le genre de petits projets web autonomes dont j'ai parlé dans pourquoi le petit web est la meilleure partie d'internet : un site statique, un index précalculé, zéro serveur.
Rayon contre isochrone : l'abstraction que vous livrez vraiment
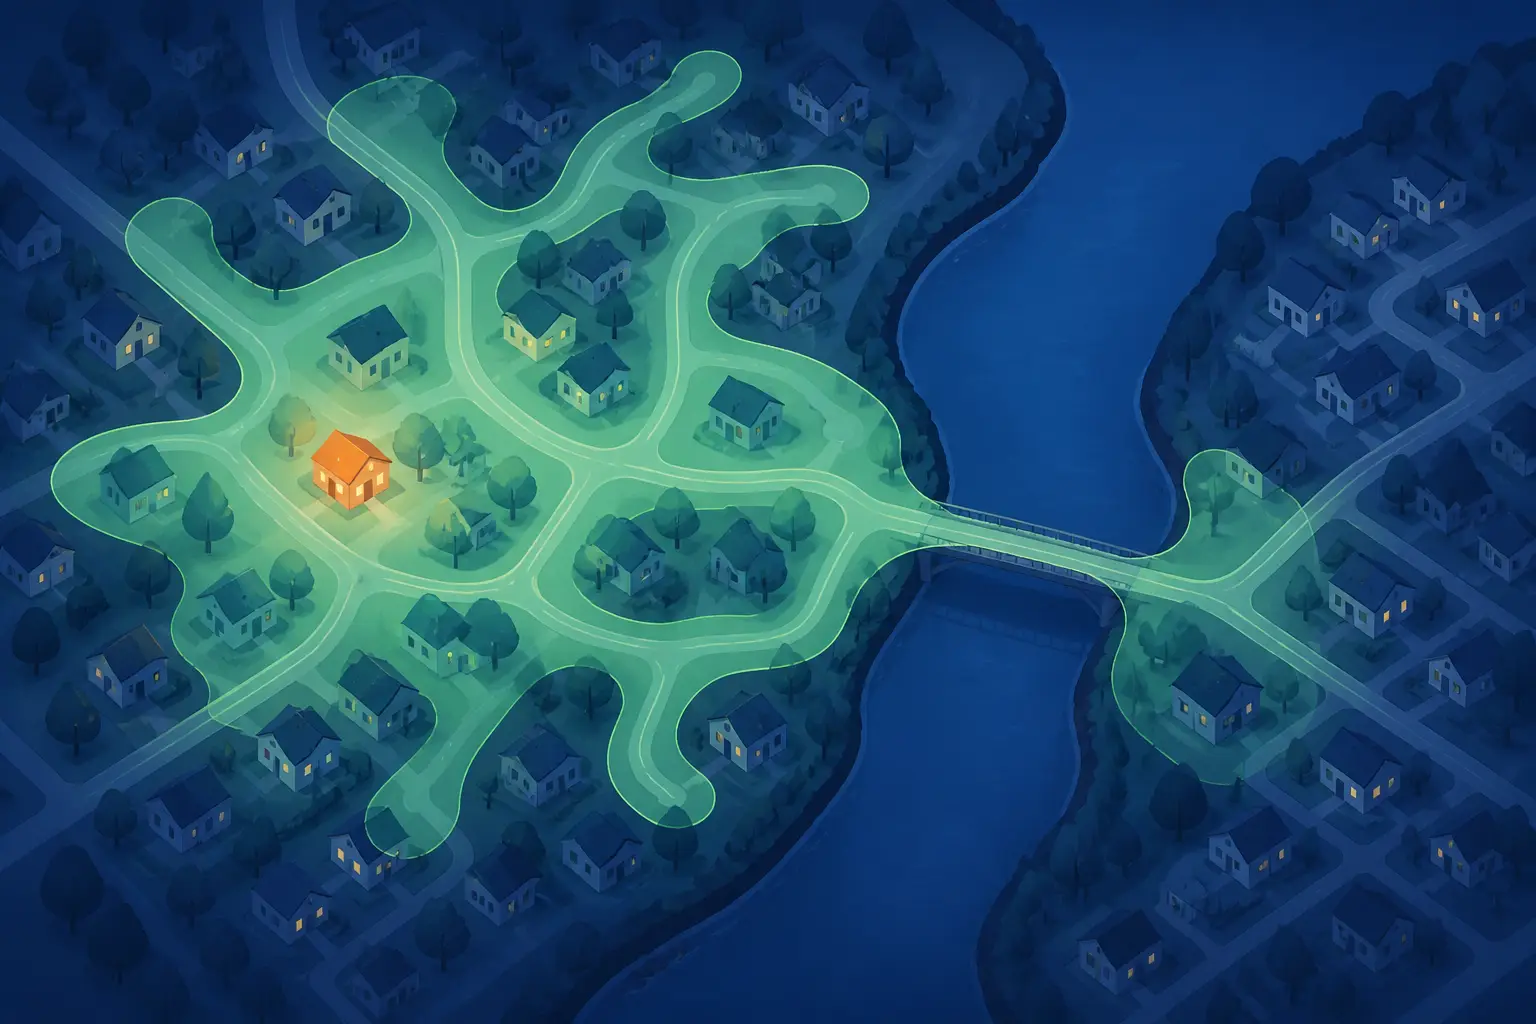
Voici ce pour quoi le projet Wikipédia local s'est fait gentiment chambrer : il parle d'une « demi-heure de marche », mais il trace en réalité un cercle de 3 km à vol d'oiseau. Une rivière sans pont, une autoroute, une gare de triage clôturée : le cercle n'en sait rien. Une véritable demi-heure de marche est une isochrone : la forme irrégulière de tout ce qui est accessible en 30 minutes le long du réseau piéton réel. Deux points distants de 1 km à vol d'oiseau peuvent être séparés de 40 minutes de marche si un estuaire se trouve entre les deux.
Calculer une isochrone suppose de faire tourner un moteur de routage — les données OpenStreetMap passées dans OSRM, Valhalla ou GraphHopper — en développant un arbre de plus courts chemins depuis votre point jusqu'à épuiser le budget de temps, puis en traçant le contour de la zone atteignable pour en faire un polygone. Cela représente quelques minutes de prétraitement de graphe par région et quelques dizaines de millisecondes par requête, contre quelques microsecondes pour un cercle. Mais une fois le polygone obtenu, la requête d'appartenance n'est qu'un ST_Intersects, que le même index spatial gère merveilleusement bien. C'est l'un des cas où le camp des index spatiaux prend encore plus d'avance : les polygones y sont des citoyens de première classe, alors que les astuces de préfixes geohash deviennent franchement pénibles pour des formes arbitraires (il faut couvrir le polygone avec un ensemble de cellules — faisable, des bibliothèques Z-order et S2 existent pour ça, mais c'est un projet à part entière).
Mon avis honnête : pour la plupart des produits, le cercle est le bon mensonge. Les utilisateurs n'auditent pas votre modèle de marche ; ils remarquent surtout que les résultats sont rapides et à peu près cohérents. « Dans un rayon de 3 km » correspond assez bien à « à proximité » pour que l'infrastructure supplémentaire d'un moteur de routage soit difficile à justifier pour une fonctionnalité de consultation de contenu. Dès que vous faites des promesses qui ont des conséquences — délais de livraison, dispatch de coursiers, couverture des secours — le cercle devient une responsabilité et l'isochrone se rentabilise. Choisissez l'abstraction selon que se tromper vous coûte de l'argent ou seulement une légère surprise.
Se procurer les données : Wikipédia géocodé et recherche d'adresses
Si vous voulez construire quelque chose dans cet esprit, la plomberie des données est plus accessible qu'on ne le croit. Les coordonnées de Wikipédia proviennent du système de modèles GeoHack et sont interrogeables via le point de terminaison list=geosearch de l'API MediaWiki — qui est elle-même une requête de rayon sur un index spatial, et ce qu'enveloppe la fonctionnalité « À proximité » du projet. La propriété P625 (localisation géographique) de Wikidata couvre bien plus que Wikipédia en anglais si vous voulez des entités multilingues ou non articles. Pour la recherche d'adresses, le projet utilise Photon, un géocodeur basé sur Elasticsearch et construit sur les données Nominatim d'OpenStreetMap — gratuit à auto-héberger, avec un point de terminaison de démonstration public que des âmes généreuses font tourner et qu'il ne faut pas marteler en production.
Une décision de conception à piquer : le site garde votre position dans le navigateur et ne la place jamais dans les URL partageables. C'est le bon réglage par défaut, et il rejoint la leçon de ce que les applications de fitness nous apprennent sur les données de localisation et l'OPSEC : les coordonnées d'un utilisateur comptent parmi les chaînes les plus sensibles que votre application manipulera jamais, et le moyen le moins coûteux de les protéger est de ne jamais les envoyer à votre serveur. Faites le géocodage côté client ou via un géocodeur tiers avec lequel le navigateur communique directement, ne conservez que des coordonnées arrondies si vous devez journaliser quoi que ce soit, et votre posture de confidentialité se dessine d'elle-même.
Pour le repli « les N plus proches quel que soit le rayon », résistez à l'envie d'implémenter des boucles de nouvelles tentatives à rayon croissant. L'opérateur KNN de PostGIS le fait en une seule requête indexée :
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
Cette seule ligne remplace toute l'« échelle de rayons » du type « essayer 3 km, puis 6 km, puis 10 km » que je vois dans tant de bases de code, et elle est plus rapide qu'un seul palier de cette échelle.
La recommandation
Si vous ne retenez qu'une chose de cette comparaison, retenez celle-ci : commencez par PostGIS et un index GiST, et ne recourez aux geohash que lorsque votre couche de stockage vous y oblige.
Le raisonnement est simple. L'index spatial gagne sur la latence médiane, gagne encore plus sur le p95 dans les zones denses, gagne sur la justesse (distances sphéroïdales exactes en mètres, pas de bugs de bord de cellule), gagne sur les fonctionnalités (polygones, KNN, appartenance à une isochrone deviennent des one-liners), et gagne sur le code que vous n'avez pas à écrire ni à maintenir. L'approche geohash vous oblige à implémenter correctement le calcul des cellules voisines, la sélection de précision et un filtre en deux phases — trois endroits où l'on peut se tromper subtilement — pour atteindre des performances qui restent inférieures.
Les geohash ne se justifient que dans trois situations : votre magasin de données n'a aucun support spatial (DynamoDB, Redis nu, un fichier JSON statique sur un CDN), vous avez besoin d'un sharding par localisation entre plusieurs nœuds, ou vous déportez la requête côté client et voulez zéro dépendance. Dans ces cas, appuyez-vous sur une bibliothèque éprouvée — ngeohash en Node, python-geohash, ou S2 geometry si vous couvrez des polygones — plutôt que de réécrire à la main les calculs de voisinage.
Et côté produit : livrez d'abord le cercle, étiquetez-le honnêtement (« dans un rayon de 3 km » plutôt que « une demi-heure de marche »), rendez le rayon configurable parce que les utilisateurs ruraux et urbains ne vivent pas dans les mêmes univers de densité, et ne passez aux isochrones que lorsque le mensonge du vol d'oiseau commence à vous coûter quelque chose de mesurable. Le projet Wikipédia local est un rappel charmant que les meilleures fonctionnalités ne sont souvent qu'une bonne requête spatiale déguisée en idée sympathique. Un million d'articles, un index, un rayon bien choisi — et soudain la plus grande encyclopédie d'internet donne l'impression d'avoir été écrite sur votre rue.