Geohash или пространственный индекс для поиска рядом
Geohash или пространственный индекс для гео-приложений: бенчмарки, примеры PostGIS, радиус против изохрон и понятный выбор для поиска рядом.
 Marcus Rodriguez
Кто-то сделал сайт, который показывает Википедию, но только статьи о местах в получасе ходьбы от вас. Штука получилась обаятельная, она разлетелась по интернету, и это отличный повод поговорить о проблеме, с которой рано или поздно сталкивается любое гео-приложение: geohash или пространственный индекс — и о более глубоком вопросе: радиус или изохрона, когда нужно ответить на «что рядом с этой точкой?» по миллионам строк.
Я писал этот запрос столько раз, что и не сосчитать: поиск ресторанов, трекинг активов, функция «зона доставки», которая чуть не уронила базу. Наивный вариант, который все пишут первым, — полное сканирование таблицы с формулой расстояния в WHERE. На разработке с 500 строками он работает. В продакшене с 5 миллионами — падает. Поэтому сравним два подхода, которые реально выдерживают масштаб: bucketing на основе geohash и нормальный пространственный индекс вроде GiST в PostGIS. Один из них побеждает в большинстве случаев, и я скажу, какой именно.
Запрос, который все пишут первым (и потом жалеют)
В одной только английской Википедии больше миллиона геокодированных статей — у каждой есть широта и долгота в таблицах page или geo_tags. Ваши данные могут быть магазинами, пользователями, IoT-датчиками, чем угодно. Наивный запрос выглядит так:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
Это формула гаверсинусов, и она правильная. Но проиндексировать её нельзя. База должна считать тригонометрию для каждой строки при каждом запросе. На таблице из миллиона строк, которую я когда-то замерял, такой запрос занимал около 800 мс на Postgres с прогретым кешем. Для демки сойдёт. При 50 запросах в секунду — катастрофа: вам нужно каждую секунду считать 40 секунд математики. Очередь растёт, соединения копятся, и вы внезапно становитесь главным героем канала инцидентов.
Оба рабочих решения используют один и тот же трюк: заменить дорогую проверку расстояния для каждой строки дешёвым отбором кандидатов. С помощью индекса сократить миллион строк до нескольких сотен кандидатов, а уже к ним применить точную математику расстояний. Geohash и пространственные индексы — два разных способа такого отбора кандидатов. Именно это сравнение и важно.
Как geohash превращает географию в строковые префиксы
Geohash кодирует пару широта/долгота в короткую строку, многократно делением глобуса пополам. Каждый добавленный символ уменьшает ячейку вдвое. «u4pruydqqvj» — это скамейка в Лондоне; «u4pruyd» — квадрат около 150 м, в котором эта скамейка находится; «u4p» — квадрат примерно 40 км, покрывающий половину южного Лондона. Ключевое свойство: близкие точки имеют общие префиксы строки, а поиск по префиксу — ровно то, что скучный B-tree индекс делает не глядя.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
Порядок работы: при записи вычисляем geohash каждой строки (чистая функция, микросекунды). При запросе вычисляем ячейку geohash, покрывающую вашу точку, с точностью, размер которой примерно соответствует радиусу, а затем вычисляем её восемь соседей. Это часть, которую обычно забывают: точка у края ячейки будет иметь соседей за границей. Фильтруем кандидатов по префиксу, затем применяем точную гаверсинус-формулу к оставшимся. Вместо миллиона вычислений расстояний получаем, может быть, несколько сотен.
Главное преимущество — переносимость. Запросы по префиксу geohash работают везде, где индексируются строки: ключи сортировки DynamoDB, Elasticsearch, отсортированные множества Redis (именно так внутри работает GEOADD — score в ZSET, закодированный geohash), SQLite, отсортированный файл на диске. Никаких расширений и экзотических типов колонок. Если ваша инфраструктура — NoSQL-хранилище или управляемый сервис без пространственной поддержки, geohash часто единственный реальный вариант. Он также легко шардируется, поэтому его часто используют в системах, которые распределяют геоданные по узлам.
Но недостатки реальные. Точность дискретна: выбираете размер ячейки, которая с запасом покрывает радиус, и платите за лишнюю выборку, либо берёте ячейки меньше и делаете больше запросов по префиксам. Размеры ячеек также искажаются с широтой: ячейка из 5 символов заметно выше, чем шире, и пропорции меняются по мере удаления от экватора. Плюс вы сами поддерживаете денормализованную колонку со всеми вытекающими сложностями согласованности обновлений. Это умный хак поверх строкового индекса, и ведёт он себя именно как строковый индекс.
Пространственные индексы: PostGIS GiST и семейство R-дерева
Альтернатива — позволить базе понимать геометрию нативно. PostGIS добавляет в Postgres тип geography и индекс GiST (generalized search tree) над ним — внутри это R-дерево, которое иерархически вкладывает ограничивающие прямоугольники. Запрос становится почти смешно простым:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin использует индекс напрямую — никакого ручного шага «кандидаты, затем уточнение», никакой логики соседних ячеек, никакой настройки точности. База выполняет предварительную фильтрацию по ограничивающему прямоугольнику и точное расстояние по сфероиду одним оператором, с корректной семантикой в метрах, потому что geography учитывает форму Земли. В моём замере на той же таблице из миллиона строк: сканирование гаверсинусом с ~800 мс стало ~4 мс с GiST-индексом при том же радиусе. Это не тюнинг, это другой вид спорта.
Помимо скорости, вы получаете корректность бесплатно и композицию в придачу. Нужно «внутри этого полигона» вместо круга? ST_Intersects. Нужен буфер вокруг линии маршрута? ST_DWithin против linestring. Нужны K ближайших соседей без заранее известного радиуса? Оператор <-> с GiST-индексом делает KNN по порядку индекса — именно то, что нужно для поведения «меньше 25 результатов рядом? покажи 25 ближайших в пределах 10 км», которое реализовано в локальном сайте Википедии. Писать многоуровневую логику отката поверх префиксов geohash значит вручную реализовывать несколько попыток с разными радиусами; с KNN это один запрос, который просто обходит индекс.
Цена — зависимости. Нужен Postgres плюс расширение PostGIS (сейчас оно почти везде есть в управляемом Postgres — RDS, Cloud SQL, Supabase всё его поставляют), либо пространственная поддержка MySQL (работает, но с шероховатостями и исторически слабее с индексами), либо SQLite с SpatiaLite. Вы также наследуете операционную тяжесть: нужно следить за SRID геометрий, запись немного тяжелее, и планировщик иногда нуждается в подсказке, чтобы действительно использовать пространственный индекс на маленьких таблицах.
Бенчмарки и честная таблица компромиссов
Цифры из бенчмарка, который я недавно перезапустил для такой нагрузки — 1,2 миллиона точек (примерно масштаб геокодированных статей Википедии), Postgres 16, запросы с радиусом 3 км по случайным городским координатам, прогретый кеш:
- Полное сканирование таблицы гаверсинусом: ~800 мс. Включено только как страшилка.
- Префикс geohash (ячейка из 5 символов + 8 соседей) + уточнение гаверсинусом: ~12 мс медианно, но ~40 мс на p95, когда ячейка захватывает лишнее в плотных районах вроде центров городов.
- PostGIS GiST с ST_DWithin: ~4 мс медианно, ~8 мс на p95, и почти не растёт с ростом плотности.
- PostGIS KNN (
<->) для 25 ближайших: ~2 мс, и ему всё равно, какой радиус вы бы выбрали. - Redis GEOSEARCH (под капотом geohash): меньше миллисекунды, но весь датасет живёт в оперативной памяти, и это кеш, а не источник истины.
Ваши цифры будут отличаться в зависимости от железа и структуры данных, но порядок стабилен во всех тестах, которые я когда-либо проводил: пространственный индекс < geohash на B-tree < сырое сканирование. Слабость подхода с geohash проявляется именно там, где это важнее всего, — в плотных городских центрах, где именно и живут пользователи и где одна ячейка содержит десятки тысяч кандидатов для перепроверки гаверсинусом.
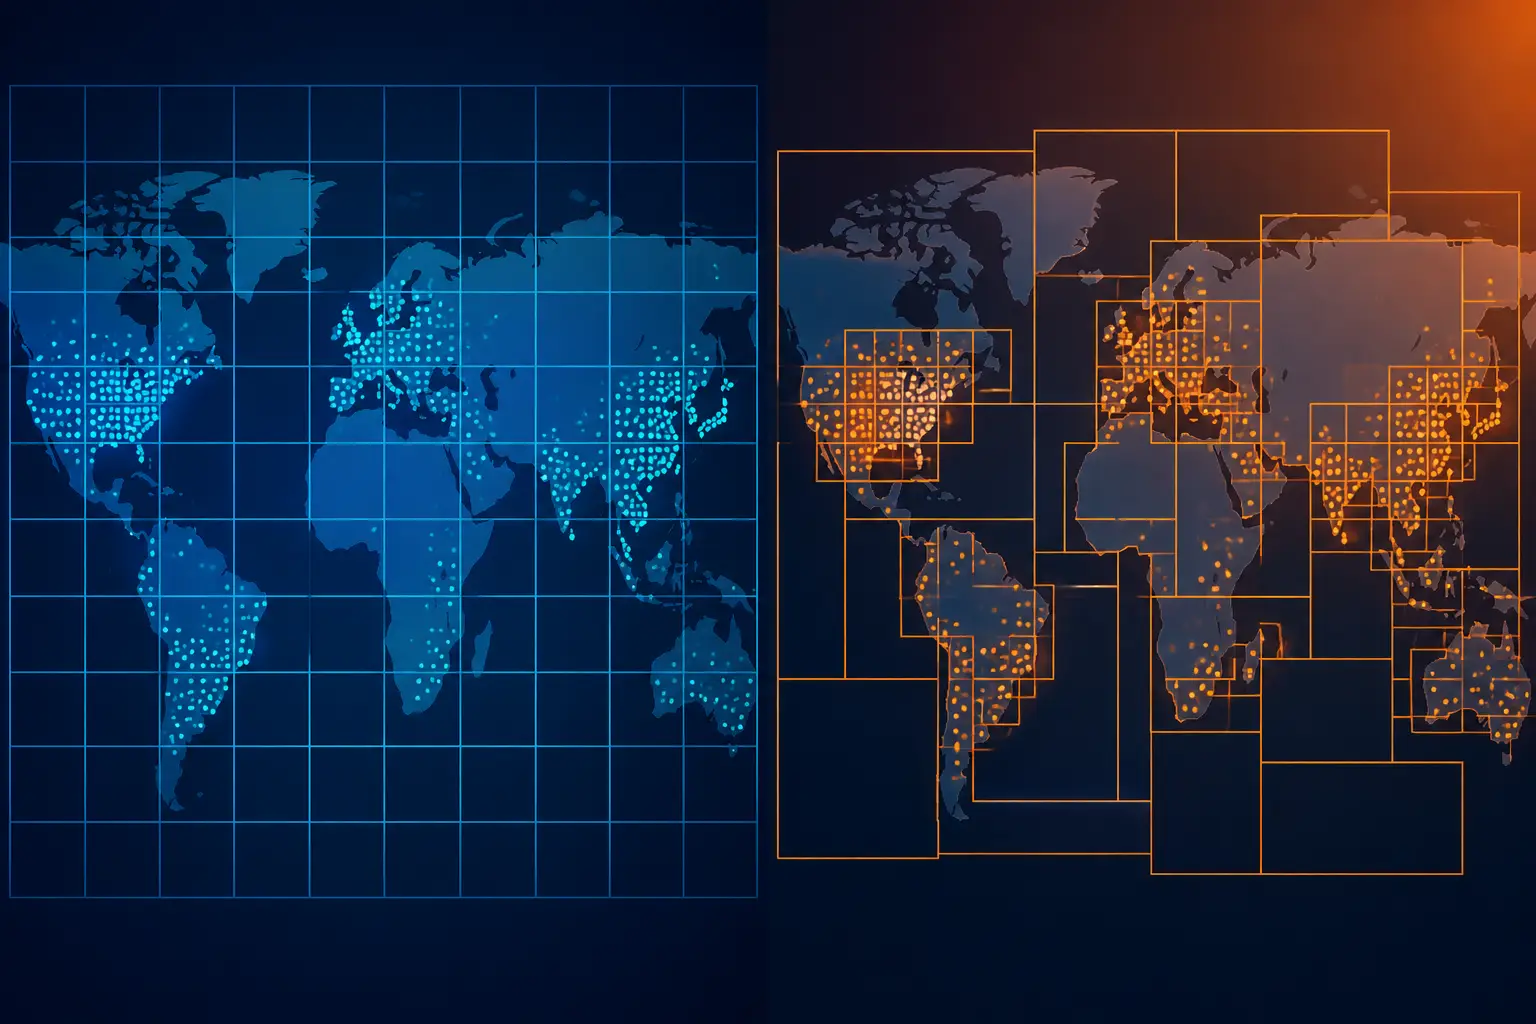
Там, где geohash отыгрывает позиции, — это операционная простота за пределами базы данных. Если ваш путь чтения — Redis (субмиллисекундный GEOSEARCH), или DynamoDB (префикс geohash как условие по ключу сортировки), или вы отдаёте статический датасет на край сети и делаете запросы по строковым префиксам в JavaScript прямо в браузере — geohash не компромисс, а сама архитектура. Несколько проектов «локального поиска» работают полностью на клиенте именно так, и как паттерн это хорошо сочетается с небольшими самодостаточными веб-проектами, о которых я писал в тексте почему малый веб — лучшая часть интернета: статический сайт, предвычисленный индекс, ноль серверов.
Радиус против изохроны: абстракция, которую вы на самом деле выкатываете
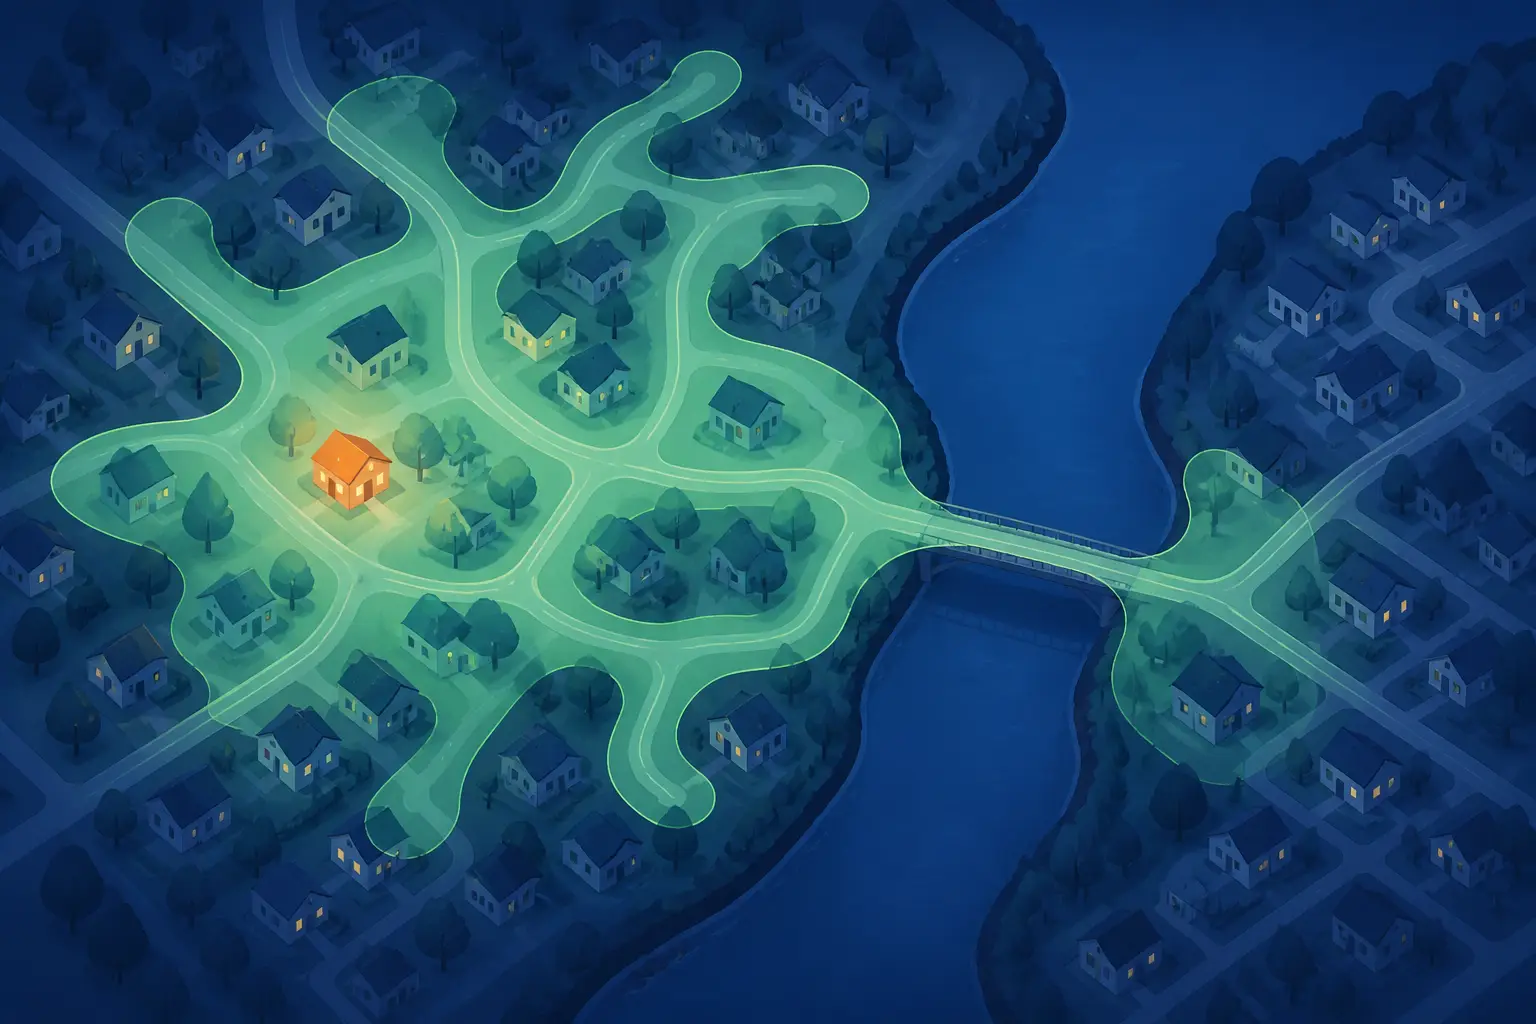
Вот то, за что локальный проект с Википедией получил мягкую обработку: он говорит «полчаса пешком», а на самом деле рисует круг 3 км по прямой. Река без моста, автострада, огороженная железнодорожная станция — круг об этом ничего не знает. Настоящая получасовая прогулка — это изохрона: неровная фигура всего, что достижимо за 30 минут по реальной пешеходной сети. Две точки в 1 км друг от друга по прямой могут оказаться в 40 минутах ходьбы друг от друга, если между ними эстуарий.
Чтобы посчитать изохрону, нужен routing-движок — данные OpenStreetMap через OSRM, Valhalla или GraphHopper: из вашей точки разворачивается дерево кратчайших путей, пока время в пути не достигнет бюджета, после чего достижимая область обводится полигоном. Это минуты предобработки графа на регион и десятки миллисекунд на запрос, против микросекунд для круга. Но когда полигон готов, проверка вхождения — это просто ST_Intersects, которую тот же пространственный индекс обрабатывает отлично. Это один из случаев, когда лагерь пространственных индексов уходит ещё дальше вперёд: полигоны там полноправные объекты, а трюки с префиксами geohash становятся по-настоящему неудобными для произвольных форм (приходится покрывать полигон набором ячеек — это возможно, для этого существуют Z-order и библиотеки S2, но это уже отдельный проект).
Моё честное мнение: для большинства продуктов круг — правильная ложь. Пользователи не проверяют вашу модель ходьбы; они замечают, что результаты быстрые и более-менее разумные. «В пределах 3 км» достаточно хорошо коррелирует с «рядом», и дополнительная инфраструктура routing-движка сложно оправдывается для функции просмотра контента. Как только вы даёте обещания с последствиями — сроки доставки, диспетчеризация курьеров, зона покрытия экстренных служб, — круг становится обязательством, и изохрона окупается. Выбирайте абстракцию, исходя из того, стоит ли ошибка денег или просто лёгкого удивления.
Источники данных: геокодированная Википедия и поиск адресов
Если хотите сделать что-то в этом духе, работа с данными куда доступнее, чем кажется. Координаты Википедии берутся из системы шаблонов GeoHack и доступны через эндпоинт list=geosearch MediaWiki API — это сама по себе радиусная выборка по пространственному индексу, которую и оборачивает функция «Рядом» в проекте. Свойство Wikidata P625 (координатное местоположение) покрывает гораздо больше, чем английская Википедия, если нужны многоязычные или неархивные сущности. Для поиска адресов проект использует Photon — геокодер на базе Elasticsearch, построенный на данных Nominatim из OpenStreetMap: его можно бесплатно развернуть у себя, а публичный демо-эндпоинт поддерживают щедрые люди, и бомбить его в продакшене не стоит.
Одно решение, которое стоит позаимствовать: сайт хранит ваше местоположение в браузере и никогда не кладёт его в URL, которым можно поделиться. Это правильное поведение по умолчанию, и оно перекликается с уроком из текста что фитнес-приложения рассказывают нам о геоданных и OPSEC: координаты пользователя — одни из самых чувствительных строк, которые ваше приложение будет хранить, и самый дешёвый способ их защитить — вообще не отправлять на сервер. Делайте геокодирование на клиенте или через сторонний геокодер, с которым браузер общается напрямую, храните только округлённые координаты, если вообще нужно что-то логировать, — и политика приватности складывается сама собой.
Для варианта «N ближайших независимо от радиуса» не поддавайтесь желанию реализовать циклы с расширяющимся радиусом. Оператор KNN в PostGIS делает это одним индексированным запросом:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
Эта единственная строка заменяет всю лестницу «попробуем 3 км, потом 6 км, потом 10 км», которую я вижу во многих кодовых базах, и работает быстрее, чем один шаг этой лестницы.
Рекомендация
Если вы возьмёте из этого сравнения одно, возьмите вот что: начинайте с PostGIS и индекса GiST, а к geohash прибегайте только тогда, когда этого вынуждает ваше хранилище.
Логика простая. Пространственный индекс выигрывает по медианной задержке, сильнее выигрывает по p95 в плотных районах, выигрывает по корректности (расстояния по сфероиду с точностью до метра, никаких багов на краю ячейки), выигрывает по функциональности (полигоны, KNN, проверка вхождения в изохрону — всё в одну строку) и выигрывает по коду, который не нужно писать и поддерживать. Подход с geohash требует правильно реализовать вычисление соседних ячеек, выбор точности и двухфазный фильтр — три места, где легко тонко ошибиться, — и при этом всё равно получить производительность хуже.
Geohash оправдан ровно в трёх ситуациях: ваше хранилище не поддерживает пространственные данные (DynamoDB, обычный Redis, статический JSON-файл на CDN), вам нужно шардирование по геолокации между узлами или вы переносите запрос на клиент и хотите обойтись без зависимостей. В этих случаях опирайтесь на проверенную библиотеку — ngeohash для Node, python-geohash или S2 для покрытия полигонов — а не реализуйте математику соседей сами.
И на стороне продукта: сначала выкатите круг, честно подпишите его («в пределах 3 км», а не «полчаса пешком»), сделайте радиус настраиваемым, потому что жители сёл и городов живут в разных мирах плотности, и переходите к изохронам только тогда, когда ложь «по прямой» начнёт стоить вам чего-то измеримого. Локальный проект Википедии — прекрасное напоминание, что лучшие фичи часто — это просто хороший пространственный запрос в дружелюбной обёртке. Миллион статей, один индекс, один правильно выбранный радиус — и самая большая энциклопедия интернета вдруг начинает казаться написанной про вашу улицу.