ジオハッシュ vs 空間インデックス:近傍検索の選び方
位置情報アプリ向けに、ジオハッシュと空間インデックスを比較。ベンチマーク、PostGISの例、半径とイソクロンの違い、近傍検索の結論まで。
 Marcus Rodriguez
誰かが、今いる場所から歩いて30分以内にあるものについての記事だけを表示するWikipediaのサイトを作りました。これが楽しいと話題になり、同時に位置情報を扱うアプリケーションが必ずぶつかる問題を語るいい口実にもなりました。それがジオハッシュ vs 空間インデックスの話で、さらに数百万行の中から「この地点の近くには何がある?」に答える場合の、半径とイソクロン(等時間圏)のトレードオフという、もう一段深い問いです。
私はこのクエリを数えきれないほど書いてきました。飲食店検索、資産追跡、データベースをほぼ落としかけた配送範囲機能などです。誰もが最初に書くナイーブな実装は、WHERE句に距離の計算式を入れたフルテーブルスキャンです。開発環境の500行では動きますが、本番の500万行では死にます。そこで、規模に耐えられる2つの実用的なアプローチ、ジオハッシュによるバケット分割と、PostGISのGiSTのような本格的な空間インデックスを比べます。大抵の場合どちらかが勝ちますので、どちらが勝つかはお伝えします。
最初に書きたくなり、後悔するクエリ
英語版Wikipediaだけでも100万件以上のジオコード済み記事があり、そのすべてがpageテーブルやgeo_tagsテーブルに緯度と経度を持っています。自分のデータセットが店舗、ユーザー、IoTセンサーなど何であれ、同じです。素朴なクエリは次のようになります。
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
これはハバースイン公式で、計算としては正しいです。しかしインデックスは効きません。データベースは毎回のリクエストで全行に対して三角関数を計算しなければなりません。以前ベンチマークした100万行のテーブルでは、ウォームキャッシュのPostgresで1クエリあたり約800msでした。デモなら問題ありませんが、毎秒50リクエストになると、毎秒40秒分の計算を処理する必要が出てきます。キューは伸び、コネクションは積み上がり、気づけばインシデントチャンネルの主役になっています。
実用的な2つの解決策は、どちらも同じ手法を使います。高コストな行ごとの距離チェックを、安価な候補の絞り込みに置き換えるのです。インデックスを使って100万行を数百の候補まで減らし、その候補だけに正確な距離計算をします。ジオハッシュと空間インデックスは、この候補絞り込みを実現する2つの異なる方法です。比較すべきはそこです。
ジオハッシュが地理情報を文字列の接頭辞に変える仕組み
ジオハッシュは、地球を繰り返し二分割して緯度経度の組を短い文字列にエンコードします。文字を1つ足すごとにセルの大きさが半分になります。「u4pruydqqvj」はロンドンのあるベンチ、「u4pruyd」はそのベンチを含む約150m四方のセル、「u4p」は南ロンドンの半分ほどを含む約40km四方のセルです。重要な性質は、近くにある点同士は文字列の接頭辞を共有することです。そして接頭辞マッチは、ごく普通のBツリーインデックスが得意とする処理そのものです。
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
処理の流れは次のとおりです。書き込み時に各行のジオハッシュを計算します(純粋な関数で、マイクロ秒単位です)。クエリ時には、検索半径におおよそ合うセルサイズの精度で、対象の地点を含むジオハッシュのセルを計算し、さらにその8つの隣接セルも計算します。ここは多くの人が忘れる部分です。セルの境界付近にある点は、境界の向こう側に近くの点があるからです。接頭辞で候補を絞り込み、残った候補に正確なハバースイン計算を適用します。これで100万回の距離計算が、数百回程度になります。
ジオハッシュの強みは可搬性です。ジオハッシュの接頭辞クエリは、文字列にインデックスを張れるあらゆる場所で動きます。DynamoDBのソートキー、Elasticsearch、Redisのソート済みセット(GEOADDが内部で使っているもので、ZSETにジオハッシュでエンコードしたスコアを持たせています)、SQLite、ディスク上のソート済みファイルなどです。拡張機能も特殊なカラム型も不要です。インフラがNoSQLストアや、空間機能のないマネージドサービスなら、ジオハッシュは現実的にほぼ唯一の選択肢になることも多いです。また、ノード間で位置データを分割するシステムによく登場するのは、簡単にシャーディングできるからです。
ただし弱点は現実的です。精度は量子化されています。半径を十分に覆う粗いセルを選んで過剰取得を受け入れるか、細かいセルを選んで接頭辞クエリを増やすかのどちらかになります。セルの形も緯度によって歪みます。5文字のセルは横幅よりずっと縦に長く、赤道から離れるほどアスペクト比が変わります。さらに、非正規化したカラムを自分で管理することになり、更新の整合性という厄介さも付いてきます。文字列インデックスの上に載せた賢い工夫であり、その振る舞いも文字列インデックスそのものです。
空間インデックス:PostGIS GiSTとR木のファミリー
代替案は、データベースに幾何を直接理解させることです。PostGISはPostgresにgeography型と、その上のGiST(汎用探索木)インデックスを提供します。内部ではバウンディングボックスを階層的にネストするR木になっています。クエリはほとんど拍子抜けするほど単純になります。
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;ST_DWithinはインデックスを直接使います。候補を取ってから精密化するステップを手で管理する必要はなく、隣接セルのロジックも、精度のチューニングも不要です。データベースは1つの演算子で、バウンディングボックスによる事前絞り込みと、楕円体上の正確な距離計算を行います。geographyが地球の形状を考慮するので、メートル単位の意味も正しく扱われます。先ほどの100万行のテーブルで前後を比べると、同じ半径でハバースインのスキャンが約800msだったのが、GiSTインデックスを使うと約4msになりました。これはチューニングによる改善ではなく、別の競技です。
生の速度だけでなく、正しさが自動的に得られ、組み合わせやすさもおまけについてきます。円ではなくポリゴン内を検索したい? ST_Intersectsです。ルートの線の周囲にバッファを取りたい? 線分に対してST_DWithinを使います。半径を事前に決めずに最近傍を K 件取りたい? GiSTインデックス付きの<->演算子は、インデックス順のKNNを実行します。ローカル版Wikipediaサイトが実装している「近くに25件未満なら、6マイル以内で最も近い25件にフォールバック」という動作に、まさに必要なものです。ジオハッシュの接頭辞の上に段階的なフォールバックを書くと、複数の半径で試す処理を手作りすることになりますが、KNNなら、インデックスをたどり続ける1つのクエリで済みます。
コストは依存関係です。PostgresとPostGISの拡張機能が必要です(現在はマネージドPostgresならほぼどこでも使えます。RDS、Cloud SQL、Supabaseはいずれも同梱しています)。あるいはMySQLの空間機能(使えますが荒削りで、歴史的にインデックスも弱め)、またはSpatiaLiteを使うSQLiteになります。運用面の重さも引き継ぎます。SRIDを正しく管理する必要があり、書き込みはやや重くなり、小さなテーブルではプランナーが空間インデックスを使うようにときどき後押しが必要になります。
ベンチマークと正直なトレードオフ表
最近このようなワークロード向けに再実行したベンチマークの数値です。120万点(おおよそWikipediaのジオコード記事規模)、Postgres 16、都市部のランダムな座標に対する3km半径のクエリ、ウォームキャッシュの条件です。
- フルテーブルのハバースインスキャン:約800ms。戒めとしてのみ掲載。
- ジオハッシュの接頭辞(5文字のセル+8つの隣接セル)+ハバースインによる絞り込み:中央値約12ms。ただし市街地中心部のような密集地域ではセルの過剰取得により、p95は約40msになります。
- PostGIS GiSTとST_DWithin:中央値約4ms、p95約8ms。密度が上がってもほぼ横ばいです。
- PostGISのKNN(
<->)で近い順25件:約2ms。どの半径を選んだかは関係ありません。 - Redis GEOSEARCH(内部はジオハッシュ):ミリ秒未満。ただしデータセット全体がRAM上にあり、キャッシュであって信頼できる情報源ではありません。
ハードウェアやデータの形によって結果は変わりますが、私が行ったすべてのテストで順序は安定していました。空間インデックス < Bツリー上のジオハッシュ < 生のスキャンです。ジオハッシュ方式の弱点は、まさに最も重要な場所に現れます。ユーザーが集中し、1つのセルにハバースインで再チェックすべき候補が数万件もある、都市の中心部です。
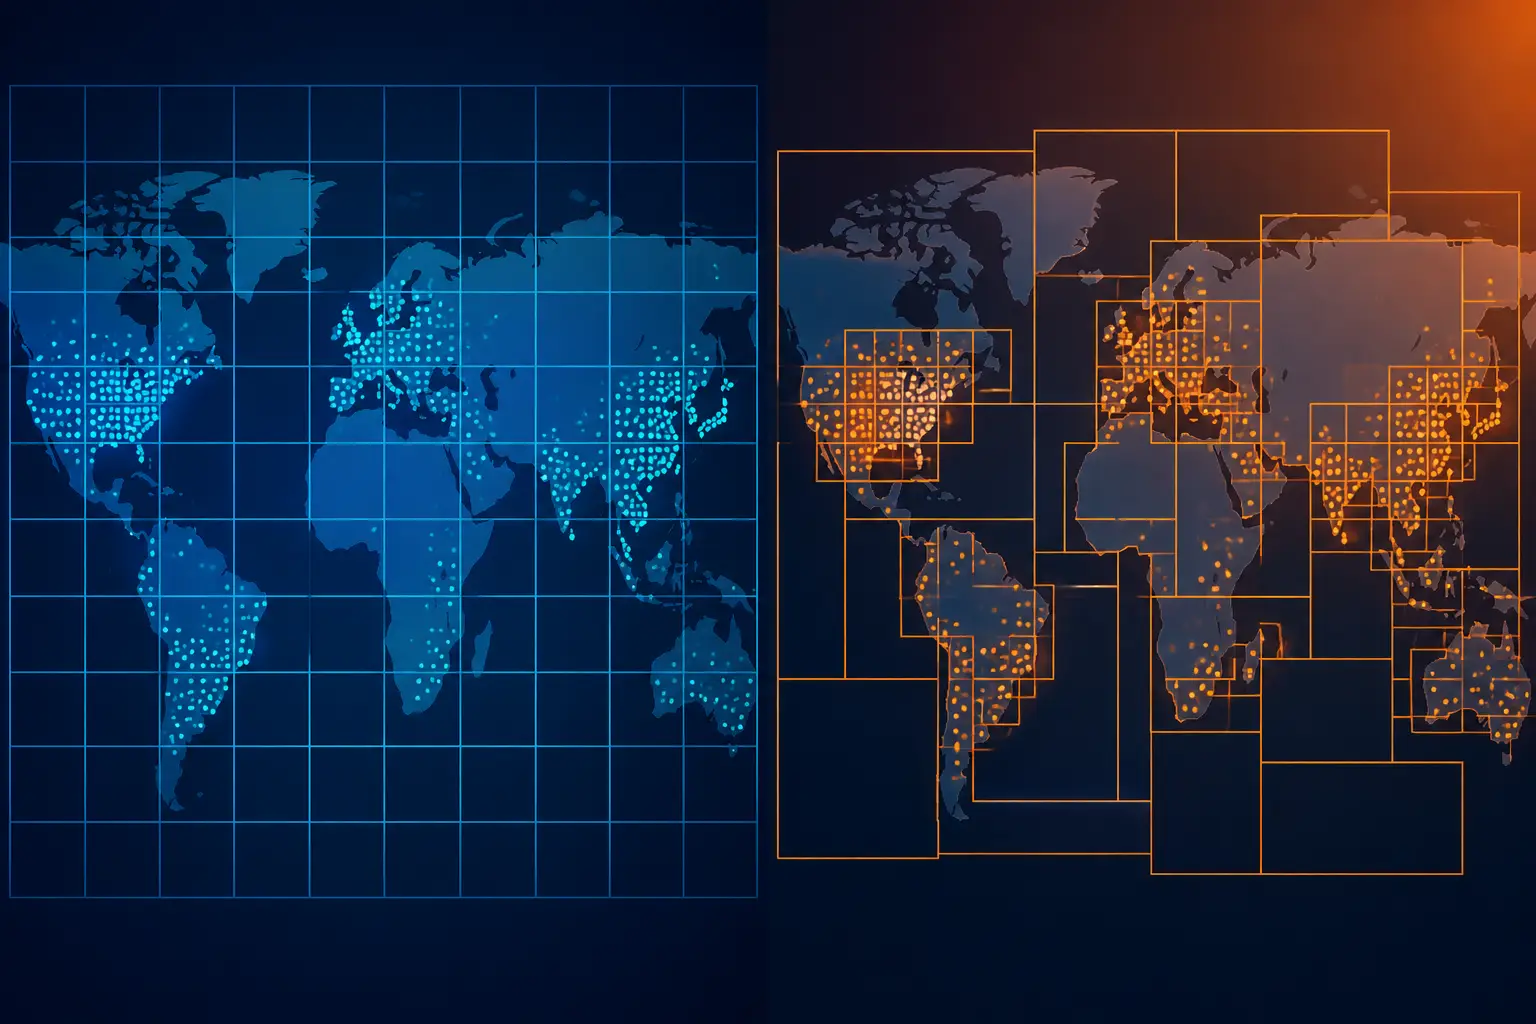
ジオハッシュが巻き返せるのは、データベースの外側での運用の単純さです。読み取り経路がRedis(ミリ秒未満のGEOSEARCH)だったり、DynamoDB(ジオハッシュの接頭辞をソートキーの条件にする)だったり、静的なデータセットをエッジに置いてブラウザでJavaScriptの文字列接頭辞を使って検索する場合です。ジオハッシュは妥協ではなく、それ自体がアーキテクチャになります。「ローカル発見」系のサイドプロジェクトの多くは、このように完全にクライアントサイドで動いています。このパターンは、私がスモールウェブこそがインターネットの最良の部分である理由で書いた小さく自己完結したWebプロジェクトとも自然に相性がよいです。静的サイト、事前計算されたインデックス、サーバーはゼロです。
半径とイソクロン:実際に提供しているのは抽象化
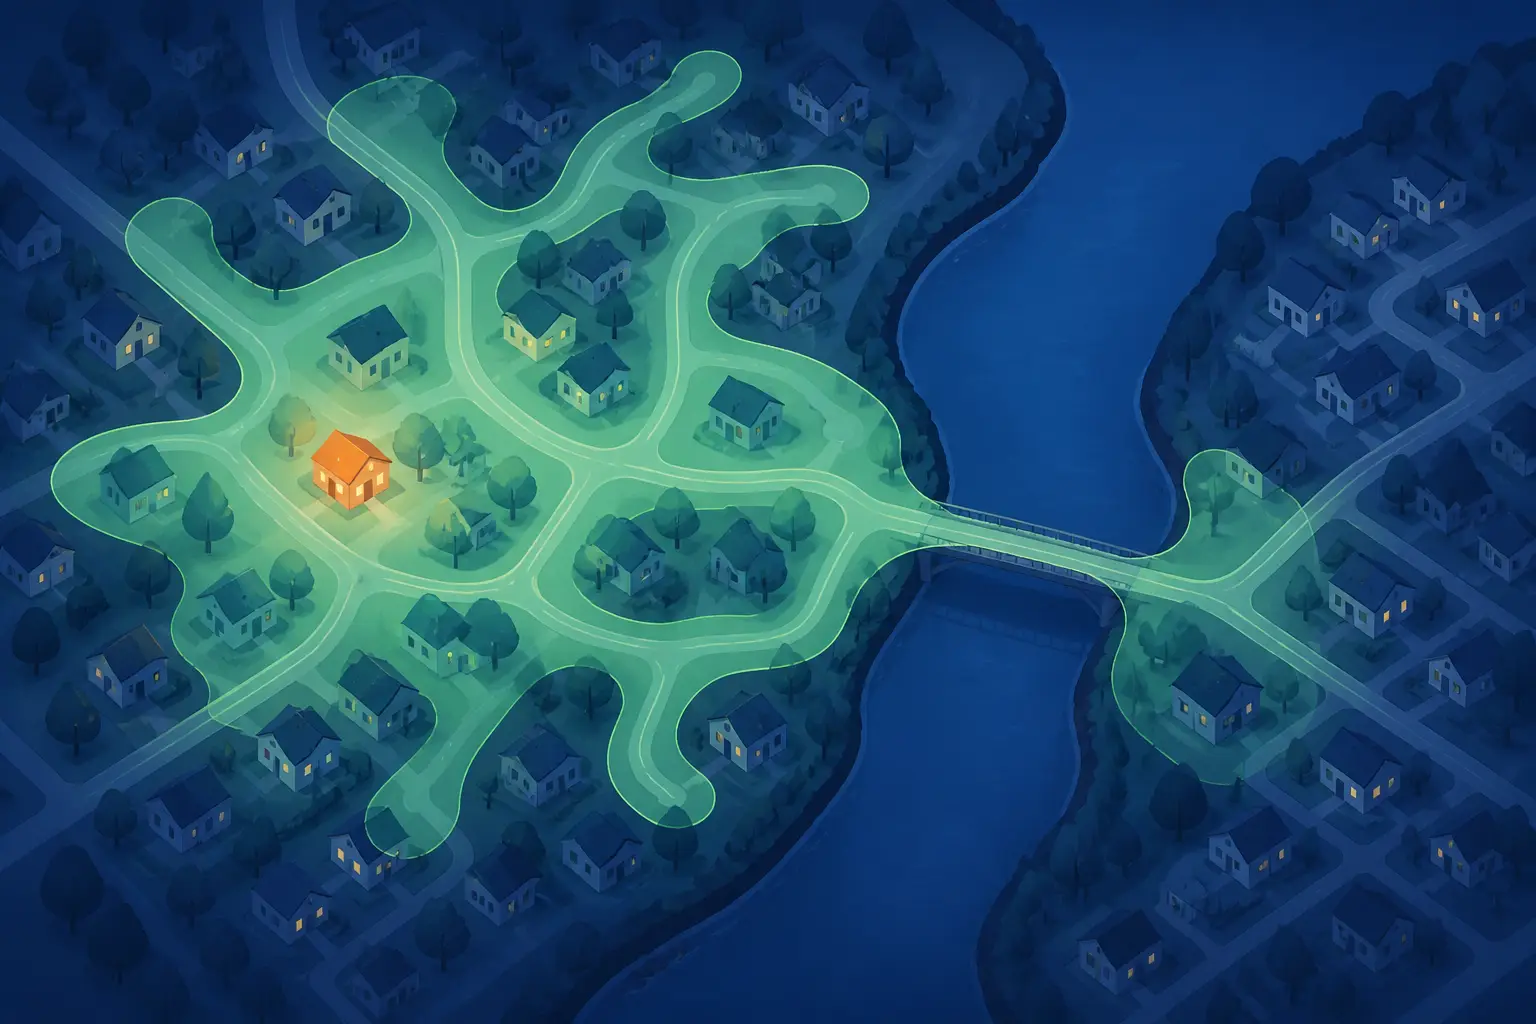
ローカル版Wikipediaプロジェクトが、やんわりと叩かれたポイントはこれです。「歩いて30分」と書いてあるのに、実際に描かれているのは直線距離3kmの円なのです。川に橋がない場所、高速道路、柵で囲まれた操車場など、円はそれを知りません。本当の「歩いて30分」はイソクロンです。実際の歩行ネットワークに沿って30分で到達できる範囲の、不規則な塊になります。直線距離で1km離れた2点でも、間に入り江があれば、歩くと40分離れていることがあります。
イソクロンを計算するには、ルーティングエンジンを動かす必要があります。OpenStreetMapのデータをOSRM、Valhalla、GraphHopperに通し、移動時間が予算に達するまで出発点から最短経路木を広げ、到達可能な領域を等値線としてポリゴンにします。地域ごとに数分のグラフ前処理が必要で、クエリごとに数十ミリ秒かかります。円ならマイクロ秒です。しかし一度ポリゴンが手に入れば、包含判定はただのST_Intersectsで、同じ空間インデックスがうまく処理してくれます。ここでは空間インデックス側がさらに引き離す場面です。ポリゴンは第一級の要素として扱えますが、ジオハッシュの接頭辞のトリックは任意の形状に対して本当に扱いにくくなります。ポリゴンを一連のセルで覆う必要があり、これはZ-orderやS2ライブラリで可能ですが、それ自体がプロジェクトになります。
正直な意見を言うと、多くのプロダクトでは円がちょうどよい「嘘」です。ユーザーはあなたの徒歩モデルを監査したりしません。結果が速く、だいたい妥当であれば気づきます。「3km以内」は「近く」とかなり相関しているので、コンテンツ閲覧機能にルーティングエンジンを入れる追加コストは正当化しにくいでしょう。配送の到着予想、配達員の配車、緊急対応の範囲など、結果に影響する約束をし始めると、円は負債になり、イソクロンがその価値を発揮します。抽象化は、間違えたときに金銭的な損失になるのか、それとも少し驚かれる程度なのかで選んでください。
データの調達:ジオコード済みWikipediaと住所検索
この方向性のものを作りたいなら、データ周りの作業は思われているよりずっと取り組みやすいです。WikipediaのTwo座標はGeoHackテンプレートのシステムから来ており、MediaWiki APIのlist=geosearchエンドポイントで照会できます。これ自体が空間インデックス上の半径検索で、プロジェクトの「近く」機能はそれをラップしたものです。多言語や記事以外のエンティティが必要なら、WikidataのプロパティP625(座標位置)が英語版Wikipediaよりずっと広くカバーしています。住所検索には、このプロジェクトはPhotonを使っています。これはOpenStreetMapのNominatimデータをもとにしたElasticsearchベースのジオコーダーで、自前でホストするのは無料です。公開デモのエンドポイントもあり、親切な人々が運用していますが、本番では叩きすぎないようにしてください。
真似する価値のある設計判断が1つあります。このサイトは位置情報をブラウザ内に保持し、共有可能なURLには決して入れません。それが正しいデフォルトであり、フィットネスアプリが位置情報とOPSECについて教えてくれることという教訓とも一致します。ユーザーの座標は、あなたのアプリが保持する中でも最もセンシティブな文字列の1つであり、それを守る最も安価な方法は、そもそもサーバーに送らないことです。ジオコーディングはクライアント側で行うか、ブラウザが直接通信するサードパーティのジオコーダーを使いましょう。何かをログに残す必要がある場合は、丸めた座標だけを保持すれば、プライバシーの姿勢はおのずと整います。
「半径に関係なく近い順にN件」というフォールバックには、半径を広げながら再試行するループを実装したくなるかもしれませんが、我慢してください。PostGISのKNN演算子なら、インデックスを使った1つのクエリで実現できます。
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
この1行で、多くのコードベースで見かける「3km、次に6km、次に10km」という再試行のはしごを丸ごと置き換えられますし、はしごの1段を回すより速いのです。
推奨
この比較から1つだけ持ち帰るなら、これです。PostGISとGiSTインデックスから始め、ストレージ層がそれを強いる場合にだけジオハッシュに手を伸ばしてください。
理由は単純です。空間インデックスは中央値のレイテンシで勝ち、密集地域のp95ではさらに大きく勝ちます。正しさでも勝ちます(メートル精度の楕円体距離、セル境界のバグがありません)。機能面でも勝ちます(ポリゴン、KNN、イソクロンの包含判定がどれも一行で書けます)。そして、書いて保守する必要のないコードの量でも勝ちます。ジオハッシュ方式では、隣接セルの計算、精度の選択、2段階のフィルタを正しく実装する必要があり、それは間違えうる箇所が3つもあるということです。しかも、それでもなお性能は劣ります。
ジオハッシュが活躍するのは、次の3つの状況に限られます。データストアが空間機能をサポートしていない場合(DynamoDB、素のRedis、CDN上の静的JSONファイルなど)、ノードをまたぐ位置情報ベースのシャーディングが必要な場合、クエリをクライアントに押し出し依存関係をゼロにしたい場合です。その場合は、ジオハッシュの隣接計算を手で書くのではなく、実績のあるライブラリを使いましょう。Nodeならngeohash、Pythonならpython-geohash、ポリゴンを扱うならS2 geometryです。
プロダクト面では、まず円を出し、正直にラベルを付けてください(「歩いて30分」ではなく「3km以内」)。農村部の利用者と都市部の利用者は密度の異なる世界に住んでいるので、半径は設定可能にしておきましょう。そして、直線距離の嘘がコストとして測定可能になり始めたときに初めて、イソクロンへ移行してください。ローカル版Wikipediaプロジェクトは、優れた機能の多くが、実は親しみやすいアイデアをまとった良い空間クエリにすぎないことを思い出させてくれる素晴らしい例です。100万件の記事、1つのインデックス、適切に選んだ1つの半径。それだけで、インターネット最大の百科事典が、まるであなたの通りについて書かれたもののように感じられるのです。