Geohash vs. Spatial Index: Nearby-Suche im Vergleich
Geohash vs. Spatial Index für Umkreissuche: Benchmarks, PostGIS-Beispiele, Radius vs. Isochrone und eine klare Empfehlung für Nearby-Suchen.
 Marcus Rodriguez
Jemand hat eine Website gebaut, die dir Wikipedia zeigt, aber nur Artikel über Orte, die innerhalb eines halbstündigen Fußwegs von deinem aktuellen Standort liegen. Das ist charmant, es ging viral, und es ist außerdem ein perfekter Anlass, über das Problem zu sprechen, auf das jede geodatenbasierte Anwendung früher oder später stößt: Geohash vs. Spatial Index – und die tiefere Frage nach Radius vs. Isochrone, wenn du bei Millionen von Zeilen beantworten willst, was sich in der Nähe eines Punktes befindet.
Ich habe diese Abfrage schon öfter gebaut, als ich zählen kann – für Restaurant-Finder, Asset-Tracking und ein Feature für Liefer-Radien, das beinahe eine Datenbank in die Knie gezwungen hätte. Die naive Variante, die jeder zuerst schreibt, ist ein Full-Table-Scan mit einer Distanzformel in der WHERE-Klausel. Sie funktioniert in der Entwicklung mit 500 Zeilen. In der Produktion mit 5 Millionen stirbt sie. Schauen wir uns also die beiden Ansätze an, die im großen Maßstab tatsächlich bestehen: geohash-basiertes Bucketing und einen richtigen Spatial Index wie GiST in PostGIS. Einer von beiden gewinnt meistens, und ich sage dir, welcher.
Die Abfrage, die jeder zuerst schreibt (und später bereut)
Wikipedia hat allein auf Englisch über eine Million geocodierte Artikel – jeder mit Breiten- und Längengrad in den Tabellen page oder geo_tags. Dein eigener Datensatz könnte aus Filialen, Nutzern, IoT-Sensoren oder allem Möglichen bestehen. Die naive Abfrage sieht so aus:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
Das ist die Haversine-Formel, und sie ist korrekt. Sie ist aber nicht indizierbar. Die Datenbank muss für jede einzelne Zeile bei jeder einzelnen Anfrage Trigonometrie berechnen. Bei einer Tabelle mit einer Million Zeilen, die ich vor einiger Zeit getestet habe, lief das auf Postgres mit warmem Cache mit etwa 800 ms pro Abfrage. Für eine Demo okay. Katastrophal bei 50 Anfragen pro Sekunde, denn dann musst du jede Sekunde 40 Sekunden Mathematik erledigen. Die Warteschlange wächst, Verbindungen stapeln sich, und plötzlich bist du der Hauptdarsteller im Incident-Channel.
Beide brauchbaren Lösungen nutzen denselben Trick: Die teure Distanzprüfung pro Zeile wird durch einen günstigen Kandidatenfilter ersetzt. Ein Index reduziert die Million Zeilen auf ein paar Hundert Kandidaten, und nur für diese berechnest du dann die exakte Distanz. Geohashes und Spatial Indizes sind zwei verschiedene Wege, diese Kandidatenfilterung umzusetzen. Genau dieser Vergleich zählt.
Wie Geohashes Geografie in String-Präfixe verwandeln
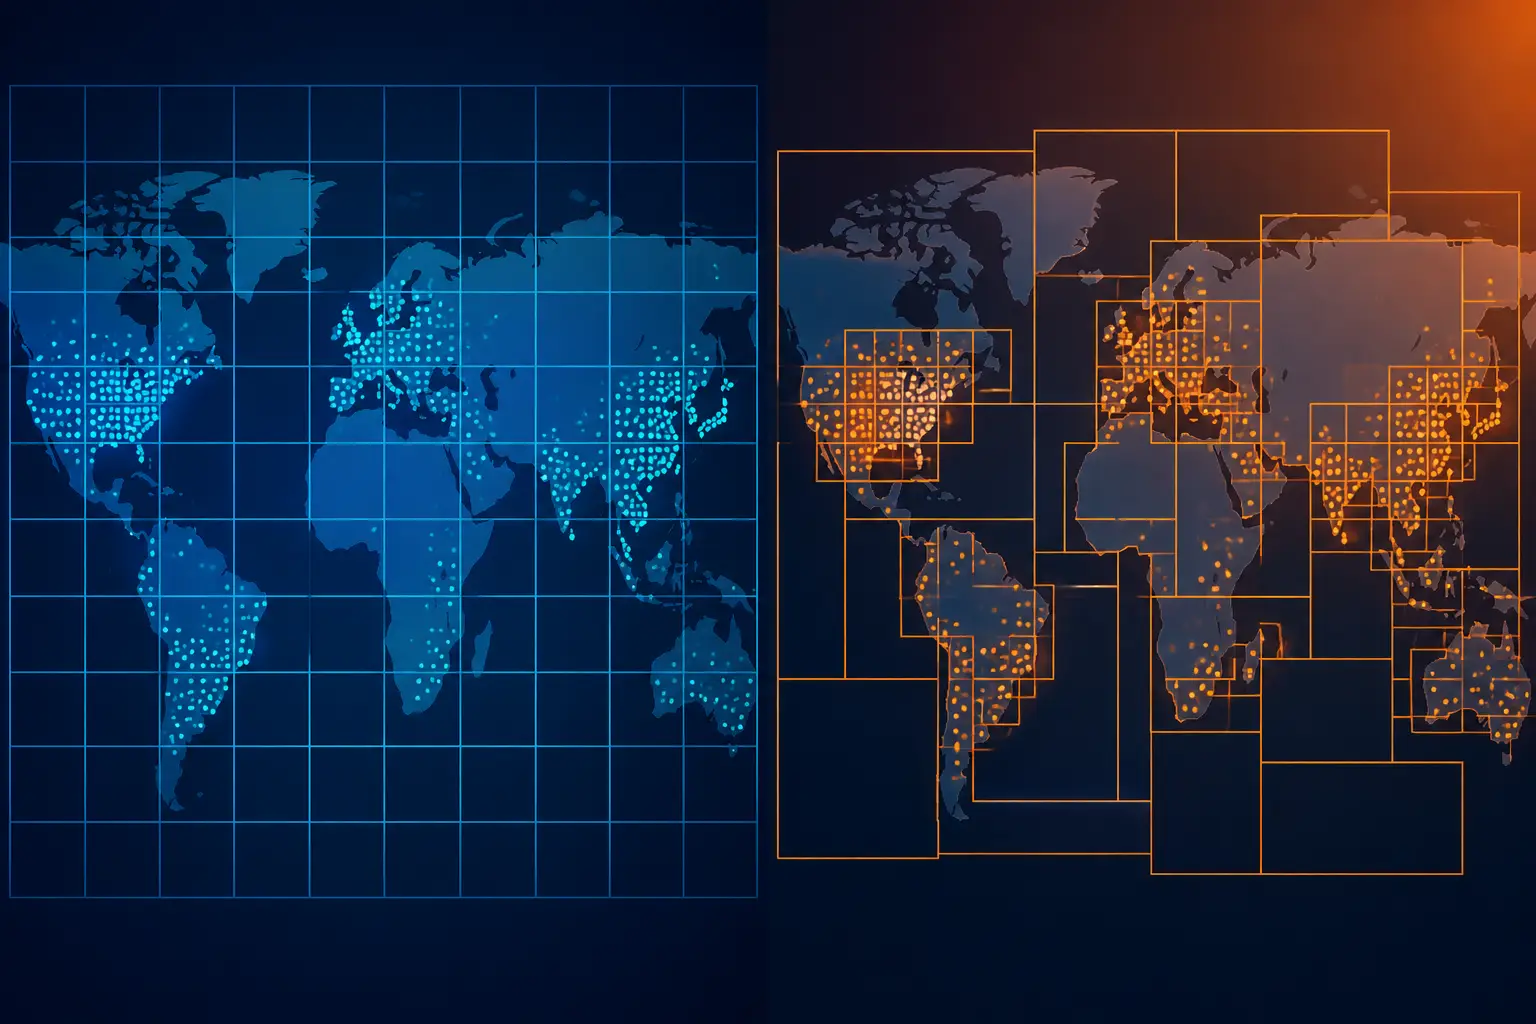
Ein Geohash kodiert ein Breiten-/Längengrad-Paar als kurze Zeichenkette, indem er den Globus wiederholt halbiert. Jedes hinzugefügte Zeichen halbiert die Zelle. „u4pruydqqvj“ ist eine Parkbank in London; „u4pruyd“ ist ein etwa 150 m großes Quadrat, das diese Bank enthält; „u4p“ ist ein etwa 40 km großes Quadrat, das die Hälfte von Süd-London umfasst. Die schöne Eigenschaft: nahe beieinanderliegende Punkte teilen sich Zeichenkettenpräfixe, und genau das macht ein simpler B-Tree-Index im Schlaf.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
Der Ablauf: Beim Schreiben berechnest du den Geohash jeder Zeile (eine reine Funktion, Mikrosekunden). Bei der Abfrage ermittelst du die Geohash-Zelle, die deinen Punkt abdeckt, mit einer Präzision, deren Zellgröße ungefähr zu deinem Radius passt, und berechnest zusätzlich deren acht Nachbarn. Dieser Teil wird oft vergessen: Ein Punkt nahe einer Zellgrenze hat Nachbarn auf der anderen Seite der Grenze. Dann filterst du die Kandidaten per Präfix und wendest auf die Überlebenden die exakte Haversine-Formel an. So gehst du von einer Million Distanzberechnungen auf vielleicht ein paar Hundert.
Der Reiz liegt in der Portabilität. Geohash-Präfixabfragen funktionieren überall, wo Strings indiziert werden: DynamoDB-Sort-Keys, Elasticsearch, Redis-Sorted-Sets (genau das nutzt GEOADD intern, nämlich einen geohash-kodierten Score in einem ZSET), SQLite oder eine sortierte Datei auf der Festplatte. Keine Erweiterungen, keine exotischen Spaltentypen. Wenn deine Infrastruktur eine NoSQL-Datenbank oder einen verwalteten Dienst ohne Geo-Unterstützung ist, sind Geohashes oft die einzige echte Option. Außerdem lassen sie sich problemlos sharden, weshalb sie in Systemen auftauchen, die Standortdaten über mehrere Knoten verteilen.
Die Schwächen sind aber real. Die Präzision ist quantisiert: Du wählst entweder eine Zellgröße, die deinen Radius grob überdeckt und dafür Overfetching in Kauf nimmt, oder kleinere Zellen und damit mehr Präfixabfragen. Die Zellgrößen verzerren sich zudem mit dem Breitengrad: Eine Zelle mit fünf Zeichen ist deutlich höher als breit, und das Seitenverhältnis verschiebt sich, je weiter du vom Äquator wegkommst. Außerdem pflegst du eine denormalisierte Spalte selbst, mit all dem Spaß, den Konsistenz beim Aktualisieren mit sich bringt. Es ist ein kluger Hack auf einem String-Index, und es verhält sich auch wie einer.
Spatial Indizes: PostGIS GiST und die R-Tree-Familie
Die Alternative besteht darin, die Geometrie direkt von der Datenbank verstehen zu lassen. PostGIS gibt Postgres einen geography-Typ und einen GiST-Index (Generalized Search Tree) darauf. Intern ist das ein R-Tree, der Bounding-Boxen hierarchisch verschachtelt. Die Abfrage wird fast peinlich einfach:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin nutzt den Index direkt. Es gibt keinen Kandidaten-und-Verfeinerungs-Schritt, den du von Hand verwaltest, keine Logik für Nachbarzellen und keine Feinabstimmung der Präzision. Die Datenbank erledigt den Bounding-Box-Vorfilter und die exakte Distanz auf dem Ellipsoid in einem einzigen Operator, mit korrekter Semantik in Metern, weil geography die Form der Erde berücksichtigt. In meinem eigenen Vorher-Nachher-Vergleich bei der Tabelle mit einer Million Zeilen wurde aus dem Haversine-Scan mit ca. 800 ms bei gleichem Radius mit dem GiST-Index etwa 4 ms. Das ist kein Tuning-Gewinn, das ist ein anderer Sport.
Abgesehen von der reinen Geschwindigkeit bekommst du Korrektheit gratis und als Bonus Komponierbarkeit. Willst du „innerhalb dieses Polygons“ statt eines Kreises? Dann ST_Intersects. Willst du einen Puffer um eine Routenlinie? Dann ST_DWithin gegen einen Linestring. Willst du K-Nearest-Neighbors, ohne vorher einen Radius zu kennen? Der Operator <-> mit einem GiST-Index liefert eine indexgeordnete KNN-Abfrage, genau das, was du für das Verhalten „weniger als 25 Ergebnisse in der Nähe? Dann die 25 nächsten innerhalb von 10 km“ brauchst, das die lokale Wikipedia-Seite umsetzt. Eine mehrstufige Fallback-Logik auf Geohash-Präfixen erfordert von Hand mehrere Radius-Versuche. Mit KNN ist es eine einzige Abfrage, die einfach weiter durch den Index läuft.
Der Preis ist die Abhängigkeit. Du brauchst Postgres plus die PostGIS-Erweiterung (die inzwischen bei verwaltetem Postgres praktisch überall dabei ist, RDS, Cloud SQL und Supabase liefern sie alle mit), oder die räumlichen Funktionen von MySQL (funktional, aber mit rauen Kanten und historisch schwächerer Indizierung), oder SQLite mit SpatiaLite. Außerdem erbst du operativen Mehraufwand: SRIDs, die du im Blick behalten musst, etwas aufwendigere Schreibvorgänge und einen Planner, der bei kleinen Tabellen gelegentlich einen Schubs braucht, um den Spatial Index tatsächlich zu verwenden.
Benchmarks und die ehrliche Abwägungstabelle
Zahlen aus einem Benchmark, den ich kürzlich für diese Art von Workload wiederholt habe: 1,2 Millionen Punkte (ungefähr die Größenordnung der geocodierten Wikipedia-Artikel), Postgres 16, Abfragen mit 3 km Radius an zufälligen urbanen Koordinaten, warmer Cache:
- Haversine-Full-Table-Scan: ca. 800 ms. Nur als warnendes Beispiel aufgeführt.
- Geohash-Präfix (Zelle mit 5 Zeichen + 8 Nachbarn) mit Haversine-Verfeinerung: ca. 12 ms Median, aber ca. 40 ms p95, wenn die Zelle in dichten Gebieten wie Stadtzentren zu viele Treffer holt.
- PostGIS GiST mit ST_DWithin: ca. 4 ms Median, ca. 8 ms p95, und bei zunehmender Dichte nahezu konstant.
- PostGIS-KNN (
<->) für die 25 nächsten: ca. 2 ms, und es ist egal, welchen Radius du sonst gewählt hättest. - Redis GEOSEARCH (intern Geohash): unter einer Millisekunde, aber dein gesamter Datensatz liegt im RAM, und es ist ein Cache, keine Quelle der Wahrheit.
Deine Ergebnisse können je nach Hardware und Datenstruktur abweichen, aber die Reihenfolge ist in allen Tests, die ich je gefahren habe, stabil: Spatial Index < Geohash auf B-Tree < roher Scan. Die Schwäche des Geohash-Ansatzes zeigt sich genau dort, wo es am meisten zählt: in dichten urbanen Kernen, also genau dort, wo die Nutzer sind und wo eine einzige Zelle Zehntausende Kandidaten enthält, die mit Haversine nachgeprüft werden müssen.
Wo Geohashes wieder Boden gutmachen, ist die operative Einfachheit außerhalb der Datenbank. Wenn dein Lesepfad Redis ist (Sub-Millisekunden-GEOSEARCH), DynamoDB (Geohash-Präfix als Bedingung am Sort-Key) oder du einen statischen Datensatz an den Edge ausliefern und im Browser mit JavaScript-Stringpräfixen abfragst, dann ist Geohash kein Kompromiss, sondern die Architektur. Mehrere Projekte für lokale Entdeckung laufen auf diese Weise komplett clientseitig, und als Muster passt es gut zu der Art kleiner, eigenständiger Webprojekte, über die ich in warum das Small Web der beste Teil des Internets ist geschrieben habe: eine statische Seite, ein vorberechneter Index, keine Server.
Radius vs. Isochrone: Die Abstraktion, die du eigentlich ausliefern musst
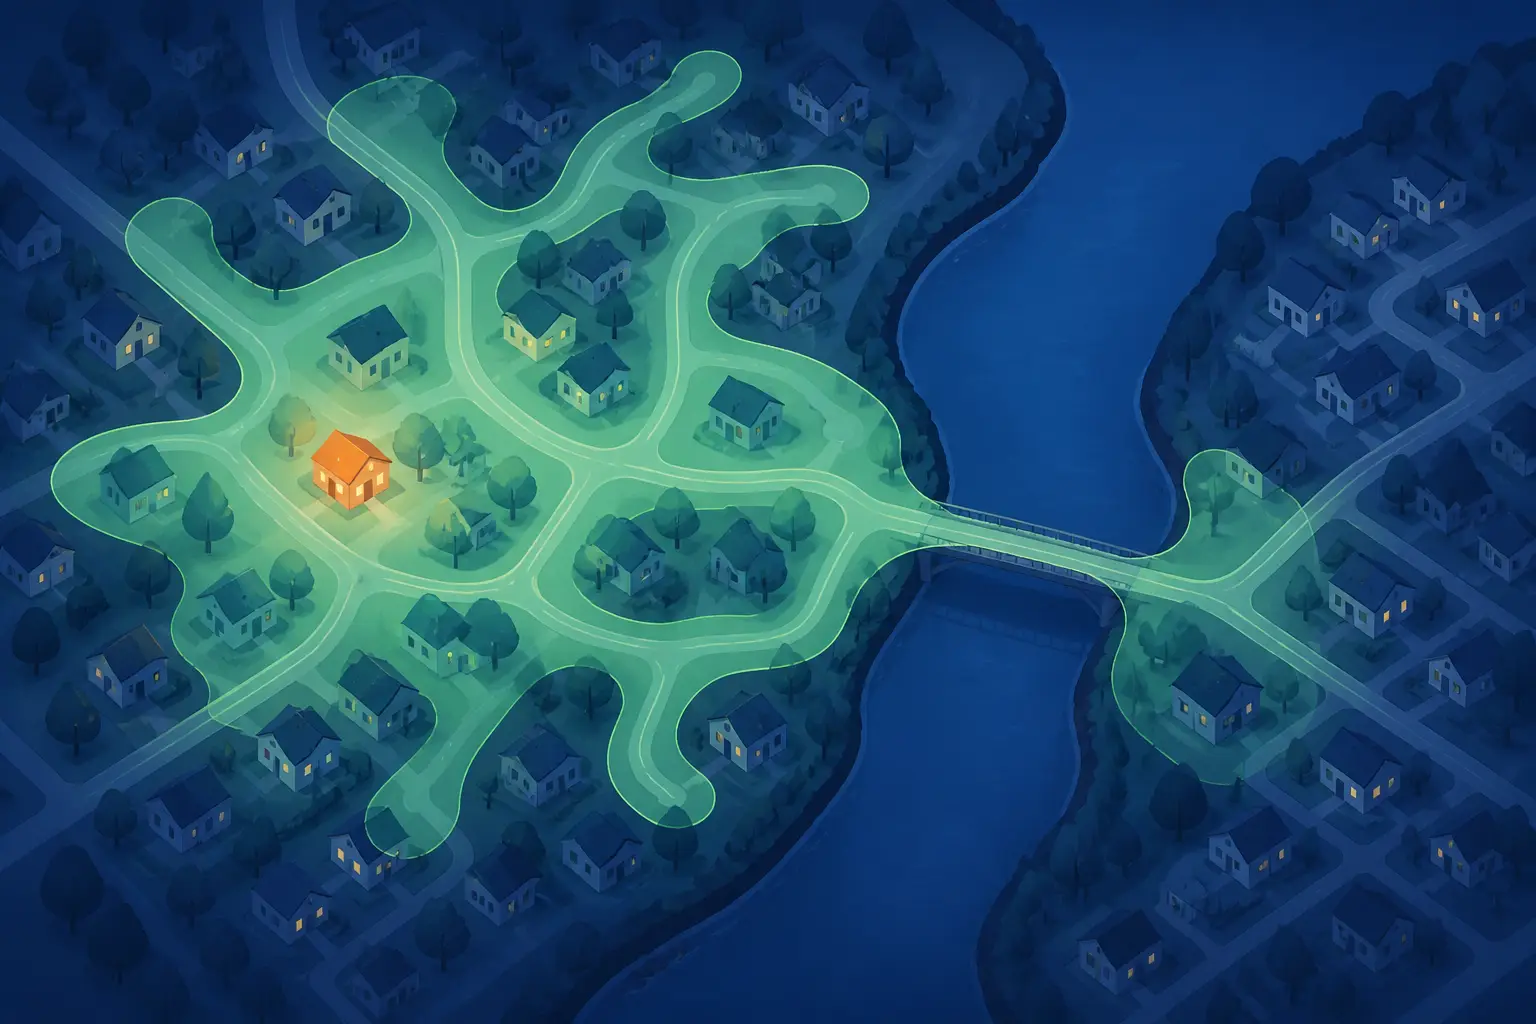
Hier liegt der Punkt, für den das lokale Wikipedia-Projekt ein wenig gerösteter wurde: Es spricht von einem „halbstündigen Fußweg“, zeichnet aber tatsächlich einen 3-km-Luftliniekreis. Ein Fluss ohne Brücke, eine Autobahn, ein eingezäunter Rangierbahnhof – der Kreis weiß davon nichts. Ein echter halbstündiger Fußweg ist eine Isochrone: die unregelmäßige Fläche aller Orte, die in 30 Minuten entlang des tatsächlichen Fußwegnetzes erreichbar sind. Zwei Punkte, die 1 km Luftlinie auseinanderliegen, können 40 Minuten Fußweg voneinander entfernt sein, wenn dazwischen eine Flussmündung liegt.
Eine Isochrone zu berechnen bedeutet, eine Routing-Engine laufen zu lassen: OpenStreetMap-Daten durch OSRM, Valhalla oder GraphHopper. Dabei expandierst du einen Baum kürzester Wege von deinem Punkt aus, bis das Zeitbudget erreicht ist, und umrandest dann die erreichbare Fläche als Polygon. Das sind pro Region Minuten an Graph-Vorverarbeitung und pro Abfrage zig Millisekunden, verglichen mit Mikrosekunden für einen Kreis. Ist das Polygon aber erst einmal da, ist die Enthaltensein-Abfrage nur noch ST_Intersects, und das erledigt derselbe Spatial Index hervorragend. Hier zieht das Lager der Spatial Indizes noch weiter davon: Polygone sind dort ein Grundbaustein, während Geohash-Präfix-Tricks bei beliebigen Formen richtig umständlich werden. Du musst das Polygon dann mit einer Menge von Zellen überdecken. Das ist machbar, für diesen Zweck gibt es Z-Order- und S2-Bibliotheken, aber es ist ein eigenes Projekt.
Meine ehrliche Meinung: Für die meisten Produkte ist der Kreis die richtige kleine Lüge. Nutzer prüfen dein Fußwegmodell nicht; sie merken nur, ob Ergebnisse schnell und halbwegs sinnvoll sind. „Innerhalb von 3 km“ korreliert gut genug mit „in der Nähe“, sodass sich die zusätzliche Infrastruktur einer Routing-Engine für ein Content-Browsing-Feature kaum rechtfertigen lässt. Sobald du Versprechen mit Folgen machst – Lieferzeiten, Kurierdisposition, Abdeckung im Notfalldienst –, wird der Kreis zur Haftungsfrage, und die Isochrone zahlt sich aus. Wähle die Abstraktion danach, ob dich ein Irrtum Geld kostet oder nur eine leichte Überraschung.
Die Datenbeschaffung: geocodierte Wikipedia und Adresssuche
Wenn du etwas in diesem Sinne bauen willst, ist die Datenaufbereitung zugänglicher, als die meisten annehmen. Die Koordinaten von Wikipedia stammen aus dem GeoHack-Template-System und lassen sich über den Endpunkt list=geosearch der MediaWiki-API abfragen. Das ist selbst eine Radiusabfrage über einen Spatial Index, und genau das verpackt das „Nearby“-Feature des Projekts. Wikidatas Property P625 (Koordinatenposition) deckt weit mehr ab als nur die englische Wikipedia, falls du mehrsprachige oder Nicht-Artikel-Entitäten brauchst. Für die Adresssuche nutzt das Projekt Photon, einen auf Elasticsearch basierenden Geocoder mit den Daten von OpenStreetMaps Nominatim. Er ist kostenlos selbst hostbar und hat einen öffentlichen Demo-Endpunkt, den großzügige Leute betreiben und den du in der Produktion nicht mit Anfragen überhäufen solltest.
Eine Gestaltungsentscheidung, die man sich abschauen sollte: Die Seite behält deinen Standort im Browser und schreibt ihn nie in teilbare URLs. Das ist der richtige Standard und spiegelt die Lektion aus was Fitness-Apps uns über Standortdaten und OPSEC beibringen. Die Koordinaten eines Nutzers gehören zu den sensibelsten Zeichenketten, die deine App je speichern wird, und der günstigste Schutz besteht darin, sie gar nicht erst an deinen Server zu schicken. Mach das Geocoding clientseitig oder über einen Drittanbieter-Geocoder, mit dem der Browser direkt kommuniziert. Behalte nur gerundete Koordinaten, falls du überhaupt etwas loggen musst, und deine Datenschutzstrategie erklärt sich praktisch von selbst.
Für den Fallback „die N nächsten, unabhängig vom Radius“ solltest du der Versuchung widerstehen, Schleifen mit wachsendem Radius zu implementieren. Der KNN-Operator von PostGIS erledigt das in einer indizierten Abfrage:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
Diese einzelne Zeile ersetzt die ganze Leiter „erst 3 km, dann 6 km, dann 10 km“, die ich in so vielen Codebasen sehe, und sie ist schneller, als eine einzelne Stufe dieser Leiter war.
Die Empfehlung
Wenn du aus diesem Vergleich nur eines mitnimmst, dann das: Starte mit PostGIS und einem GiST-Index, und greife nur dann zu Geohashes, wenn dein Storage-Layer dich dazu zwingt.
Die Begründung ist simpel. Der Spatial Index gewinnt bei der Median-Latenz, gewinnt noch deutlicher beim p95 in dichten Gebieten, gewinnt bei der Korrektheit (metergenaue Ellipsoid-Distanzen, keine Fehler an Zellgrenzen), gewinnt bei den Features (Polygone, KNN und Isochronen-Enthaltensein werden zu Einzeilern) und gewinnt bei Code, den du nicht schreiben und pflegen musst. Der Geohash-Ansatz verlangt, dass du Nachbarzellen-Berechnung, Präzisionsauswahl und einen zweistufigen Filter korrekt implementierst. Das sind drei Stellen, an denen man subtil danebenliegen kann, und das Ergebnis ist trotzdem langsamer.
Geohashes verdienen ihren Platz in genau drei Situationen: Dein Datenspeicher hat keine Geo-Unterstützung (DynamoDB, einfaches Redis, eine statische JSON-Datei auf einem CDN), du brauchst standortbasiertes Sharding über mehrere Knoten, oder du verlagerst die Abfrage in den Client und willst keinerlei Abhängigkeiten. In diesen Fällen greifst du auf eine bewährte Bibliothek zurück, etwa ngeohash in Node, python-geohash oder S2-Geometrie, wenn du Polygone abdeckst, statt die Nachbarschaftsmathematik selbst zu basteln.
Und auf der Produktseite: Liefere zuerst den Kreis aus, beschrifte ihn ehrlich („innerhalb von 3 km“ statt „ein halbstündiger Fußweg“), mach den Radius konfigurierbar, weil Landnutzer und Stadtnutzer in völlig unterschiedlichen Dichte-Welten leben, und steig erst dann auf Isochronen um, wenn die Luftlinien-Lüge dich messbar etwas kostet. Das lokale Wikipedia-Projekt ist eine schöne Erinnerung daran, dass die besten Features oft nur eine gute räumliche Abfrage sind, die eine freundliche Idee trägt. Eine Million Artikel, ein Index, ein gut gewählter Radius, und plötzlich fühlt sich die größte Enzyklopädie des Internets an, als wäre sie über deine eigene Straße geschrieben worden.