Geohash مقابل الفهرس المكاني للبحث القريب
مقارنة Geohash بالفهرس المكاني للتطبيقات الجغرافية: قياسات، أمثلة PostGIS، الدائرة مقابل isochrone، وتوصية واضحة للبحث القريب.
 Marcus Rodriguez
صنع أحدهم موقعًا يعرض لك ويكيبيديا، لكن فقط المقالات عن الأشياء التي تبعد عنك مسافة نصف ساعة مشيًا من مكانك الحالي. الفكرة ممتعة، وانتشرت بسرعة، وهي أيضًا ذريعة مثالية للحديث عن المشكلة التي تواجه كل تطبيق يعتمد على الموقع في النهاية: geohash مقابل الفهرس المكاني، والسؤال الأعمق: الدائرة أم منطقة الوصول الزمني (isochrone) عندما تحتاج إلى الإجابة عن «ما القريب من هذه النقطة؟» على ملايين السجلات؟
كتبتُ هذا الاستعلام أكثر من أن أحصيه: محددات للمطاعم، وتتبع الأصول، وميزة نطاق التوصيل التي كادت أن تُسقط قاعدة بيانات. النسخة الساذجة التي يكتبها الجميع أولًا هي مسح كامل للجدول مع معادلة المسافة داخل شرط WHERE. تعمل في بيئة التطوير مع 500 سجل، وتنهار في الإنتاج مع 5 ملايين. لذا دعونا نقارن النهجين اللذين يصمدان فعلًا أمام التوسع: التجميع حسب geohash والفهرس المكاني الحقيقي مثل GiST في PostGIS. أحدهما يفوز في معظم الأحيان، وسأخبرك أيهما.
الاستعلام الذي يكتبه الجميع أولًا (ويندمون عليه)
تحتوي ويكيبيديا على أكثر من مليون مقال مُحدَّد جغرافيًا بالإنجليزية وحدها، ولكل مقال خط عرض وخط طول في جدولي page أو geo_tags. بياناتك الخاصة قد تكون متاجر أو مستخدمين أو حساسات إنترنت الأشياء، أي شيء. الاستعلام الساذج يبدو هكذا:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
هذه صيغة هافرسين، وهي صحيحة. لكنها غير قابلة للفهرسة. تحتاج قاعدة البيانات إلى حساب المثلثات لكل صف في كل طلب. في جدول من مليون صف قست أداءه قبل فترة، استغرق الاستعلام قرابة 800 ملي ثانية في Postgres مع ذاكرة تخزين مؤقت ساخنة. مقبول في العرض التوضيحي، لكنه كارثي عند 50 طلبًا في الثانية، حيث ستحتاج إلى 40 ثانية من الحسابات في كل ثانية. تتراكم الطلبات في الطابور، وتتكدس الاتصالات، وفجأة تصبح أنت بطل قناة الحوادث.
يشترك الحلان الحقيقيان في الحيلة نفسها: استبدال فحص المسافة المكلف لكل صف بفلتر مرشحين رخيص. نزّل المليون صف إلى بضع مئات من المرشحين باستخدام فهرس، ثم نفذ الحساب الدقيق للمسافة على هؤلاء فقط. الـ geohash والفهارس المكانية طريقتان مختلفتان لتنفيذ تصفية المرشحين. وهذه هي المقارنة المهمة.
كيف تحوّل الـ Geohash الجغرافيا إلى بادئات نصية
يرمّز geohash زوج خط العرض وخط الطول إلى سلسلة نصية قصيرة عبر تقسيم الكرة الأرضية مرارًا. كل حرف تضيفه يقسم الخلية إلى النصف. السلسلة «u4pruydqqvj» تمثل مقعدًا في لندن، و«u4pruyd» مربعًا بمساحة نحو 150 مترًا يحتوي ذلك المقعد، و«u4p» مربعًا بحجم نحو 40 كيلومترًا يغطي نصف جنوب لندن. الخاصية الجميلة: النقاط المتقاربة تتشارك بادئات النص، ومطابقة البادئات هي بالضبط ما يفعله فهرس B-tree البسيط دون أن يبذل جهدًا.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
سير العمل: عند الكتابة، نحسب geohash لكل صف (دالة نقية تستغرق ميكروثانية). وعند الاستعلام، نحسب خلية الـ geohash التي تغطي نقطتك بدقة يقارب حجمها نصف قطر البحث، ثم نحسب جيرانها الثمانية أيضًا. هذا الجزء ينساه الناس غالبًا، لأن النقطة القريبة من حافة الخلية ستكون جيرانها عبر الحدود. نصفّي المرشحين بالبادئة، ثم نطبق هافرسين الدقيق على الناجين. تنتقل من مليون حساب مسافة إلى بضع مئات تقريبًا.
الميزة الأبرز هي القابلية للنقل. استعلامات بادئات geohash تعمل في أي نظام يفهرس النصوص: مفاتيح الفرز في DynamoDB، وElasticsearch، ومجموعات Redis المرتبة (وهذا ما يستخدمه GEOADD داخليًا، أي درجة مرمّزة بـ geohash في ZSET)، وSQLite، وملف مرتب على القرص. لا حاجة إلى إضافات ولا أنواع أعمدة غريبة. إذا كانت بنيتك التحتية قاعدة NoSQL أو خدمة مُدارة بلا دعم مكاني، فغالبًا لا يكون الـ geohash خيارًا آخر حقيقيًا. كما أنه سهل التجزئة بين العقد، ولهذا يظهر في الأنظمة التي توزّع بيانات الموقع على عدة خوادم.
لكن نقاط ضعفه حقيقية. الدقة مكمّاة: تختار حجم خلية أكبر من نصف قطرك وتتحمل جلب بيانات زائدة، أو تختار خلايا أصغر فتصدر استعلامات بادئات أكثر. كما أن أحجام الخلايا تتشوه مع خط العرض، فالخلية ذات 5 أحرف أطول بكثير من عرضها، وتتغير نسبة أبعادها كلما ابتعدت عن خط الاستواء. وعليك أن تحافظ بنفسك على عمود مكرر البيانات، مع كل ما يعنيه ذلك من تحديات في اتساق التحديثات. إنها حيلة ذكية فوق فهرس نصي، وتتصرف كفهرس نصي.
الفهارس المكانية: PostGIS مع GiST وعائلة R-Tree
البديل هو أن تجعل قاعدة البيانات تفهم الهندسة بشكل أصلي. يمنح PostGIS نظام Postgres نوع البيانات geography وفهرس GiST (شجرة البحث المعممة) فوقه، وهو داخليًا R-tree يتداخل فيه صناديق الحدود بشكل هرمي. يصبح الاستعلام بسيطًا إلى حد مُحرج:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin يستخدم الفهرس مباشرة، دون خطوة مرشحين-ثم-تنقيح تديرها بيدك، ودون منطق خلايا الجوار، ودون ضبط للدقة. تنفذ قاعدة البيانات مرشح الصندوق المحيط وحساب المسافة الدقيقة على الشكل الإهليلجي للأرض في عملية واحدة، مع دلالات صحيحة بالمتر لأن geography يأخذ شكل الأرض في الحسبان. في قياس قبل وبعد أجريته على جدول المليون صف: تحوّل استعلام هافرسين من 800 ملي ثانية إلى نحو 4 ملي ثوانٍ مع فهرس GiST بنفس نصف القطر. هذا ليس تحسينًا في الضبط، بل لعبة مختلفة تمامًا.
إلى جانب السرعة الخام، تحصل على الصحة المنطقية مجانًا، وقابلية تركيب كمكافأة. تريد «داخل هذا المضلع» بدل الدائرة؟ ST_Intersects. تريد منطقة عازلة حول خط مسار؟ ST_DWithin مقابل linestring. تريد أقرب K جيران دون معرفة نصف القطر مسبقًا؟ عامل <-> مع فهرس GiST ينفذ KNN مرتبًا حسب الفهرس، وهذا بالضبط ما تحتاجه لسلوك «أقل من 25 نتيجة قريبة؟ ارجع إلى أقرب 25 ضمن 6 أميال» الذي يطبقه موقع ويكيبيديا المحلي. كتابة منطق احتياطي متدرج فوق بادئات geohash تعني برمجة محاولات متعددة لنصف القطر يدويًا؛ أما مع KNN فهو استعلام واحد يتابع المرور عبر الفهرس.
الثمن هو الاعتماد على إضافة. تحتاج إلى Postgres مع إضافة PostGIS (وهي شائعة جدًا اليوم في Postgres المُدار: RDS وCloud SQL وSupabase تأتي بها جميعًا)، أو دعم MySQL المكاني (وظيفي لكنه أقل نضجًا وفهرسته أضعف تاريخيًا)، أو SQLite مع SpatiaLite. وترث أيضًا ثقلًا تشغيليًا: معرّفات SRID للأشكال الهندسية تحتاج إلى متابعة دقيقة، وكتابات أثقل قليلًا، ومخطط تنفيذ قد يحتاج أحيانًا إلى دفعة ليستخدم الفهرس المكاني فعلًا على الجداول الصغيرة.
المقاييس وجدول المفاضلة الصادق
أرقام من قياس أعدت تشغيله مؤخرًا لهذا النوع من الأحمال: 1.2 مليون نقطة (تقريبًا بحجم المقالات المُحدَّدة جغرافيًا في ويكيبيديا)، وPostgres 16، واستعلامات بنصف قطر 3 كم عند إحداثيات حضرية عشوائية، مع ذاكرة تخزين مؤقت ساخنة:
- مسح كامل للجدول بهافرسين: نحو 800 ملي ثانية. ذُكر هنا فقط كتحذير.
- بادئة geohash (خلية من 5 أحرف + 8 جيران) مع تنقيح هافرسين: نحو 12 ملي ثانية كوسيط، لكن نحو 40 ملي ثانية عند النسبة المئوية 95 عندما تجلب الخلية بيانات زائدة في المناطق الكثيفة مثل وسط المدن.
- PostGIS GiST مع ST_DWithin: نحو 4 ملي ثوانٍ كوسيط، ونحو 8 ملي ثوانٍ عند النسبة 95، وتبقى ثابتة تقريبًا مع زيادة الكثافة.
- KNN في PostGIS (
<->) لأقرب 25: نحو 2 ملي ثانية، ولا يهتم بنصف القطر الذي كنت ستختاره. - Redis GEOSEARCH (يعتمد على geohash داخليًا): أقل من ملي ثانية، لكن كامل بياناتك يعيش في الذاكرة العشوائية، وهو ذاكرة تخزين مؤقت لا مصدر للحقيقة.
قد تختلف النتائج حسب الأجهزة وشكل البيانات، لكن الترتيب ثابت في كل اختبار أجريته: فهرس مكاني < geohash على B-tree < مسح خام. تظهر نقطة ضعف نهج geohash تحديدًا حيث تكون الأهمية الأكبر، أي في قلب المدن الكثيفة، حيث تحتوي خلية واحدة على عشرات الآلاف من المرشحين لإعادة فحصهم بهافرسين.
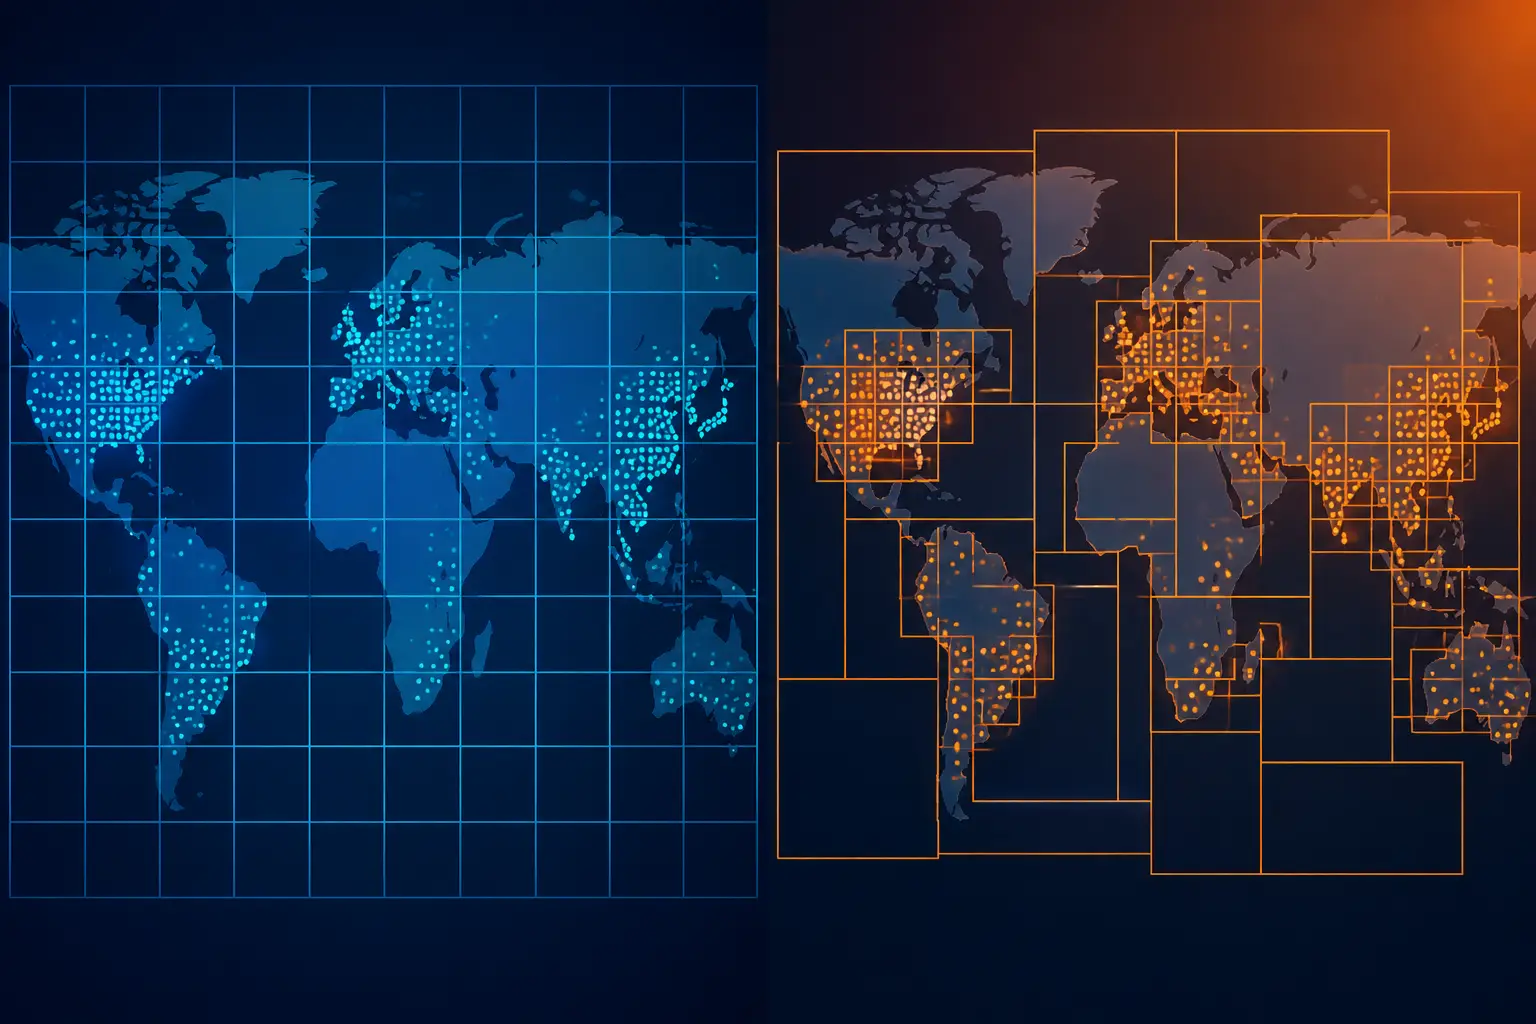
حيث يستعيد geohash أرضيته هو في البساطة التشغيلية خارج قاعدة البيانات. إذا كان مسار القراءة لديك Redis (وهو GEOSEARCH بأقل من ملي ثانية)، أو DynamoDB (بادئة geohash كشرط مفتاح الفرز)، أو كنت تشحن مجموعة بيانات ثابتة إلى الحافة وتستعلم بالبادئات النصية في JavaScript داخل المتصفح، فإن geohash ليس حلًا وسطًا، بل هو المعمارية نفسها. تعمل عدة مشاريع «اكتشاف محلي» جانبية بالكامل من جهة العميل بهذه الطريقة، وهذا النمط يتناسب بشكل طبيعي مع المشاريع الويب الصغيرة المستقلة التي كتبت عنها في لماذا الويب الصغير هو أفضل جزء في الإنترنت: موقع ثابت، وفهرس مُحسَب مسبقًا، وصفر خوادم.
الدائرة مقابل منطقة الوصول الزمني: التجريد الذي تشحنه فعلًا
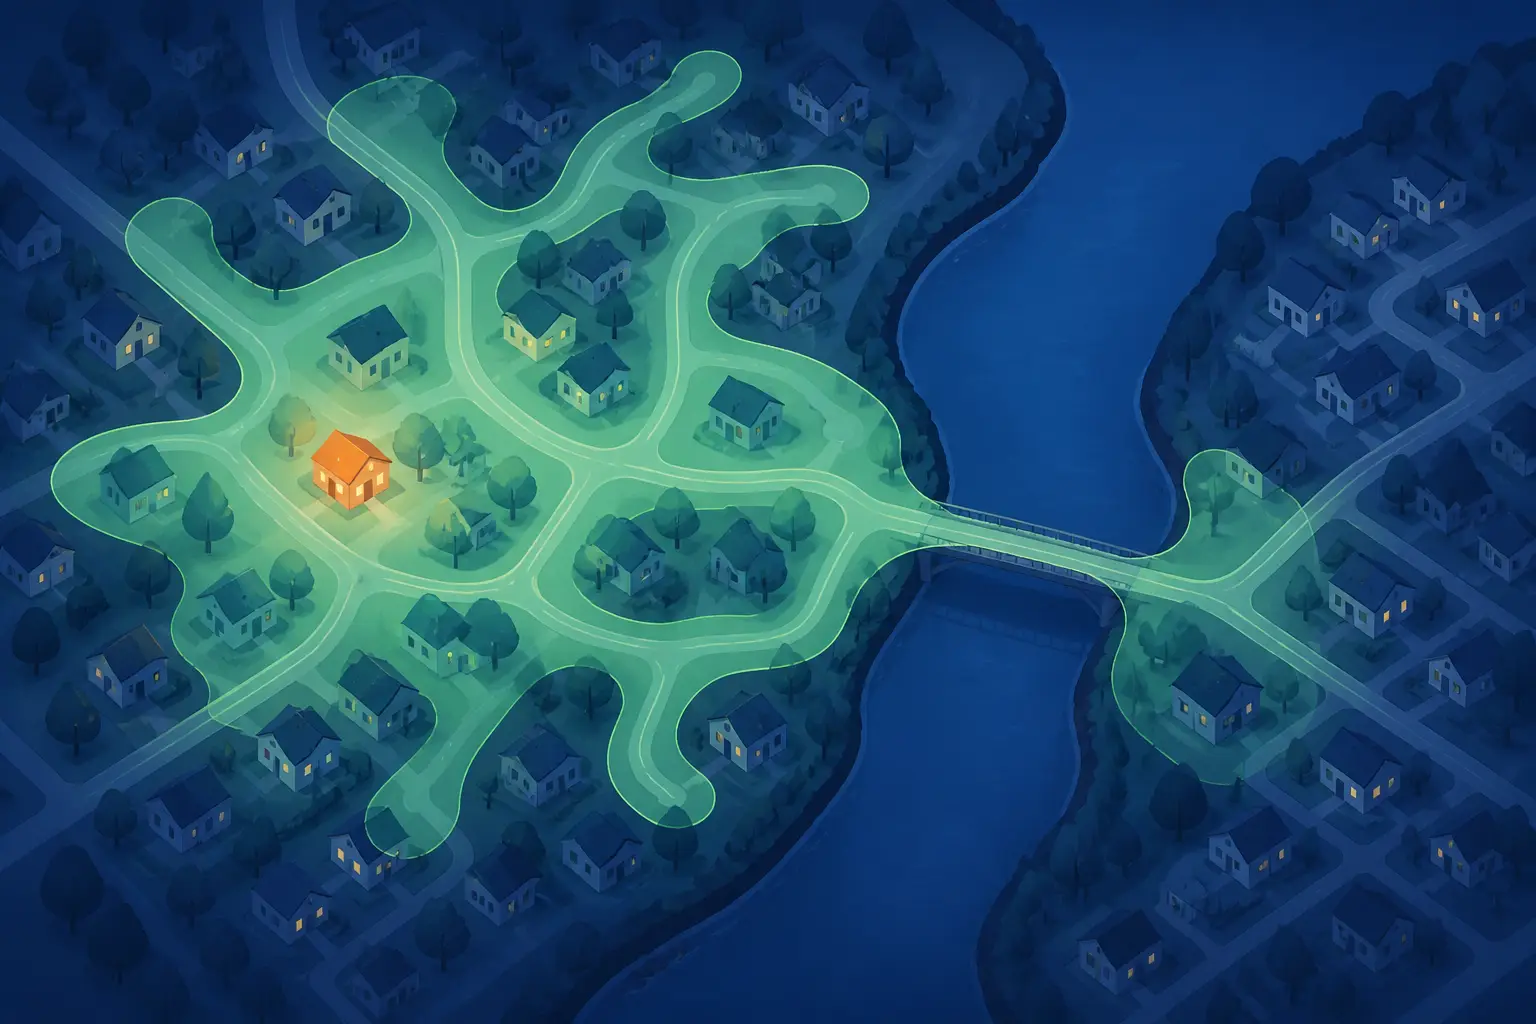
الشيء الذي تعرض له مشروع ويكيبيديا المحلي للنقد اللطيف: يقول «نصف ساعة مشيًا»، لكنه يرسم فعليًا دائرة بنصف قطر 3 كم بخط مستقيم (crow-flies). نهر بلا جسر، وطريق سريع، وساحة سكك حديدية مسيّجة، الدائرة لا تعرف شيئًا عن ذلك. المشي الحقيقي لمدة نصف ساعة هو isochrone: المنطقة غير المنتظمة لكل ما يمكن الوصول إليه في 30 دقيقة على شبكة المشاة الفعلية. نقطتان تبعدان 1 كم بخط مستقيم قد تكونان على بعد 40 دقيقة مشيًا إذا كان هناك مصب نهر بينهما.
حساب isochrone يعني تشغيل محرك توجيه، مثل بيانات OpenStreetMap عبر OSRM أو Valhalla أو GraphHopper، وتوسيع شجرة أقصر المسارات من نقطتك حتى تصل مدة السفر إلى الميزانية، ثم رسم خطوط كنتورية للمنطقة القابلة للوصول كمضلع. هذا يستغرق دقائق من معالجة الرسم البياني لكل منطقة، وعشرات الملي ثوانٍ لكل استعلام، مقابل ميكروثوانٍ للدائرة. لكن بعد أن يصبح لديك المضلع، فإن استعلام الاحتواء هو مجرد ST_Intersects، وهو ما يتعامل معه الفهرس المكاني نفسه بكفاءة. هذه إحدى الحالات التي يتقدم فيها معسكر الفهارس المكانية أكثر: المضلعات مواطن من الدرجة الأولى هناك، بينما تصبح حيل بادئات geohash صعبة للأشكال العشوائية (تنتهي بتغطية المضلع بمجموعة من الخلايا، وهذا ممكن، وتوجد مكتبات Z-order وS2 لذلك، لكنه مشروع بحد ذاته).
رأيي الصادق: في معظم المنتجات الدائرة هي الكذبة الصحيحة. المستخدمون لا يدققون في نموذج المشي لديك؛ يلاحظون أن النتائج سريعة ومعقولة تقريبًا. عبارة «ضمن 3 كم» تتطابق بما يكفي مع «قريب»، لذلك يصعب تبرير البنية التحتية الإضافية لمحرك التوجيه لميزة تصفح محتوى. لكن لحظة وعد لها عواقب، مثل تقديرات وصول التوصيل، وإرسال السائقين، وتغطية الاستجابة للطوارئ، تصبح الدائرة عبئًا والـ isochrone يبرر نفسه. اختر التجريد بناءً على ما إذا كان الخطأ سيكلفك مالًا أم مجرد استغراب بسيط.
مصادر البيانات: ويكيبيديا المُحدَّدة جغرافيًا والبحث عن العناوين
إذا أردت بناء شيء بهذه الروح، فإن سباكة البيانات أسهل مما يظن الناس. تأتي إحداثيات ويكيبيديا من نظام قوالب GeoHack، ويمكن الاستعلام عنها عبر نقطة list=geosearch في MediaWiki API، وهي نفسها استعلام نصف قطر فوق فهرس مكاني، وهي ما يغلفه ميزة «قريب» في المشروع. الخاصية P625 في Wikidata (موقع الإحداثيات) تغطي أكثر بكثير من ويكيبيديا الإنجليزية إذا أردت كيانات متعددة اللغات أو غير مقالات. أما للبحث عن العناوين، فيستخدم المشروع Photon، وهو مرمّز جغرافي مبني على Elasticsearch ومستند إلى بيانات Nominatim من OpenStreetMap، ومجاني للاستضافة الذاتية، مع نقطة نهاية تجريبية عامة يشغلها أشخاص كرماء، ولا يجب أن تضغط عليها في الإنتاج.
قرار تصميم يستحق السرقة: يحتفظ الموقع بموقعك في المتصفح ولا يضعه أبدًا في روابط قابلة للمشاركة. هذا الافتراض الصحيح، ويعكس الدرس من ما تعلمنا إياه تطبيقات اللياقة عن بيانات الموقع وOPSEC: إحداثيات المستخدم من أكثر السلاسل حساسية التي سيحتفظ بها تطبيقك، وأرخص طريقة لحمايتها هي ألا ترسلها إلى خادمك أصلًا. نفّذ الترميز الجغرافي من جهة العميل أو عبر مرمّز طرف ثالث يتصل به المتصفح مباشرة، واحتفظ فقط بإحداثيات مقرّبة إذا اضطررت لتسجيل أي شيء، وستتشكل سياسة الخصوصية لديك من تلقاء نفسها.
أما لبديل «أقرب N بغض النظر عن نصف القطر»، فقاوم رغبة تنفيذ حلقات إعادة محاولة بنصف قطر متوسع. يُنجز عامل KNN في PostGIS ذلك باستعلام واحد مفهرس:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
هذا السطر الواحد يحل محل سلسلة «جرّب 3 كم، ثم 6 كم، ثم 10 كم» التي أراها في كثير من قواعد الأكواد، وهو أسرع من جولة واحدة من تلك السلسلة.
التوصية
إذا أخذت شيئًا واحدًا من هذه المقارنة، فخذ هذا: ابدأ بـ PostGIS وفهرس GiST، ولا تلجأ إلى geohash إلا عندما تفرض عليك طبقة التخزين ذلك.
المنطق بسيط. الفهرس المكاني يفوز في زمن الاستجابة الوسيط، ويفوز أكثر في النسبة 95 بالمناطق الكثيفة، ويفوز في الصحة (مسافات شكل إهليلجي دقيقة بالمتر، دون أخطاء على حواف الخلايا)، ويفوز في الميزات (المضلعات وKNN واحتواء isochrone كلها تصبح سطرًا واحدًا)، ويفوز في الكود الذي لا تضطر لكتابته وصيانته. نهج geohash يتطلب منك تنفيذ حساب الجيران الصحيح واختيار الدقة ومرشح من مرحلتين، أي ثلاثة مواضع يمكن أن تخطئ فيها بهدوء، لتصل إلى أداء ما زال أسوأ.
يكسب geohash مكانه في ثلاث حالات بالضبط: عندما لا يدعم مخزن البيانات المكاني (DynamoDB أو Redis العادي أو ملف JSON ثابت على CDN)، أو عندما تحتاج إلى تقسيم حسب الموقع عبر العقد، أو عندما تدفع الاستعلام إلى العميل وتريد صفر اعتماديات. في هذه الحالات، اعتمد على مكتبة مجربة، مثل ngeohash في Node أو python-geohash أو هندسة S2 إذا كنت تغطي مضلعات، بدلًا من كتابة حساب الجيران يدويًا.
وعلى جانب المنتج: أطلق الدائرة أولًا، وسمّها بصدق («ضمن 3 كم» بدلًا من «نصف ساعة مشيًا»)، واجعل نصف القطر قابلًا للضبط لأن مستخدمي الريف ومستخدمي المدن يعيشون في عوالم كثافة مختلفة، ولا تنتقل إلى isochrone إلا عندما تبدأ كذبة الخط المستقيم بتكلفتك شيئًا قابلًا للقياس. مشروع ويكيبيديا المحلي تذكير لطيف بأن أفضل الميزات غالبًا ليست سوى استعلام مكاني جيد يرتدي فكرة ودودة. مليون مقالة، فهرس واحد، ونصف قطر مختار جيدًا، وفجأة تبدو أكبر موسوعة في الإنترنت كأنها كُتبت عن شارعك.