Geohash vs índice espacial para búsqueda de cercanos
Geohash vs índice espacial para apps con geolocalización: benchmarks, ejemplos con PostGIS, radio vs isócrona y una recomendación clara para búsquedas cercanas.
 Marcus Rodriguez
Alguien creó un sitio que te muestra Wikipedia, pero solo los artículos sobre cosas a menos de media hora caminando desde donde estés. Es encantador, se volvió viral y, además, es una excusa perfecta para hablar del problema con el que tarde o temprano choca cualquier aplicación con geolocalización: geohash vs índice espacial, y la pregunta más profunda de radio vs isócrona cuando necesitas responder «¿qué hay cerca de este punto?» sobre millones de filas.
He escrito esta consulta más veces de las que puedo contar: buscadores de restaurantes, seguimiento de activos, una función de radio de entrega que casi tumba una base de datos. La versión ingenua que todo el mundo escribe primero es un escaneo completo de la tabla con una fórmula de distancia en el WHERE. Funciona en desarrollo con 500 filas. Muere en producción con 5 millones. Así que comparemos los dos enfoques que realmente sobreviven a la escala: el bucketing basado en geohash y un índice espacial como el GiST de PostGIS. Uno de ellos gana la mayoría de las veces, y te diré cuál.
La consulta que todos escriben primero (y luego lamentan)
Wikipedia tiene más de un millón de artículos geocodificados solo en inglés, cada uno con latitud y longitud en las tablas page o geo_tags. Tu propio dataset puede ser tiendas, usuarios, sensores IoT o lo que sea. La consulta ingenua se ve así:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
Esa es la fórmula del haversine, y es correcta. También es no indexable. La base de datos tiene que calcular trigonometría en cada fila, en cada petición. En una tabla de un millón de filas que medí hace un tiempo, esto tardaba unos 800 ms por consulta en Postgres con caché caliente. Bien para una demo. Catastrófico con 50 peticiones por segundo, porque ahora tienes que hacer 40 segundos de cálculos cada segundo. La cola crece, las conexiones se acumulan y de repente eres el protagonista del canal de incidencias.
Ambas soluciones reales comparten el mismo truco: sustituir la costosa comprobación de distancia por fila por un filtro barato de candidatos. Reduces el millón de filas a unos cientos de candidatos usando un índice y luego aplicas el cálculo exacto de distancia solo a esos. Los geohashes y los índices espaciales son dos formas distintas de hacer ese filtrado de candidatos. Esa es la comparación que importa.
Cómo los geohashes convierten la geografía en prefijos de cadenas
Un geohash codifica un par latitud/longitud como una cadena corta dividiendo repetidamente el globo por la mitad. Cada carácter que añades reduce la celda a la mitad. «u4pruydqqvj» es un banco en Londres; «u4pruyd» es un cuadrado de unos 150 m que contiene ese banco; «u4p» es un cuadrado de unos 40 km que cubre la mitad del sur de Londres. La propiedad maravillosa: los puntos cercanos comparten prefijos, y el emparejamiento de prefijos es exactamente lo que hace un índice B-tree aburrido sin esfuerzo.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
El flujo de trabajo: en el momento de escritura, calculas el geohash de cada fila (una función pura, microsegundos). En el momento de la consulta, calculas la celda de geohash que cubre tu punto con una precisión cuyo tamaño de celda coincida aproximadamente con tu radio, y luego calculas también sus ocho vecinas. Esta es la parte que la gente olvida, porque un punto cerca del borde de una celda tendrá vecinos al otro lado de la frontera. Filtras candidatos por prefijo y luego aplicas el haversine exacto a los supervivientes. Pasas de un millón de cálculos de distancia a quizás unos cientos.
Lo atractivo es la portabilidad. Las consultas por prefijo de geohash funcionan en cualquier cosa que indexe cadenas: claves de ordenación de DynamoDB, Elasticsearch, conjuntos ordenados de Redis (eso es lo que usa GEOADD por dentro: una puntuación codificada en geohash dentro de un ZSET), SQLite, un archivo ordenado en disco. Sin extensiones, sin tipos de columna exóticos. Si tu infraestructura es un almacén NoSQL o un servicio gestionado sin soporte espacial, los geohashes suelen ser tu única opción real. Además, son trivialmente particionables, por eso aparecen en sistemas que reparten datos de ubicación entre nodos.
Las debilidades, eso sí, son reales. La precisión está cuantizada: eliges un tamaño de celda que sea un superconjunto grueso de tu radio y asumes el sobrefetch, o eliges celdas más pequeñas y lanzas más consultas por prefijo. Además, los tamaños de celda se distorsionan con la latitud: una celda de 5 caracteres es mucho más alta que ancha, y la relación de aspecto cambia a medida que te alejas del ecuador. Y tú mismo mantienes una columna desnormalizada, con toda la diversión de la consistencia en actualizaciones que eso implica. Es un truco ingenioso sobre un índice de cadenas, y se comporta como tal.
Índices espaciales: GiST de PostGIS y la familia de R-tree
La alternativa es dejar que la base de datos entienda la geometría de forma nativa. PostGIS le da a Postgres un tipo geography y un índice GiST (generalized search tree) sobre él; internamente es un R-tree que anida jerárquicamente cajas delimitadoras. La consulta se vuelve casi vergonzosamente simple:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin usa el índice directamente: sin paso de candidatos-y-refinamiento que gestionas a mano, sin lógica de celdas vecinas, sin ajuste de precisión. La base de datos hace el prefiltro por caja delimitadora y la distancia exacta sobre el esferoide en un solo operador, con semántica correcta en metros porque geography tiene en cuenta la forma de la Tierra. En mi propia comparación antes/después sobre esa tabla de un millón de filas: el escaneo con haversine pasó de ~800 ms a ~4 ms con el índice GiST para el mismo radio. Eso no es una mejora de ajuste, es otro deporte.
Más allá de la velocidad bruta, obtienes corrección gratis y composición de regalo. ¿Quieres «dentro de este polígono» en lugar de un círculo? ST_Intersects. ¿Quieres un buffer alrededor de una línea de ruta? ST_DWithin contra un linestring. ¿Quieres los K vecinos más cercanos sin conocer el radio de antemano? El operador <-> con un índice GiST hace KNN ordenado por índice, exactamente lo que necesitas para el comportamiento de «¿menos de 25 resultados cerca? recurre a los 25 más cercanos en un radio de 6 millas» que implementa el sitio local de Wikipedia. Escribir lógica de respaldo por niveles sobre prefijos de geohash significa programar a mano varios intentos de radio; con KNN es una sola consulta que simplemente sigue recorriendo el índice.
El coste es la dependencia. Necesitas Postgres más la extensión PostGIS (casi universal en Postgres gestionado hoy: RDS, Cloud SQL, Supabase la incluyen), o el soporte espacial de MySQL (funcional pero con aristas más ásperas e históricamente con indexación más débil), o SQLite con SpatiaLite. Además heredas peso operacional: SRIDs de geometría que hay que tener claros, escrituras algo más pesadas y un planificador que a veces necesita un empujón para usar realmente el índice espacial en tablas pequeñas.
Benchmarks y la tabla de compensaciones sin adornos
Cifras de un benchmark que volví a ejecutar recientemente para este tipo de carga: 1,2 millones de puntos (más o menos la escala de los artículos geocodificados de Wikipedia), Postgres 16, consultas de radio de 3 km en coordenadas urbanas aleatorias, caché caliente:
- Escaneo completo con haversine: ~800 ms. Incluido solo como advertencia.
- Prefijo de geohash (celda de 5 caracteres + 8 vecinas) + refinamiento con haversine: ~12 ms de mediana, pero ~40 ms en p95 cuando la celda sobrecarga en zonas densas como los centros urbanos.
- PostGIS GiST con ST_DWithin: ~4 ms de mediana, ~8 ms en p95, y prácticamente constante a medida que crece la densidad.
- KNN de PostGIS (
<->) para los 25 más cercanos: ~2 ms, y no le importa qué radio habrías elegido. - Redis GEOSEARCH (geohash por debajo): submilisegundo, pero todo tu dataset vive en RAM y es una caché, no una fuente de verdad.
Tus resultados variarán según el hardware y la forma de los datos, pero el orden se mantiene en todas las pruebas que he hecho: índice espacial < geohash sobre B-tree < escaneo completo. La debilidad del enfoque con geohash aparece justo donde más importa: en los núcleos urbanos densos, los lugares exactos donde están los usuarios y donde una sola celda contiene decenas de miles de candidatos que revisar con haversine.
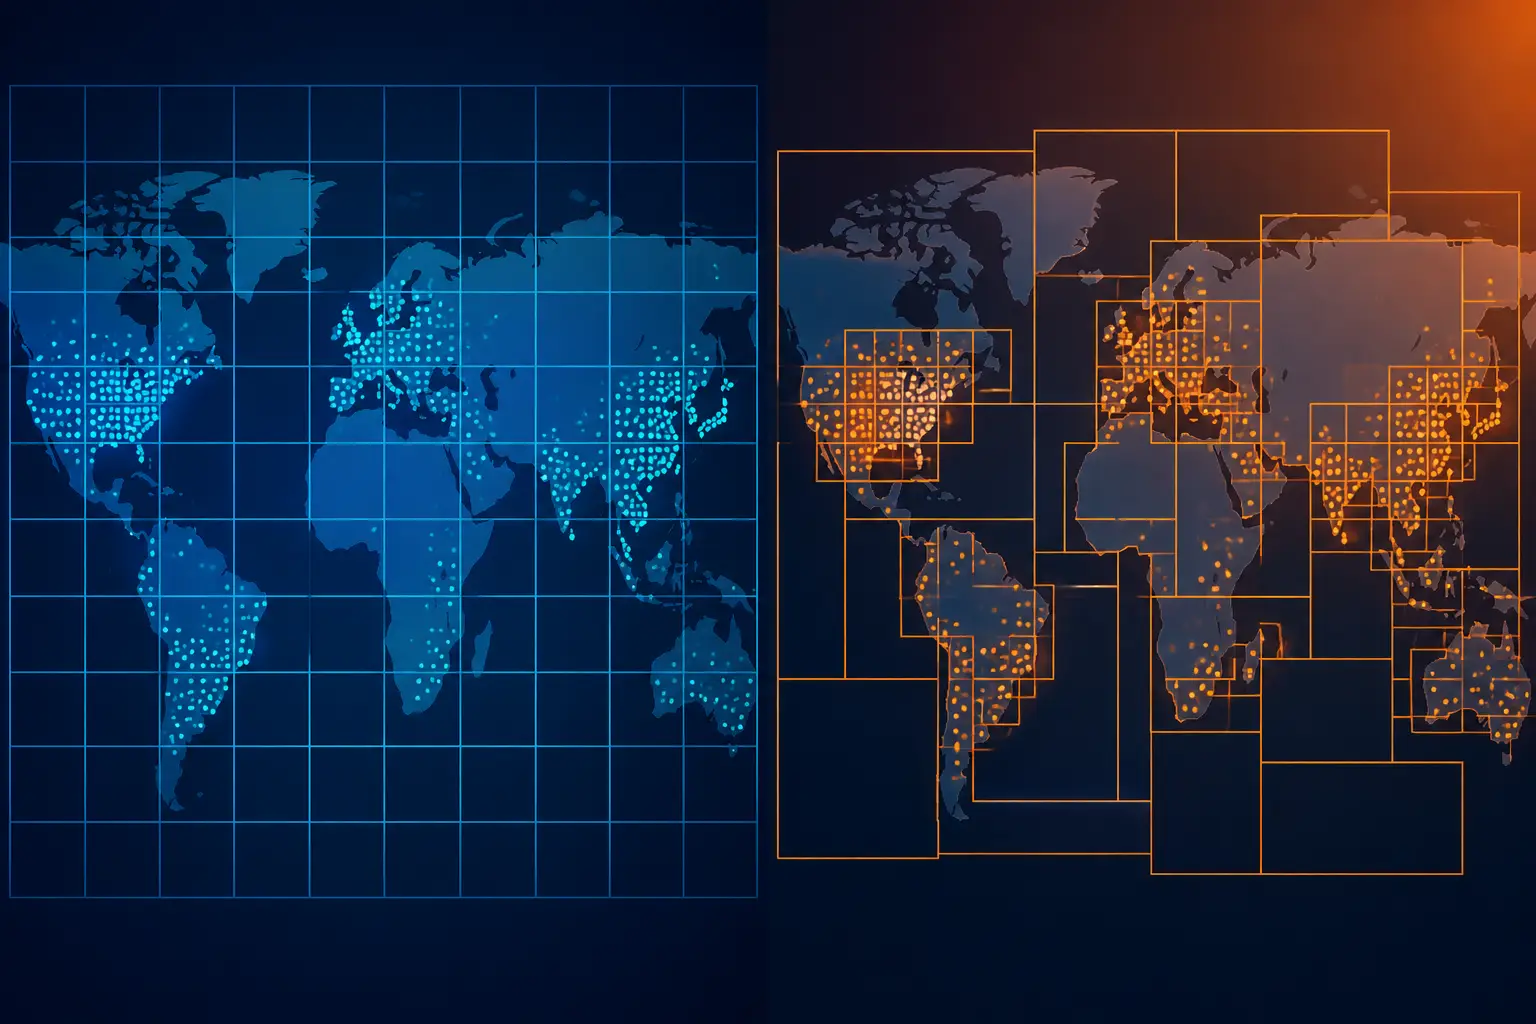
Donde los geohashes recuperan terreno es en la simplicidad operacional fuera de la base de datos. Si tu ruta de lectura es Redis (GEOSEARCH en submilisegundos), o DynamoDB (el prefijo de geohash como condición de clave de ordenación), o si envías un dataset estático al edge y consultas con prefijos de cadena de JavaScript en el navegador, el geohash no es un compromiso: es la arquitectura. Varios proyectos paralelos de «descubrimiento local» funcionan completamente en el cliente así, y como patrón encaja de forma natural con el tipo de proyectos web pequeños y autocontenidos de los que escribí en por qué la web pequeña es la mejor parte de internet: un sitio estático, un índice precalculado, cero servidores.
Radio vs isócrona: la abstracción que realmente estás entregando
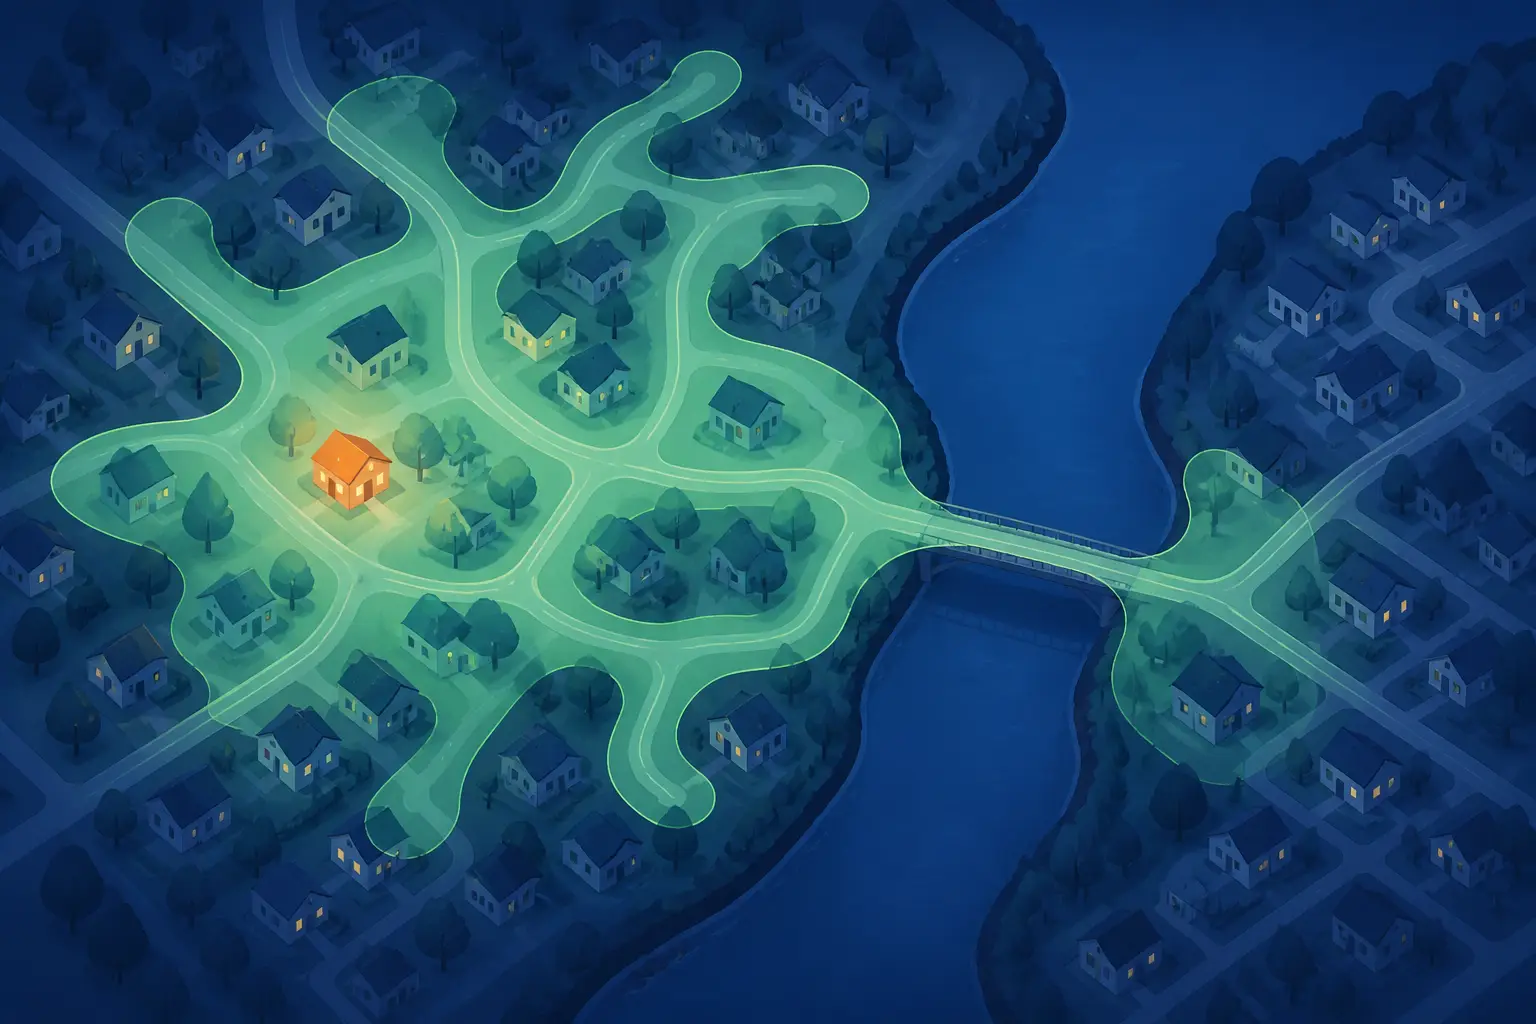
Aquí está lo que el proyecto local de Wikipedia recibió con suaves burlas: dice «media hora caminando», pero en realidad dibuja un círculo de 3 km en línea recta. Un río sin puente, una autopista, un patio de maniobras de tren vallado: el círculo no lo sabe. Una media hora caminando de verdad es una isócrona: la mancha irregular de todo lo alcanzable en 30 minutos siguiendo la red peatonal real. Dos puntos separados 1 km en línea recta pueden estar a 40 minutos andando si hay un estuario entre ellos.
Calcular una isócrona implica ejecutar un motor de rutas: datos de OpenStreetMap a través de OSRM, Valhalla o GraphHopper, expandiendo un árbol de caminos más cortos desde tu punto hasta agotar el tiempo de viaje, y luego trazando el área alcanzable como polígono. Eso son minutos de preprocesado del grafo por región y decenas de milisegundos por consulta, frente a microsegundos de un círculo. Pero una vez que tienes el polígono, la consulta de contención es simplemente ST_Intersects, que el mismo índice espacial maneja de maravilla. Este es uno de los casos en que el bando de los índices espaciales se aleja aún más: los polígonos son ciudadanos de primera clase allí, mientras que los trucos de prefijos de geohash se vuelven realmente incómodos con formas arbitrarias (acabas cubriendo el polígono con un conjunto de celdas: factible, existen bibliotecas de Z-order y S2 para esto, pero es un proyecto en sí mismo).
Mi opinión sincera: en la mayoría de productos el círculo es la mentira correcta. Los usuarios no auditan tu modelo de caminata; notan que los resultados son rápidos y más o menos sensatos. «A menos de 3 km» se correlaciona lo bastante bien con «cerca» como para que la infraestructura extra de un motor de rutas sea difícil de justificar en una función de exploración de contenido. En el momento en que haces promesas con consecuencias (ETAs de entrega, despacho de mensajeros, cobertura de respuesta a emergencias), el círculo se convierte en un pasivo y la isócrona se paga sola. Elige la abstracción según si equivocarte te cuesta dinero o solo una sorpresa leve.
Obtener los datos: Wikipedia geocodificada y búsqueda de direcciones
Si quieres construir algo en este espíritu, la fontanería de datos es más accesible de lo que la gente supone. Las coordenadas de Wikipedia provienen del sistema de plantillas GeoHack y se pueden consultar a través del endpoint list=geosearch de la API de MediaWiki, que en sí mismo es una consulta por radio sobre un índice espacial, y es lo que envuelve la función «Cercanos» del proyecto. La propiedad P625 (ubicación geográfica) de Wikidata cubre mucho más que la Wikipedia en inglés si quieres entidades multilingües o que no sean artículos. Para la búsqueda de direcciones, el proyecto usa Photon, un geocodificador basado en Elasticsearch construido sobre los datos de Nominatim de OpenStreetMap: gratuito para autoalojar, con un endpoint de demo público que mantienen personas generosas y que no deberías machacar en producción.
Una decisión de diseño que vale la pena copiar: el sitio guarda tu ubicación en el navegador y nunca la pone en URLs compartibles. Ese es el valor por defecto correcto, y refleja la lección de lo que las apps de fitness nos enseñan sobre datos de ubicación y OPSEC: las coordenadas de un usuario están entre las cadenas más sensibles que tu app llegará a manejar, y la forma más barata de protegerlas es nunca enviarlas a tu servidor. Haz la geocodificación en el cliente o mediante un geocodificador de terceros con el que el navegador hable directamente, guarda solo coordenadas redondeadas si tienes que registrar algo, y tu postura de privacidad se escribe sola.
Para el respaldo de «los N más cercanos sin importar el radio», resiste la tentación de implementar bucles de reintento con radio creciente. El operador KNN de PostGIS lo hace en una sola consulta indexada:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
Esa única línea reemplaza toda la escalera de «probar 3 km, luego 6 km, luego 10 km» que veo en tantas bases de código, y es más rápida de lo que era una sola ronda de la escalera.
La recomendación
Si te llevas una sola cosa de esta comparación, que sea esta: empieza con PostGIS y un índice GiST, y recurre a los geohashes solo cuando tu capa de almacenamiento te obligue.
El razonamiento es sencillo. El índice espacial gana en latencia mediana, gana aún más en p95 en zonas densas, gana en corrección (distancias de esferoide exactas en metros, sin errores en los bordes de celda), gana en funcionalidades (polígonos, KNN y contención por isócronas se convierten en líneas de una sola instrucción) y gana en código que no tienes que escribir ni mantener. El enfoque con geohash te obliga a implementar correctamente el cálculo de celdas vecinas, la selección de precisión y un filtro de dos fases: tres sitios donde puedes equivocarte sutilmente para llegar a un rendimiento que aun así es peor.
Los geohashes se ganan su sitio en exactamente tres situaciones: tu almacén no tiene soporte espacial (DynamoDB, Redis puro, un archivo JSON estático en un CDN), necesitas particionado por ubicación entre nodos, o estás trasladando la consulta al cliente y quieres cero dependencias. En esos casos, apóyate en una biblioteca probada en batalla (ngeohash en Node, python-geohash, o S2 geometry si vas a cubrir polígonos) en lugar de programar a mano la matemática de vecinos.
Y en el lado del producto: lanza primero el círculo, etiquétalo con honestidad («a menos de 3 km» en vez de «media hora caminando»), haz el radio configurable porque los usuarios rurales y urbanos viven en universos de densidad distintos, y pasa a isócronas solo cuando la mentira del círculo en línea recta empiece a costarte algo medible. El proyecto local de Wikipedia es un recordatorio precioso de que las mejores funcionalidades suelen ser solo una buena consulta espacial con una idea amable. Un millón de artículos, un índice, un radio bien elegido, y de repente la enciclopedia más grande de internet parece escrita sobre tu calle.