Geohash vs indice spaziale: la ricerca per vicinanza
Geohash vs indice spaziale: benchmark, esempi PostGIS, raggio vs isocrona e la scelta giusta per la ricerca nelle vicinanze.
 Marcus Rodriguez
Qualcuno ha costruito un sito che ti mostra Wikipedia, ma solo gli articoli su luoghi a non più di mezz'ora a piedi da dove ti trovi. È delizioso, è diventato virale, ed è anche il pretesto perfetto per parlare del problema che ogni applicazione geo-aware prima o poi incontra: geohash vs indice spaziale — e della domanda più profonda su raggio vs isocrona quando devi rispondere a «cosa c'è vicino a questo punto?» su milioni di righe.
Ho scritto questa query più volte di quante ne riesca a contare — motori di ricerca di ristoranti, tracciamento di asset, una funzione di raggio di consegna che quasi ha mandato giù un database. La versione ingenua che tutti scrivono per prima è una scansione completa della tabella con una formula di distanza nella clausola WHERE. Funziona in sviluppo con 500 righe. Muore in produzione con 5 milioni. Quindi confrontiamo i due approcci che reggono davvero la scala: il bucketing basato su geohash e un indice spaziale vero e proprio come il GiST di PostGIS. Uno dei due vince nella maggior parte dei casi, e ti dirò quale.
La query che tutti scrivono per prima (e poi rimpiangono)
Wikipedia ha oltre un milione di articoli geocodificati solo in inglese — ognuno con latitudine e longitudine nelle tabelle page o geo_tags. Il tuo dataset potrebbe essere negozi, utenti, sensori IoT, qualsiasi cosa. La query ingenua è questa:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
Questa è la formula dell'haversine, ed è corretta. Ma non è indicizzabile. Il database deve calcolare la trigonometria su ogni singola riga, a ogni richiesta. Su una tabella da un milione di righe che ho misurato tempo fa, girava a circa 800ms per query su Postgres con cache calda. Va bene per una demo. Catastrofico con 50 richieste al secondo, dove devi fare 40 secondi di matematica ogni secondo. La coda cresce, le connessioni si accumulano e all'improvviso sei tu il protagonista del canale degli incidenti.
Entrambe le soluzioni reali condividono lo stesso trucco: sostituire il costoso controllo di distanza per riga con un filtro candidato economico. Ridurre il milione di righe a qualche centinaio di candidati usando un indice, e poi eseguire il calcolo esatto della distanza solo su quelli. I geohash e gli indici spaziali sono due modi diversi di fare questo filtraggio dei candidati. È questo il confronto che conta.
Come i geohash trasformano la geografia in prefissi di stringa
Un geohash codifica una coppia lat/lon come breve stringa suddividendo ripetutamente il globo. Ogni carattere aggiunto dimezza la cella. «u4pruydqqvj» è una panchina a Londra; «u4pruyd» è un quadrato di circa 150 m che contiene quella panchina; «u4p» è un quadrato di circa 40 km che contiene metà della Londra meridionale. La proprietà fondamentale: punti vicini condividono prefissi di stringa, e il confronto dei prefissi è esattamente ciò che un banale indice B-tree fa a occhi chiusi.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
Il flusso di lavoro: in fase di scrittura calcoli il geohash di ogni riga (una funzione pura, microsecondi). In fase di query calcoli la cella geohash che copre il tuo punto a una precisione la cui dimensione corrisponde grossomodo al raggio, e poi calcoli anche i suoi otto vicini — è la parte che la gente dimentica, perché un punto vicino al bordo di una cella avrà vicini oltre il confine. Filtri i candidati per prefisso, poi applichi l'haversine esatta ai sopravvissuti. Passi da un milione di calcoli di distanza a forse qualche centinaio.
Il vantaggio è la portabilità. Le query per prefisso di geohash funzionano in qualsiasi sistema che indicizza stringhe: chiavi di ordinamento di DynamoDB, Elasticsearch, i sorted set di Redis (è ciò che GEOADD usa internamente — uno score codificato come geohash in un ZSET), SQLite, un file ordinato su disco. Nessuna estensione, nessun tipo di colonna esotico. Se la tua infrastruttura è un NoSQL o un servizio gestito senza supporto spaziale, i geohash sono spesso l'unica vera opzione. Sono anche facilmente shardabili, ed è per questo che compaiono nei sistemi che partizionano dati di localizzazione tra nodi.
I punti deboli, però, sono reali. La precisione è quantizzata: scegli una dimensione di cella che è un superset grossolano del raggio e accetti il sovra-recupero, oppure scegli celle più piccole e lanci più query per prefisso. Anche le dimensioni delle celle si distorcono con la latitudine — una cella di 5 caratteri è molto più alta che larga, e il rapporto d'aspetto cambia man mano che ti allontani dall'equatore. E mantieni tu stesso una colonna denormalizzata, con tutto il divertimento della coerenza degli aggiornamenti che ne consegue. È un trucco intelligente sopra un indice di stringhe, e si comporta come tale.
Indici spaziali: GiST di PostGIS e la famiglia degli R-tree
L'alternativa è lasciare che il database capisca la geometria in modo nativo. PostGIS dà a Postgres un tipo geography e un indice GiST (generalized search tree) su di esso — internamente un R-tree che annida gerarchicamente i bounding box. La query diventa quasi imbarazzantemente semplice:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin usa l'indice direttamente — niente passaggio candidato-poi-raffinamento da gestire a mano, nessuna logica di celle vicine, nessuna messa a punto della precisione. Il database esegue il prefiltro sui bounding box e il calcolo esatto della distanza sullo sferoide con un unico operatore, con semantica corretta in metri perché geography tiene conto della forma della Terra. Nel mio confronto prima/dopo su quella tabella da un milione di righe: la scansione haversine è passata da ~800ms a ~4ms con l'indice GiST, a parità di raggio. Non è un miglioramento di tuning, è un altro sport.
Oltre alla velocità pura, ottieni correttezza gratis e componibilità in più. Vuoi «dentro questo poligono» invece di un cerchio? ST_Intersects. Vuoi un buffer attorno a una linea di percorso? ST_DWithin contro un linestring. Vuoi i K vicini più prossimi senza conoscere in anticipo un raggio? L'operatore <-> con un indice GiST fa KNN ordinato dall'indice — esattamente ciò che serve per il comportamento «meno di 25 risultati vicini? usa i 25 più vicini entro 6 miglia» che implementa il sito Wikipedia locale. Scrivere una logica di fallback a livelli sopra i prefissi di geohash significa costruire a mano più tentativi di raggio; con KNN è una sola query che continua semplicemente a percorrere l'indice.
Il costo è la dipendenza. Ti servono Postgres più l'estensione PostGIS (ormai quasi universale nei Postgres gestiti — RDS, Cloud SQL, Supabase la includono tutti), oppure il supporto spaziale di MySQL (funzionale ma con spigoli più ruvidi e storicamente un'indicizzazione più debole), oppure SQLite con SpatiaLite. Erediti anche un certo peso operativo: SRID delle geometrie da tenere a posto, scritture un po' più pesanti e un planner che ogni tanto ha bisogno di una spinta per usare davvero l'indice spaziale sulle tabelle piccole.
Benchmark e la tabella dei compromessi onesta
Numeri da un benchmark che ho rieseguito di recente per questo tipo di carico di lavoro — 1,2 milioni di punti (più o meno la scala degli articoli geocodificati di Wikipedia), Postgres 16, query con raggio di 3 km su coordinate urbane casuali, cache calda:
- Scansione completa haversine: ~800ms. Inclusa solo come monito.
- Prefisso geohash (cella da 5 caratteri + 8 vicini) + raffinamento haversine: ~12ms mediana, ma ~40ms al p95 quando la cella sovra-recupera in aree dense come i centri città.
- PostGIS GiST con ST_DWithin: ~4ms mediana, ~8ms p95, e grossomodo costante al crescere della densità.
- KNN di PostGIS (
<->) per i 25 più vicini: ~2ms, e non gli importa quale raggio avresti scelto. - Redis GEOSEARCH (geohash sotto il cofano): sotto il millisecondo, ma l'intero dataset vive in RAM ed è una cache, non una fonte di verità.
I tuoi risultati varieranno in base all'hardware e alla forma dei dati, ma l'ordine è stabile in ogni test che abbia mai fatto: indice spaziale < geohash su B-tree < scansione grezza. Il punto debole dell'approccio geohash emerge proprio dove conta di più — nei centri urbani densi, esattamente dove stanno gli utenti e dove una cella contiene decine di migliaia di candidati da ricontrollare con haversine.
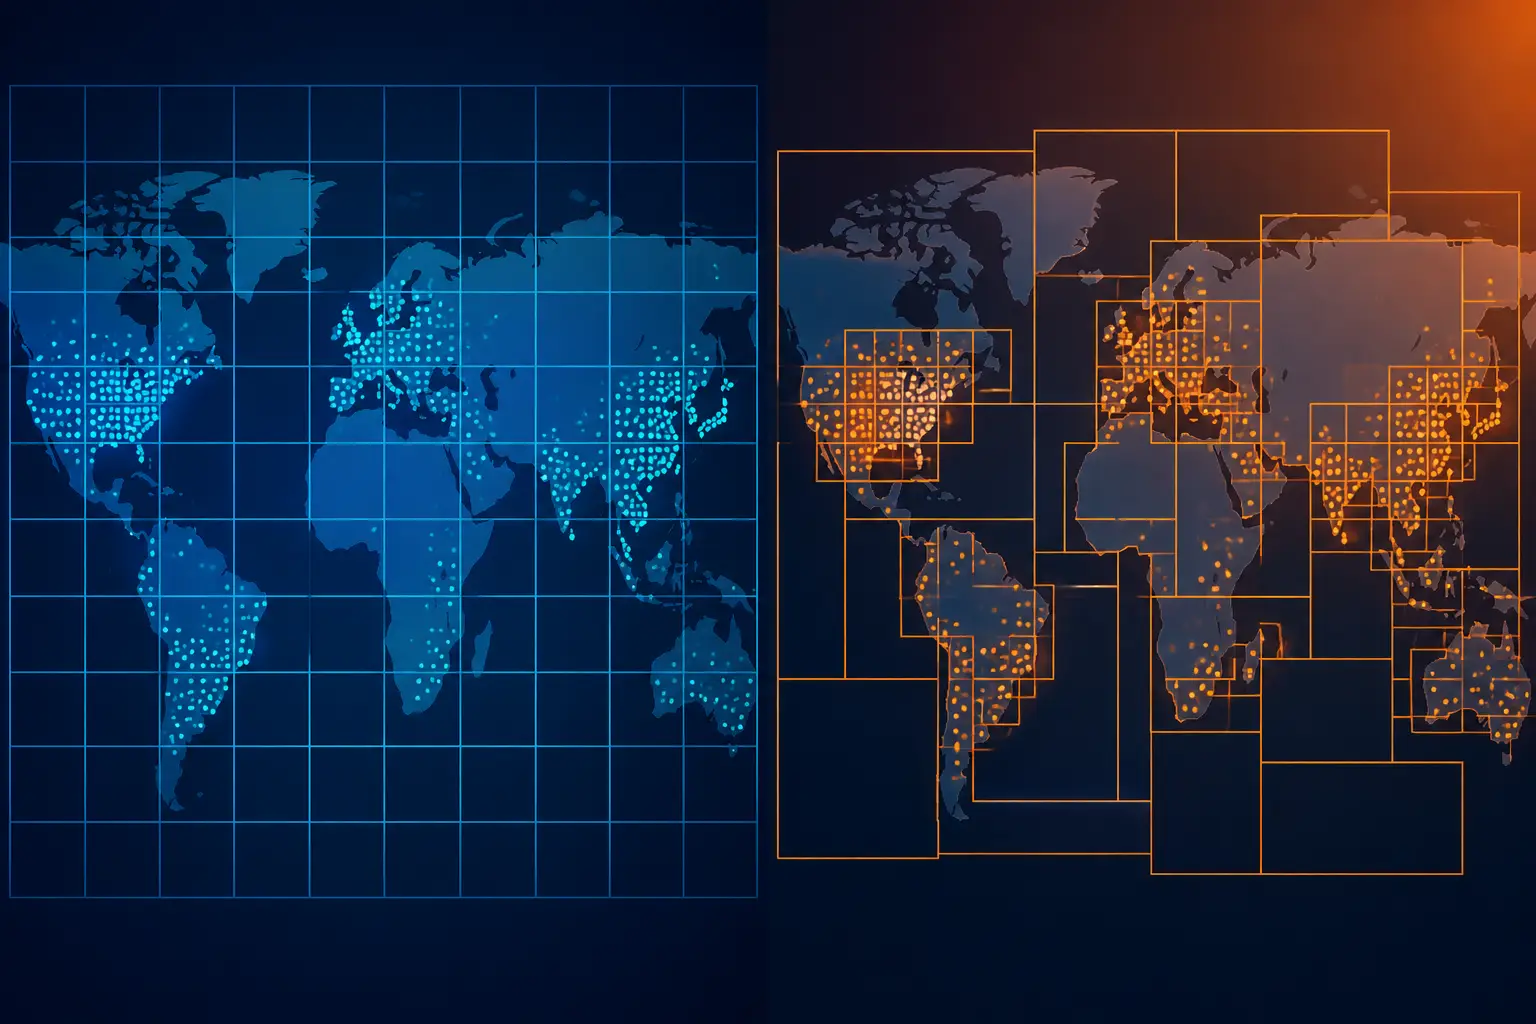
Dove i geohash recuperano terreno è nella semplicità operativa fuori dal database. Se il tuo percorso di lettura è Redis (GEOSEARCH sotto il millisecondo), o DynamoDB (prefisso geohash come condizione sulla chiave di ordinamento), oppure stai distribuendo un dataset statico sull'edge e interroghi con prefissi di stringa JavaScript nel browser — il geohash non è un compromesso, è l'architettura. Diversi progetti collaterali di «scoperta locale» funzionano interamente lato client in questo modo, e come pattern si abbina bene al genere di piccoli progetti web autonomi di cui ho scritto in perché il piccolo web è la parte migliore di internet: un sito statico, un indice precalcolato, zero server.
Raggio vs isocrona: l'astrazione che stai davvero spedendo
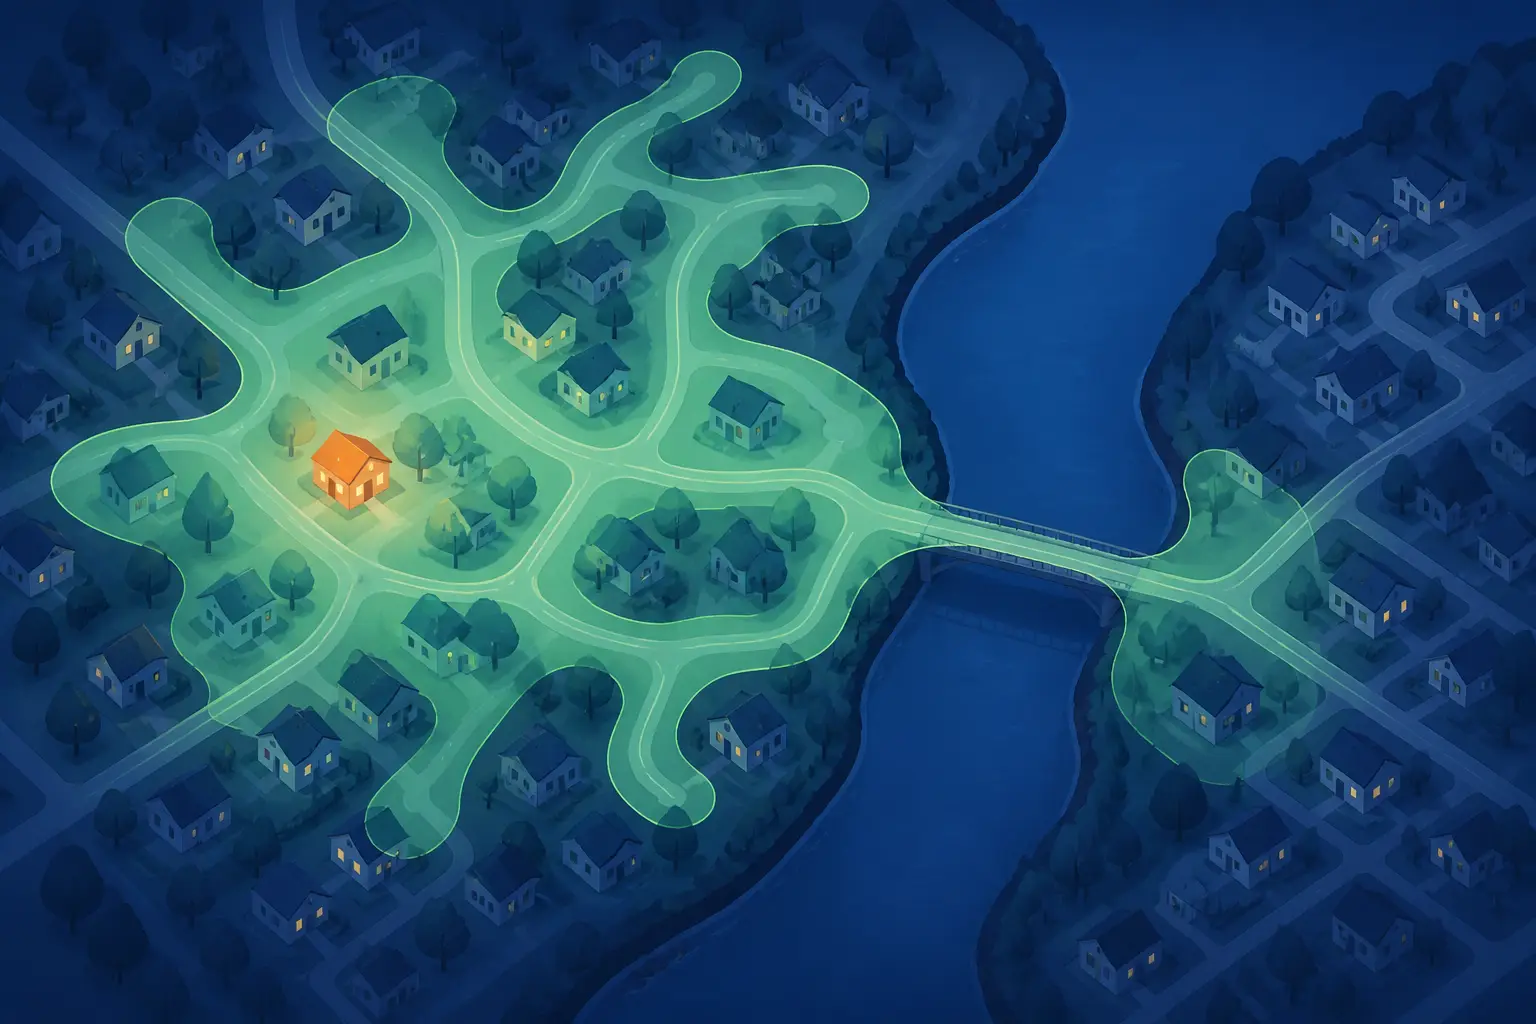
La cosa per cui il progetto locale di Wikipedia è stato bonariamente preso in giro: dice «mezz'ora a piedi», ma in realtà disegna un cerchio di 3 km in linea d'aria. Un fiume senza ponte, un'autostrada, un deposito ferroviario recintato — il cerchio non lo sa. Una vera mezz'ora a piedi è un'isocrona: la forma irregolare di tutto ciò che è raggiungibile in 30 minuti lungo la rete pedonale reale. Due punti distanti 1 km in linea d'aria possono essere a 40 minuti di cammino l'uno dall'altro se in mezzo c'è un estuario.
Calcolare un'isocrona significa far girare un motore di routing — dati OpenStreetMap attraverso OSRM, Valhalla o GraphHopper — espandendo un albero dei cammini minimi dal tuo punto finché il tempo di percorrenza non raggiunge il budget, poi tracciando i contorni dell'area raggiungibile in un poligono. Sono minuti di preprocessing del grafo per regione e decine di millisecondi per query, contro i microsecondi di un cerchio. Ma una volta che hai il poligono, la query di contenimento è semplicemente ST_Intersects, che lo stesso indice spaziale gestisce benissimo. È uno dei casi in cui il fronte degli indici spaziali prende ancora più vantaggio: i poligoni sono cittadini di prima classe lì, mentre i trucchi con i prefissi geohash diventano davvero scomodi per forme arbitrarie (finisci per ricoprire il poligono con un insieme di celle — fattibile, esistono librerie Z-order e S2 per questo, ma è un progetto a sé).
La mia opinione onesta: per la maggior parte dei prodotti il cerchio è la bugia giusta. Gli utenti non verificano il tuo modello di camminata; notano che i risultati sono veloci e grossomodo sensati. «Entro 3 km» si correla abbastanza bene con «nelle vicinanze», quindi l'infrastruttura extra di un motore di routing è difficile da giustificare per una funzione di navigazione dei contenuti. Nel momento in cui fai promesse con conseguenze — tempi stimati di consegna, dispatch dei corrieri, copertura dei soccorsi d'emergenza — il cerchio diventa una responsabilità e l'isocrona si ripaga da sola. Scegli l'astrazione in base al fatto che sbagliare ti costi denaro o solo una leggera sorpresa.
Recuperare i dati: Wikipedia geocodificata e ricerca degli indirizzi
Se vuoi costruire qualcosa in questo spirito, la parte di gestione dei dati è più accessibile di quanto la gente pensi. Le coordinate di Wikipedia provengono dal sistema di template GeoHack e sono interrogabili tramite l'endpoint list=geosearch delle API MediaWiki — che è di per sé una query per raggio su un indice spaziale, ed è ciò che la funzione «Nelle vicinanze» del progetto incapsula. La proprietà P625 (coordinate geografiche) di Wikidata copre molto più dell'inglese Wikipedia, se ti servono entità multilingua o non articoli. Per la ricerca degli indirizzi, il progetto usa Photon, un geocoder basato su Elasticsearch costruito sui dati Nominatim di OpenStreetMap — gratuito da self-hostare, con un endpoint demo pubblico gestito da persone generose che non dovresti martellare in produzione.
Una scelta progettuale da copiare: il sito tiene la tua posizione nel browser e non la mette mai negli URL condivisibili. È il default giusto, e rispecchia la lezione di cosa ci insegnano le app fitness sui dati di localizzazione e sull'OPSEC — le coordinate di un utente sono tra le stringhe più sensibili che la tua app possa mai contenere, e il modo più economico per proteggerle è non inviarle mai al tuo server. Fai la geocodifica lato client o tramite un geocoder di terze parti con cui il browser parla direttamente, conserva solo coordinate arrotondate se devi loggare qualcosa, e la tua postura sulla privacy si scrive da sola.
Per il fallback «i N più vicini indipendentemente dal raggio», resisti alla tentazione di implementare cicli di retry con raggio crescente. L'operatore KNN di PostGIS lo fa in una singola query indicizzata:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
Quella singola riga sostituisce l'intera «scala dei tentativi: 3 km, poi 6 km, poi 10 km» che vedo in tanti codebase, ed è più veloce di un solo passo di quella scala.
La raccomandazione
Se porti via una sola cosa da questo confronto, prendi questa: parti da PostGIS e da un indice GiST, e ricorri ai geohash solo quando il tuo livello di storage ti costringe a farlo.
Il ragionamento è semplice. L'indice spaziale vince sulla latenza mediana, vince ancora di più sul p95 nelle aree dense, vince sulla correttezza (distanze sferoidali accurate al metro, niente bug ai bordi delle celle), vince sulle funzionalità (poligoni, KNN, contenimento in isocrona diventano tutti one-liner) e vince sul codice che non devi scrivere e mantenere. L'approccio geohash ti obbliga a implementare correttamente il calcolo dei vicini di cella, la selezione della precisione e un filtro in due fasi — tre punti in cui sbagliare in modo sottile — per ottenere prestazioni che restano comunque peggiori.
I geohash si guadagnano il loro posto in esattamente tre situazioni: il tuo datastore non ha supporto spaziale (DynamoDB, Redis semplice, un file JSON statico su CDN), ti serve lo sharding basato sulla posizione tra nodi, oppure spingi la query sul client e vuoi zero dipendenze. In questi casi, affidati a una libreria collaudata — ngeohash in Node, python-geohash, o S2 geometry se devi coprire poligoni — invece di scrivere a mano la matematica dei vicini.
E sul lato prodotto: spedisci prima il cerchio, etichettalo onestamente («entro 3 km» invece di «mezz'ora a piedi»), rendi il raggio configurabile perché gli utenti rurali e quelli urbani vivono in universi di densità diversi, e passa alle isocrone solo quando la bugia della linea d'aria inizia a costarti qualcosa di misurabile. Il progetto locale di Wikipedia è un bel promemoria che le funzionalità migliori sono spesso solo una buona query spaziale travestita da idea gentile. Un milione di articoli, un indice, un raggio ben scelto — e all'improvviso la più grande enciclopedia di internet sembra scritta proprio sulla tua strada.