Geohash 还是空间索引?邻近搜索选型指南
Geohash 与空间索引对比:基准测试、PostGIS 示例、半径与等时圈的取舍,以及邻近搜索的选型建议。
 Marcus Rodriguez
有人做了一个网站,只展示你所在位置步行半小时范围内的维基百科条目。它很有趣,还火了,也正好引出每个地理应用迟早会遇到的问题:geohash 还是空间索引——以及在数百万行数据中回答“这个点附近有什么”时,半径与等时圈之间更深层的选择。
这个查询我写过的次数数都数不清了——餐厅查找、资产追踪,还有一个差点把数据库拖垮的配送半径功能。大家最先写的朴素版本,是在 WHERE 子句里放距离公式做全表扫描。开发环境 500 行数据跑得好好的,到了生产环境 500 万行就挂了。所以我们来比较两种真正能扛住规模的做法:基于 geohash 的分桶,以及 PostGIS 的 GiST 这类成熟的空间索引。大多数情况下会有一个胜出,我会告诉你是哪个。
每个人最先写、然后后悔的查询
光是英文维基百科就有超过一百万个带坐标的条目,每一条都在 page 或 geo_tags 表里带有经纬度。你自己的数据集可能是门店、用户、物联网传感器,什么都行。朴素的查询大概长这样:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
这就是 haversine 公式,计算本身是正确的。但它无法建立索引。数据库每次请求都要对每一行做三角运算。我前段时间在一张百万行的表上测过,Postgres 热缓存下每次查询大约 800 毫秒。做 demo 没问题,但每秒 50 次请求时,每秒就要做 40 秒的计算,这就是灾难。队列越堆越长,连接数爆满,你很快就会成为事故频道里的主角。
两种可行的方案都用了同一个技巧:用一个廉价的候选过滤替代每行昂贵的距离计算。先借助索引把数百万行缩减到几百个候选,再只对这几百个做精确的距离计算。Geohash 和空间索引是两种不同的候选过滤方式,这才是真正值得比较的地方。
Geohash 如何把地理位置变成字符串前缀
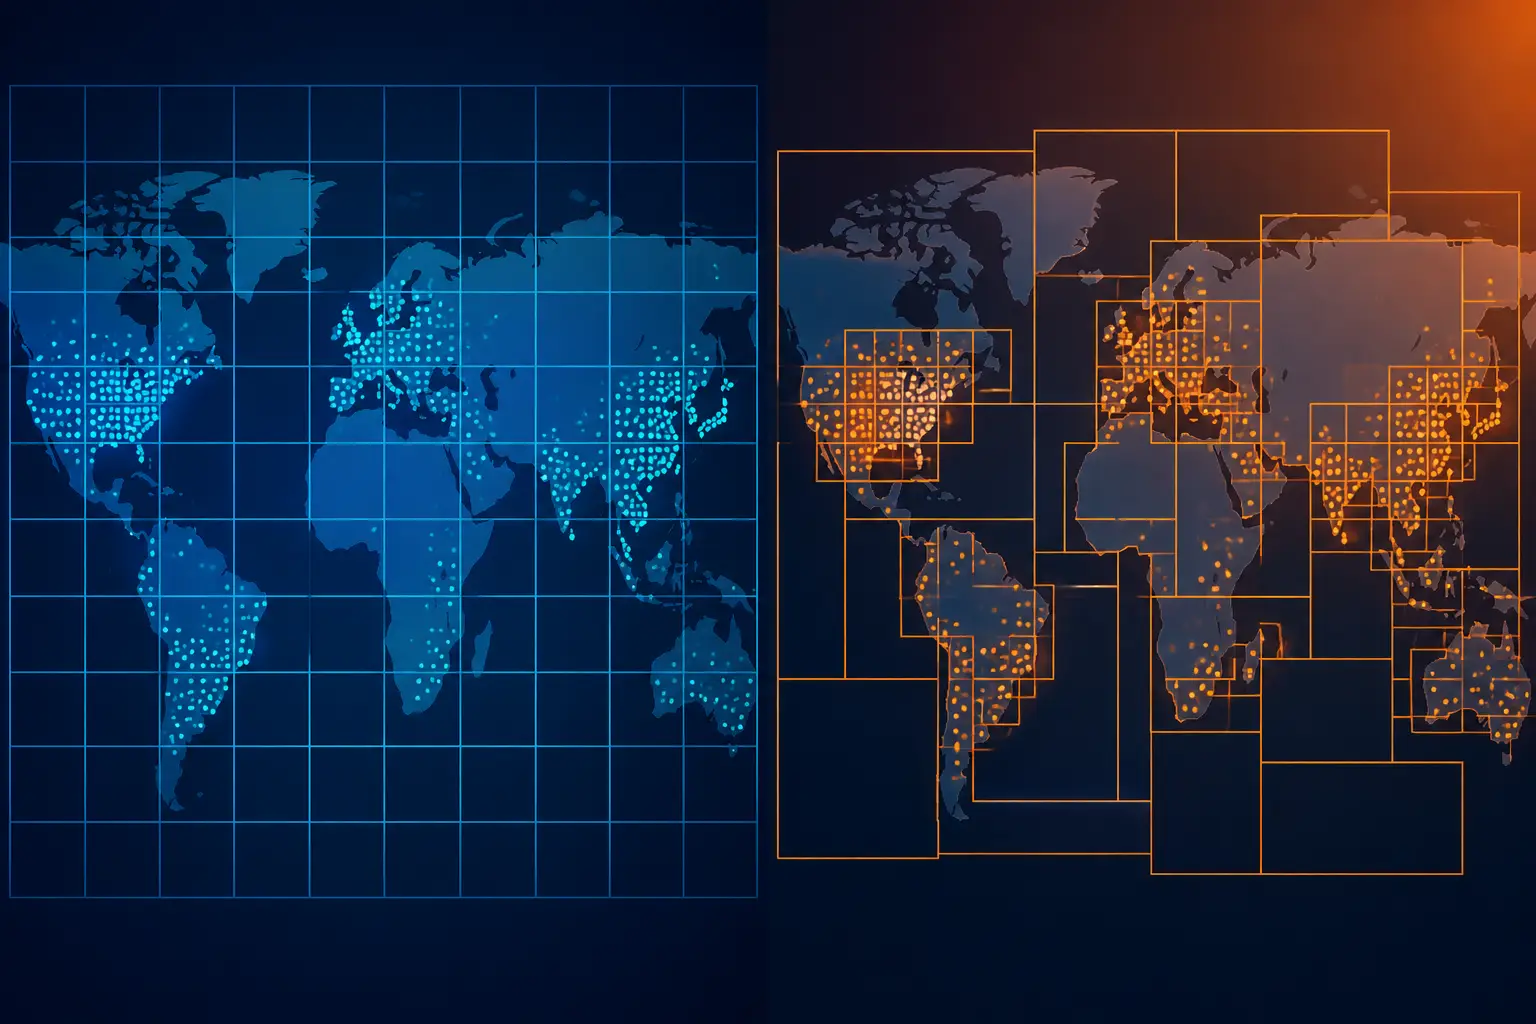
Geohash 通过不断对地球做二分,把经纬度编码成一个短字符串。每增加一个字符,格子面积就缩小一半。“u4pruydqqvj” 是伦敦的一张长椅;“u4pruyd” 是包含这张长椅、约 150 米见方的格子;“u4p” 则是覆盖伦敦南部一半区域、约 40 公里见方的格子。它最妙的性质是:相近的点共享字符串前缀,而前缀匹配正是普通 B 树索引闭着眼也能完成的事情。
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
工作流程是:写入时,计算每一行的 geohash(纯函数,微秒级)。查询时,选一个单元格大小与半径大致匹配的精度,计算覆盖你所在点的格子,再算出它的八个相邻格子。这一步常被忽略,因为靠近格子边缘的点,邻居可能在边界另一侧。先按前缀过滤候选,再对剩下的结果做精确的 haversine 计算。这样你就能从一百万次距离计算降到大约几百次。
这种方案的吸引力在于可移植性。Geohash 前缀查询可以在任何能索引字符串的地方运行:DynamoDB 的排序键、Elasticsearch、Redis 有序集合(GEOADD 内部正是用 ZSET 中经 geohash 编码的分值实现的)、SQLite,甚至磁盘上一个排好序的文件。不需要扩展,也不需要特殊的列类型。如果你的基础设施是 NoSQL 存储,或者是不支持空间功能的托管服务,geohash 往往是你唯一真正可行的选择。它也很容易分片,这就是为什么它常出现在把位置数据分散到多个节点的系统里。
不过它的短板也是真实的。精度是离散的:你要么选一个比半径粗、覆盖范围更大的格子,接受多余的数据拉取;要么选更小的格子,发出更多的前缀查询。格子大小还会随纬度变形:一个 5 位字符的格子高度明显大于宽度,并且离赤道越远,长宽比越不同。另外,你还得自己维护一个反范式化的列,随之而来的更新一致性问题够你头疼的。它是构建在字符串索引之上的一个聪明技巧,而它的行为也确实像个技巧。
空间索引:PostGIS GiST 与 R 树家族
另一种思路是让数据库原生理解几何。PostGIS 为 Postgres 提供了 geography 类型,以及基于它的 GiST(通用搜索树)索引——其底层是一棵 R 树,逐层嵌套包围盒。查询写起来简单得几乎让人不好意思:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin 直接使用索引——不需要你手动做候选过滤再精化,不需要处理相邻格子的逻辑,也不需要调整精度。数据库在一个算子里同时完成包围盒预过滤和精确的椭球面距离计算,而且因为 geography 考虑了地球的形状,单位语义是正确的米。在我自己对那张百万行表的前后对比中,haversine 全表扫描从约 800 毫秒降到了约 4 毫秒(同样半径,使用 GiST 索引)。这已经不是调优的胜利,而是另一个量级的比赛。
除了速度,你还能免费获得正确性,并附带可组合性。想查“这个多边形内”而不是圆形范围?用 ST_Intersects。想要线路周围的缓冲区?对线段使用 ST_DWithin。想在不预先知道半径的情况下查最近的 K 个点?带 GiST 索引的 <-> 算子可以按索引顺序执行 KNN——这正是本地维基百科站点实现的“附近少于 25 条结果?那就退回到 6 英里内最近的 25 条”这种行为所需要的。如果在 geohash 前缀之上实现分级回退逻辑,就得手写多次半径尝试;而用 KNN,只需一个查询,沿着索引一路走下去即可。
代价在于依赖。你需要 Postgres 加上 PostGIS 扩展(现在的托管 Postgres 基本都支持,RDS、Cloud SQL、Supabase 都内置了),或者 MySQL 的空间支持(能用,但粗糙得多,而且索引能力历来较弱),或者带 SpatiaLite 的 SQLite。你还要承担运维上的负担:要理清几何的 SRID,写入会稍微变重,而且在小表上,规划器偶尔需要推一把才会真正使用空间索引。
基准测试与坦诚的取舍表
以下是我最近针对这类负载重新跑的基准数据——120 万个点(大致是维基百科地理条目的规模),Postgres 16,在随机城市坐标上做 3 公里半径查询,热缓存:
- 全表 haversine 扫描:约 800 毫秒。仅作为反面教材列出。
- Geohash 前缀(5 位字符格子 + 8 个邻居)+ haversine 精化:中位数约 12 毫秒,但在市中心等高密度区域,格子会过度拉取数据,p95 约 40 毫秒。
- PostGIS GiST 配合 ST_DWithin:中位数约 4 毫秒,p95 约 8 毫秒,并且随着密度增加基本保持平稳。
- PostGIS KNN(
<->)取最近的 25 个:约 2 毫秒,而且它不关心你原本会选什么半径。 - Redis GEOSEARCH(底层是 geohash):亚毫秒级,但你的全部数据都要放在内存里,它是缓存而不是事实来源。
硬件和数据形态不同,结果会有差异,但我做过的每一次测试中,排序都很稳定:空间索引 < 基于 B 树的 geohash < 原始扫描。geohash 方案的弱点恰恰体现在最关键的地方——密集的城市核心区域,用户最集中的地方,同一个格子里可能有数万个候选点需要用 haversine 重新检查。
Geohash 在数据库之外的运维简单性上扳回了一些局面。如果你的读取路径是 Redis(亚毫秒级的 GEOSEARCH),或者是 DynamoDB(用 geohash 前缀作为排序键条件),或者你要把一个静态数据集发布到边缘,然后在浏览器里用 JavaScript 字符串前缀做查询——那么 geohash 就不是妥协,而是架构本身。一些“本地发现”类的个人项目就是完全在客户端这样运行的,作为一种模式,它与我在 为什么小众网络是互联网最好的部分 中写到的那类小型、自包含的网页项目很搭:一个静态站点,一个预先计算好的索引,零服务器。
半径与等时圈:你真正在交付的抽象
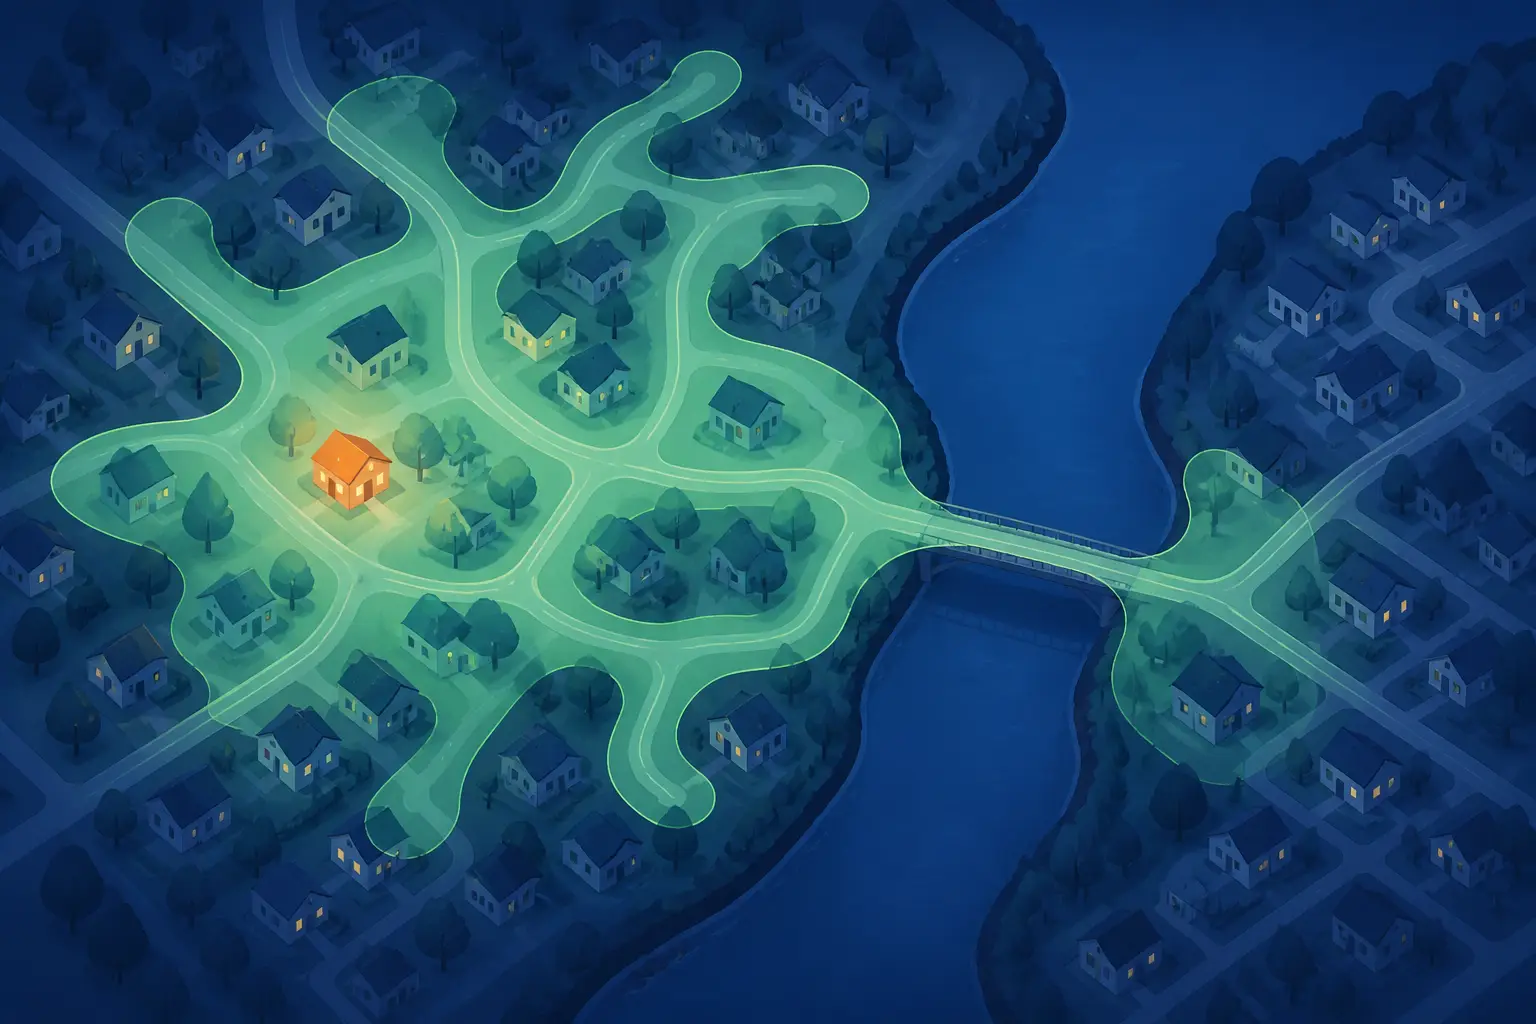
本地维基百科项目被温和吐槽的地方就在这里:它写的是“步行半小时”,实际上画的却是一个 3 公里的直线圆。河流没有桥、高速公路、围栏封闭的铁路货场——这个圆对这些一无所知。真正的半小时步行范围是等时圈:沿着真实步行网络,30 分钟内所有可到达区域组成的不规则形状。两个直线距离只有 1 公里的点,如果中间隔着一个河口,步行可能要 40 分钟。
计算等时圈需要跑一个路径规划引擎——用 OSRM、Valhalla 或 GraphHopper 处理 OpenStreetMap 数据,从你的点出发扩展最短路径树,直到行程时间达到预算,然后把可达区域勾勒成一个多边形。每个区域的图预处理要花几分钟,每次查询则需要几十毫秒,而画一个圆只要几微秒。但一旦有了多边形,包含判断就只是 ST_Intersects,同样的空间索引可以处理得很好。这是空间索引阵营进一步拉开差距的场景之一:多边形在那里是一等公民,而 geohash 前缀技巧在处理任意形状时会变得相当别扭(你得用一组格子去覆盖多边形——可行,Z 序和 S2 库都能做到,但这已经是一个项目了)。
我的坦率看法是:对大多数产品来说,圆形是个合适的“善意谎言”。用户不会去审计你的步行模型,他们只会注意到结果是否够快、是否大致合理。“3 公里以内”与“附近”的关联已经足够强,内容浏览类功能没必要为一个路径规划引擎付出那么多基础设施成本。一旦你做出的承诺会带来后果——配送 ETA、骑手调度、应急响应覆盖范围——圆形就会变成负担,而等时圈就物有所值了。选择抽象时,看的是出错的代价是钱,还是只是轻微的意外。
数据来源:带坐标的维基百科与地址搜索
如果你想做类似的东西,数据获取部分比大多数人想象的要容易上手。维基百科的坐标来自 GeoHack 模板系统,可以通过 MediaWiki API 的 list=geosearch 端点查询——这本身就是基于空间索引的半径查询,也正是该项目“附近”功能的底层封装。如果你想覆盖多语言或非文章类实体,Wikidata 的 P625(坐标位置)属性涵盖的范围远超英文维基百科。至于地址查询,该项目使用 Photon,这是一个基于 Elasticsearch、以 OpenStreetMap 的 Nominatim 数据构建的地理编码器——可以免费自托管,还有一个由热心人运行的公共演示端点,但你不应该在生产环境中频繁请求它。
有一个值得借鉴的设计决策:该站点把你的位置保存在浏览器里,从不把它放进可分享的 URL 中。这是正确的默认做法,也呼应了我在 健身应用如何教会我们位置数据与运营安全(OPSEC) 中的观点——用户的坐标是你的应用会持有的最敏感的字符串之一,保护它们最便宜的办法,就是根本不发送到你的服务器。在客户端完成地理编码,或者通过浏览器直接与第三方地理编码器通信;如果确实需要记录日志,只保留取整后的坐标。这样,你的隐私策略基本就自然成型了。
对于“不论半径、取最近 N 个”的回退逻辑,请克制住实现扩展半径重试循环的冲动。PostGIS 的 KNN 算子用一个带索引的查询就能搞定:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
这一行代码就替代了我在很多代码库里见到的整套“先试 3 公里,再 6 公里,再 10 公里”的重试阶梯,而且它的速度比阶梯中的一轮还要快。
推荐方案
如果你只能从这次对比中带走一件事,那就是:先用 PostGIS 和 GiST 索引起步,只有当你的存储层强迫你时,才去用 geohash。
理由很简单。空间索引在中位延迟上胜出,在密集区域的 p95 上胜出得更明显;在正确性上胜出(米级精度的椭球面距离,没有格子边缘的 bug);在功能上胜出(多边形、KNN、等时圈包含判断都变成了一行代码);在你不必编写和维护的代码量上也胜出。而 geohash 方案要求你正确实现相邻格子计算、精度选择以及两阶段过滤——任何一处都可能隐秘地出错——最终的性能却依然更差。
Geohash 只在三种情况下才值得用:你的数据存储不支持空间功能(DynamoDB、纯 Redis、CDN 上的静态 JSON 文件);你需要在多个节点之间做基于位置的分片;或者你要把查询推给客户端,并希望零依赖。在这些场景下,请依赖经过充分验证的库——Node 里的 ngeohash、python-geohash,或者如果要覆盖多边形就用 S2 几何库——而不是自己手写相邻格子的数学计算。
产品层面也是如此:先上线圆形,并如实标注(写“3 公里以内”而不是“步行半小时”),让半径可配置,因为农村用户和城市用户生活在完全不同的密度世界里;只有当“直线距离”这个谎言开始带来可以衡量的损失时,才升级到等时圈。本地维基百科项目很好地提醒了我们:最好的功能往往只是一个披着友好外衣的良好空间查询。一百万篇条目,一个索引,一个选得恰当的半径——突然之间,这部互联网上最大的百科全书,就像是专门为你的街道而写的。