Geohash vs Índice Espacial para Busca por Proximidade
Geohash vs índice espacial para apps com localização: benchmarks, exemplos com PostGIS, raio vs isócrona e a escolha certa para busca próxima.
 Marcus Rodriguez
Alguém criou um site que mostra a Wikipédia, mas apenas os artigos sobre coisas a no máximo meia hora de caminhada de onde você está. É encantador, viralizou e também é uma desculpa perfeita para falar do problema que toda aplicação com geolocalização acaba enfrentando: geohash vs índice espacial — e da questão mais profunda de raio vs isócrona quando você precisa responder "o que está perto deste ponto?" em milhões de linhas.
Já escrevi essa consulta mais vezes do que consigo contar — buscadores de restaurantes, rastreamento de ativos, uma funcionalidade de raio de entrega que quase derrubou um banco de dados. A versão ingênua que todo mundo escreve primeiro é um full-table scan com a fórmula de distância no WHERE. Funciona em desenvolvimento com 500 linhas. Morre em produção com 5 milhões. Então vamos comparar as duas abordagens que realmente sobrevivem em escala: bucketing baseado em geohash e um índice espacial de verdade, como o GiST do PostGIS. Uma delas vence na maioria das vezes, e vou dizer qual.
A consulta que todo mundo escreve primeiro (e depois se arrepende)
A Wikipédia tem mais de um milhão de artigos geocodificados só em inglês — todos com latitude e longitude nas tabelas page ou geo_tags. Seu próprio dataset pode ser de lojas, usuários, sensores IoT, o que for. A consulta ingênua fica assim:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
Essa é a fórmula de haversine, e ela está correta. Também não é indexável. O banco precisa calcular trigonometria em cada linha, a cada requisição. Numa tabela de um milhão de linhas que testei há um tempo, isso rodou em cerca de 800ms por consulta no Postgres com cache aquecido. Serve para uma demo. É catastrófico com 50 requisições por segundo, quando você já tem 40 segundos de cálculo para fazer a cada segundo. A fila cresce, as conexões se acumulam e, de repente, você é o protagonista do canal de incidentes.
As duas soluções reais compartilham o mesmo truque: substituir a checagem de distância cara, linha a linha, por um filtro barato de candidatos. Use um índice para reduzir o milhão de linhas a algumas centenas de candidatos e só então faça a conta exata de distância neles. Geohashes e índices espaciais são duas formas diferentes de fazer essa filtragem de candidatos. É essa comparação que importa.
Como geohashes transformam geografia em prefixos de string
Um geohash codifica um par latitude/longitude como uma string curta, dividindo o globo repetidamente ao meio. Cada caractere que você adiciona reduz a célula pela metade. "u4pruydqqvj" é um banco em Londres; "u4pruyd" é um quadrado de ~150m que contém esse banco; "u4p" é um quadrado de ~40km que contém metade do sul de Londres. A propriedade bonita: pontos próximos compartilham prefixos de string, e casar prefixos é exatamente o que um índice B-tree comum faz de olhos fechados.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
O fluxo de trabalho: na escrita, calcule o geohash de cada linha (uma função pura, microssegundos). Na consulta, calcule a célula de geohash que cobre seu ponto com uma precisão cujo tamanho se aproxime do seu raio e depois calcule também seus oito vizinhos. Essa é a parte que as pessoas esquecem, porque um ponto perto da borda de uma célula terá vizinhos do outro lado da fronteira. Filtre os candidatos por prefixo e aplique haversine exata nos sobreviventes. Você passa de um milhão de cálculos de distância para talvez algumas centenas.
O apelo é a portabilidade. Consultas por prefixo de geohash funcionam em qualquer coisa que indexe strings: chaves de ordenação do DynamoDB, Elasticsearch, sorted sets do Redis (é isso que o GEOADD usa por baixo — um score codificado em geohash dentro de um ZSET), SQLite, um arquivo ordenado em disco. Sem extensões, sem tipos de coluna exóticos. Se sua infraestrutura é um NoSQL ou um serviço gerenciado sem suporte espacial, geohashes são muitas vezes sua única opção real. Também são trivialmente shardáveis, por isso aparecem em sistemas que particionam dados de localização entre nós.
As fraquezas são reais, porém. A precisão é quantizada: você escolhe um tamanho de célula que seja um superconjunto grosseiro do seu raio e aceita o over-fetch, ou escolhe células menores e faz mais consultas por prefixo. Os tamanhos de célula também distorcem com a latitude — uma célula de 5 caracteres é bem mais alta do que larga, e a proporção muda conforme você se afasta do equador. E você mantém uma coluna desnormalizada por conta própria, com toda a diversão de consistência em atualizações que isso implica. É um hack engenhoso em cima de um índice de string, e se comporta como um.
Índices espaciais: GiST do PostGIS e a família R-Tree
A alternativa é deixar o banco entender geometria nativamente. O PostGIS dá ao Postgres um tipo geography e um índice GiST (generalized search tree) sobre ele — internamente uma R-tree que aninha bounding boxes hierarquicamente. A consulta fica quase constrangedoramente simples:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin usa o índice diretamente — sem uma etapa de candidato-depois-refino que você gerencie na mão, sem lógica de células vizinhas, sem ajuste de precisão. O banco faz o pré-filtro por bounding box e a distância exata no esferoide em um único operador, com semântica correta em metros porque geography leva em conta o formato da Terra. No meu antes e depois naquela tabela de um milhão de linhas: o scan com haversine, de ~800ms, virou ~4ms com o índice GiST no mesmo raio. Isso não é uma otimização, é outro esporte.
Além da velocidade bruta, você ganha correção de graça e composabilidade de bônus. Quer "dentro deste polígono" em vez de um círculo? ST_Intersects. Quer um buffer em volta de uma linha de rota? ST_DWithin contra um linestring. Quer os K vizinhos mais próximos sem saber um raio de antemão? O operador <-> com um índice GiST faz KNN ordenado pelo índice — exatamente o que você precisa para o comportamento de "menos de 25 resultados por perto? volte para os 25 mais próximos em até 10 km" que o site local da Wikipédia implementa. Escrever lógica de fallback em camadas em cima de prefixos de geohash significa implementar várias tentativas de raio na mão; com KNN, é uma consulta só que simplesmente continua percorrendo o índice.
O custo é a dependência. Você precisa de Postgres com a extensão PostGIS (quase universal em Postgres gerenciado hoje — RDS, Cloud SQL, Supabase, todos a trazem), ou do suporte espacial do MySQL (funcional, mas com arestas mais ásperas e indexação historicamente mais fraca), ou de SQLite com SpatiaLite. Você também herda peso operacional: SRIDs de geometria para manter em ordem, escritas um pouco mais pesadas e um planner que às vezes precisa de um empurrãozinho para realmente usar o índice espacial em tabelas pequenas.
Benchmarks e a tabela de trade-offs sem enfeite
Números de um benchmark que rodei recentemente para esse tipo de carga — 1,2 milhão de pontos (mais ou menos a escala dos artigos geocodificados da Wikipédia), Postgres 16, consultas com raio de 3 km em coordenadas urbanas aleatórias, cache aquecido:
- Scan completo com haversine: ~800ms. Incluído apenas como alerta.
- Prefixo de geohash (célula de 5 caracteres + 8 vizinhos) + refino com haversine: ~12ms na mediana, mas ~40ms no p95 quando a célula faz over-fetch em áreas densas, como centros de cidade.
- PostGIS GiST com ST_DWithin: ~4ms na mediana, ~8ms no p95, e praticamente estável conforme a densidade aumenta.
- KNN do PostGIS (
<->) para os 25 mais próximos: ~2ms, e não se importa com o raio que você teria escolhido. - Redis GEOSEARCH (geohash por baixo): sub-milissegundo, mas todo o seu dataset vive na RAM e ele é um cache, não uma fonte da verdade.
Seus números vão variar com o hardware e o formato dos dados, mas a ordem é estável em todos os testes que já fiz: índice espacial < geohash em B-tree < scan bruto. A fraqueza da abordagem por geohash aparece justamente onde mais importa — nos núcleos urbanos densos, exatamente onde estão os usuários e onde uma única célula pode conter dezenas de milhares de candidatos para reverificar com haversine.
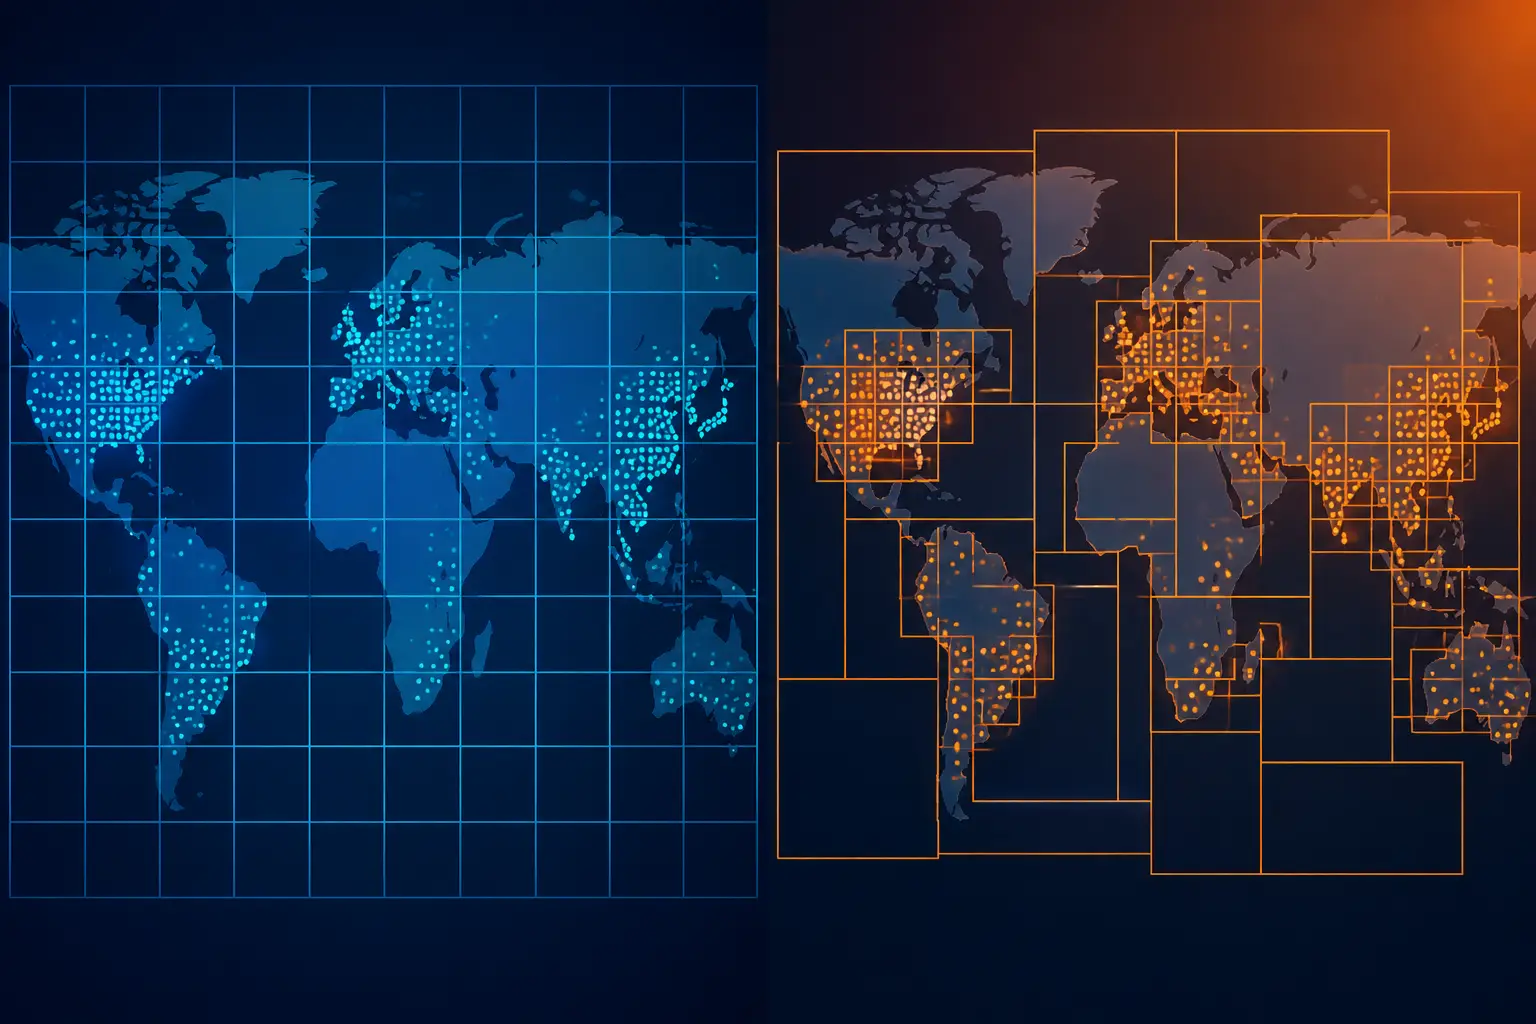
Onde os geohashes recuperam terreno é na simplicidade operacional fora do banco. Se o seu caminho de leitura é Redis (GEOSEARCH em sub-milissegundo), ou DynamoDB (prefixo de geohash como condição da chave de ordenação), ou você está enviando um dataset estático para a borda e consultando com prefixos de string em JavaScript no navegador — geohash não é um compromisso, é a arquitetura. Vários projetos paralelos de "descoberta local" funcionam inteiramente no cliente desse jeito, e como padrão combina naturalmente com o tipo de projeto web pequeno e autocontido sobre o qual escrevi em por que a pequena web é a melhor parte da internet: um site estático, um índice pré-computado, zero servidores.
Raio vs isócrona: a abstração que você está realmente entregando
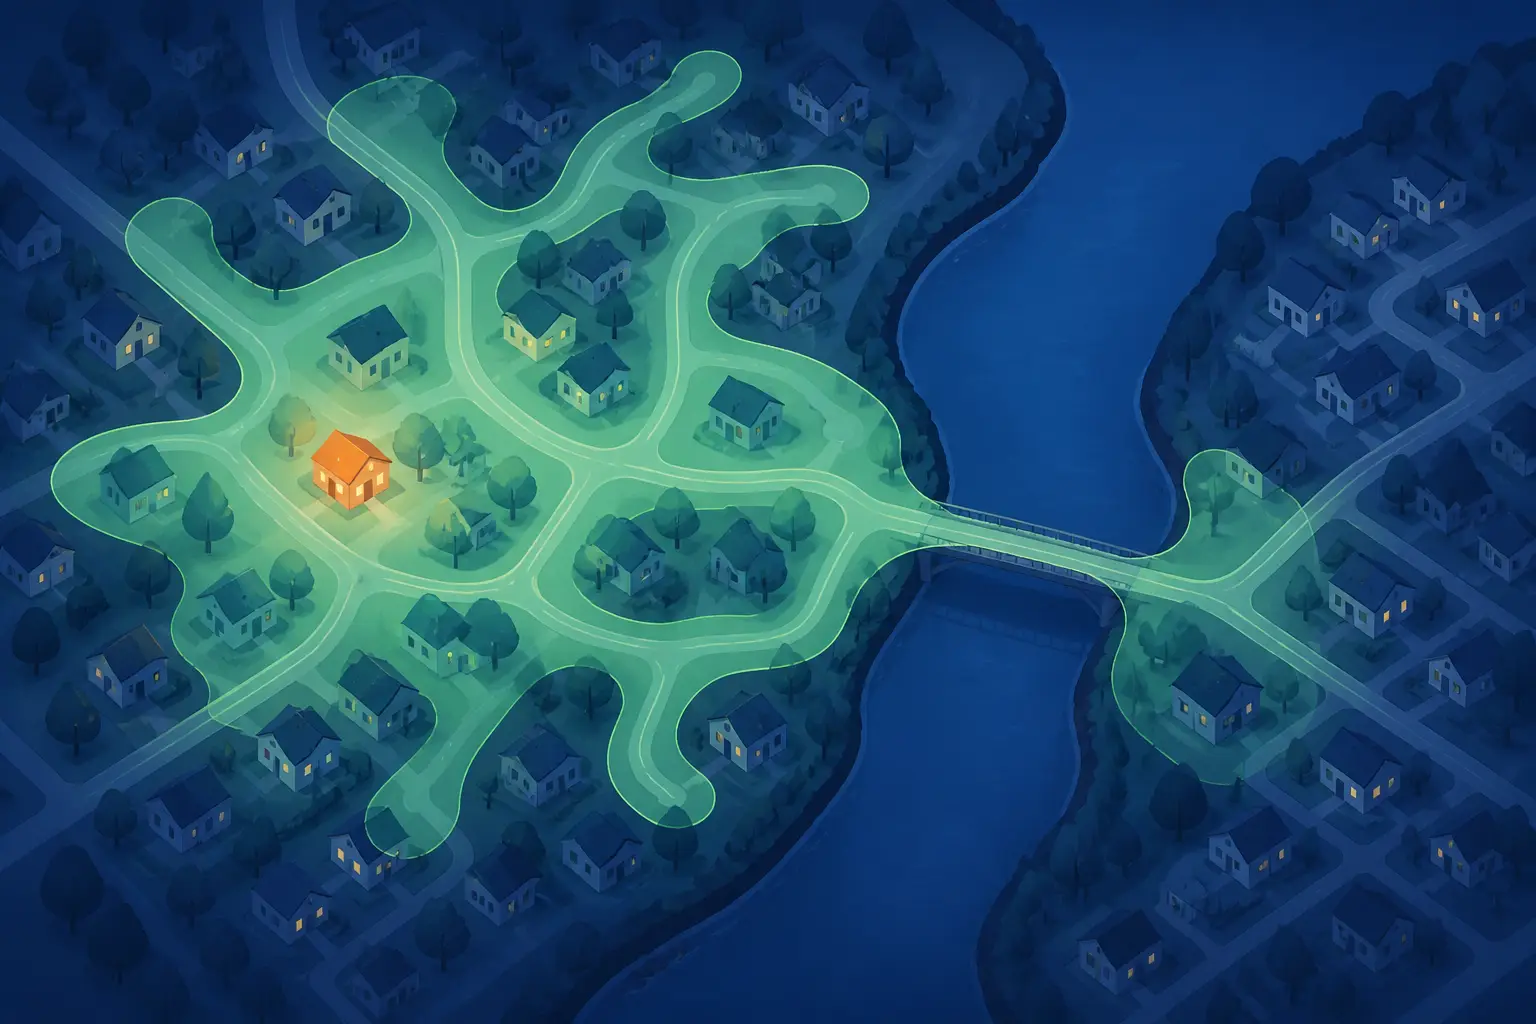
Aqui está a coisa pela qual o projeto local da Wikipédia levou uma leve alfinetada: ele diz "meia hora de caminhada", mas na prática desenha um círculo de 3 km em linha reta. Um rio sem ponte, uma rodovia, um pátio ferroviário cercado — o círculo não sabe disso. Uma verdadeira meia hora de caminhada é uma isócrona: a mancha irregular de tudo o que é alcançável em 30 minutos pela rede real de caminhos. Dois pontos separados por 1 km em linha reta podem estar a 40 minutos de caminhada um do outro se houver um estuário no meio.
Calcular uma isócrona significa rodar um motor de roteamento — dados do OpenStreetMap via OSRM, Valhalla ou GraphHopper — expandindo uma árvore de caminhos mais curtos a partir do seu ponto até o tempo de viagem atingir o orçamento, e depois traçando o contorno da área alcançável como um polígono. São minutos de pré-processamento do grafo por região e dezenas de milissegundos por consulta, contra microssegundos de um círculo. Mas, uma vez que você tem o polígono, a consulta de contenção é só um ST_Intersects, que o mesmo índice espacial lida lindamente. É um dos casos em que o lado dos índices espaciais se distancia ainda mais: polígonos são cidadãos de primeira classe ali, enquanto os truques de prefixo de geohash ficam genuinamente trabalhosos para formas arbitrárias (você acaba cobrindo o polígono com um conjunto de células — factível, existem bibliotecas de Z-order e S2 para isso, mas é um projeto à parte).
Minha opinião sincera: para a maioria dos produtos, o círculo é a mentira certa. Usuários não auditam o seu modelo de caminhada; eles percebem se os resultados são rápidos e razoavelmente sensatos. "Até 3 km" se correlaciona bem o suficiente com "perto", então a infraestrutura extra de um motor de roteamento é difícil de justificar para uma funcionalidade de navegação de conteúdo. O momento em que você faz promessas com consequências — ETAs de entrega, despacho de entregadores, cobertura de resposta a emergências — o círculo vira passivo e a isócrona se paga. Escolha a abstração com base em saber se errar custa dinheiro ou apenas causa uma leve surpresa.
Obtendo os dados: Wikipédia geocodificada e busca de endereços
Se você quer construir algo nesse espírito, a parte de dados é mais acessível do que as pessoas imaginam. As coordenadas da Wikipédia vêm do sistema de templates GeoHack e podem ser consultadas pelo endpoint list=geosearch da API do MediaWiki — que é, ele próprio, uma consulta por raio sobre um índice espacial, e é o que a funcionalidade "Nearby" do projeto encapsula. A propriedade P625 (localização geográfica) da Wikidata cobre muito mais do que a Wikipédia em inglês, caso você queira entidades multilíngues ou que não sejam artigos. Para busca de endereços, o projeto usa o Photon, um geocodificador baseado em Elasticsearch construído sobre os dados do Nominatim do OpenStreetMap — gratuito para hospedar você mesmo, com um endpoint de demonstração público que pessoas generosas mantêm e que você não deve bombardear em produção.
Uma decisão de design que vale copiar: o site guarda sua localização no navegador e nunca a coloca em URLs compartilháveis. Esse é o padrão certo, e espelha a lição de o que os apps de fitness nos ensinam sobre dados de localização e OPSEC — as coordenadas de um usuário estão entre as strings mais sensíveis que seu app vai manter, e a forma mais barata de protegê-las é nunca enviá-las ao seu servidor. Faça a geocodificação no cliente ou através de um geocodificador de terceiros com o qual o navegador conversa diretamente, guarde apenas coordenadas arredondadas caso precise registrar algo, e sua postura de privacidade se escreve sozinha.
Para o fallback de "os N mais próximos, independentemente do raio", resista à vontade de implementar loops de tentativa com raio crescente. O operador KNN do PostGIS faz isso em uma única consulta indexada:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
Essa única linha substitui toda a escada de "tenta 3 km, depois 6 km, depois 10 km" que vejo em tantas bases de código, e é mais rápida do que uma rodada dessa escada.
A recomendação
Se você levar uma única coisa desta comparação, leve esta: comece com PostGIS e um índice GiST, e só recorra a geohashes quando sua camada de armazenamento obrigar.
O raciocínio é simples. O índice espacial vence na latência mediana, vence com folga no p95 em áreas densas, vence em correção (distâncias de esferoide precisas em metros, sem bugs de borda de célula), vence em funcionalidades (polígonos, KNN, contenção por isócrona viram uma linha só) e vence em código que você não precisa escrever nem manter. A abordagem por geohash exige que você implemente corretamente o cálculo de células vizinhas, a seleção de precisão e um filtro em duas fases — três lugares para errar sutilmente — para chegar a um desempenho que ainda assim é pior.
Geohashes se justificam em exatamente três situações: seu datastore não tem suporte espacial (DynamoDB, Redis puro, um arquivo JSON estático em um CDN), você precisa de sharding por localização entre nós, ou está levando a consulta para o cliente e quer zero dependências. Nesses casos, apoie-se numa biblioteca testada em batalha — ngeohash em Node, python-geohash, ou S2 geometry se você for cobrir polígonos — em vez de implementar na mão a matemática de vizinhos.
E do lado do produto: entregue o círculo primeiro, rotule-o com honestidade ("até 3 km" em vez de "meia hora de caminhada"), torne o raio configurável porque usuários rurais e urbanos vivem em universos de densidade diferentes, e só evolua para isócronas quando a mentira da linha reta começar a custar algo mensurável. O projeto local da Wikipédia é um lembrete bonito de que as melhores funcionalidades costumam ser apenas uma boa consulta espacial vestida com uma ideia amigável. Um milhão de artigos, um índice, um raio bem escolhido — e de repente a maior enciclopédia da internet parece ter sido escrita sobre a sua rua.