Geohash vs Spatial Index untuk Pencarian Terdekat
Geohash vs spatial index untuk aplikasi geo: benchmark, contoh PostGIS, radius vs isochrone, dan rekomendasi untuk pencarian terdekat.
 Marcus Rodriguez
Ada yang bikin situs yang menampilkan Wikipedia, tapi hanya artikel tentang tempat yang berjarak setengah jam jalan kaki dari lokasi kamu berdiri. Idenya menyenangkan, sempat viral, dan juga jadi alasan sempurna untuk membahas masalah yang pasti dihadapi setiap aplikasi berbasis lokasi: geohash vs spatial index — dan pertanyaan yang lebih dalam, yaitu radius vs isochrone, saat kamu perlu menjawab "apa saja yang ada di dekat titik ini?" di atas jutaan baris.
Saya sudah membuat query ini lebih sering dari yang bisa saya hitung — mulai dari pencari restoran, pelacakan aset, sampai fitur jangkauan pengiriman yang hampir bikin database tumbang. Versi naif yang biasanya ditulis orang pertama kali adalah full-table scan dengan rumus jarak di klausa WHERE. Di dev dengan 500 baris ia jalan dengan baik. Di produksi dengan 5 juta baris, ia ambruk. Jadi mari kita bandingkan dua pendekatan yang benar-benar bertahan di skala besar: bucketing berbasis geohash dan spatial index yang layak seperti GiST di PostGIS. Salah satunya menang di sebagian besar kasus, dan saya akan bilang yang mana.
Query yang Semua Orang Tulis Pertama (dan Menyesalinya)
Wikipedia punya lebih dari satu juta artikel ber-geocode hanya dalam bahasa Inggris — masing-masing punya latitude dan longitude di tabel page atau geo_tags. Dataset kamu mungkin berisi toko, pengguna, sensor IoT, atau apa pun. Query naifnya kira-kira seperti ini:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
Itu rumus haversine, dan benar. Tapi tidak bisa di-index. Database harus menghitung trigonometri untuk setiap baris, di setiap request. Di tabel satu juta baris yang saya benchmark beberapa waktu lalu, query ini berjalan sekitar 800ms per query di Postgres dengan cache hangat. Lumayan untuk demo. Tapi bencana di 50 request per detik, di mana kamu harus menghitung 40 detik matematika setiap detiknya. Antrean menumpuk, koneksi menggantung, dan tiba-tiba kamu jadi tokoh utama di channel insiden.
Kedua solusi nyata ini memakai trik yang sama: mengganti pengecekan jarak yang mahal per baris dengan filter kandidat yang murah. Turunkan satu juta baris menjadi beberapa ratus kandidat menggunakan index, lalu jalankan perhitungan jarak yang tepat hanya pada kandidat tersebut. Geohash dan spatial index adalah dua cara berbeda untuk melakukan filter kandidat itu. Perbandingan inilah yang penting.
Bagaimana Geohash Mengubah Geografi Menjadi Prefix String
Geohash meng-encode pasangan lat/lon menjadi string pendek dengan membagi globe secara berulang. Setiap karakter yang kamu tambahkan membagi sel menjadi setengahnya. "u4pruydqqvj" adalah sebuah bangku di London; "u4pruyd" adalah persegi sekitar 150m yang memuat bangku itu; "u4p" adalah persegi sekitar 40km yang mencakup separuh London selatan. Sifat indahnya: titik yang berdekatan berbagi prefix string, dan pencocokan prefix persis seperti yang dilakukan index B-tree yang membosankan itu tanpa usaha.
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
Alurnya: saat menulis, hitung geohash setiap baris (fungsi murni, mikrodetik). Saat query, hitung sel geohash yang menutupi titik kamu dengan presisi yang ukuran selnya kira-kira sesuai dengan radius, lalu hitung juga kedelapan tetangganya. Bagian ini sering terlupakan, karena titik yang dekat tepi sel akan punya tetangga di seberang batas. Filter kandidat berdasarkan prefix, lalu terapkan haversine yang tepat pada yang lolos. Kamu berpindah dari satu juta perhitungan jarak menjadi mungkin hanya beberapa ratus.
Daya tariknya ada di portabilitas. Query prefix geohash berjalan di apa pun yang meng-index string: sort key DynamoDB, Elasticsearch, Redis sorted set (itulah yang dipakai GEOADD di balik layar — skor ter-encode geohash di dalam ZSET), SQLite, atau file terurut di disk. Tanpa ekstensi, tanpa tipe kolom eksotis. Kalau infrastruktur kamu berupa NoSQL atau layanan terkelola tanpa dukungan spasial, geohash sering kali jadi satu-satunya pilihan nyata. Selain itu, geohash mudah di-shard, makanya sering muncul di sistem yang mempartisi data lokasi ke banyak node.
Kelemahannya tetap nyata. Presisinya terkuantisasi: kamu memilih ukuran sel yang merupakan superset kasar dari radius dan menanggung over-fetch, atau memilih sel lebih kecil dan menjalankan lebih banyak query prefix. Ukuran sel juga terdistorsi menurut latitude — sel 5 karakter jauh lebih tinggi daripada lebar, dan rasio aspeknya berubah saat menjauh dari khatulistiwa. Lalu kamu sendiri yang memelihara kolom denormalisasi, lengkap dengan kerumitan konsistensi saat update. Ini adalah trik cerdas di atas index string, dan perilakunya memang seperti itu.
Spatial Index: PostGIS GiST dan Keluarga R-Tree
Alternatifnya adalah membiarkan database memahami geometri secara native. PostGIS memberi Postgres tipe geography dan index GiST (generalized search tree) di atasnya — secara internal berupa R-tree yang menyusun bounding box secara hierarkis. Query-nya jadi hampir memalukan karena sederhana:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin langsung memakai index — tidak ada langkah kandidat-lalu-perbaikan yang harus kamu atur sendiri, tidak ada logika sel tetangga, tidak ada tuning presisi. Database melakukan prefilter bounding box dan jarak spheroid yang tepat dalam satu operator, dengan semantik meter yang benar karena geography memperhitungkan bentuk Bumi. Dalam benchmark sebelum-sesudah saya di tabel satu juta baris itu: scan haversine yang tadinya ~800ms menjadi ~4ms dengan index GiST pada radius yang sama. Ini bukan peningkatan tuning, ini beda kelas.
Selain kecepatan mentah, kamu dapat kebenaran secara gratis dan komposabilitas sebagai bonus. Ingin "di dalam poligon ini" alih-alih lingkaran? ST_Intersects. Ingin buffer di sekitar garis rute? ST_DWithin terhadap linestring. Ingin K-nearest-neighbors tanpa tahu radius di awal? Operator <-> dengan index GiST melakukan KNN yang terurut berdasarkan index — persis yang dibutuhkan untuk perilaku "kurang dari 25 hasil di dekat sini? pakai 25 terdekat dalam 6 mil" yang diterapkan situs Wikipedia lokal itu. Menulis logika fallback bertingkat di atas prefix geohash berarti harus merakit banyak percobaan radius secara manual; dengan KNN, cukup satu query yang terus menelusuri index.
Harganya adalah ketergantungan. Kamu butuh Postgres plus ekstensi PostGIS (hampir universal di Postgres terkelola sekarang — RDS, Cloud SQL, Supabase semuanya menyediakannya), atau dukungan spasial MySQL (berfungsi, tapi kasar dan secara historis indexing-nya lebih lemah), atau SQLite dengan SpatiaLite. Kamu juga mewarisi beban operasional: SRID geometri yang harus dijaga konsistensinya, penulisan yang sedikit lebih berat, dan planner yang kadang perlu didorong agar benar-benar memakai index spasial pada tabel kecil.
Benchmark dan Tabel Trade-off yang Jujur
Angka dari benchmark yang baru saya jalankan ulang untuk jenis beban kerja ini — 1,2 juta titik (kira-kira skala artikel Wikipedia ber-geocode), Postgres 16, query radius 3km di koordinat urban acak, cache hangat:
- Full-table scan haversine: ~800ms. Hanya dicantumkan sebagai peringatan.
- Prefix geohash (sel 5 karakter + 8 tetangga) + perbaikan haversine: ~12ms median, tapi ~40ms p95 saat sel over-fetch di area padat seperti pusat kota.
- PostGIS GiST dengan ST_DWithin: ~4ms median, ~8ms p95, dan kurang lebih konstan saat kepadatan naik.
- PostGIS KNN (
<->) untuk 25 terdekat: ~2ms, dan tidak peduli radius apa yang akan kamu pilih. - Redis GEOSEARCH (geohash di balik layar): di bawah milidetik, tapi seluruh dataset kamu hidup di RAM dan ia cache, bukan sumber kebenaran.
Hasilnya bisa berbeda tergantung perangkat keras dan bentuk data, tapi urutannya stabil di setiap tes yang pernah saya jalankan: spatial index < geohash-di-B-tree < scan mentah. Kelemahan pendekatan geohash muncul tepat di tempat yang paling penting — inti kota yang padat, tempat pengguna berkumpul dan satu sel bisa memuat puluhan ribu kandidat yang harus dicek ulang dengan haversine.
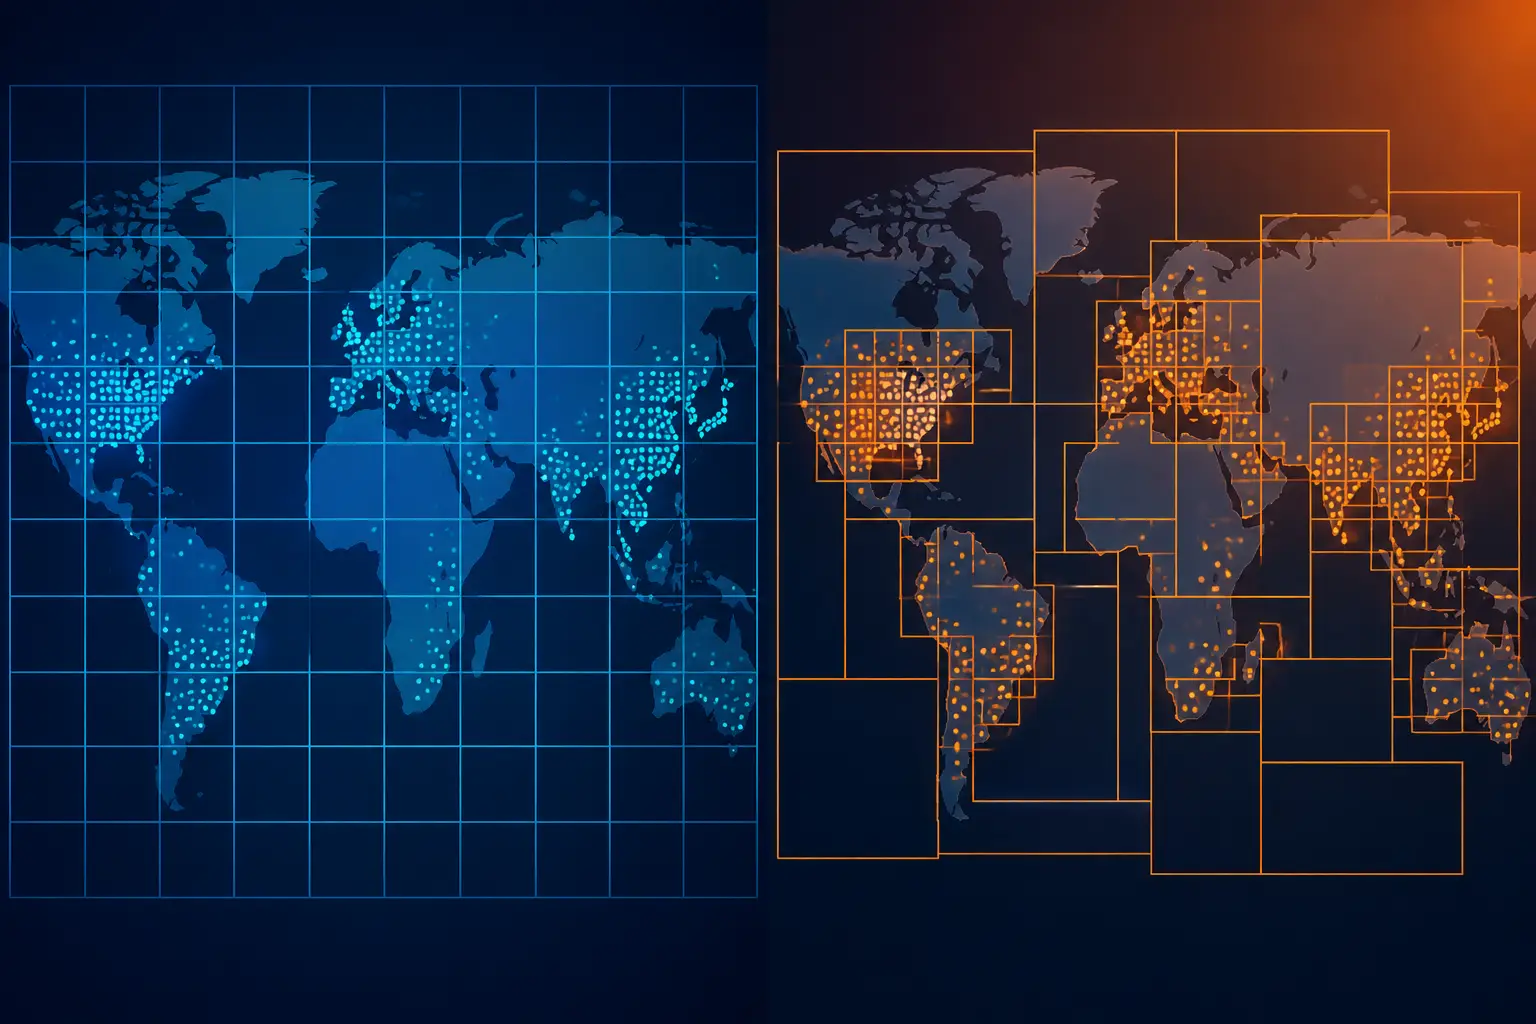
Di mana geohash mendapatkan kembali posisinya adalah kesederhanaan operasional di luar database. Jika jalur baca kamu adalah Redis (GEOSEARCH di bawah milidetik), atau DynamoDB (prefix geohash sebagai kondisi sort key), atau kamu mengirim dataset statis ke edge dan melakukan query dengan prefix string JavaScript di browser — geohash bukan kompromi, melainkan arsitekturnya. Beberapa proyek sampingan "penemuan lokal" berjalan sepenuhnya di sisi klien dengan cara ini, dan sebagai pola ia cocok dengan jenis proyek web kecil dan mandiri yang pernah saya tulis di kenapa small web adalah bagian terbaik dari internet: situs statis, index yang sudah dihitung, tanpa server.
Radius vs Isochrone: Abstraksi yang Sebenarnya Kamu Kirim
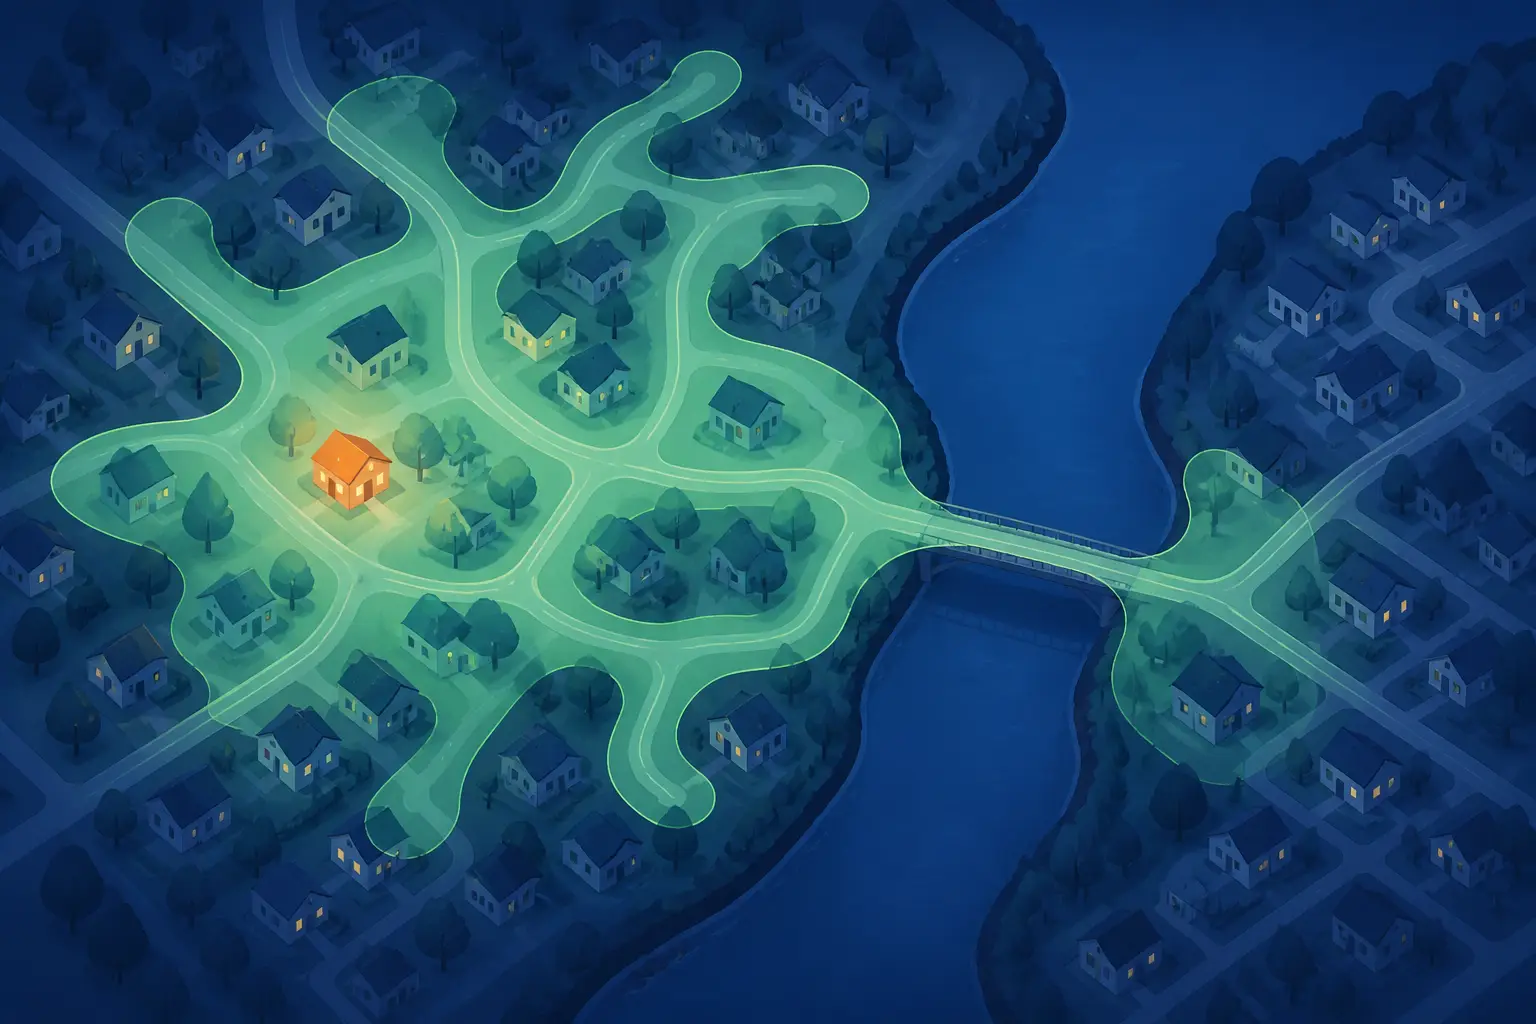
Hal yang membuat proyek Wikipedia lokal itu sedikit diledek: di situ tertulis "jalan kaki setengah jam", tapi yang sebenarnya digambar adalah lingkaran 3km garis lurus. Sungai tanpa jembatan, jalan tol, area rel yang berpagar — lingkaran itu tidak tahu apa-apa. Jalan kaki setengah jam yang sebenarnya adalah isochrone: gumpalan tidak beraturan berisi semua tempat yang bisa dicapai dalam 30 menit mengikuti jaringan jalan kaki yang nyata. Dua titik yang berjarak 1km garis lurus bisa berjarak 40 menit jalan kaki jika ada muara di antaranya.
Menghitung isochrone berarti menjalankan mesin routing — data OpenStreetMap lewat OSRM, Valhalla, atau GraphHopper — memperluas pohon jalur terpendek dari titik kamu sampai waktu tempuh mencapai anggaran, lalu membentuk kontur area yang terjangkau menjadi poligon. Itu butuh menit preprocessing graf per wilayah dan puluhan milidetik per query, dibanding mikrodetik untuk lingkaran. Tapi setelah punya poligonnya, query containment cukup ST_Intersects, yang ditangani dengan indah oleh spatial index yang sama. Ini salah satu kasus di mana kubu spatial index makin unggul: poligon adalah warga kelas satu di sana, sementara trik prefix geohash menjadi sangat canggung untuk bentuk arbitrer (kamu harus menutupi poligon dengan sekumpulan sel — bisa, library Z-order dan S2 tersedia untuk itu, tapi itu sebuah proyek tersendiri).
Pendapat jujur saya: untuk kebanyakan produk, lingkaran adalah kebohongan yang tepat. Pengguna tidak mengaudit model jalan kaki kamu; mereka hanya memperhatikan hasil yang cepat dan masuk akal. "Dalam 3km" cukup berkorelasi dengan "dekat" sehingga infrastruktur tambahan mesin routing sulit dibenarkan untuk fitur penjelajahan konten. Begitu kamu membuat janji yang punya konsekuensi — ETA pengiriman, dispatch kurir, cakupan respons darurat — lingkaran menjadi beban dan isochrone sudah terbayar. Pilih abstraksinya berdasarkan apakah salah hitung membuatmu rugi uang atau hanya sedikit kaget.
Mengambil Data: Wikipedia ber-geocode dan Pencarian Alamat
Kalau kamu ingin membangun sesuatu dengan semangat ini, plumbing datanya lebih mudah didekati daripada yang orang kira. Koordinat Wikipedia berasal dari sistem template GeoHack dan bisa di-query lewat endpoint list=geosearch di MediaWiki API — yang sendirinya adalah query radius di atas spatial index, dan itulah yang dibungkus fitur "Terdekat" proyek tersebut. Properti P625 (coordinate location) di Wikidata mencakup jauh lebih banyak daripada Wikipedia bahasa Inggris saja, jika kamu menginginkan entitas multibahasa atau non-artikel. Untuk pencarian alamat, proyek ini memakai Photon, geocoder berbasis Elasticsearch yang dibangun di atas data Nominatim OpenStreetMap — gratis di-self-host, dengan endpoint demo publik yang dijalankan oleh orang-orang baik hati dan sebaiknya jangan kamu gempur di produksi.
Satu keputusan desain yang layak dicontek: situs ini menyimpan lokasi kamu di browser dan tidak pernah memasukkannya ke URL yang bisa dibagikan. Itu default yang tepat, dan sejalan dengan pelajaran dari apa yang diajarkan aplikasi kebugaran tentang data lokasi dan OPSEC — koordinat pengguna termasuk string paling sensitif yang akan pernah dipegang aplikasimu, dan cara termurah untuk melindunginya adalah tidak pernah mengirimkannya ke server sama sekali. Lakukan geocoding di sisi klien atau lewat geocoder pihak ketiga yang langsung dihubungi browser, simpan hanya koordinat yang dibulatkan jika kamu harus mencatat sesuatu, dan postur privasimu akan terbentuk dengan sendirinya.
Untuk fallback "N terdekat tanpa peduli radius", tahan godaan untuk membuat loop retry radius yang melebar. Operator KNN PostGIS melakukannya dalam satu query ber-index:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
Satu baris itu menggantikan seluruh tangga retry "coba 3km, lalu 6km, lalu 10km" yang saya lihat di banyak codebase, dan lebih cepat daripada satu putaran tangga tersebut.
Rekomendasinya
Kalau kamu hanya mengambil satu hal dari perbandingan ini, ambil ini: mulailah dengan PostGIS dan index GiST, dan baru pakai geohash saat storage kamu memaksamu.
Alasannya sederhana. Spatial index menang di latency median, menang lebih telak di p95 di area padat, menang di kebenaran (jarak spheroid akurat sampai meter, tanpa bug tepi sel), menang di fitur (poligon, KNN, containment isochrone semuanya jadi satu baris), dan menang di kode yang tidak perlu kamu tulis dan pelihara. Pendekatan geohash mengharuskanmu mengimplementasikan komputasi sel tetangga, pemilihan presisi, dan filter dua fase dengan benar — tiga tempat untuk salah secara halus — hanya untuk mencapai performa yang tetap lebih buruk.
Geohash layak dipakai di tepat tiga situasi: datastore kamu tidak punya dukungan spasial (DynamoDB, Redis biasa, file JSON statis di CDN), kamu butuh sharding berbasis lokasi lintas node, atau kamu mendorong query ke klien dan ingin nol dependensi. Dalam kasus itu, andalkan library yang sudah teruji — ngeohash di Node, python-geohash, atau S2 geometry jika kamu perlu menutupi poligon — daripada merakit matematika tetangga sendiri.
Dan dari sisi produk: rilis lingkaran dulu, beri label dengan jujur ("dalam 3km" bukan "jalan kaki setengah jam"), jadikan radius bisa dikonfigurasi karena pengguna di desa dan di kota hidup di semesta kepadatan yang berbeda, dan naik ke isochrone hanya ketika kebohongan garis lurus mulai merugikanmu secara terukur. Proyek Wikipedia lokal itu adalah pengingat indah bahwa fitur terbaik sering kali hanyalah query spasial yang bagus yang memakai ide yang ramah. Satu juta artikel, satu index, satu radius yang dipilih dengan baik — dan tiba-tiba ensiklopedia terbesar di internet terasa seperti ditulis tentang jalanmu sendiri.