Geohash बनाम Spatial Index: नज़दीकी सर्च का सही तरीका
Geohash बनाम spatial index: नज़दीकी सर्च के लिए benchmarks, PostGIS उदाहरण, radius बनाम isochrone का फ़र्क और साफ़ सिफ़ारिश।
 Marcus Rodriguez
किसी ने एक ऐसी साइट बनाई है जो आपको Wikipedia दिखाती है, लेकिन सिर्फ़ उन लेखों की जो आप जहाँ खड़े हैं वहाँ से आधे घंटे की पैदल दूरी के अंदर की चीज़ों के बारे में हैं। यह बहुत मज़ेदार है, वायरल भी हुई है, और यह उस समस्या पर बात करने का एक बढ़िया बहाना भी है जिससे हर geo-aware application को देर-सबेर सामना करना पड़ता है: geohash बनाम spatial index — और उससे भी गहरा सवाल कि जब लाखों rows में “इस बिंदु के आसपास क्या है?” पूछना हो, तो radius बनाम isochrone में से कौन सा चुनें।
मैंने यह query जितनी बार बनाई है, गिनना मुश्किल है — restaurant finder, asset tracking, और एक delivery-radius feature जिसने लगभग database गिरा दिया था। हर कोई सबसे पहले जो naive version लिखता है वह है WHERE clause में distance formula के साथ full-table scan। यह dev में 500 rows पर चल जाता है। production में 5 million पर मर जाता है। तो आइए उन दो तरीकों की तुलना करें जो असल में scale पर टिकते हैं: geohash-based bucketing और PostGIS के GiST जैसा proper spatial index। इनमें से एक ज़्यादातर समय जीतता है, और मैं बताऊँगा कौन सा।
वह Query जो हर कोई पहले लिखता है (और बाद में पछताता है)
अंग्रेज़ी में अकेले Wikipedia पर ही दस लाख से ज़्यादा geocoded articles हैं — हर एक का latitude और longitude page या geo_tags tables में है। आपके अपने dataset में stores, users, IoT sensors, कुछ भी हो सकता है। naive query कुछ ऐसी दिखती है:
SELECT title, lat, lon,
2 * 6371 * ASIN(SQRT(
POWER(SIN(RADIANS(lat - :lat) / 2), 2) +
COS(RADIANS(:lat)) * COS(RADIANS(lat)) *
POWER(SIN(RADIANS(lon - :lon) / 2), 2)
)) AS distance_km
FROM places
HAVING distance_km < 3
ORDER BY distance_km
LIMIT 25;
यह haversine formula है, और यह सही है। लेकिन इसे index नहीं किया जा सकता। database को हर request पर हर एक row के लिए trigonometry निकालनी पड़ती है। कुछ समय पहले मैंने एक दस लाख rows वाली table पर benchmark किया था, warm cache के साथ Postgres पर यह लगभग 800ms प्रति query चला। डेमो के लिए ठीक है। 50 requests प्रति सेकंड पर तबाही, क्योंकि तब हर सेकंड आपको 40 सेकंड का math करना पड़ता है। queue बढ़ती है, connections जमा होने लगते हैं, और अचानक आप incident channel के मुख्य किरदार बन जाते हैं।
दोनों असली समाधान एक ही चाल चलते हैं: महँगी per-row distance check को सस्ते candidate filter से बदल दो। index की मदद से दस लाख rows को कुछ सौ candidates तक लाओ, फिर exact distance math सिर्फ़ उन्हीं पर चलाओ। Geohash और spatial index candidate filtering के दो अलग तरीके हैं। असली तुलना यही है।
Geohash कैसे भूगोल को string prefixes में बदल देता है
Geohash एक lat/lon जोड़ी को बार-बार globe को दो हिस्सों में बाँटकर एक छोटी string में encode करता है। हर character जोड़ने पर cell आधा हो जाता है। “u4pruydqqvj” लंदन की एक बेंच है; “u4pruyd” लगभग 150 मीटर का वह वर्ग है जिसमें वह बेंच आती है; “u4p” लगभग 40 किलोमीटर का वर्ग है जिसमें दक्षिण लंदन का आधा हिस्सा आता है। खूबसूरत बात यह है: पास के points के string prefixes एक जैसे होते हैं, और prefix matching वही काम है जो एक साधारण B-tree index आराम से कर देता है।
-- Store the geohash at insert time, index it like any string
CREATE INDEX idx_places_geohash ON places(geohash);
-- A 3km radius fits mostly inside a 5-char geohash cell (~4.9km x 4.9km)
SELECT * FROM places
WHERE geohash LIKE 'u4pru%'   -- plus the 8 neighboring cells
AND haversine(lat, lon, :lat, :lon) < 3000;
Workflow यह है: लिखते समय हर row का geohash निकालो (एक शुद्ध function, microseconds लगते हैं)। query के समय अपने point को कवर करने वाला geohash cell उस precision पर निकालो जिसका cell size आपके radius के लगभग बराबर हो, और फिर उसके आठों पड़ोसी cells भी निकालो। यह वह हिस्सा है जो लोग अक्सर भूल जाते हैं, क्योंकि cell की किनारे के पास वाला point boundary के पार पड़ोसियों के पास भी हो सकता है। Prefix से candidates छानो, फिर बचे हुए पर exact haversine लगाओ। एक दस लाख distance calculations से घटकर शायद कुछ सौ रह जाते हैं।
इसकी खूबी portability है। Geohash prefix queries हर उस चीज़ में चलती हैं जो strings को index करती है: DynamoDB sort keys, Elasticsearch, Redis sorted sets (GEOADD अंदर से यही इस्तेमाल करता है — ZSET में geohash-encoded score), SQLite, या disk पर रखी एक sorted file। कोई extension नहीं, कोई खास column type नहीं। अगर आपका infrastructure NoSQL store है या कोई managed service है जिसमें spatial support नहीं, तो geohash अक्सर आपका एकमात्र असली विकल्प होता है। ये आसानी से shard भी हो जाते हैं, इसीलिए location data को nodes में बाँटने वाले systems में ये दिखते हैं।
कमज़ोरियाँ भी असली हैं। Precision quantized होती है: या तो आप एक ऐसा cell size चुनते हैं जो आपके radius का मोटा superset हो और extra data झेलते हैं, या छोटे cells चुनकर ज़्यादा prefix queries चलाते हैं। Cell sizes latitude के साथ भी बिगड़ते हैं — 5-character वाला cell चौड़ाई से कहीं ज़्यादा लंबा होता है, और भूमध्य रेखा से दूर जाने पर aspect ratio बदल जाता है। और denormalized column आपको खुद संभालना पड़ता है, उसकी update-consistency की सारी परेशानियों के साथ। यह string index के ऊपर एक चतुर जुगाड़ है, और यह वैसा ही बर्ताव करता है।
Spatial Indexes: PostGIS GiST और R-Tree परिवार
दूसरा तरीका है database को geometry को सीधे समझने देना। PostGIS Postgres को geography type और उस पर एक GiST (generalized search tree) index देता है — अंदर से यह एक R-tree है जो bounding boxes को पदानुक्रम में नेस्ट करता है। query लगभग शर्मिंदा कर देने की हद तक सरल हो जाती है:
ALTER TABLE places ADD COLUMN geog geography(Point, 4326);
UPDATE places SET geog = ST_MakePoint(lon, lat)::geography;
CREATE INDEX idx_places_geog ON places USING GIST(geog);
SELECT title, ST_Distance(geog, ST_MakePoint(:lon, :lat)::geography) AS dist_m
FROM places
WHERE ST_DWithin(geog, ST_MakePoint(:lon, :lat)::geography, 3000)
ORDER BY dist_m
LIMIT 25;
ST_DWithin सीधे index का इस्तेमाल करता है — कोई candidate-फिर-refine वाला step नहीं जो आपको हाथ से संभालना पड़े, कोई neighbor-cell logic नहीं, कोई precision tuning नहीं। Database एक ही operator में bounding-box prefilter और exact spheroid distance दोनों करता है, और geography पृथ्वी के आकार को ध्यान में रखता है, इसलिए meter-आधारित semantics सही रहते हैं। उस दस लाख rows वाली table पर मेरे अपने before/after में: ~800ms वाला haversine scan GiST index के साथ उसी radius पर ~4ms हो गया। यह tuning की जीत नहीं है, यह अलग खेल है।
कच्ची रफ़्तार के अलावा, correctness मुफ़्त मिलती है और composability बोनस में। चाहते हैं “इस polygon के अंदर”, circle की जगह? ST_Intersects। Route line के चारों ओर buffer चाहिए? linestring के खिलाफ ST_DWithin। Radius पहले से जाने बिना K-nearest-neighbors चाहिए? GiST index के साथ <-> operator index-ordered KNN देता है — ठीक वही जो स्थानीय Wikipedia साइट के “क्या पास में 25 से कम नतीजे हैं? तो 6 मील के अंदर सबसे नज़दीकी 25 दिखाओ” वाले व्यवहार के लिए चाहिए। Geohash prefixes पर tiered fallback logic लिखने का मतलब है हाथ से कई radius attempts लिखना; KNN के साथ यह एक query है जो बस index में चलती रहती है।
कीमत है dependency। आपको Postgres के साथ PostGIS extension चाहिए (अब managed Postgres पर लगभग हर जगह उपलब्ध है — RDS, Cloud SQL, Supabase सब इसे देते हैं), या MySQL का spatial support (काम करता है, पर खुरदरे किनारे हैं और ऐतिहासिक रूप से indexing कमज़ोर रही है), या SpatiaLite वाला SQLite। आपको operational भार भी मिलता है: geometry SRIDs का हिसाब रखना, थोड़े भारी writes, और ऐसा planner जो छोटी tables पर कभी-कभी spatial index इस्तेमाल करवाने के लिए एक धक्का माँगता है।
Benchmarks और ईमानदार trade-off table
इस तरह के workload के लिए हाल में दोबारा चलाए गए benchmark के नंबर — 1.2 मिलियन points (लगभग Wikipedia के geocoded-article पैमाने के), Postgres 16, शहरी इलाकों में random coordinates पर 3km radius queries, warm cache:
- पूरी table पर haversine scan: ~800ms। सिर्फ़ चेतावनी के तौर पर शामिल किया है।
- Geohash prefix (5-char cell + 8 neighbors) + haversine refine: median ~12ms, लेकिन घनी जगहों जैसे शहर के केंद्र में cell ज़्यादा data लाता है, तो p95 ~40ms।
- PostGIS GiST के साथ ST_DWithin: median ~4ms, p95 ~8ms, और घनत्व बढ़ने पर लगभग स्थिर।
- PostGIS KNN (
<->) 25 सबसे नज़दीकी के लिए: ~2ms, और इसे इससे फ़र्क नहीं पड़ता कि आप कौन सा radius चुनते। - Redis GEOSEARCH (अंदर geohash): sub-millisecond, लेकिन आपका पूरा dataset RAM में रहता है और यह cache है, source of truth नहीं।
हार्डवेयर और data के आकार से नतीजे बदलेंगे, पर क्रम हर उस test में स्थिर रहा है जो मैंने कभी चलाया: spatial index < B-tree पर geohash < कच्चा scan। Geohash का कमज़ोर पहलू ठीक वहीं दिखता है जहाँ सबसे ज़्यादा मायने रखता है — घनी शहरी केंद्र, वही जगहें जहाँ users होते हैं और जहाँ एक cell में दसियों हज़ार candidates होते हैं जिन्हें haversine से दोबारा जाँचना पड़ता है।
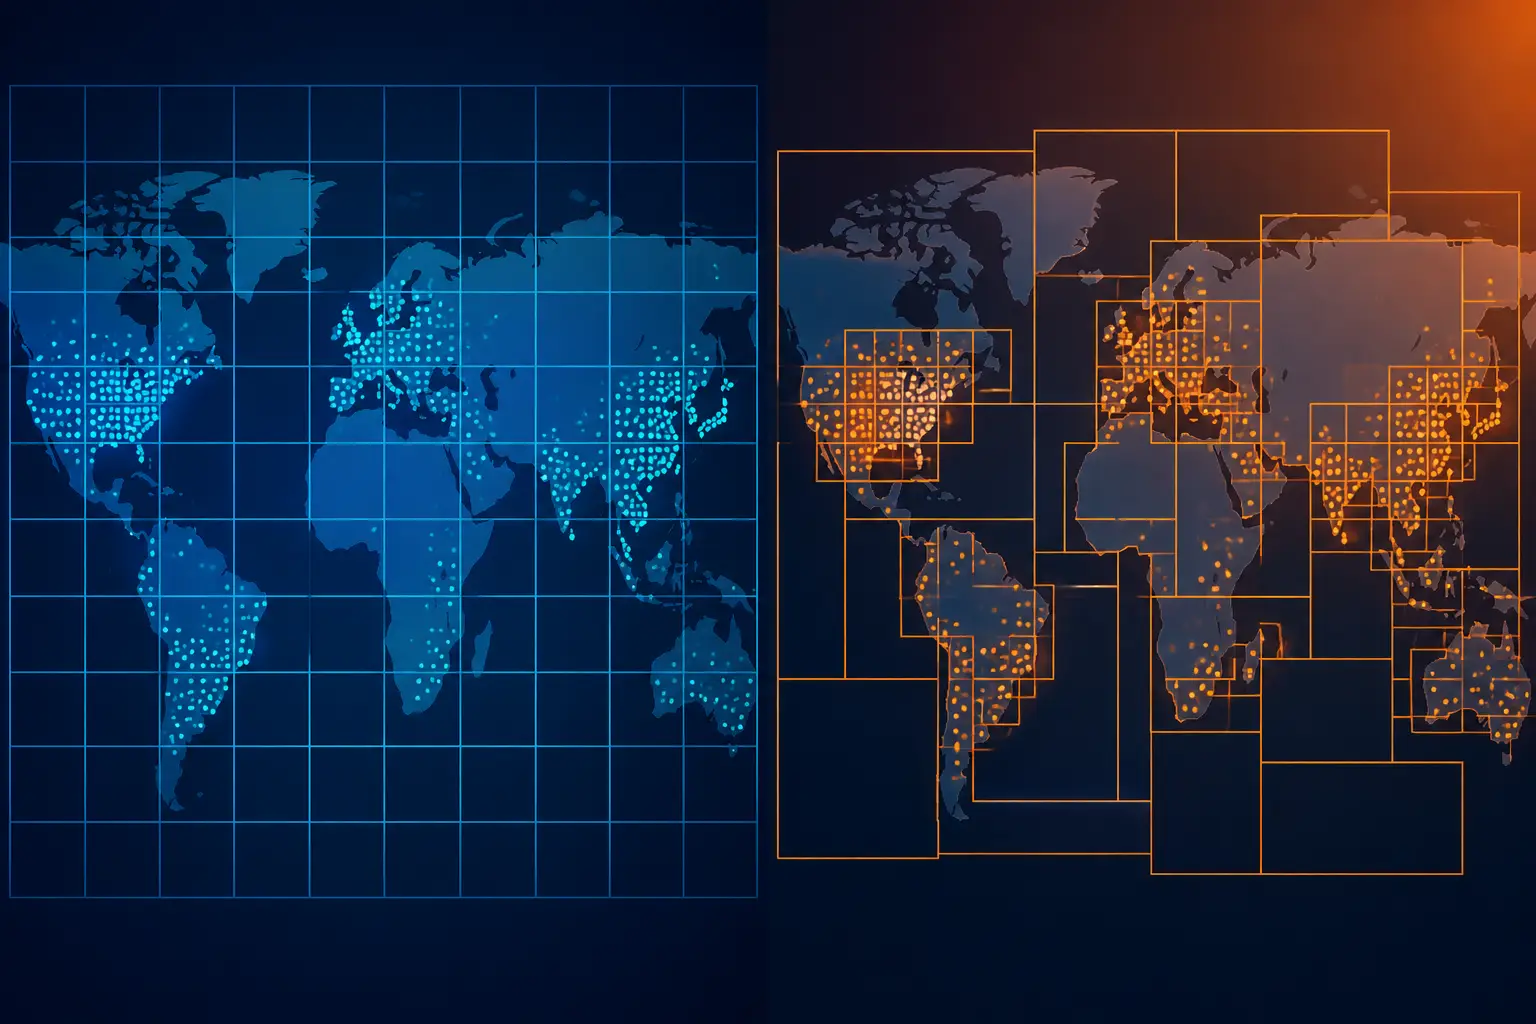
Geohash की मज़बूती वहाँ वापस आती है जहाँ database के बाहर का operational सरलता चाहिए। अगर आपका read path Redis है (sub-millisecond GEOSEARCH), या DynamoDB (sort key condition के रूप में geohash prefix), या आप एक static dataset edge पर भेज रहे हैं और browser में JavaScript string prefixes से query कर रहे हैं — तो geohash समझौता नहीं, बल्कि आर्किटेक्चर है। कई “local discovery” side projects इसी तरह पूरी तरह client-side चलते हैं, और यह pattern उन छोटे, self-contained web projects के साथ स्वाभाविक रूप से मेल खाता है जिनके बारे में मैंने इंटरनेट का सबसे अच्छा हिस्सा छोटा वेब क्यों है में लिखा था: एक static site, एक precomputed index, कोई server नहीं।
Radius बनाम Isochrone: वह abstraction जो आप असल में ship कर रहे हो
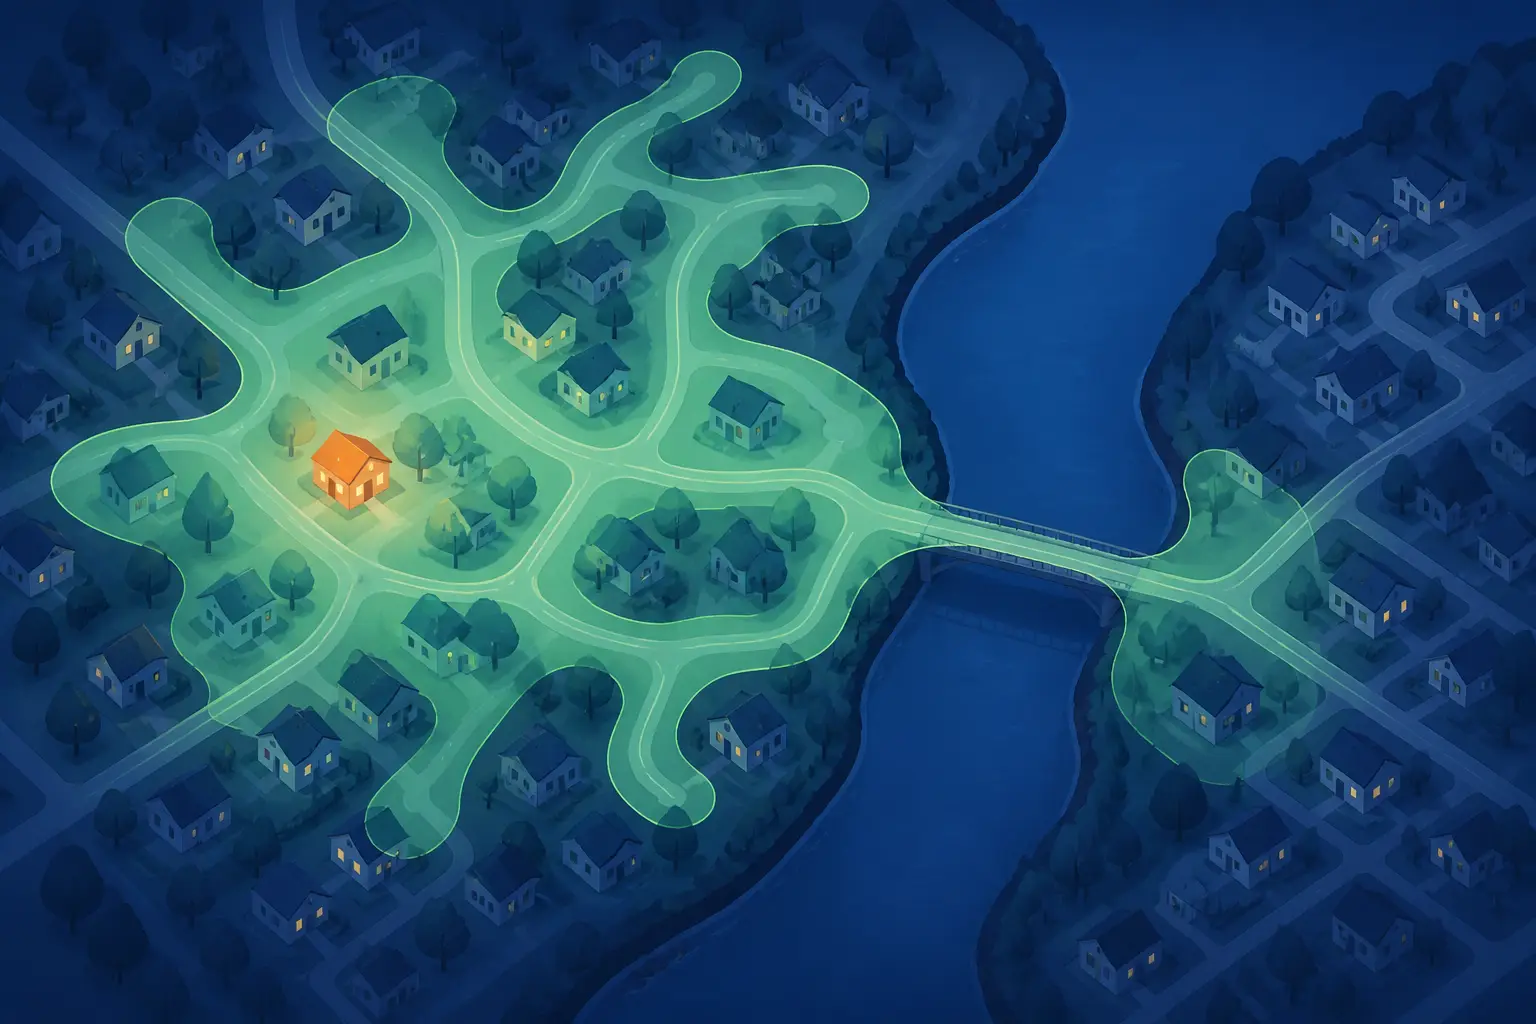
जिस बात पर स्थानीय Wikipedia प्रोजेक्ट को हल्का-सा मज़ाक झेलना पड़ा: वह कहती है “आधे घंटे की पैदल दूरी”, पर असल में वह 3km की सीधी-हवाई circle बनाती है। नदी जिस पर पुल नहीं है, एक motorway, एक घिरा हुआ rail yard — circle को इनकी कोई खबर नहीं। असली आधे घंटे की पैदल दूरी एक isochrone है: वह अनियमित आकार जिसमें वह सब आता है जो असली पैदल रास्तों पर 30 मिनट में पहुँचा जा सकता है। हवाई सीधी रेखा में 1km दूर दो बिंदु पैदल 40 मिनट दूर हो सकते हैं, अगर बीच में कोई खाड़ी हो।
Isochrone निकालने के लिए routing engine चलाना पड़ता है — OpenStreetMap data को OSRM, Valhalla या GraphHopper से, आपके बिंदु से सबसे छोटे-रास्ते वाला tree तब तक फैलाकर जब तक यात्रा का समय बजट तक न पहुँच जाए, फिर पहुँच वाले इलाके को polygon में बदलकर। यह हर इलाके के लिए मिनटों का graph preprocessing और हर query पर दसियों milliseconds है, जबकि circle में माइक्रोसेकंड लगते हैं। पर एक बार polygon मिल जाए, तो containment query बस ST_Intersects है, जिसे वही spatial index बखूबी संभालता है। यह उन मामलों में से है जहाँ spatial-index खेमा और आगे निकल जाता है: वहाँ polygons पहली श्रेणी के नागरिक हैं, जबकि geohash prefix की चालें मनमाने आकारों के लिए सच में अटपटी हो जाती हैं (आपको polygon को cells के समूह से ढकना पड़ता है — यह संभव है, इसके लिए Z-order और S2 libraries भी हैं, पर यह अपने आप में एक प्रोजेक्ट है)।
मेरी ईमानदार राय: ज़्यादातर products के लिए circle सही “झूठ” है। Users आपके पैदल चलने के model का ऑडिट नहीं करते; वे नतीजों की रफ़्तार और लगभग सही होने को नोटिस करते हैं। “3km के अंदर” “नज़दीक” से काफ़ी अच्छी तरह मेल खाता है, इसलिए content-browsing फ़ीचर के लिए routing engine का अतिरिक्त infrastructure मुश्किल से जायज़ ठहरता है। जैसे ही आप ऐसे वादे करने लगते हैं जिनके परिणाम होते हैं — delivery ETAs, courier dispatch, emergency response coverage — circle देनदारी बन जाता है और isochrone अपनी कीमत खुद चुका देता है। Abstraction इस पर चुनें कि गलत होने से आपका पैसा जाएगा या बस हल्की हैरानी होगी।
Data जुटाना: Geocoded Wikipedia और address search
अगर आप इसी भावना में कुछ बनाना चाहते हैं, तो data का काम लोगों के अनुमान से कहीं ज़्यादा सरल है। Wikipedia के coordinates GeoHack template system से आते हैं और MediaWiki API के list=geosearch endpoint से query किए जा सकते हैं — जो खुद एक spatial index पर radius query है, और प्रोजेक्ट का “Nearby” फ़ीचर इसी को लपेटता है। अगर आपको बहुभाषी या non-article entities चाहिए, तो Wikidata की P625 (coordinate location) property English Wikipedia से कहीं ज़्यादा कवर करती है। Address lookup के लिए प्रोजेक्ट Photon इस्तेमाल करता है, एक Elasticsearch-आधारित geocoder जो OpenStreetMap के Nominatim data पर बना है — खुद होस्ट करने के लिए मुफ़्त, और एक सार्वजनिक demo endpoint है जिसे उदार लोग चलाते हैं और जिस पर production में ज़ोर से हथौड़ा नहीं चलाना चाहिए।
एक design फ़ैसला उधार लेने लायक है: साइट आपकी location browser में रखती है और उसे कभी shareable URLs में नहीं डालती। यही सही default है, और यह उस सीख से मेल खाता है जो फ़िटनेस ऐप्स location data और OPSEC के बारे में हमें क्या सिखाते हैं में है — उपयोगकर्ता के coordinates आपके app में रखी सबसे संवेदनशील strings में से हैं, और उन्हें सुरक्षित रखने का सबसे सस्ता तरीका है कि उन्हें कभी अपने server तक भेजा ही न जाए। Geocoding client-side करें या ऐसे third-party geocoder से करें जिससे browser सीधे बात करता है, और अगर कुछ log करना ज़रूरी हो तो सिर्फ़ rounded coordinates रखें, फिर आपकी privacy नीति अपने आप लिख जाती है।
“पास के N, radius चाहे जो हो” वाले fallback के लिए expanding-radius retry loops लिखने की इच्छा दबाएँ। PostGIS का KNN operator यह एक indexed query में कर देता है:
-- The closest 25 articles, whatever the distance — one query, index-ordered
SELECT title, geog <-> ST_MakePoint(:lon, :lat)::geography AS dist_m
FROM places
ORDER BY dist_m
LIMIT 25;
यह अकेली line उस “3km आज़माओ, फिर 6km, फिर 10km” वाली retry सीढ़ी की जगह ले लेती है जो मैं इतने सारे codebases में देखता हूँ, और यह सीढ़ी के एक चरण से भी तेज़ है।
सिफ़ारिश
अगर इस तुलना से एक ही बात लेनी हो, तो यह लीजिए: PostGIS और GiST index से शुरू करें, और geohash तभी अपनाएँ जब आपका storage layer मजबूर करे।
तर्क सीधा है। Spatial index median latency में जीतता है, घनी जगहों पर p95 में और भी ज़्यादा जीतता है, correctness में जीतता है (meter-सटीक spheroid distances, cell-edge वाले bugs नहीं), features में जीतता है (polygons, KNN, isochrone containment सब एक-पंक्ति के काम बन जाते हैं), और उस code में जीतता है जिसे आपको लिखना और संभालना नहीं पड़ता। Geohash तरीके में आपको neighbor-cell computation, precision selection और दो-चरणीय filter सही तरह लागू करने पड़ते हैं — यानी तीन ऐसी जगहें जहाँ सूक्ष्म गलती हो सकती है — और फिर भी प्रदर्शन उससे खराब ही रहता है।
Geohash अपनी जगह तीन ही स्थितियों में कमाता है: आपके datastore में spatial support नहीं है (DynamoDB, सादा Redis, CDN पर एक static JSON file), आपको nodes में location-based sharding चाहिए, या आप query को client पर धकेल रहे हैं और शून्य dependencies चाहते हैं। इन स्थितियों में geohash की neighbor गणित हाथ से लिखने के बजाय किसी परखे हुए library पर भरोसा करें — Node में ngeohash, python-geohash, या polygons कवर करने हों तो S2 geometry।
और product के पक्ष में: पहले circle ship करें, उसे ईमानदारी से label करें (“3km के अंदर” कहें, “आधे घंटे की पैदल दूरी” नहीं), radius configurable रखें क्योंकि ग्रामीण users और शहरी users अलग घनत्व की दुनियाओं में रहते हैं, और isochrone तभी अपनाएँ जब सीधी-हवाई झूठ की कीमत आपको मापने लायक चुकानी शुरू करे। स्थानीय Wikipedia प्रोजेक्ट यह याद दिलाने वाला एक सुंदर उदाहरण है कि सबसे अच्छे फ़ीचर अक्सर एक अच्छी spatial query ही होते हैं जो एक दोस्ताना विचार पहने हो। दस लाख लेख, एक index, एक सोच-समझकर चुना गया radius — और अचानक दुनिया का सबसे बड़ा encyclopedia ऐसा लगने लगता है जैसे आपकी गली के बारे में लिखा गया हो।