에이전트 라이다 고고학: 5가지 통념을 검증하다
AI 에이전트가 라이다 데이터에서 마야 유적을 찾아냈다. 에이전틱 라이다 고고학의 통념 5가지를 직접 검증해 봤다.
 Sarah Chen

에이전트 48개가 밤새 정글 라이다 데이터 1,200제곱킬로미터를 훑었고, 멕시코 공식 고고학 등록부에 없는 마야 시민 센터 하나를 찾아냈다. 그다음이 불편한 부분이다. 연구자들이 2025년 논문에서 바로 그 유적을 이미 지도로 만들어 놓았던 것이고, 에이전트와 그 뒤의 사람이 문헌 조사에서 이를 놓쳤다. 이 이야기 하나에 에이전틱 라이다 고고학의 핵심이 다 담겨 있다. 발견 파이프라인은 실제로 동작하지만, 제대로 설계하지 않으면 검증 루프는 제대로 동작하지 않는다.
저는 몇 년간 ML 파이프라인을 만들어 왔습니다. 거기서 거짓 양성의 비용은 잘못 보고된 고고학 유적이 아니라, 호출받은 엔지니어였습니다. 그래서 이런 에이전트 기반 발견 파이프라인에 대해 계속 보이는 다섯 가지 믿음을 골라, 실제로 일어난 일과 하나씩 대조해 보겠습니다.
통념 1: 유적을 찾으려면 커스텀 학습 모델이 필요하다
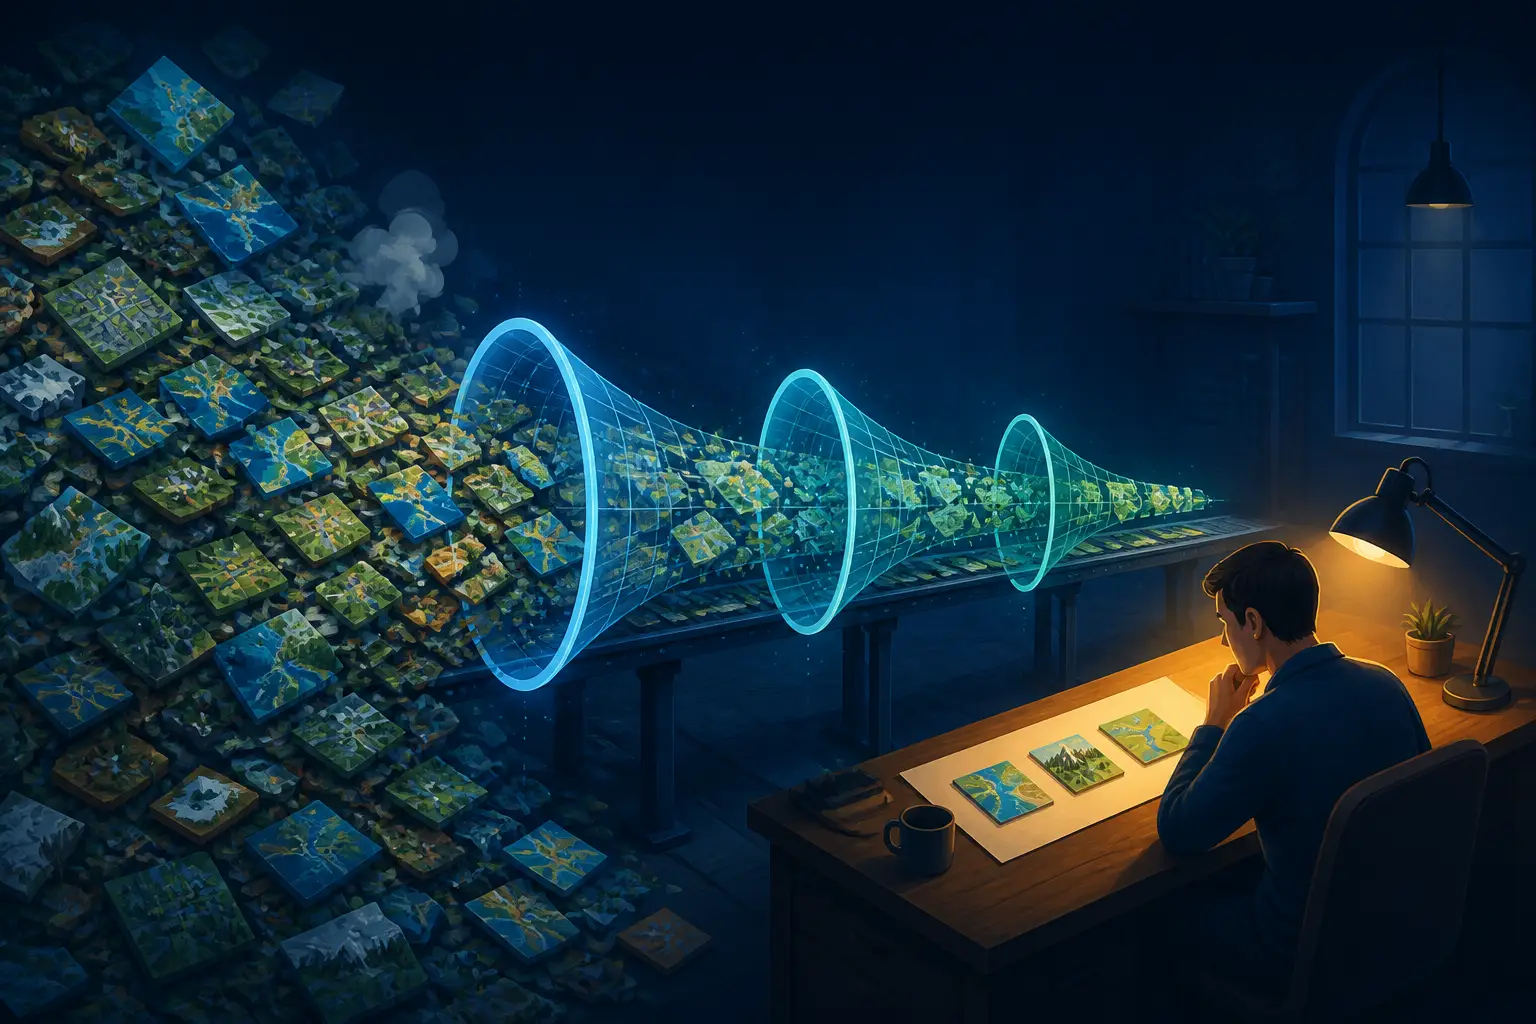
이야기 전체에서 가장 놀라운 부분은 특별한 모델이 전혀 쓰이지 않았다는 점이다. 라벨링된 피라미드 타일로 학습한 CNN도, 파인튜닝한 탐지기도 없었다. 파이프라인은 라이다 스트립을 힐셰이드 스타일 이미지로 변환했고, 범용 비전-언어 에이전트가 이를 하나씩 살펴보게 했다. 피라미드, 플랫폼, 광장이 언덕, 싱크홀, 도로와 어떻게 다르게 보이는지 적어 둔 가이드를 따라서다.
이 방식이 통하는 이유는, 최신 비전 모델이 방대한 시각적 사전 지식을 사실상 흡수해 두었기 때문이다. 정글 수관 아래 직선 모서리를 가진 평평한 광장은 이상 탐지 문제이고, 깨끗하게 렌더링된 입력을 주면 최신 VLM도 꽤 괜찮은 이상 탐지기가 된다. 핵심은 모델이 아니라 렌더링이다. 라이다 포인트 클라우드는 비전 모델이 직접 읽기에는 쓸모가 없다. 디지털 지형 모델, 여러 태양 각도의 힐셰이드, 경사 지도처럼 읽을 수 있는 형태로 바꿔야 한다. 시각화만 제대로 하면 범용 모델도 놀랍도록 유능한 측량사가 된다.
그렇다고 이 방식을 무조건 옹호하지는 않겠다. 대량 운영 환경에서는 비용과 일관성 면에서 전문 분류기가 여전히 낫다. 이 트레이드오프는 전에 이미지 분류에서 전문 CNN 대 프런티어 LLM을 다룰 때 이미 정리한 바 있다. 1,000개가 넘는 이미지 타일에 에이전트 세션 48개를 돌리는 것은 비싸고 결과도 비결정적이다. 하지만 서비스를 운영하는 게 아니라 가설을 만들어 내는 탐색 단계라면 어떨까? 범용 모델에 좋은 프롬프트를 쓰는 접근이 실용적으로 옳고, 라벨링된 학습 데이터도 필요 없다. 틈새 고고학 과제에서는 애초에 그런 데이터가 거의 존재하지 않으니까.
판정: 틀림, 단서 조건부다. 후보를 만들어 내는 데 커스텀 모델은 필요 없다. 다만 이것이 반복적이고 규모 있는 작업이 된다면 아마 필요할 것이다.
통념 2: 발견은 에이전트가 했다
타임라인을 자세히 보면 에이전트가 실제로 한 일이 보인다. 바로 걸러내기다. 발견 자체는 몇 년 전 항공 라이다 조사팀, 환경 라이다를 고고학에 재활용하는 연구를 발표한 연구자들, 특히 이 언덕 꼭대기를 이미 지도로 그린 2025년 서베이 논문의 저자들이 먼저 했다. 에이전트가 한 일은 1,200제곱킬로미터의 정글이라는 탐색 공간을, 사람이 커피를 마시며 검토할 수 있는 몇 개의 후보 타일로 줄인 것이다.
이건 흠잡을 일이 아니다. 이 규모에서 걸러내기는 데이터가 풍부한 대부분의 과학 분야에서 실제 병목이다. 전파천문학, 입자물리학, 유전체학 모두 패턴이 같다. 센서가 사람이 볼 수 있는 양보다 훨씬 많은 데이터를 쏟아내니, 발견 속도를 제한하는 것은 데이터 가용성이 아니라 분류 처리량이다. 이것이 바로 AI 벤치마크가 실제 업무의 대부분을 놓치는 이유와 같은 역학이다. 가치 있는 과제는 애초에 "똑똑해야 한다"가 아니라, "지루한 것 백만 개를 보고 흥미로운 다섯 개를 골라내는 것"이었다.
판정: 대부분 틀림. 에이전트는 주의력의 증폭기이지 발견의 원천이 아니다. 에이전트를 발견자로 보는 순간 그들의 부정적 결과, 즉 "문헌 검색에서 아무것도 못 찾았다"를 믿기 시작하게 되는데, 이 이야기의 실패 모드가 바로 거기에 있다.
통념 3: 비전 에이전트가 찾은 직선 모서리는 정답이다
파이프라인에서 기술적으로 가장 탄탄하다고 본 부분이다. 비전 에이전트가 언덕을 표시한 뒤에도 워크플로는 렌더링 이미지에서 멈추지 않았다. 원시 포인트 클라우드로 돌아가, 지면으로 분류된 반환점(수관 반환점과 구분되는)이 실제로 광장, 피라미드, 안뜰의 윤곽을 따르는지 10~17미터 높이의 숲 아래에서 확인했다. 이는 어떤 지리공간 ML 파이프라인에서든 가장 중요한 습관이다. 렌더링은 거짓말을 하지만, 포인트는 거짓말을 하지 않는다.
왜 이렇게 의심하느냐고? 라이다 처리에서 지면 분류 자체가 하나의 모델이고, 조밀한 열대 수관 아래에서는 실제 반환점이 거의 없는 곳에 매끄러운 표면을 보간해 버릴 수 있다. 즉 "광장"이 지면 탐색 알고리즘이 평평함을 환각으로 만들어 낸 산물일 수 있다. 식생 구조가 힐셰이드에 전파되는 기묘하게 직선인 수관 틈을 만들기도 한다. 국가 규모 지오데이터 파이프라인을 다뤄 본 사람이라면, 신호보다 더 의미 있어 보이는 처리 아티팩트에 한 번쯤 데어 봤을 것이다.
내가 필수로 요구할 검증 체크리스트는 이렇다. 이 이야기도 대체로 이를 따랐다.
- 렌더링된 DTM에서만 확인하지 말고, 원시 포인트 클라우드를 최소 두 개 축으로 잘라 특징을 확인한다.
- 여러 힐셰이드 방위각으로 렌더링한다. 스캔 라인 방향에서 비롯된 아티팩트는 사라지거나 움직이지만, 실제 구조물은 그대로다.
- 다른 데이터 소스(다른 조사, 다른 연도)가 있다면 교차 검증한다.
- 알려진 거짓 양성 유발 요인을 걸러낸다. 싱크홀(마야 지역은 카르스트라서 많다), 현대의 도로, 벌목 흔적, 지질 계단지형 등이다.
- 이상 징후를 수치화한다. 모서리의 직선성, 각도, 플랫폼 면적 대 주변 배경을 잰다. "직사각형처럼 보인다"는 느낌일 뿐이고, 측정된 종횡비가 있어야 주장이 된다.
파이프라인은 이 검증들 대부분을 통과했다. 물리적 주장도 입증되었다. 이 유적은 실제로 존재하고, 고고학자들도 고전기 시민 센터라는 데 동의한다. 실패는 전혀 다른 축에서 일어났다.
통념 4: 문헌 확인은 에이전트에게 맡길 수 있는 일이다
이 이야기가 스스로를 공개적으로 깨뜨린 통념이다. 에이전트는 문헌과 공식 INAH 등록부를 검색했고, 아무것도 찾지 못했다며 이 유적을 미등록으로 보고했다. 기술적으로는 맞다. INAH 등록부에는 없었으니까. 그러나 같은 해에 발표된 동료 심사 논문이 이 유적을 이미 지도로 만들어 놓았고, 에이전트의 문헌 검색은 그냥 지나쳐 버렸다. "재발견"이라는 표현은 도메인 전문가가 인용 문헌을 짚어 준 뒤에야 제목에 등장했다.
선행 기술 조사나 신규성 확인을 하는 에이전트를 만들어 본 사람이라면, 이 대목에서 뜨끔할 것이다. 문헌 검색은 구조적인 이유로 위임하기 가장 어려운 작업이다.
- 범위가 보이지 않는다. 에이전트는 자기가 접근하지 못한 것을 알려주지 못한다. 유료 저널, 대학 저장소 뒤의 PDF, 유적이 14쪽 표의 좌표 한 줄로만 나오는 논문 같은 것들이다. 바로 이 유적이 그런 곳에 있었다.
- 부정적 결과는 반증할 수 없다. "아무것도 못 찾았다"는 실제로 아무것도 없을 때나, 검색이 얕았을 때나 똑같아 보인다. 오류 신호가 없다.
- 최신 논문은 모든 인덱스에서 늦다. 2025년 논문은 색인이 잘 안 되어 있거나, 검색 도구에 잡히지 않거나, 학회 발표나 프리프린트 서버에서만 알려졌을 수 있다.
- 공간 매칭은 그 자체로 별개의 문제다. 논문이 좌표를 항상 공개하지는 않는다. 유적은 이름이 여러 개이고, 그림 캡션에는 "X 근처 언덕"이라고만 쓰여 있으며, 지도는 저해상도 래스터일 수 있다. 후보를 이와 맞추려면 지리에 대한 실제 추론이 필요하다.
프로덕션 ML 경험에서 나온 원칙은 이렇다. 에이전트는 후보 주장을 만들 수 있지만, 신규성 주장, 즉 "아무도 보고한 적 없다"는 가능한 한 깊게 검색한 뒤 사람이 직접 검증해야 하는 유일한 산출물이다. 지리 공간 쪽에도 좌표계와 경계 체계에 관한 비슷한 함정이 있다. 공간 인덱싱의 트레이드오프를 다뤄 본 사람이라면, "이 점이 이 데이터셋에 있는가"라는 질문이 말처럼 단순하지 않다는 것을 알 것이다.
판정: 틀림, 심각하게. 이 이야기에서 물리적 검증은 잘 위임되었다. 신규성 검증은 끔찍하게 위임되었다. 파이프라인을 그에 맞게 설계하라. 검색은 자동화하되, "선행 연구 없음"은 결론이 아니라 초안으로만 취급해야 한다.
통념 5: 검증 루프는 한 단계짜리다
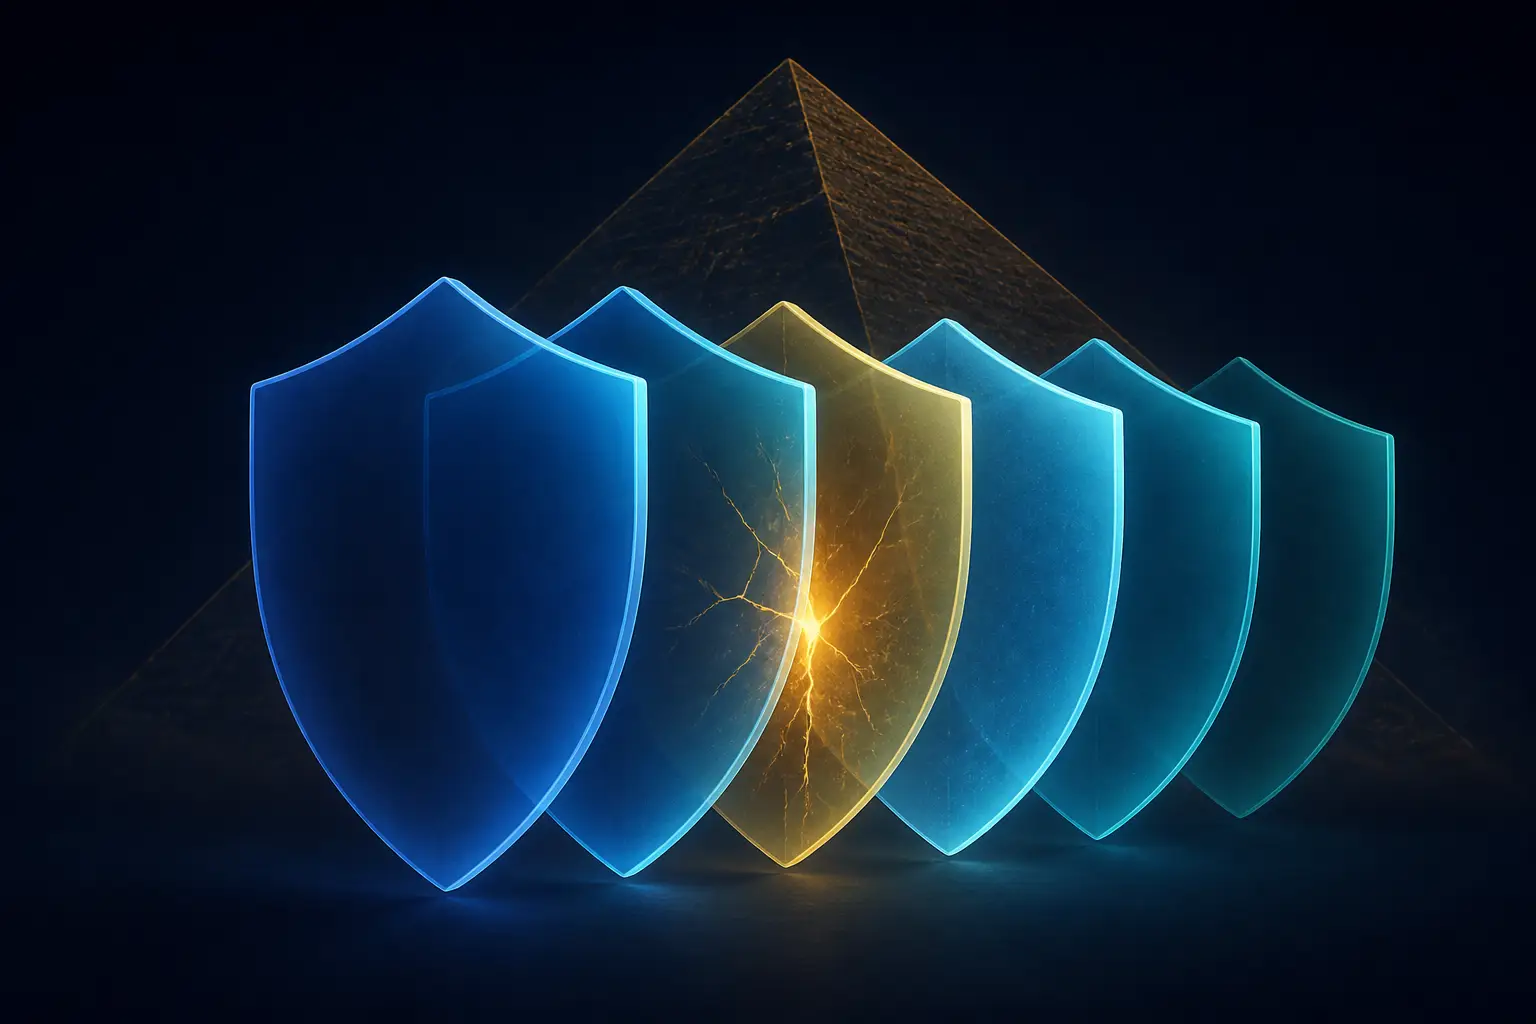
72시간의 전체 흐름은 여러 층으로 된 검증 설계로 읽는 것이 가장 유용하다. 어떤 층은 버텼고 한 층은 무너졌다. 층에 이름을 붙여 볼 가치가 있다. 어떤 에이전틱 주장 생성 시스템에든 똑같이 만들게 되는 층들이기 때문이다.
- 1층 — 센서 수준 확인. 원시 데이터가 렌더링된 특징을 뒷받침하는가? (포인트 클라우드 단면. 통과.)
- 2층 — 독립 에이전트 검토. 서로 다른 에이전트와 프롬프트가 후보를 다시 살펴보고, 의견이 갈리면 사람에게 넘긴다. (대체로 통과. 적대적 프롬프팅의 공개된 증거는 없었는데, 나라면 이를 추가하겠다.)
- 3층 — 외부 권위 확인. 공식 등록부 INAH에 조회했고, 등록된 것이 없다고 확인되었다. (통과했지만, 등록부에 없다는 사실만 증명했을 뿐 신규성을 증명하지는 못했다.)
- 4층 — 선행 연구 검색. (실패. 2025년 서베이 논문을 놓쳤다.)
- 5층 — 도메인 전문가. 결국 발표 후 커뮤니티와 원저자들이 제공했다. (오류를 잡아낸 층이다.)
교훈은 "에이전트를 믿지 마라"가 아니다. 각 층은 서로 다른 주장을 검증하며, 다섯 중 셋을 통과했다는 사실은 나머지 둘에 대해 아무 말도 해 주지 않는다는 것이다. 여기서는 3층의 통과가 오히려 오해를 낳았다. "등록부에 없다"가 사람의 머릿속에서 "과학계에 알려지지 않았다"로 격상되어 버렸기 때문이다. 이는 서로 다른 범위를 가진 두 데이터셋 사이의 조인 오류이고, ZIP 코드 경계가 우리가 생각하는 의미일 거라고 가정하는 버그와 같은 종류다. 이런 문제는 ZCTA와 USPS 경계 불일치에서 자세히 파헤친 바 있다. 권위 있어 보이는 두 출처가 말없이 어긋났고, 그 결과 자신만만하게 틀린 결론이 나왔다.
검증 스택의 모든 층은 서로 다른 주장을 확인한다. 세 개의 층을 통과했다고 해서 네 번째 층에 대해서는 아무것도 알 수 없다.
이 파이프라인을 강화한다면 값싼 장치 두 가지를 추가하겠다. 첫째, 적대적 문헌 검토다. 신규성을 반증하는 것만이 유일한 임무인 별도 에이전트에게, 더 공격적인 검색 도구를 주고 선행 연구가 존재한다고 가정하라고 지시한다. 둘째, 발표 전 전문가 확인이다. 무엇이든 발표하기 전에 후보 목록을 실제 도메인 전문가 한 명에게 보낸다. 이번 커뮤니티 반응을 보면 전문가들은 빠르게 참여할 의향이 있고, 글이 올라가고 몇 시간 안에 정정이 도착했다.
재발견이 실제로 증명한 것
그래도 결과는 옹호하겠다. 회의론자들이 실패 분석을 잘못했다고 보기 때문이다. 노트북과 약간의 연산 자원을 가진 외부인이, 공개 데이터를 써서 며칠 밤의 에이전트 작업만으로 전문 조사가 발표한 바로 그 유적에 독립적으로 도달했다. 분류 파이프라인이 이미 알려진 유적을 재발견한다면, 그것은 부끄러운 일이 아니라 보정 신호다. 탐지기에 실제 감도가 있다는 뜻이니까. 오히려 아무도 확인할 수 없는 것만 찾아낸다면 그때 걱정해야 한다.
모험담을 걷어내고 남은, 재현 가능한 방법이다.
- 공개 센서 데이터가 사람의 주의력을 압도적으로 넘어서는 분야를 고른다. 라이다가 대표적인 사례이고, NASA 지구과학 아카이브도 또 다른 예다.
- 원시 데이터를 고품질 시각 렌더링으로 바꾼다. 이 단계가 모델 선택보다 중요하다.
- 정밀한 서면 루브릭, 즉 양성 사례와 알려진 거짓 양성 목록을 주고 저렴한 비전 에이전트를 여럿 병렬로 돌린다.
- 살아남은 후보는 렌더링이 아니라 원시 데이터에 대해 검증한다.
- 신규성은 별도의 사람 주도 검증 트랙으로 다루고, 발표 전에 도메인 전문가를 거치게 한다.
고고학계가 제기한 한 가지 더 생각해 볼 점이 있다. 발견은 더 이상 병목이 아니고, 보존과 관리가 병목이라는 것이다. 발굴하거나 보호할 수 있는 속도보다 빠르게 발견된 유적은 도굴의 표적이 된다. 좌표도 민감한 정보다(보고서 저자가 좌표를 기밀 부록에 넣은 것은 옳았다). 민감한 분야에서 발견 파이프라인을 만든다면, 공개 정책부터 먼저 만들어야 한다. 검증은 옳기만 해서는 충분하지 않고, 책임감 있게 옳아야 한다.
솔직한 요약이다. 공개 지리공간 데이터 위의 에이전틱 파이프라인은 실제로 검증 가능한 주장을 만들어 낼 수 있고, 비전 모델을 측량사로 쓰는 트릭은 대부분의 실무자가 예상했던 것보다 잘 작동한다. 하지만 살아남는 주장은, 조용히 실패하는 층을 위해 설계된 검증 루프를 가진 주장이다. 이 이야기에서 라이다 검사는 제대로 노래했고, 문헌 검사는 속삭이고 있었다. 그 속삭임에 맞춰 설계하라.


