Arqueologia Lidar Agêntica: 5 Mitos, Testados
Um pipeline de agentes de IA identificou um sítio maia em dados lidar. Testamos 5 mitos da arqueologia lidar agêntica e o ciclo de verificação.
 Sarah Chen

Quarenta e oito agentes de IA varreram 1.200 km² de selva em dados lidar durante a noite e sinalizaram um centro cívico maia que não constava no registro arqueológico oficial do México. Aí veio a parte constrangedora: descobriu-se que arqueólogos já tinham mapeado exatamente esse sítio num artigo de 2025, e os agentes — e o humano que os supervisionava — tinham deixado passar na busca bibliográfica. Essa história, em miniatura, resume tudo o que você precisa saber sobre arqueologia lidar agêntica: o pipeline de descoberta funciona de verdade, e o ciclo de verificação não funciona, a não ser que você o construa direito.
Passei anos construindo pipelines de ML em que o custo de um falso positivo era um engenheiro acordado às três da manhã, não um sítio arqueológico reportado de forma errada. Então deixa eu pegar as cinco crenças que vejo o tempo todo sobre esse tipo de pipeline de descoberta agêntica e testar cada uma delas contra o que realmente aconteceu.
Mito 1: Você Precisa de um Modelo Treinado sob Medida para Encontrar Ruínas
O detalhe mais surpreendente de toda a história: nenhum modelo especial estava envolvido. Nada de CNN treinada com recortes rotulados de pirâmides, nem detector ajustado. O pipeline converteu faixas de lidar em imagens estilo hillshade e fez agentes generalistas de visão-linguagem analisarem uma por uma, seguindo um guia escrito que descrevia como são pirâmides, plataformas e praças, em contraste com colinas, dolinas e estradas.
Isso funciona porque os modelos de visão de ponta absorveram, na prática, uma enorme quantidade de conhecimento visual prévio. Uma praça nivelada com bordas retas sob o dossel da selva é um problema de detecção de anomalias, e os VLMs modernos são detectores de anomalias razoáveis quando você lhes dá entradas limpas e renderizadas. O truque não é o modelo, é a renderização. Nuvens de pontos do lidar são inúteis para um modelo de visão diretamente; você precisa convertê-las em algo legível: modelos digitais de terreno, hillshades com vários ângulos de sol, mapas de declividade. Acerte a visualização e um modelo generalista vira um topógrafo surpreendentemente competente.
Dito isso, esta é uma fronteira que defendo com ressalvas. Para trabalho de alto volume em produção, um classificador especializado ainda ganha em custo e consistência — já tratamos desse dilema em CNNs especializadas vs. LLMs de fronteira para classificação de imagens. Rodar 48 sessões de agentes sobre mais de mil recortes de imagem é caro e não determinístico. Mas para exploração, em que você está gerando hipóteses e não operando um serviço? A abordagem generalista com um bom prompt é pragmaticamente correta, e não custa nada em dados de treino rotulados — que, para tarefas de arqueologia de nicho, praticamente não existem mesmo.
Veredito: refutado, com um asterisco. Você não precisa de um modelo sob medida para gerar candidatos. Provavelmente vai querer um se isso virar uma operação repetida e em escala.
Mito 2: Os Agentes Fizeram a Descoberta
Leia a linha do tempo com atenção e você verá o que os agentes realmente fizeram: filtraram. A descoberta em si foi feita anos antes pelas equipes de lidar aerotransportado, pelos pesquisadores que publicaram sobre o reaproveitamento de lidar ambiental para arqueologia e, especificamente, pelos autores do levantamento de 2025 que já tinham mapeado exatamente esse topo de colina. Os agentes comprimiram o espaço de busca de 1.200 km² de selva para um punhado de recortes candidatos que um humano poderia inspecionar tomando um café.
Não é uma crítica: filtrar nessa escala é, na verdade, o gargalo da maioria das ciências orientadas a dados. Radioastronomia, física de partículas, genômica: o padrão é sempre o mesmo. Os sensores produzem muito mais dados do que humanos conseguem olhar, então a taxa de descoberta é limitada pela velocidade de triagem, não pela disponibilidade de dados. É exatamente essa dinâmica por trás de por que os benchmarks de IA deixam de fora a maior parte do trabalho real — a tarefa valiosa nunca foi "ser inteligente", foi "olhar para um milhão de coisas chatas e destacar as cinco interessantes".
Veredito: em grande parte refutado. Agentes são multiplicadores de atenção, não fontes de descoberta. No momento em que você os enquadra como descobridores, começa a confiar nos resultados negativos deles — "a busca bibliográfica não encontrou nada" — e é aí que mora o modo de falha desta história.
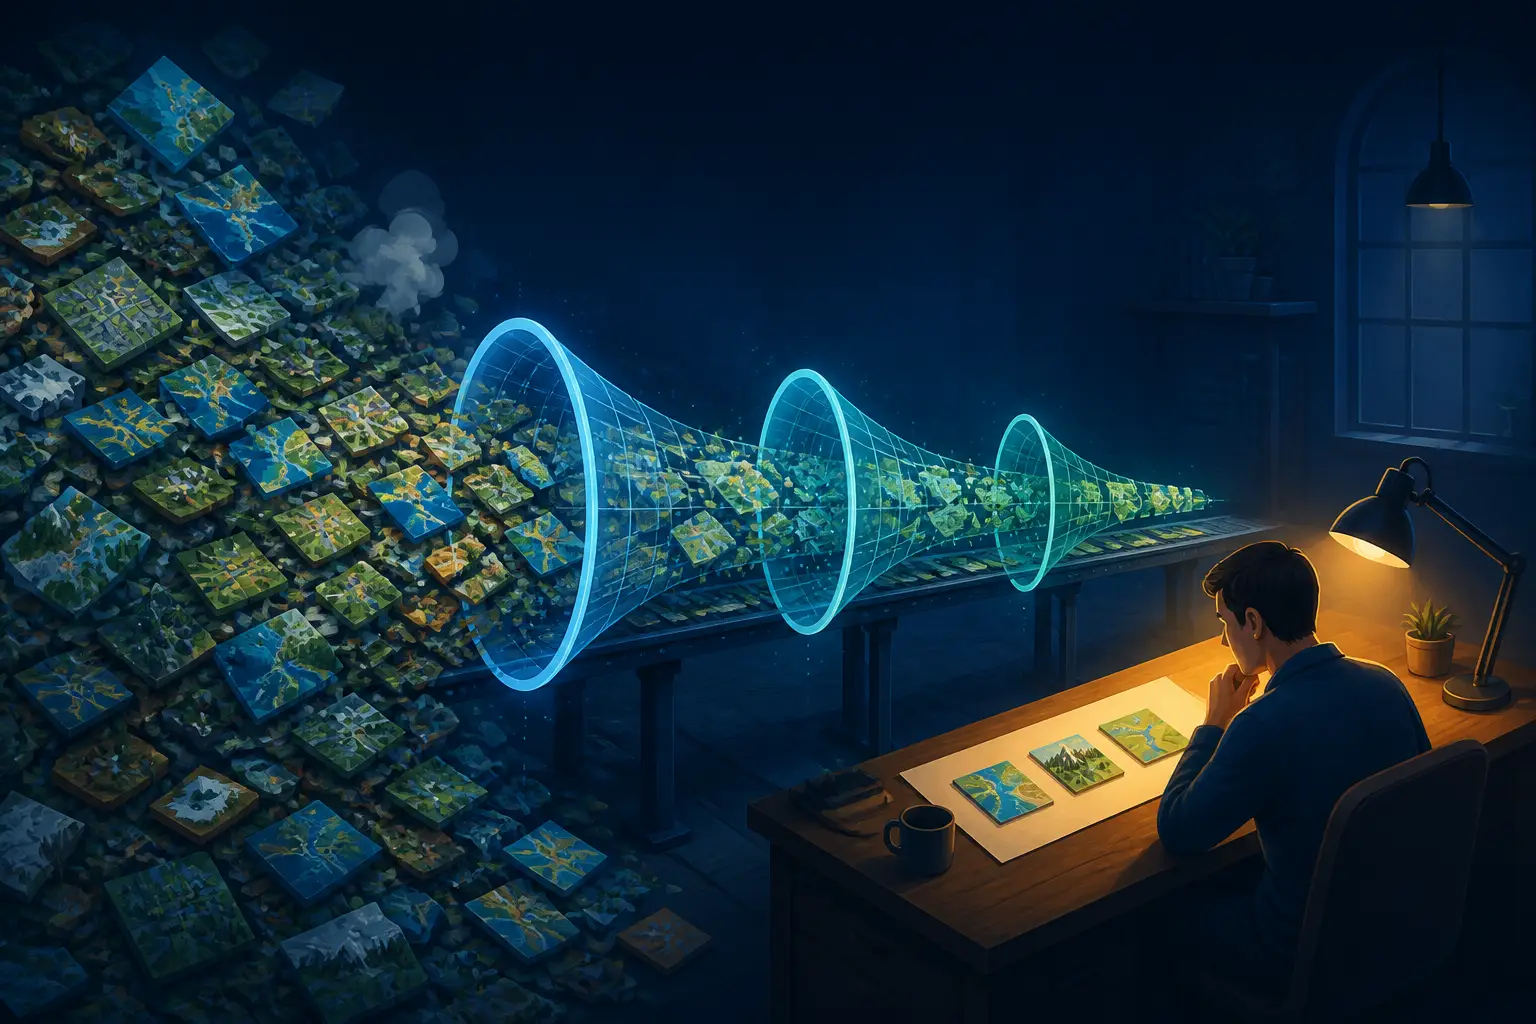
Mito 3: As Bordas Retas de um Agente de Visão São Verdade de Campo
Esta é a parte do pipeline que achei mais tecnicamente sólida. Depois que um agente de visão sinalizou o topo da colina, o fluxo não parou na imagem renderizada. Ele voltou à nuvem de pontos bruta e verificou se os retornos classificados como solo (e não como dossel) realmente traçavam a praça, a pirâmide e o pátio — sob 10 a 17 metros de floresta. Este é o hábito mais importante em qualquer pipeline de ML geoespacial: as renderizações mentem, os pontos não.
Por que a paranoia? A classificação de solo no processamento de lidar é, ela mesma, um modelo, e sob dossel tropical denso pode interpolar superfícies suaves onde quase não há retornos reais. Uma "praça" pode ser um artefato do algoritmo de busca do solo alucinando planura. A estrutura da vegetação também pode produzir falhas no dossel estranhamente lineares que se propagam para os hillshades. Quem já trabalhou com pipelines de dados geográficos em escala nacional já foi queimado por artefatos de processamento que parecem mais significativos que o sinal.
Então, a checklist de verificação que eu exigiria, e que esta história em grande parte seguiu:
- Confirme a feição na nuvem de pontos bruta, fatiada em pelo menos dois eixos — não apenas em um DTM renderizado.
- Renderize com vários azimutes de hillshade; artefatos da direção das linhas de varredura desaparecem ou se deslocam, estruturas reais não.
- Cruze com uma segunda fonte de dados, se existir (outro levantamento, outro ano).
- Filtre geradores conhecidos de falsos positivos: dolinas (a região maia é cárstica, cheia delas), estradas modernas, cicatrizes de desmatamento e terraços geológicos.
- Quantifique a anomalia: retidão das bordas, ângulos dos cantos, área da plataforma versus o fundo regional. "Parece retangular" é uma impressão; uma proporção medida é uma afirmação.
O pipeline passou na maioria desses testes. E, notavelmente, a afirmação física se sustentou — o sítio é real, e os arqueólogos concordam que se trata de um centro cívico do período Clássico. A falha aconteceu em um eixo completamente diferente.
Mito 4: Checar a Literatura É uma Tarefa que Você Pode Delegar
Este é o mito que a história desmontou em público, sobre si mesma. Os agentes pesquisaram a literatura e o registro oficial do INAH, não encontraram nada e reportaram o sítio como não registrado. Tecnicamente verdade — ele não estava no registro do INAH. Mas um artigo revisado por pares publicado naquele mesmo ano tinha mapeado o sítio, e a busca bibliográfica agêntica passou direto por ele. "Redescoberta" só entrou na manchete depois que um especialista da área apontou a citação.
Se você já construiu agentes que fazem qualquer tipo de checagem de prior art ou de novidade, isso deve causar um incômodo de reconhecimento. A busca bibliográfica é a coisa mais difícil de delegar, por razões estruturais:
- A cobertura é invisível. Um agente não consegue dizer o que não conseguiu acessar — periódicos com paywall, PDFs atrás de repositórios universitários, artigos em que o sítio aparece como uma coordenada numa tabela na página 14. Exatamente onde este sítio estava.
- Resultados negativos não são falsificáveis. "Não achei nada" parece idêntico seja porque nada existe, seja porque sua busca foi superficial. Não há sinal de erro.
- Publicações recentes ficam atrás de todos os índices. Um artigo de 2025 pode estar mal indexado, não ser captado pelas ferramentas de busca ou ser conhecido apenas por palestras em congressos e servidores de preprints.
- A correspondência espacial é um problema à parte. Artigos nem sempre publicam coordenadas; sítios têm vários nomes; a legenda de uma figura diz "colina perto de X" e o mapa é um raster de baixa resolução. Associar seu candidato a isso exige raciocínio real sobre geografia.
Minha regra vinda do trabalho de ML em produção: agentes podem gerar afirmações candidatas, mas a afirmação de novidade — "ninguém relatou isso" — é a única saída que você verifica manualmente, com a busca mais profunda que conseguir reunir, antes de sair do prédio. O lado geoespacial tem uma armadilha análoga com sistemas de coordenadas e limites; quem já lidou com compromissos de indexação espacial sabe que "este ponto está neste conjunto de dados" nunca é tão simples quanto parece.
Veredito: refutado, e com força. A verificação física foi bem delegada nesta história. A verificação de novidade foi delegada muito mal. Projete seu pipeline de acordo: automatize a busca, mas trate "nenhum trabalho anterior encontrado" como um rascunho, nunca como conclusão.
Mito 5: O Ciclo de Verificação É Uma Etapa Só
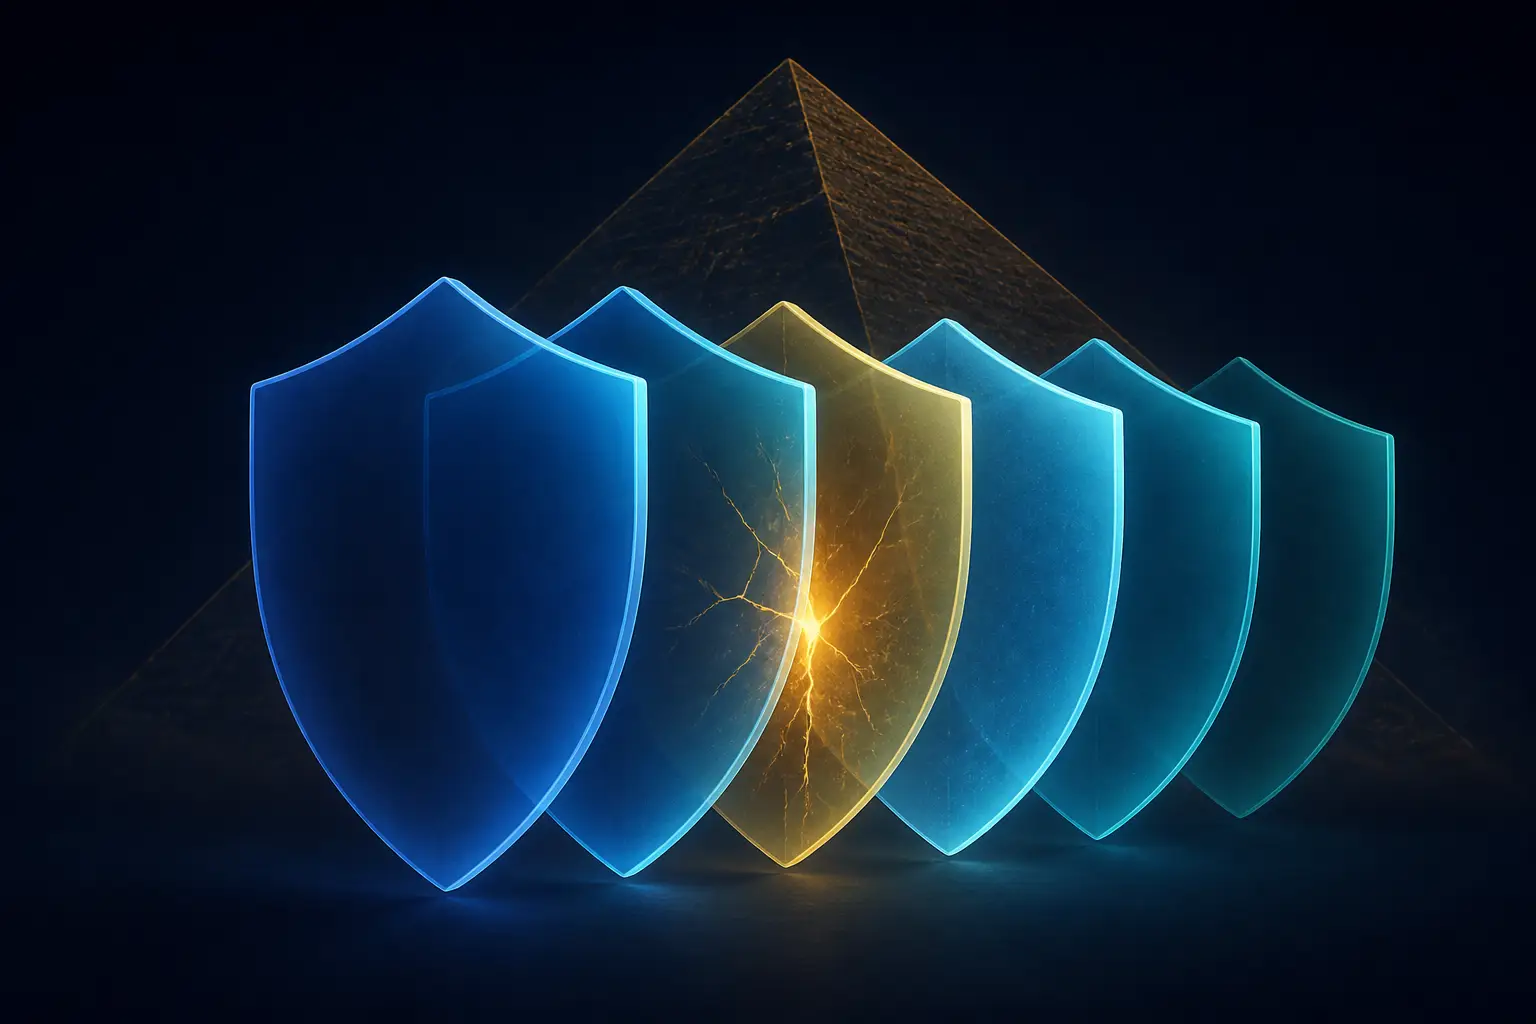
A forma útil de ler todo o arco de 72 horas é como um desenho de verificação em camadas, em que algumas camadas aguentaram e uma colapsou. Vale nomear as camadas, porque são as mesmas que você construiria para qualquer sistema agêntico de geração de afirmações:
- Camada 1 — Verificação do sensor. Os dados brutos sustentam a feição renderizada? (Fatias da nuvem de pontos. Passou.)
- Camada 2 — Revisão por agente independente. Agentes diferentes, prompts diferentes, reexaminam os candidatos; divergências vão para o humano. (Em grande parte passou; não há evidência publicada de prompts adversariais, o que eu acrescentaria.)
- Camada 3 — Autoridade externa. Consulta ao registro oficial — o INAH confirmou que nada estava registrado. (Passou, mas só provou a ausência no registro, não a novidade.)
- Camada 4 — Busca de prior art. (Falhou — deixou passar o levantamento de 2025.)
- Camada 5 — Especialista da área. Fornecida, no fim, pela comunidade e pelos autores originais, depois da publicação. (Foi a camada que pegou o erro.)
A lição não é "não confie nos agentes" — é que cada camada verifica uma afirmação diferente, e passar em três de cinco não diz nada sobre as outras duas. A Camada 3 ter passado foi ativamente enganosa aqui, porque "não está no registro" foi promovido a "não é conhecido pela ciência" na cabeça do humano. Isso é um erro de junção entre dois conjuntos de dados com cobertura diferente, e pertence à mesma classe de bug de achar que um limite de CEP significa o que você imagina — o tipo de coisa que investigamos em incompatibilidades entre limites ZCTA e USPS. Duas fontes com aparência de autoridade, discordância silenciosa, conclusão errada com confiança.
Cada camada de uma pilha de verificação checa uma afirmação diferente. Passar em três camadas não diz nada sobre a quarta.
Se eu estivesse reforçando este pipeline, adicionaria dois mecanismos baratos. Primeiro, uma passagem adversarial pela literatura: um agente separado cuja única função é refutar a novidade, com ferramentas de busca mais agressivas e instruções para presumir que trabalhos anteriores existem. Segundo, um contato com especialista antes da publicação — enviar a lista de candidatos a um especialista da área antes de anunciar qualquer coisa. A resposta da comunidade aqui mostra que os especialistas estão dispostos a se engajar rápido; a correção chegou em poucas horas depois que o post foi ao ar.
O Que a Redescoberta Realmente Prova
Vou, porém, defender o resultado, porque acho que os céticos erraram na análise da falha. Um outsider com um notebook e alguma capacidade de computação convergiu, de forma independente, para o mesmo sítio que um levantamento profissional publicou — usando dados públicos, em algumas noites de tempo de agente. Se o seu pipeline de triagem redescobre sítios conhecidos, isso é um sinal de calibração, não um vexame: significa que o detector tem sensibilidade real. Você deveria se preocupar muito mais se ele só encontrasse coisas que ninguém jamais conseguiria confirmar.
A receita replicável, sem a narrativa de aventura:
- Escolha um domínio em que dados de sensores públicos superem enormemente a atenção humana (o lidar é o caso canônico; os arquivos de ciências da Terra da NASA são outro).
- Converta os dados brutos em renderizações visuais de alta qualidade — esta etapa importa mais do que a escolha do modelo.
- Distribua agentes de visão baratos com uma rubrica escrita e precisa de positivos e falsos positivos conhecidos.
- Verifique os sobreviventes contra os dados brutos, não contra as renderizações.
- Trate a novidade como uma trilha de verificação separada, liderada por humanos, e encaminhe as afirmações a um especialista da área antes de anunciar.
Há mais uma coisa que a comunidade de arqueologia levantou e vale refletir: descoberta não é mais o gargalo — a curadoria é. Sítios encontrados mais rápido do que podem ser escavados ou protegidos viram alvos de saque, e coordenadas são informação sensível (o autor do relatório fez bem em colocá-las em um anexo confidencial). Se você constrói pipelines de descoberta sobre domínios sensíveis, construa primeiro a política de divulgação. Verificação não é só acertar; é acertar com responsabilidade.
O resumo honesto: pipelines agênticos sobre dados geoespaciais públicos podem, sim, gerar afirmações reais e verificáveis, e o truque do modelo de visão como topógrafo funciona melhor do que a maioria dos praticantes esperava. Mas a afirmação que sobrevive é aquela cujo ciclo de verificação foi projetado para a camada que falha silenciosamente. Nesta história, as checagens de lidar cantaram e a checagem bibliográfica sussurrou. Construa para o sussurro.


