Arkeologi Lidar Agentik: 5 Mitos yang Kami Uji
Pipeline agen AI menandai situs Maya dari data lidar semalam. Kami uji 5 mitos arkeologi lidar agentik dan cara kerja loop verifikasinya.
 Sarah Chen

Empat puluh delapan agen AI memindai 1.200 km² hutan lewat data lidar semalam dan menandai sebuah pusat sipil Maya yang tidak ada di register arkeologi resmi Meksiko. Lalu bagian yang bikin tidak nyaman muncul: ternyata para arkeolog sudah memetakan persis situs itu dalam makalah 2025, dan agen-agennya, beserta manusia di baliknya, melewatkannya saat pencarian literatur. Kisah mini ini merangkum semua yang perlu kamu tahu soal arkeologi lidar agentik: pipeline penemuannya memang jalan, dan loop verifikasinya memang tidak jalan, kecuali kamu membangunnya dengan benar.
Selama bertahun-tahun saya membangun pipeline ML di mana biaya false positive berarti engineer yang di-page, bukan situs arkeologi yang salah lapor. Jadi mari kita ambil lima keyakinan yang terus saya lihat soal pipeline penemuan agentik semacam ini, lalu uji masing-masing dengan apa yang benar-benar terjadi.
Mitos 1: Kamu Butuh Model yang Dilatih Khusus untuk Menemukan Reruntuhan
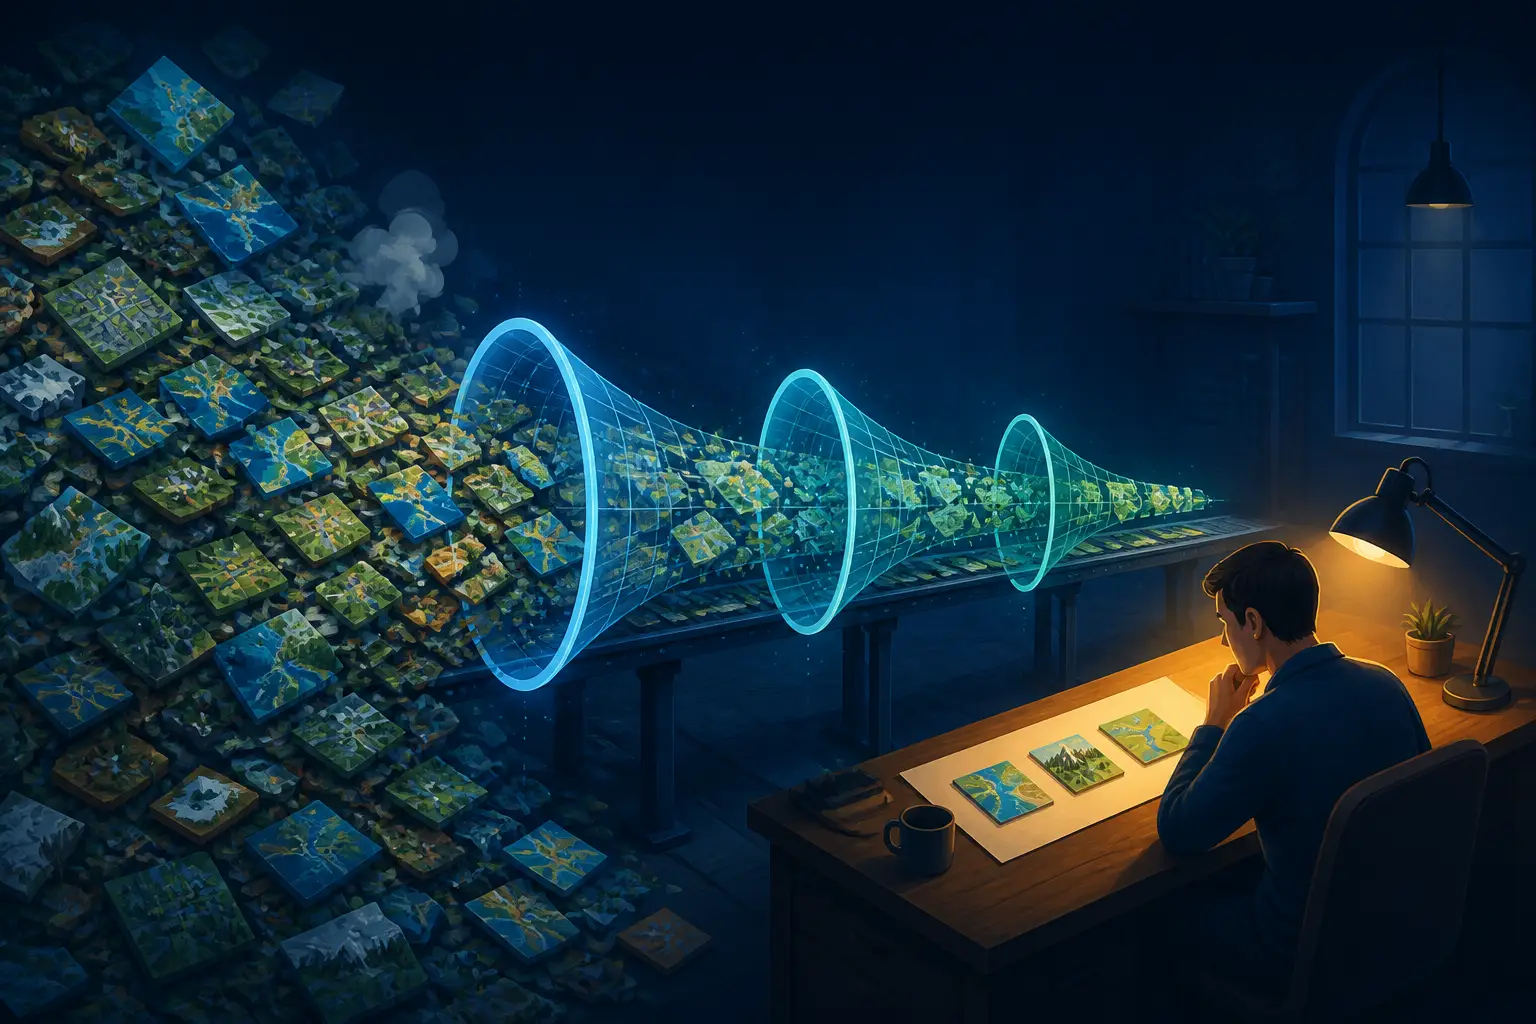
Detail paling mengejutkan dari seluruh cerita ini: tidak ada model khusus yang terlibat. Tidak ada CNN yang dilatih dengan ubin piramida berlabel, tidak ada detektor hasil fine-tuning. Pipeline mengubah strip lidar menjadi gambar bergaya hillshade, lalu agen vision-language serbaguna memeriksanya satu per satu, mengikuti panduan tertulis yang menjelaskan seperti apa piramida, platform, dan plaza dibandingkan bukit, lubang sinkhole, dan jalan.
Ini berhasil karena model vision frontier pada dasarnya sudah menyerap banyak sekali pengetahuan visual awal. Plaza yang rata dengan tepi lurus di bawah kanopi hutan adalah masalah deteksi anomali, dan VLM modern cukup jago jadi pendeteksi anomali kalau kamu memberi input hasil render yang bersih. Triknya bukan pada modelnya, melainkan pada rendering-nya. Point cloud lidar tidak berguna bagi model vision secara langsung; kamu harus mengubahnya jadi sesuatu yang bisa dibaca: digital terrain model, hillshade dengan beberapa sudut matahari, peta kemiringan. Kalau visualisasinya tepat, model generalis bisa jadi surveyor yang sangat kompeten.
Meski begitu, ini frontier yang akan saya bela dengan catatan. Untuk pekerjaan produksi volume tinggi, classifier spesialis tetap menang dari sisi biaya dan konsistensi. Kami sudah pernah membahas trade-off-nya di CNN spesialis vs LLM frontier untuk klasifikasi gambar. Menjalankan 48 sesi agen di atas lebih dari seribu ubin gambar itu mahal dan non-deterministik. Tapi untuk eksplorasi, saat kamu sedang membuat hipotesis dan bukan mengoperasikan layanan? Pendekatan generalis dengan prompt yang bagus itu secara pragmatis tepat, dan tidak butuh data latih berlabel sama sekali, yang untuk tugas arkeologi niche memang hampir tidak ada.
Vonis: terpatahkan, dengan catatan. Kamu tidak butuh model khusus untuk menghasilkan kandidat. Kamu mungkin memang membutuhkannya kalau ini berkembang jadi operasi berulang yang diskalakan.
Mitos 2: Agen yang Melakukan Penemuannya
Baca linimasanya dengan teliti dan kamu akan melihat apa yang sebenarnya dilakukan agen: mereka menyaring. Penemuannya sendiri dibuat bertahun-tahun sebelumnya oleh tim lidar udara, para peneliti yang mempublikasikan pemanfaatan lidar lingkungan untuk arkeologi, dan khususnya penulis makalah survei 2025 yang sudah memetakan bukit ini. Agen memampatkan ruang pencarian dari 1.200 km² hutan menjadi segelintir kandidat ubin yang bisa diperiksa manusia sambil minum kopi.
Ini bukan kritik. Menyaring pada skala seperti itu adalah bottleneck sesungguhnya di hampir semua sains yang kaya data. Radioastronomi, fisika partikel, genomika: polanya selalu sama. Sensor menghasilkan data jauh lebih banyak daripada yang bisa dilihat manusia, sehingga laju penemuan dibatasi oleh throughput triase, bukan ketersediaan data. Ini persis dinamika di balik kenapa benchmark AI melewatkan sebagian besar pekerjaan nyata: tugas yang berharga tidak pernah soal "pintar", melainkan "melihat sejuta hal membosankan dan memunculkan lima yang menarik".
Vonis: sebagian besar terpatahkan. Agen adalah pengganda tenaga untuk perhatian, bukan sumber penemuan. Begitu kamu membingkai mereka sebagai penemu, kamu mulai mempercayai hasil negatif mereka, seperti "pencarian literatur tidak menemukan apa-apa", dan di situlah letak mode kegagalan cerita ini.
Mitos 3: Garis Lurus dari Agen Vision Adalah Ground Truth
Bagian pipeline yang paling menurut saya kuat secara teknis adalah ini. Setelah agen vision menandai bukit tersebut, alur kerjanya tidak berhenti di gambar hasil render. Ia kembali ke point cloud mentah dan memeriksa apakah return yang diklasifikasikan sebagai tanah (bukan return kanopi) benar-benar membentuk plaza, piramida, dan halaman di bawah 10 sampai 17 meter hutan. Ini kebiasaan terpenting dalam pipeline ML geospasial mana pun: rendering bisa menipu, titik tidak.
Kenapa harus separanoid itu? Klasifikasi tanah dalam pemrosesan lidar itu sendiri adalah sebuah model, dan di bawah kanopi hutan tropis yang rapat, ia bisa menginterpolasi permukaan halus di tempat yang hampir tidak punya return nyata. "Plaza" bisa jadi artefak dari algoritma pencari tanah yang berhalusinasi soal kerataan. Struktur vegetasi juga bisa menghasilkan celah kanopi yang anehnya linear dan merambat ke hillshade. Siapa pun yang pernah bekerja dengan pipeline geodata skala negara pasti pernah terbakar oleh artefak pemrosesan yang tampak lebih bermakna daripada sinyalnya.
Jadi ini daftar periksa verifikasi yang akan saya tegaskan, dan yang sebagian besar diikuti cerita ini:
- Konfirmasi fitur di point cloud mentah, diiris setidaknya di dua sumbu, jangan hanya di DTM hasil render.
- Render dengan beberapa azimuth hillshade; artefak dari arah scan-line akan hilang atau bergeser, struktur nyata tidak.
- Silang-periksa dengan sumber data kedua jika ada (survei berbeda, tahun berbeda).
- Saring generator false positive yang sudah dikenal: sinkhole (wilayah Maya itu karst dan penuh sinkhole), jalan modern, bekas penebangan, dan teras geologis.
- Ukur anomalinya: kelurusan tepi, sudut-sudut, luas platform dibandingkan latar regional. "Kelihatannya persegi" itu cuma perasaan; rasio aspek yang terukur itu klaim.
Pipeline lulus sebagian besar pemeriksaan ini. Dan yang menarik, klaim fisiknya terbukti: situsnya nyata, dan para arkeolog sepakat ini adalah pusat sipil periode Klasik. Kegagalannya terjadi di sumbu yang sama sekali berbeda.
Mitos 4: Memeriksa Literatur Itu Tugas yang Bisa Didelegasikan
Ini mitos yang diruntuhkan cerita ini terhadap dirinya sendiri, di depan umum. Agen mencari literatur dan register INAH resmi, tidak menemukan apa-apa, lalu melaporkan situs itu sebagai tidak terdaftar. Secara teknis benar, karena situs itu memang tidak ada di register INAH. Tapi sebuah makalah peer-reviewed yang terbit di tahun yang sama sudah memetakan situs tersebut, dan pencarian literatur agentik itu melewatinya begitu saja. Kata "penemuan ulang" baru masuk ke judul setelah seorang pakar menunjuk sitasinya.
Kalau kamu pernah membangun agen yang melakukan pengecekan prior-art atau kebaruan, bagian ini pasti terasa familier dan bikin meringis. Pencarian literatur adalah hal paling sulit untuk didelegasikan, karena alasan struktural:
- Cakupan itu tak terlihat. Agen tidak bisa memberitahumu apa yang tidak bisa diaksesnya: jurnal berbayar, PDF di balik repositori universitas, makalah di mana situs muncul sebagai satu koordinat dalam tabel di halaman 14. Dan justru di situlah situs ini berada.
- Hasil negatif tidak bisa difalsifikasi. "Saya tidak menemukan apa-apa" terlihat sama saja, entah memang tidak ada atau pencariannya dangkal. Tidak ada sinyal error.
- Publikasi baru selalu tertinggal dari indeks. Makalah 2025 mungkin kurang terindeks, belum terjangkau alat pencarian, atau baru dikenal lewat presentasi konferensi dan server preprint.
- Pencocokan spasial adalah masalah tersendiri. Makalah tidak selalu mempublikasikan koordinat; situs punya banyak nama; caption gambar menulis "bukit dekat X" dan petanya raster beresolusi rendah. Mencocokkan kandidatmu dengan itu butuh penalaran nyata atas geografi.
Aturan saya dari pekerjaan ML produksi: agen boleh menghasilkan klaim kandidat, tapi klaim kebaruan, yaitu "belum pernah ada yang melaporkan ini", adalah satu-satunya output yang harus kamu verifikasi secara manual, dengan pencarian sedalam mungkin, sebelum keluar dari gedung. Sisi geospasial juga punya jebakan analog dengan sistem koordinat dan batas wilayah; siapa pun yang pernah berurusan dengan trade-off indexing spasial tahu bahwa "apakah titik ini ada di dataset ini" tidak pernah sesederhana kelihatannya.
Vonis: terpatahkan, parah. Verifikasi fisik didelegasikan dengan baik dalam cerita ini. Verifikasi kebaruan didelegasikan dengan sangat buruk. Rancang pipeline-mu dengan itu dalam pikiran: otomatiskan pencariannya, tapi perlakukan "tidak ada karya sebelumnya yang ditemukan" sebagai draf, bukan kesimpulan.
Mitos 5: Loop Verifikasi Itu Hanya Satu Langkah
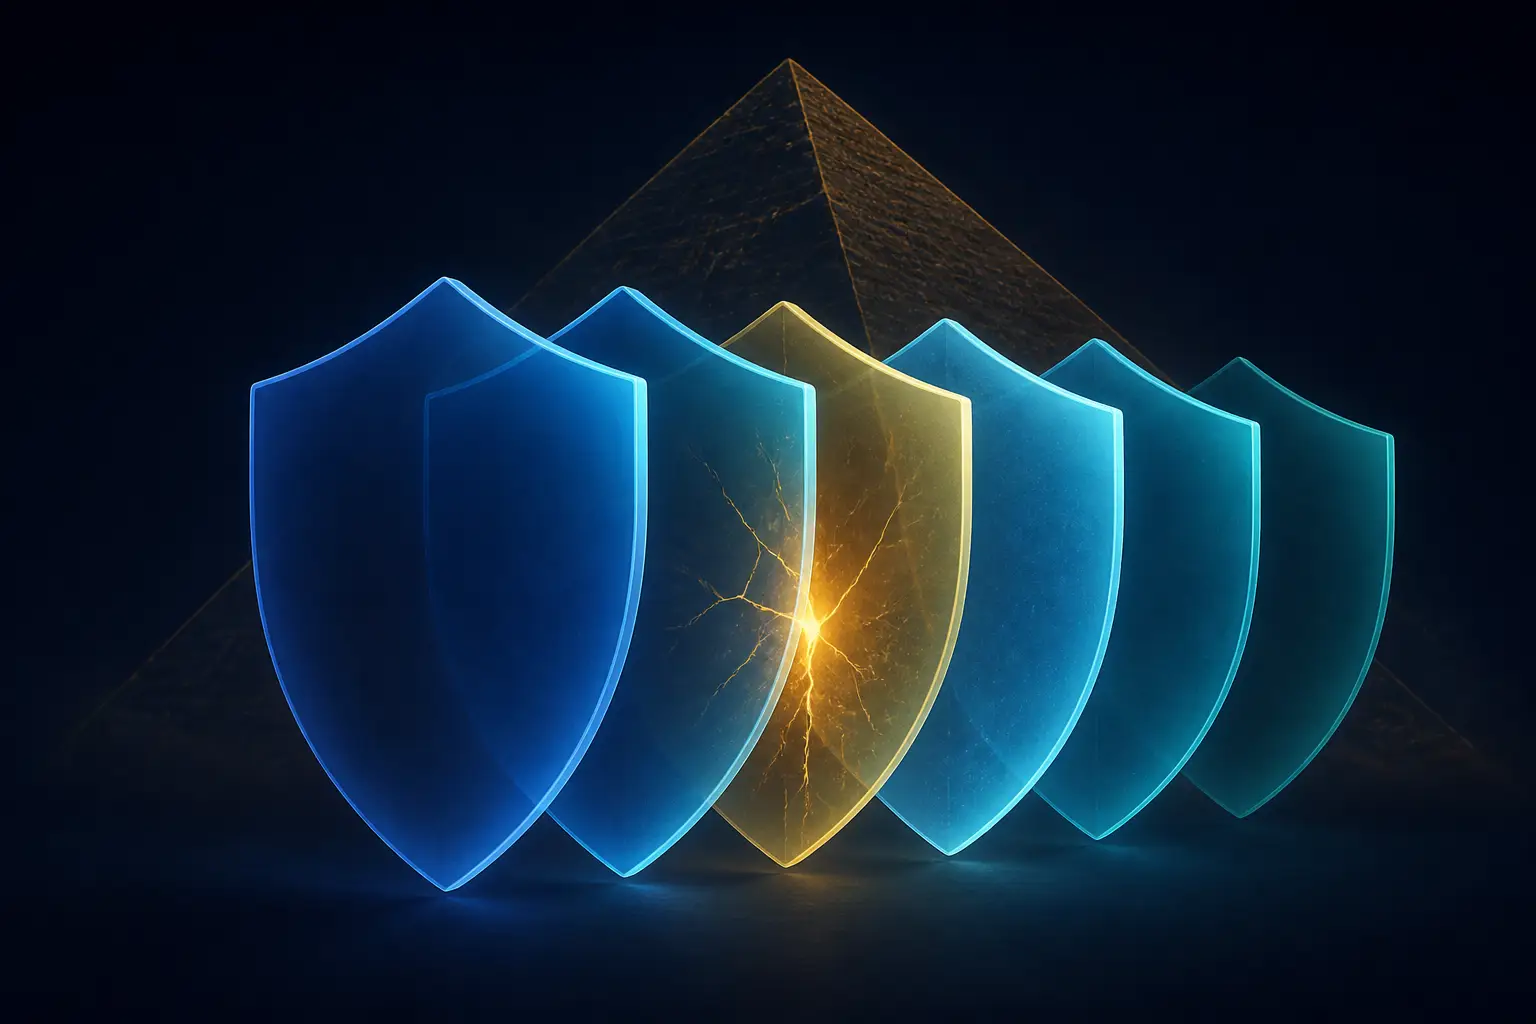
Cara yang berguna untuk membaca seluruh alur 72 jam ini adalah sebagai desain verifikasi berlapis, di mana beberapa lapisan bertahan dan satu runtuh. Ada baiknya menamai lapisan-lapisannya karena itulah yang akan kamu bangun untuk sistem generasi klaim agentik apa pun:
- Lapisan 1: Pemeriksaan tingkat sensor. Apakah data mentah mendukung fitur hasil render? (Irisan point cloud. Lulus.)
- Lapisan 2: Tinjauan agen independen. Agen berbeda, prompt berbeda, memeriksa ulang kandidat; perbedaan pendapat diarahkan ke manusia. (Sebagian besar lulus; tidak ada bukti yang dipublikasikan soal prompting adversarial, dan itu yang akan saya tambahkan.)
- Lapisan 3: Otoritas eksternal. Kueri ke register resmi, dan INAH mengonfirmasi tidak ada yang terdaftar. (Lulus, tapi hanya membuktikan ketiadaan di register, bukan kebaruan.)
- Lapisan 4: Pencarian prior-art. (Gagal, melewatkan makalah survei 2025.)
- Lapisan 5: Pakar domain. Akhirnya disediakan oleh komunitas dan penulis asli, setelah publikasi. (Ini lapisan yang menangkap kesalahannya.)
Pelajarannya bukan "jangan percaya agen", melainkan setiap lapisan memverifikasi klaim yang berbeda, dan lulusnya tiga dari lima lapisan tidak memberitahumu apa-apa tentang dua lainnya. Lapisan 3 yang lulus justru menyesatkan di sini, karena "tidak ada di register" naik kelas di kepala manusia menjadi "tidak dikenal oleh ilmu pengetahuan". Itu error join antara dua dataset dengan cakupan berbeda, dan itu kelas bug yang sama dengan mengira batas kode pos berarti apa yang kamu kira, jenis hal yang kami bahas di ketidakcocokan batas ZCTA vs USPS. Dua sumber yang tampak otoritatif, ketidaksepakatan diam-diam, kesimpulan yang salah tapi yakin.
Setiap lapisan dalam tumpukan verifikasi memeriksa klaim yang berbeda. Lulusnya tiga lapisan tidak memberitahumu apa pun tentang lapisan keempat.
Kalau saya yang memperkuat pipeline ini, saya akan menambahkan dua mekanisme murah. Pertama, pass literatur adversarial: agen terpisah yang tugasnya hanya membantah kebaruan, dengan alat pencarian yang lebih agresif dan instruksi untuk menganggap karya sebelumnya pasti ada. Kedua, ping pakar sebelum publikasi, yaitu mengirim daftar kandidat ke setidaknya satu spesialis domain sebelum mengumumkan apa pun. Respons komunitas di sini menunjukkan para pakar mau terlibat dengan cepat; koreksinya datang dalam hitungan jam setelah postingan tayang.
Apa yang Sebenarnya Dibuktikan oleh Penemuan Ulang
Tapi saya akan membela hasilnya, karena menurut saya para skeptis salah membaca analisis kegagalannya. Seorang outsider dengan laptop dan sedikit komputasi secara independen sampai pada situs yang sama yang sudah dipublikasikan oleh survei profesional, memakai data publik dalam beberapa malam waktu agen. Kalau pipeline triasemu menemukan ulang situs yang sudah dikenal, itu sinyal kalibrasi, bukan rasa malu: artinya detektornya punya sensitivitas nyata. Kamu justru harus lebih khawatir jika ia hanya memunculkan hal-hal yang tidak bisa dikonfirmasi siapa pun.
Resep yang bisa direplikasi, tanpa narasi petualangannya:
- Pilih domain di mana data sensor publik jauh melampaui perhatian manusia (lidar adalah kasus klasik; arsip ilmu bumi NASA adalah contoh lain).
- Ubah data mentah menjadi rendering visual berkualitas tinggi. Langkah ini lebih penting daripada pilihan model.
- Sebarkan agen vision yang murah dengan rubrik tertulis yang presisi tentang positif dan false positive yang sudah diketahui.
- Verifikasi kandidat yang lolos terhadap data mentah, bukan rendering.
- Perlakukan kebaruan sebagai jalur verifikasi terpisah yang dipimpin manusia, dan arahkan klaim ke pakar domain sebelum mengumumkan.
Ada satu hal lagi yang diangkat komunitas arkeologi dan layak direnungkan: penemuan bukan lagi bottleneck, pengelolaanlah yang jadi bottleneck. Situs yang ditemukan lebih cepat daripada bisa digali atau dilindungi akan menjadi sasaran penjarahan, dan koordinat adalah informasi sensitif (penulis laporan benar untuk menaruhnya di lampiran rahasia). Kalau kamu membangun pipeline penemuan di domain sensitif, bangun kebijakan pengungkapannya dulu. Verifikasi bukan hanya soal benar; ini soal benar secara bertanggung jawab.
Kesimpulan jujurnya: pipeline agentik di atas data geospasial publik memang bisa menghasilkan klaim nyata yang bisa diverifikasi, dan trik vision-model-sebagai-surveyor bekerja lebih baik daripada yang diperkirakan kebanyakan praktisi. Tapi klaim yang bertahan adalah yang loop verifikasinya dirancang untuk lapisan yang gagal secara diam-diam. Dalam cerita ini, pemeriksaan lidar berkicau riang dan pemeriksaan literatur berbisik. Bangunlah untuk bisikan itu.


