एजेंटिक लिडार पुरातत्व: 5 मिथक, परखे हुए
एक AI एजेंट पाइपलाइन ने रात भर लिडार डेटा में माया स्थल चिह्नित किया। हम एजेंटिक लिडार पुरातत्व के 5 मिथकों और सत्यापन लूप की सच्चाई परखते हैं।
 Sarah Chen

एक ही रात में 48 AI एजेंटों ने जंगल के 1,200 वर्ग किलोमीटर लिडार डेटा को स्कैन किया और एक ऐसे माया नागरिक केंद्र को चिह्नित किया जो मेक्सिको के आधिकारिक पुरातात्विक रजिस्टर में नहीं था। फिर असहज हिस्सा सामने आया: पता चला कि पुरातत्वविदों ने 2025 के एक शोधपत्र में उसी जगह का नक्शा पहले ही बना लिया था, और एजेंट — और उनके मानव ऑपरेटर — साहित्य खोज में उसे चूक गए थे। यह कहानी छोटे रूप में वह सब बताती है जो आपको एजेंटिक लिडार पुरातत्व के बारे में जानना चाहिए: खोज वाली पाइपलाइन सच में काम करती है, और सत्यापन लूप सच में काम नहीं करता, जब तक कि आप उसे सही तरीके से न बनाएँ।
मैंने वर्षों तक ऐसी ML पाइपलाइनें बनाई हैं जहाँ फॉल्स पॉज़िटिव की कीमत एक पुरातात्विक स्थल की गलत रिपोर्टिंग नहीं, बल्कि किसी इंजीनियर का रात में जगाया जाना होती थी। तो आइए इस तरह की एजेंटिक खोज पाइपलाइन के बारे में मैं जो पाँच धारणाएँ लगातार देखता हूँ, उन्हें लेकर चलें, और हर एक को उस पर परखें जो सच में हुआ।
मिथक 1: खंडहर खोजने के लिए एक कस्टम-ट्रेन्ड मॉडल चाहिए
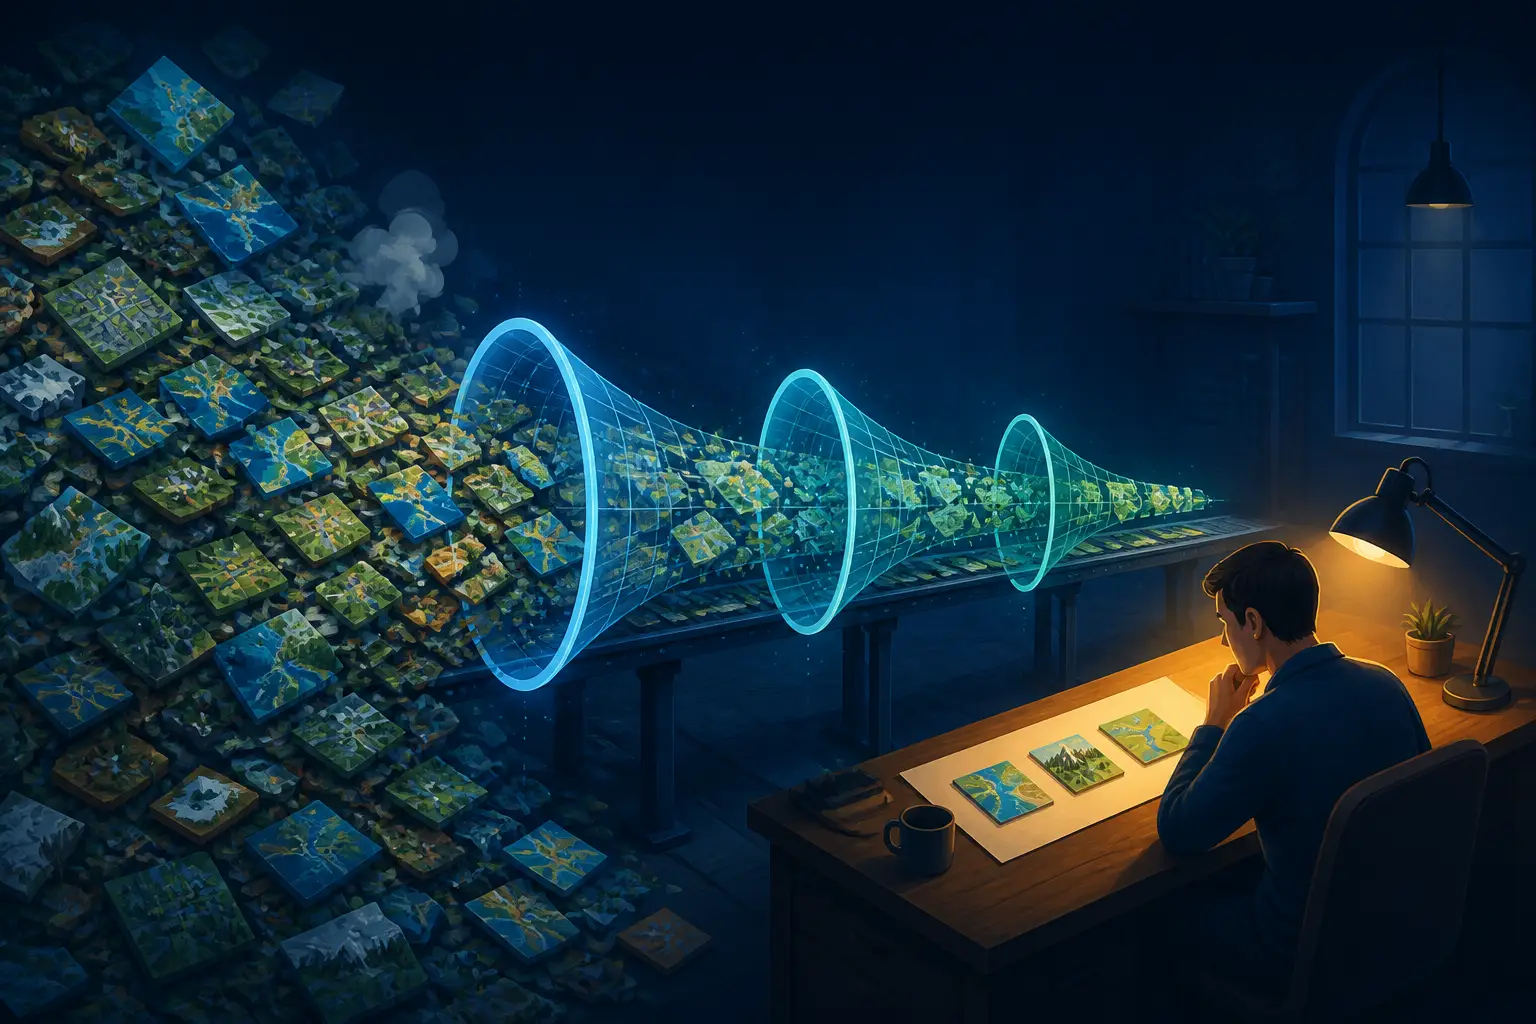
पूरी कहानी का सबसे चौंकाने वाला विवरण: इसमें कोई खास मॉडल शामिल नहीं था। लेबल किए गए पिरामिड टाइल्स पर ट्रेन किया गया कोई CNN नहीं, कोई फाइन-ट्यून्ड डिटेक्टर नहीं। पाइपलाइन ने लिडार स्ट्रिप्स को हिलशेड-शैली की छवियों में बदला और सामान्य-उद्देश्य वाले विज़न-लैंग्वेज एजेंटों ने उन्हें एक-एक करके देखा, एक लिखित गाइड का पालन करते हुए जिसमें बताया गया था कि पिरामिड, चबूतरे और चौक कैसे दिखते हैं, और पहाड़ियों, सिंकहोल और सड़कों से वे कैसे अलग हैं।
यह इसलिए काम करता है क्योंकि फ्रंटियर विज़न मॉडलों ने विज़ुअल प्रायर ज्ञान की एक विशाल मात्रा को प्रभावी रूप से आत्मसात कर लिया है। जंगल की छत्रछाया के नीचे सीधी किनारों वाला समतल चबूतरा एक एनोमली-डिटेक्शन समस्या है, और जब आप उन्हें साफ़ रेंडर की गई इनपुट देते हैं तो आधुनिक VLM काफी अच्छे एनोमली स्पॉटर साबित होते हैं। चाल मॉडल में नहीं, रेंडरिंग में है। लिडार पॉइंट क्लाउड सीधे विज़न मॉडल के लिए बेकार हैं; आपको उन्हें किसी पठनीय रूप में बदलना होता है: डिजिटल टेरेन मॉडल, कई सूर्य-कोणों वाले हिलशेड, स्लोप मैप। विज़ुअलाइज़ेशन सही हो तो एक सामान्य मॉडल भी आश्चर्यजनक रूप से दक्ष सर्वेयर बन जाता है।
फिर भी, यह एक ऐसा फ्रंटियर है जिसका बचाव मैं कुछ शर्तों के साथ करूँगा। उच्च-मात्रा वाले प्रोडक्शन काम के लिए, विशेष क्लासिफायर अब भी लागत और स्थिरता में जीतता है — इस ट्रेड-ऑफ पर हम पहले इमेज क्लासिफिकेशन के लिए स्पेशलिस्ट CNN बनाम फ्रंटियर LLM पर चर्चा कर चुके हैं। एक हज़ार से ज़्यादा इमेज टाइल्स पर 48 एजेंट सेशन चलाना महँगा और नॉन-डिटरमिनिस्टिक है। लेकिन खोज के लिए, जहाँ आप सेवा चलाने के बजाय परिकल्पनाएँ बना रहे हैं? सामान्य मॉडल प्लस अच्छे प्रॉम्प्ट वाला तरीका व्यावहारिक रूप से सही है, और इसमें लेबल किए गए ट्रेनिंग डेटा की कोई लागत नहीं — जो वैसे भी विशेष पुरातात्विक कार्यों के लिए लगभग मौजूद ही नहीं होता।
निर्णय: गलत साबित हुआ, एक शर्त के साथ। उम्मीदवार बनाने के लिए आपको कस्टम मॉडल की ज़रूरत नहीं है। अगर यह बार-बार दोहराए जाने वाला, स्केल किया हुआ काम बन जाए, तो शायद आप एक चाहेंगे।
मिथक 2: खोज एजेंटों ने की
टाइमलाइन को ध्यान से पढ़ें तो दिखता है कि एजेंटों ने असल में क्या किया: उन्होंने छानने का काम किया। खोज स्वयं कई साल पहले एयरबोर्न लिडार टीमों ने की थी, उन शोधकर्ताओं ने जिन्होंने पुरातत्व के लिए पर्यावरणीय लिडार के पुन: उपयोग पर प्रकाशन किया, और खास तौर पर 2025 के सर्वे पेपर के लेखकों ने, जिन्होंने इसी पहाड़ी को पहले ही मैप कर लिया था। एजेंटों ने खोज के दायरे को 1,200 वर्ग किलोमीटर जंगल से घटाकर कुछ उम्मीदवार टाइल्स तक सीमित कर दिया, जिन्हें एक इंसान कॉफ़ी के साथ देख सकता है।
यह कोई आलोचना नहीं है — इतने बड़े पैमाने पर छँटाई ही अधिकांश डेटा-समृद्ध विज्ञानों में असली बाधा है। रेडियो खगोलविज्ञान, कण भौतिकी, जेनोमिक्स: पैटर्न हमेशा एक ही होता है। सेंसर इंसानों द्वारा देखे जाने से कहीं ज़्यादा डेटा पैदा करते हैं, इसलिए खोज की दर डेटा की उपलब्धता से नहीं, बल्कि ट्रायज की गति से सीमित होती है। यही गतिशीलता AI बेंचमार्क असली काम का बड़ा हिस्सा क्यों छोड़ देते हैं के पीछे भी है — मूल्यवान कार्य कभी "स्मार्ट होना" नहीं था, बल्कि "दस लाख उबाऊ चीज़ें देखना और उनमें से पाँच दिलचस्प चुनना" था।
निर्णय: ज़्यादातर गलत साबित हुआ। एजेंट ध्यान के फोर्स मल्टीप्लायर हैं, खोज के स्रोत नहीं। जिस क्षण आप उन्हें खोजकर्ता मान लेते हैं, आप उनके नकारात्मक नतीजों पर भरोसा करने लगते हैं — "साहित्य खोज में कुछ नहीं मिला" — और यहीं इस कहानी की विफलता का मूल छिपा है।
मिथक 3: विज़न एजेंट की सीधी रेखाएँ ग्राउंड ट्रुथ हैं
पाइपलाइन का वह हिस्सा जिसे मैंने तकनीकी रूप से सबसे सुदृढ़ पाया। विज़न एजेंट ने पहाड़ी को चिह्नित करने के बाद, वर्कफ़्लो रेंडर की गई छवि पर नहीं रुका। वह कच्चे पॉइंट क्लाउड पर लौटा और जाँचा कि ग्राउंड-क्लासिफाइड रिटर्न (कैनोपी रिटर्न के विपरीत) वास्तव में चबूतरे, पिरामिड और आँगन की रेखा खींचते हैं — 10–17 मीटर जंगल के नीचे। किसी भी जियोस्पेशियल ML पाइपलाइन में यह सबसे महत्वपूर्ण आदत है: रेंडरिंग झूठ बोल सकती है, पॉइंट नहीं।
इतनी सावधानी क्यों? लिडार प्रोसेसिंग में ग्राउंड क्लासिफिकेशन स्वयं एक मॉडल है, और घने उष्णकटिबंधीय जंगल में, जहाँ लगभग कोई वास्तविक रिटर्न नहीं होते, यह चिकनी सतहों का अनुमान लगा सकता है। एक "चबूतरा" ग्राउंड-फाइंडिंग एल्गोरिदम द्वारा समतलता के भ्रम का नतीजा हो सकता है। वनस्पति की संरचना भी अजीब तरह से रैखिक कैनोपी अंतराल पैदा कर सकती है, जो हिलशेड में फैल जाते हैं। जिसने भी देश-स्तरीय जियोडेटा पाइपलाइनों पर काम किया है, वह उन प्रोसेसिंग आर्टिफैक्ट्स से जल चुका है जो संकेत से ज़्यादा सार्थक दिखते हैं।
तो सत्यापन चेकलिस्ट, जिस पर मैं ज़ोर देता, और जिसका इस कहानी में अधिकतर पालन हुआ:
- सुविधा की पुष्टि कच्चे पॉइंट क्लाउड में करें, कम से कम दो अक्षों पर स्लाइस करके — केवल रेंडर किए गए DTM में नहीं।
- कई हिलशेड एज़िमुथ से रेंडर करें; स्कैन-लाइन की दिशा से बने आर्टिफैक्ट्स गायब हो जाते हैं या खिसक जाते हैं, असली संरचनाएँ नहीं।
- अगर कोई दूसरा डेटा स्रोत हो तो उससे क्रॉस-चेक करें (अलग सर्वे, अलग वर्ष)।
- ज्ञात फॉल्स-पॉज़िटिव जनरेटर छानें: सिंकहोल (माया क्षेत्र कार्स्ट है, जो इनसे भरा है), आधुनिक सड़कें, लॉगिंग के निशान और भूवैज्ञानिक टेरेस।
- विसंगति को मापें: किनारों की सीधाई, कोणों का माप, क्षेत्रीय पृष्ठभूमि की तुलना में चबूतरे का क्षेत्रफल। "आयताकार दिखता है" एक अनुभूति है; मापा गया आस्पेक्ट रेशियो एक दावा है।
पाइपलाइन ने इनमें से अधिकांश जाँचें पास कीं। और उल्लेखनीय बात यह है कि भौतिक दावा सही निकला — स्थल वास्तविक है, और पुरातत्वविद सहमत हैं कि यह क्लासिक काल का नागरिक केंद्र है। विफलता एक बिल्कुल अलग धुरी पर हुई।
मिथक 4: साहित्य जाँचना एक ऐसा काम है जिसे सौंपा जा सकता है
यह वह मिथक है जिसे इस कहानी ने सार्वजनिक रूप से खुद पर ही गलत साबित किया। एजेंटों ने साहित्य और आधिकारिक INAH रजिस्टर खँगाला, कुछ नहीं मिला, और स्थल को अपंजीकृत बताया। तकनीकी रूप से सही था — यह INAH के रजिस्टर में नहीं था। लेकिन उसी वर्ष एक पीयर-रिव्यूड पेपर ने इस स्थल का नक्शा बना दिया था, और एजेंटिक साहित्य खोज उसे अनदेखा कर गई। "पुनर्खोज" हेडलाइन में तभी आई जब किसी विषय-विशेषज्ञ ने उद्धरण की ओर इशारा किया।
यदि आपने ऐसे एजेंट बनाए हैं जो पूर्व-कला (prior-art) या नवीनता की जाँच करते हैं, तो यह पढ़कर आपको पहचान की एक सिहरन होनी चाहिए। साहित्य खोज संरचनात्मक कारणों से सौंपने का सबसे कठिन काम है:
- कवरेज अदृश्य है। एजेंट यह नहीं बता सकता कि उसे क्या पहुँच में नहीं आया — पेवॉल वाली पत्रिकाएँ, यूनिवर्सिटी रिपॉज़िटरी के पीछे के PDF, या ऐसे पेपर जिनमें स्थल तालिका में एक निर्देशांक भर है, पृष्ठ 14 पर। यही तो वह जगह थी जहाँ यह स्थल था।
- नकारात्मक नतीजे असत्यापनीय हैं। "कुछ नहीं मिला" एक जैसा दिखता है, चाहे कुछ मौजूद न हो या आपकी खोज उथली रही हो। कोई त्रुटि संकेत नहीं होता।
- नए प्रकाशन हर इंडेक्स से पीछे रहते हैं। 2025 का एक पेपर खराब तरीके से इंडेक्स हो सकता है, खोज टूल्स द्वारा न उठाया गया हो, या केवल कॉन्फ़्रेंस टॉक और प्रीप्रिंट सर्वर के ज़रिए जाना जाता हो।
- स्थानिक मिलान अपनी अलग समस्या है। पेपर हमेशा निर्देशांक प्रकाशित नहीं करते; स्थलों के कई नाम होते हैं; चित्र का कैप्शन "X के पास पहाड़ी" कहता है और नक्शा कम रिज़ॉल्यूशन का रास्टर है। अपने उम्मीदवार को उससे मिलाने के लिए भूगोल पर वास्तविक तर्क चाहिए।
प्रोडक्शन ML कार्य से मेरा नियम: एजेंट उम्मीदवार दावे बना सकते हैं, लेकिन नवीनता का दावा — "यह किसी ने रिपोर्ट नहीं किया" — वह आउटपुट है जिसे इमारत से बाहर जाने से पहले, जितनी गहरी खोज संभव हो, मैन्युअली सत्यापित किया जाना चाहिए। जियोस्पेशियल पक्ष में निर्देशांक और सीमा प्रणालियों का समान जाल है; जिसने स्पेशियल इंडेक्सिंग के ट्रेड-ऑफ से निपटा है, वह जानता है कि "क्या यह बिंदु इस डेटासेट में है" उतना सरल कभी नहीं होता जितना लगता है।
निर्णय: पूरी तरह गलत साबित हुआ। इस कहानी में भौतिक सत्यापन अच्छी तरह सौंपा गया। नवीनता सत्यापन बुरी तरह सौंपा गया। अपनी पाइपलाइन उसी हिसाब से डिज़ाइन करें: खोज को स्वचालित करें, लेकिन "कोई पूर्व कार्य नहीं मिला" को निष्कर्ष नहीं, बल्कि ड्राफ्ट मानें।
मिथक 5: सत्यापन लूप एक ही चरण है
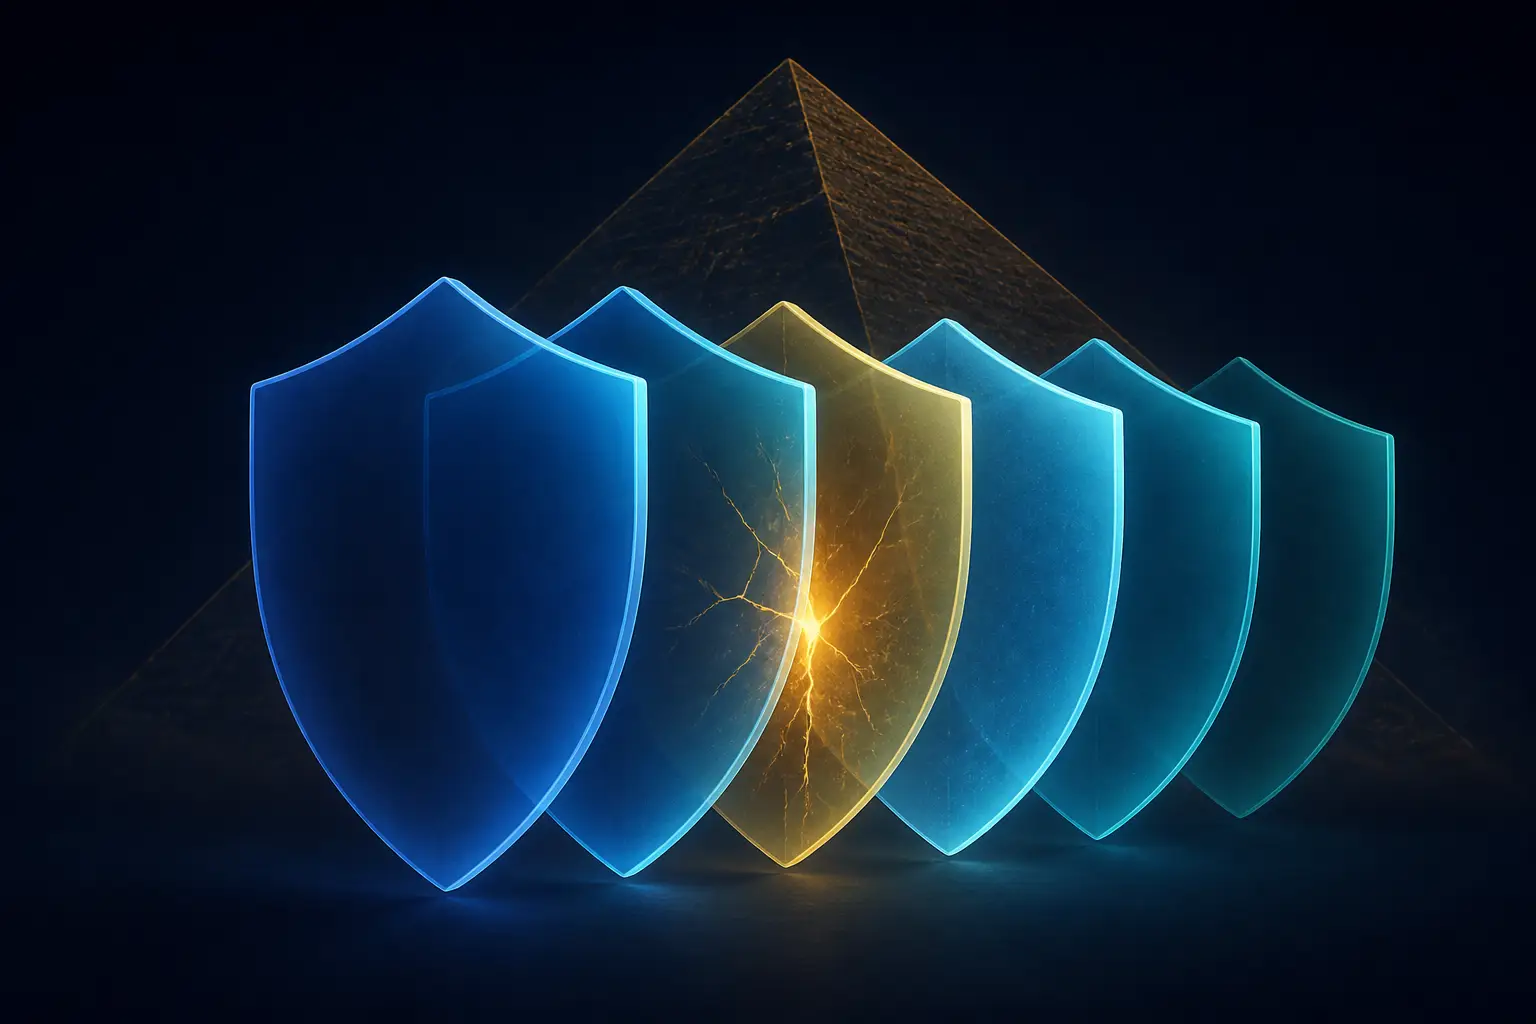
पूरे 72 घंटे के घटनाक्रम को पढ़ने का उपयोगी तरीका यह है कि इसे एक स्तरित सत्यापन डिज़ाइन के रूप में देखें, जहाँ कुछ परतें टिकीं और एक ढह गई। परतों के नाम लेना उपयोगी है, क्योंकि ये वही परतें हैं जो आप किसी भी एजेंटिक दावा-निर्माण प्रणाली के लिए बनाएँगे:
- परत 1 — सेंसर-स्तरीय जाँच। क्या कच्चा डेटा रेंडर की गई सुविधा का समर्थन करता है? (पॉइंट क्लाउड स्लाइस। पास।)
- परत 2 — स्वतंत्र एजेंट समीक्षा। अलग एजेंट, अलग प्रॉम्प्ट, उम्मीदवारों को फिर से जाँचते हैं; असहमति मानव तक भेजी जाती है। (ज़्यादातर पास; एडवर्सरियल प्रॉम्प्टिंग का कोई प्रकाशित प्रमाण नहीं, जिसे मैं जोड़ता।)
- परत 3 — बाहरी प्राधिकरण। आधिकारिक रजिस्टर से पूछा गया — INAH ने पुष्टि की कि कुछ पंजीकृत नहीं है। (पास, लेकिन केवल रजिस्टर में अनुपस्थिति सिद्ध की, नवीनता नहीं।)
- परत 4 — पूर्व-कला खोज। (विफल — 2025 का सर्वे पेपर छूट गया।)
- परत 5 — विषय विशेषज्ञ। अंततः प्रकाशन के बाद समुदाय और मूल लेखकों द्वारा उपलब्ध कराया गया। (यही वह परत थी जिसने त्रुटि पकड़ी।)
सीख यह नहीं है कि "एजेंटों पर भरोसा मत करो" — बल्कि यह है कि हर परत एक अलग दावे की जाँच करती है, और पाँच में से तीन परतों का पास होना बाकी दो के बारे में कुछ नहीं बताता। यहाँ परत 3 का पास होना सक्रिय रूप से भ्रामक था, क्योंकि "रजिस्टर में नहीं" को इंसान के मन में "विज्ञान को ज्ञात नहीं" बना दिया गया। यह अलग-अलग कवरेज वाले दो डेटासेट के बीच जॉइन की त्रुटि है, और यह उसी श्रेणी का बग है जैसे यह मान लेना कि ZIP कोड सीमा का वही अर्थ है जो आप सोचते हैं — ऐसी चीज़ जिस पर हम ZCTA बनाम USPS सीमा असंगति में गहराई से जाते हैं। दो विश्वसनीय दिखने वाले स्रोत, चुपचाप असहमति, और आत्मविश्वास भरा गलत निष्कर्ष।
सत्यापन स्टैक की हर परत एक अलग दावे की जाँच करती है। तीन परतों का पास होना चौथी के बारे में कुछ नहीं बताता।
अगर मैं इस पाइपलाइन को मज़बूत कर रहा होता, तो मैं दो सस्ते तंत्र जोड़ता। पहला, एक एडवर्सरियल साहित्य पास: एक अलग एजेंट जिसका एकमात्र काम नवीनता को गलत साबित करना होगा, जिसके पास अधिक आक्रामक खोज टूलिंग हो और निर्देश हो कि पूर्व कार्य मौजूद है यह मानकर चले। दूसरा, एक प्रकाशन-पूर्व विशेषज्ञ संपर्क — कुछ भी घोषित करने से पहले उम्मीदवार सूची किसी एक वास्तविक विषय-विशेषज्ञ को भेजें। यहाँ की सामुदायिक प्रतिक्रिया दिखाती है कि विशेषज्ञ तेज़ी से जुड़ने को तैयार रहते हैं; पोस्ट आने के कुछ घंटों के भीतर सुधार आ गया।
पुनर्खोज वास्तव में क्या साबित करती है
फिर भी मैं परिणाम का बचाव करूँगा, क्योंकि मुझे लगता है कि संशयवादियों ने विफलता के विश्लेषण को गलत समझा। एक बाहरी व्यक्ति, लैपटॉप और थोड़े कंप्यूट के साथ, सार्वजनिक डेटा का उपयोग करके, कुछ रातों के एजेंट समय में, उसी स्थल पर स्वतंत्र रूप से पहुँचा जिसे एक पेशेवर सर्वे ने प्रकाशित किया था। अगर आपकी ट्रायज पाइपलाइन ज्ञात स्थलों को फिर से खोजती है, तो यह एक कैलिब्रेशन संकेत है, शर्मिंदगी नहीं: इसका मतलब है कि डिटेक्टर में वास्तविक संवेदनशीलता है। आपको कहीं ज़्यादा चिंता तब होनी चाहिए जब वह केवल ऐसी चीज़ें उठाए जिन्हें कोई कभी पुष्ट नहीं कर सकता।
रोमांचक कथा से अलग, दोहराए जा सकने वाला तरीका:
- ऐसा क्षेत्र चुनें जहाँ सार्वजनिक सेंसर डेटा मानव ध्यान से कहीं ज़्यादा हो (लिडार सबसे स्पष्ट उदाहरण है; NASA के पृथ्वी विज्ञान अभिलेखागार एक और है)।
- कच्चे डेटा को उच्च-गुणवत्ता वाले विज़ुअल रेंडर में बदलें — यह चरण मॉडल चुनाव से ज़्यादा मायने रखता है।
- सस्ते विज़न एजेंटों को सकारात्मक और ज्ञात फॉल्स पॉज़िटिव की सटीक लिखित रूब्रिक के साथ फैलाएँ।
- बचे हुए उम्मीदवारों को रेंडरिंग के बजाय कच्चे डेटा से सत्यापित करें।
- नवीनता को एक अलग, मानव-नेतृत्व वाला सत्यापन ट्रैक मानें, और घोषणा से पहले दावों को किसी विषय-विशेषज्ञ के पास भेजें।
पुरातत्व समुदाय ने एक और बात उठाई है जिस पर विचार करना उचित है: खोज अब बाधा नहीं रही — संरक्षण बाधा है। जो स्थल उतनी तेज़ी से मिल जाते हैं जितनी तेज़ी से उनकी खुदाई या सुरक्षा नहीं हो सकती, वे लूट के निशाने बन जाते हैं, और निर्देशांक संवेदनशील जानकारी हैं (रिपोर्ट के लेखक ने उन्हें गोपनीय परिशिष्ट में रखकर सही किया)। यदि आप संवेदनशील क्षेत्रों पर खोज पाइपलाइन बनाते हैं, तो पहले प्रकटीकरण नीति बनाएँ। सत्यापन केवल सही होने के बारे में नहीं है; यह ज़िम्मेदारी से सही होने के बारे में है।
ईमानदार सार: सार्वजनिक जियोस्पेशियल डेटा पर एजेंटिक पाइपलाइनें निश्चित रूप से वास्तविक, सत्यापन योग्य दावे उत्पन्न कर सकती हैं, और विज़न मॉडल-को-सर्वेयर वाली चाल अधिकांश प्रैक्टिशनरों की उम्मीद से बेहतर काम करती है। लेकिन जो दावा टिकता है, वह वही है जिसका सत्यापन लूप उस परत के लिए डिज़ाइन किया गया था जो चुपचाप विफल होती है। इस कहानी में लिडार की जाँचें सही बोलीं और साहित्य की जाँच धीमी फुसफुसाहट में। उसी फुसफुसाहट के लिए बनाइए।


