Agentische Lidar-Archäologie: 5 Mythen im Test
Eine KI-Agenten-Pipeline markierte über Nacht eine Maya-Stätte in Lidar-Daten. Wir testen 5 Mythen der agentischen Lidar-Archäologie und was die Verifikationsschleife wirklich leistet.
 Sarah Chen

Achtundvierzig KI-Agenten durchsuchten über Nacht 1.200 km² Dschungel-Lidardaten und markierten ein Maya-Zentrum, das nicht im offiziellen archäologischen Register Mexikos stand. Dann kam der unangenehme Teil: Es stellte sich heraus, dass Archäologen genau diese Stätte bereits 2025 in einer Fachveröffentlichung kartiert hatten. Die Agenten – und ihr Mensch – hatten sie bei der Literaturrecherche übersehen. Die Geschichte fasst im Kleinen zusammen, was man über agentische Lidar-Archäologie wissen muss: Die Entdeckungspipeline funktioniert wirklich, und die Verifikationsschleife funktioniert wirklich nicht, es sei denn, man baut sie richtig.
Ich habe jahrelang ML-Pipelines gebaut, bei denen ein falsch positives Ergebnis einen alarmierten Ingenieur bedeutete und keine falsch gemeldete archäologische Stätte. Deshalb nehme ich die fünf Annahmen, die ich zu solchen agentischen Entdeckungspipelines immer wieder höre, und prüfe jede einzeln anhand dessen, was tatsächlich passiert ist.
Mythos 1: Man braucht ein eigens trainiertes Modell, um Ruinen zu finden
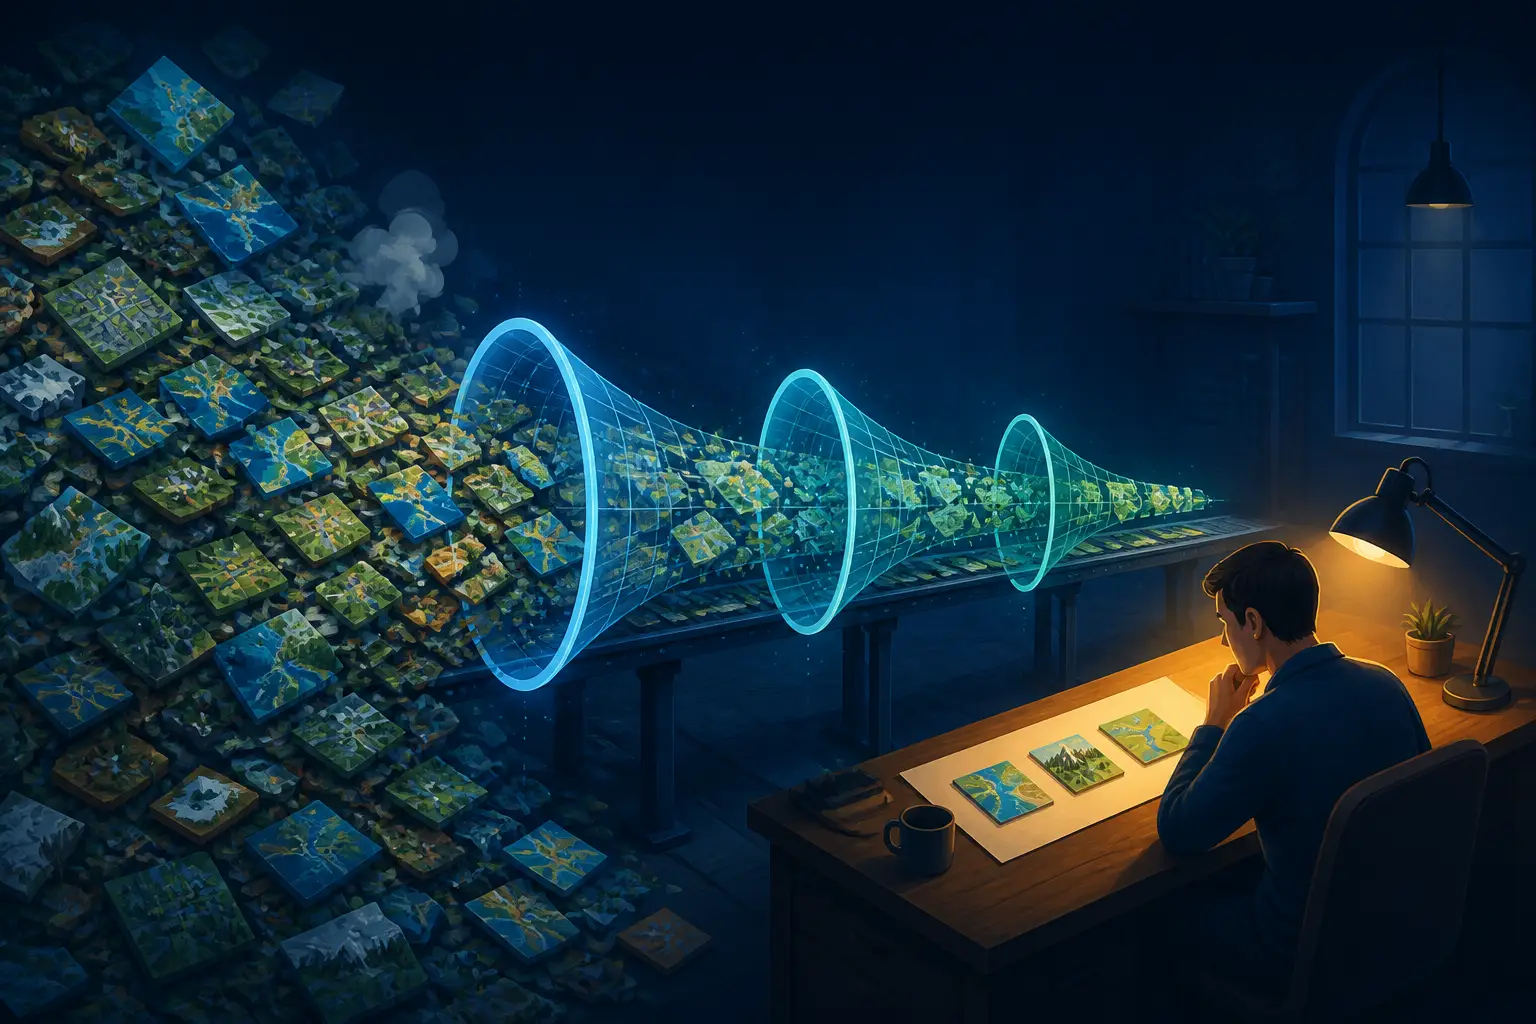
Das überraschendste Detail der ganzen Geschichte: Ein spezielles Modell war gar nicht im Spiel. Kein CNN, das auf beschrifteten Pyramidenkacheln trainiert wurde, kein feinabgestimmter Detektor. Die Pipeline wandelte Lidar-Streifen in schummerungsartige Bilder um und ließ allgemeine Vision-Language-Agenten diese einzeln betrachten, geleitet von einer schriftlichen Anleitung, die beschreibt, wie Pyramiden, Plattformen und Plätze aussehen – im Unterschied zu Hügeln, Dolinen und Straßen.
Das funktioniert, weil moderne Bildmodelle eine enorme visuelle Vorwissensbasis aufgenommen haben. Ein eingeebneter Platz mit geraden Kanten unter einem Dschungeldach ist ein Anomalieerkennungsproblem, und aktuelle VLMs sind ziemlich gute Anomaliesucher, wenn man ihnen saubere, gerenderte Eingaben gibt. Der Trick liegt nicht im Modell, sondern im Rendering. Lidar-Punktwolken sind für ein Bildmodell direkt nutzlos; man muss sie in etwas Lesbares verwandeln: digitale Geländemodelle, Schummerungen mit mehreren Sonnenwinkeln, Hangneigungskarten. Stimmt die Visualisierung, wird ein Generalistenmodell zu einem erstaunlich kompetenten Vermessungsexperten.
Trotzdem ist das ein Feld, das ich nur mit Einschränkungen verteidige. Für Produktionsbetrieb mit hohem Volumen gewinnt weiterhin ein spezialisierter Klassifikator bei Kosten und Konsistenz – das Abwägen haben wir schon in spezialisierte CNNs vs. Frontier-LLMs für Bildklassifikation behandelt. 48 Agentensitzungen über mehr als tausend Bildkacheln sind teuer und nicht deterministisch. Aber für die Exploration, wenn man Hypothesen erzeugt statt einen Dienst zu betreiben? Der Ansatz mit Generalist plus gutem Prompt ist pragmatisch richtig, und er kostet keine gelabelten Trainingsdaten – die es für Nischenthemen der Archäologie ohnehin kaum gibt.
Urteil: widerlegt, mit einem Sternchen. Man braucht kein eigenes Modell, um Kandidaten zu erzeugen. Wenn daraus ein wiederholter, skalierter Betrieb wird, will man vermutlich doch eines.
Mythos 2: Die Agenten haben die Entdeckung gemacht
Liest man die Zeitleiste genau, sieht man, was die Agenten wirklich getan haben: Sie haben gefiltert. Die eigentliche Entdeckung stammt Jahre früher von den Befliegungsteams für Lidar, von den Forschenden, die Umwelt-Lidar für die Archäologie nachgenutzt haben, und konkret von den Autoren des Übersichtsartikels von 2025, die genau diesen Hügel bereits kartiert hatten. Die Agenten haben den Suchraum von 1.200 km² Dschungel auf eine Handvoll Kandidatenkacheln verdichtet, die ein Mensch bei einem Kaffee prüfen kann.
Das ist kein Vorwurf. Filtern in dieser Größenordnung ist in den meisten datenreichen Wissenschaften der eigentliche Engpass: Radioastronomie, Teilchenphysik, Genomik – das Muster ist immer dasselbe. Sensoren liefern weit mehr Daten, als Menschen sichten können, also wird die Entdeckungsrate durch den Durchsatz bei der Triage begrenzt, nicht durch die Verfügbarkeit der Daten. Genau diese Dynamik steckt hinter warum KI-Benchmarks den größten Teil echter Arbeit verfehlen: Die wertvolle Aufgabe war nie „schlau sein“, sondern „eine Million langweiliger Dinge ansehen und die fünf interessanten herausfiltern“.
Urteil: größtenteils widerlegt. Agenten sind Verstärker für Aufmerksamkeit, keine Entdeckungsquelle. Sobald man sie als Entdecker betrachtet, beginnt man, ihren negativen Ergebnissen zu vertrauen – „die Literaturrecherche hat nichts gefunden“ –, und genau dort liegt der Fehlermodus dieser Geschichte.
Mythos 3: Die geraden Kanten eines Vision-Agenten sind Ground Truth
Der Teil der Pipeline, den ich technisch am solidesten fand: Nachdem ein Vision-Agent den Hügel markiert hatte, blieb der Workflow nicht beim gerenderten Bild stehen. Er ging zurück zur Roh-Punktwolke und prüfte, ob die als Boden klassifizierten Rückstreuungen (im Gegensatz zu Kronenrückstreuungen) tatsächlich Platz, Pyramide und Innenhof nachzeichnen – unter 10 bis 17 Metern Wald. Das ist die wichtigste Gewohnheit in jeder geospatialen ML-Pipeline: Renderings lügen, Punkte nicht.
Warum die Paranoia? Die Bodenklassifikation in der Lidar-Verarbeitung ist selbst ein Modell, und unter dichtem tropischem Kronendach kann sie glatte Flächen interpolieren, wo kaum echte Rückstreuungen existieren. Ein „Platz“ kann also ein Artefakt des Bodenfindungsalgorithmus sein, der Ebenheit halluziniert. Auch die Vegetationsstruktur kann unheimlich lineare Lücken im Kronendach erzeugen, die sich in die Schummerungen fortpflanzen. Wer mit landesweiten Geodaten-Pipelines gearbeitet hat, wurde schon von Verarbeitungsartefakten hereingelegt, die bedeutungsvoller aussahen als das eigentliche Signal.
Deshalb die Prüfliste, auf der ich bestehen würde und der diese Geschichte größtenteils gefolgt ist:
- Das Merkmal in der Roh-Punktwolke bestätigen, entlang mindestens zweier Achsen geschnitten – nicht nur im gerenderten DTM.
- Mit mehreren Schummerungs-Azimuten rendern; Artefakte aus der Scanlinienrichtung verschwinden oder wandern, echte Strukturen nicht.
- Gegen eine zweite Datenquelle prüfen, falls vorhanden (andere Befliegung, anderes Jahr).
- Bekannte Erzeuger falsch positiver Ergebnisse herausfiltern: Dolinen (die Maya-Region ist Karst, voll davon), moderne Straßen, Spuren von Holzeinschlag und geologische Terrassen.
- Die Anomalie quantifizieren: Kantengeradheit, Eckwinkel, Plattformfläche im Vergleich zum regionalen Hintergrund. „Sieht rechteckig aus“ ist ein Gefühl; ein gemessenes Seitenverhältnis ist eine Aussage.
Die Pipeline hat die meisten davon bestanden. Und bemerkenswerterweise hat die physische Aussage standgehalten: Die Stätte ist real, Archäologen sind sich einig, dass es sich um ein Zentrum der Klassik-Periode handelt. Das Versagen geschah auf einer ganz anderen Achse.
Mythos 4: Die Literaturprüfung kann man delegieren
Dies ist der Mythos, den die Geschichte öffentlich an sich selbst widerlegt hat. Die Agenten durchsuchten die Literatur und das offizielle INAH-Register, fanden nichts und meldeten die Stätte als nicht registriert. Technisch stimmte das – sie stand nicht im INAH-Register. Aber ein im selben Jahr veröffentlichter, begutachteter Artikel hatte die Stätte kartiert, und die agentische Literatursuche ist daran vorbeigerauscht. Das Wort „Wiederentdeckung“ tauchte erst in der Schlagzeile auf, nachdem ein Fachexperte auf das Zitat hingewiesen hatte.
Wenn man Agenten gebaut hat, die Vorarbeiten oder Neuheit prüfen, dürfte einem das bekannt vorkommen. Die Literaturrecherche ist aus strukturellen Gründen die schwierigste Aufgabe zum Delegieren:
- Die Abdeckung ist unsichtbar. Ein Agent kann nicht sagen, worauf er nicht zugreifen konnte – Zeitschriften hinter Paywalls, PDFs in Hochschul-Repositorien, Arbeiten, in denen die Stätte als eine Koordinate in einer Tabelle auf Seite 14 steht. Genau dort stand diese Stätte.
- Negative Ergebnisse sind nicht falsifizierbar. „Nichts gefunden“ sieht gleich aus, egal ob nichts existiert oder die Suche oberflächlich war. Es gibt kein Fehlersignal.
- Aktuelle Veröffentlichungen hinken jedem Index hinterher. Ein Paper von 2025 ist vielleicht schlecht indexiert, von Suchwerkzeugen noch nicht erfasst oder nur über Konferenzvorträge und Preprint-Server bekannt.
- Räumliches Zuordnen ist ein eigenes Problem. Arbeiten veröffentlichen nicht immer Koordinaten; Stätten haben mehrere Namen; eine Abbildungsunterschrift lautet „Hügel nahe X“, und die Karte ist ein niedrig aufgelöstes Raster. Die Zuordnung des Kandidaten erfordert echtes geografisches Schlussfolgern.
Meine Regel aus der Produktions-ML-Arbeit: Agenten können Kandidatenaussagen erzeugen, aber die Neuheitsaussage – „noch niemand hat das berichtet“ – ist die eine Ausgabe, die man manuell prüft, mit der tiefsten Suche, die man aufbieten kann, bevor sie das Haus verlässt. Auch die Geoseite hat eine analoge Falle bei Koordinaten- und Grenzsystemen; wer sich mit Abwägungen bei räumlichen Indizes beschäftigt hat, weiß, dass „liegt dieser Punkt in diesem Datensatz?“ nie so einfach ist, wie es klingt.
Urteil: widerlegt, und zwar deutlich. Die physische Verifikation wurde in dieser Geschichte gut delegiert. Die Neuheitsverifikation wurde schrecklich delegiert. Entwerfen Sie Ihre Pipeline entsprechend: Automatisieren Sie die Suche, aber behandeln Sie „keine Vorarbeit gefunden“ als Entwurf, niemals als Schlussfolgerung.
Mythos 5: Die Verifikationsschleife besteht aus einem Schritt
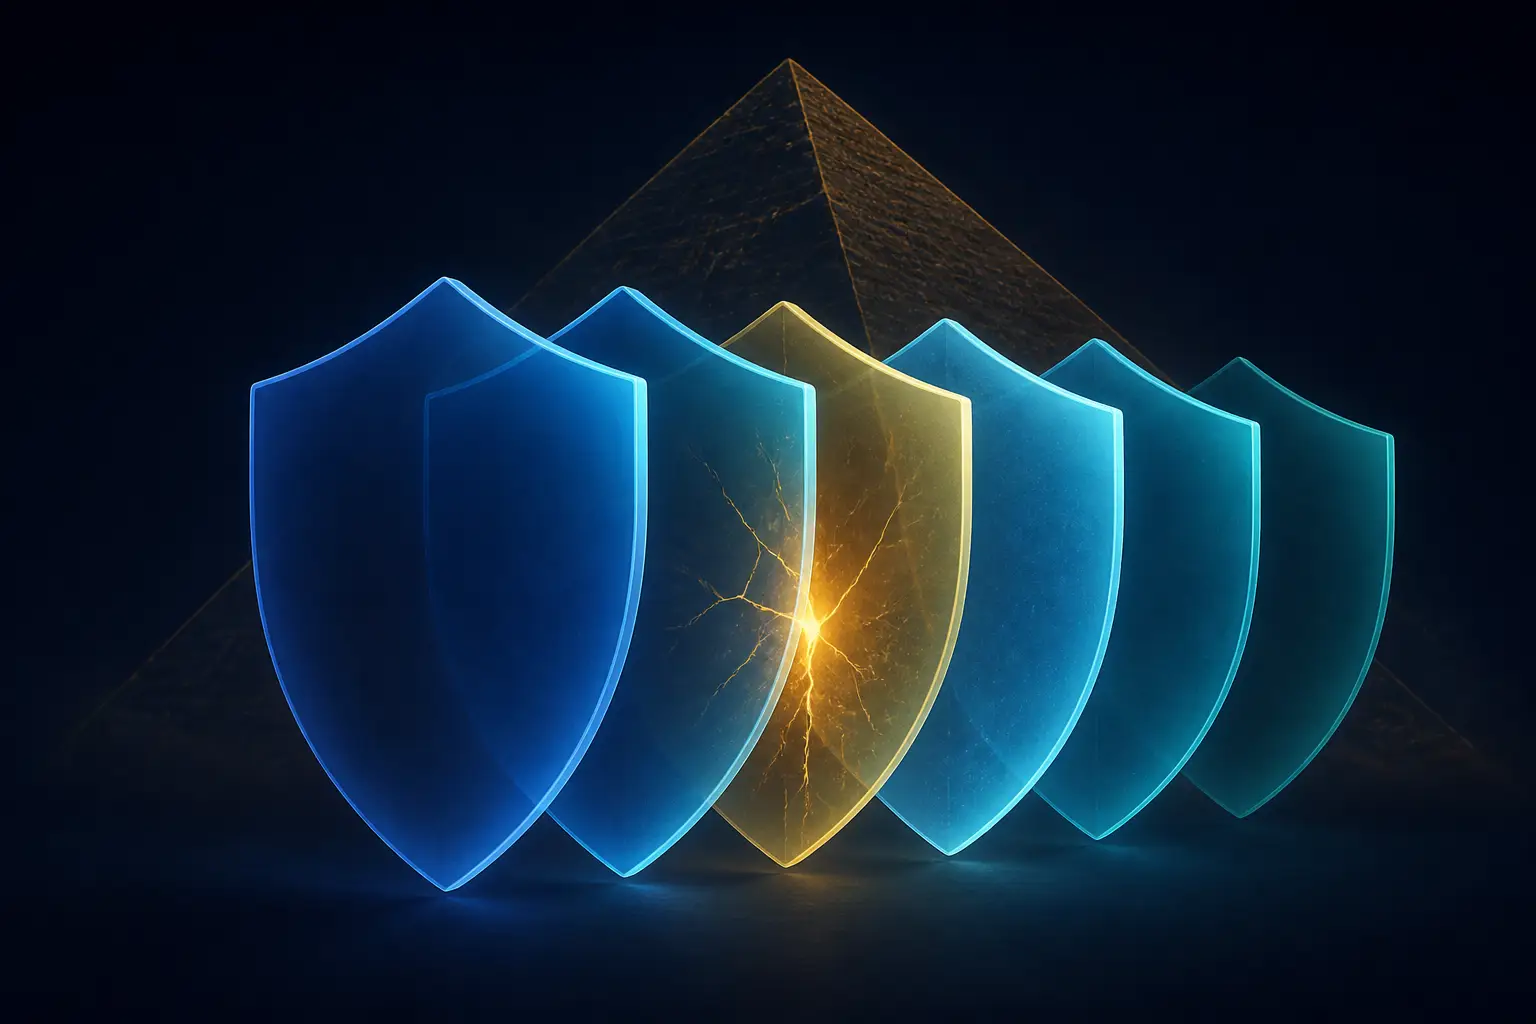
Am sinnvollsten liest man den ganzen 72-Stunden-Ablauf als geschichtete Verifikationsarchitektur, in der einige Schichten gehalten haben und eine zusammengebrochen ist. Es lohnt sich, die Schichten zu benennen, denn es sind dieselben, die man für jedes agentische System zur Aussageerzeugung bauen würde:
- Schicht 1 – Sensorprüfung. Stützen die Rohdaten das gerenderte Merkmal? (Punktwolken-Schnitte. Bestanden.)
- Schicht 2 – Unabhängige Agentenprüfung. Verschiedene Agenten mit unterschiedlichen Prompts prüfen die Kandidaten erneut; Abweichungen gehen an den Menschen. (Größtenteils bestanden; keine veröffentlichten Hinweise auf adversariales Prompting, was ich ergänzen würde.)
- Schicht 3 – Externe Instanz. Abfrage des offiziellen Registers – das INAH bestätigte, dass nichts registriert ist. (Bestanden, belegte aber nur die Abwesenheit im Register, nicht die Neuheit.)
- Schicht 4 – Vorarbeitensuche. (Gescheitert – das Übersichtspapier von 2025 wurde übersehen.)
- Schicht 5 – Fachexperte. Letztlich von der Community und den ursprünglichen Autoren geliefert, nach der Veröffentlichung. (Diese Schicht hat den Fehler gefunden.)
Die Lehre lautet nicht „Vertrau Agenten nicht“, sondern: Jede Schicht prüft eine andere Aussage, und das Bestehen von drei von fünf sagt nichts über die anderen beiden aus. Dass Schicht 3 bestanden hat, war hier sogar irreführend, denn „nicht im Register“ wurde im Kopf des Menschen zu „der Wissenschaft nicht bekannt“ befördert. Das ist ein Join-Fehler über zwei Datensätze mit unterschiedlicher Abdeckung, derselbe Fehlertyp wie die Annahme, eine PLZ-Grenze bedeute, was man denkt. Dem geht man in Abweichungen zwischen ZCTA- und USPS-Grenzen nach. Zwei scheinbar maßgebliche Quellen, stilles Widersprechen, selbstsicherer Fehlschluss.
Jede Schicht eines Verifikationsstapels prüft eine andere Aussage. Drei bestandene Schichten sagen nichts über die vierte aus.
Würde ich diese Pipeline härten, würde ich zwei günstige Mechanismen ergänzen. Erstens einen adversarialen Literaturdurchgang: ein eigener Agent, dessen einzige Aufgabe es ist, Neuheit zu widerlegen, mit aggressiveren Suchwerkzeugen und der Anweisung, frühere Arbeiten als existent anzunehmen. Zweitens eine Expertenrückfrage vor der Veröffentlichung: die Kandidatenliste an einen echten Fachspezialisten schicken, bevor etwas angekündigt wird. Die Reaktion der Community zeigt, dass Experten schnell bereit sind, sich einzubringen; die Korrektur kam innerhalb weniger Stunden nach dem Beitrag.
Was die Wiederentdeckung tatsächlich beweist
Ich verteidige das Ergebnis aber, weil ich finde, dass die Skeptiker die Fehleranalyse falsch bewertet haben. Ein Außenstehender mit Laptop und etwas Rechenleistung ist unabhängig auf dieselbe Stätte gestoßen, die ein professioneller Survey veröffentlicht hatte – mit öffentlichen Daten, in ein paar Nächten Agentenzeit. Wenn Ihre Triage-Pipeline bekannte Stätten wiederentdeckt, ist das ein Kalibrierungssignal, keine Peinlichkeit: Es bedeutet, dass der Detektor echte Empfindlichkeit hat. Sorgen müsste man sich eher machen, wenn er nur Dinge findet, die niemand je bestätigen könnte.
Das replizierbare Rezept, ohne die Abenteuererzählung:
- Eine Domäne wählen, in der öffentliche Sensordaten die menschliche Aufmerksamkeit bei Weitem übersteigen (Lidar ist der klassische Fall; die Erdbeobachtungsarchive der NASA sind ein weiterer).
- Rohdaten in hochwertige visuelle Renderings umwandeln – dieser Schritt ist wichtiger als die Modellwahl.
- Günstige Vision-Agenten fächern, geleitet von einer präzisen schriftlichen Rubrik mit Positiven und bekannten falsch positiven Ergebnissen.
- Überlebende Kandidaten gegen Rohdaten verifizieren, nicht gegen Renderings.
- Neuheit als eigene, vom Menschen geführte Verifikationsspur behandeln und Aussagen vor der Ankündigung über einen Fachexperten leiten.
Eine Beobachtung aus der Archäologie-Community verdient auch Aufmerksamkeit: Entdeckung ist nicht länger der Engpass – Verantwortung für den Erhalt ist es. Stätten, die schneller gefunden werden, als sie ausgegraben oder geschützt werden können, werden zu Plünderungszielen, und Koordinaten sind sensible Informationen (der Autor des Berichts hat sie zu Recht in einen vertraulichen Anhang gesetzt). Wer Entdeckungspipelines über sensible Domänen baut, sollte zuerst die Offenlegungsrichtlinie entwerfen. Verifikation betrifft nicht nur das Richtigliegen, sondern das verantwortungsvolle Richtigliegen.
Das ehrliche Fazit: Agentische Pipelines über öffentliche Geodaten können durchaus echte, überprüfbare Aussagen erzeugen, und der Trick mit dem Vision-Modell als Vermesser funktioniert besser, als die meisten Praktiker erwartet hätten. Aber die Aussage, die standhält, ist die, deren Verifikationsschleife für die Schicht entworfen wurde, die stillschweigend versagen kann. In dieser Geschichte haben die Lidar-Prüfungen gesungen und die Literaturprüfung geflüstert. Bauen Sie für das Flüstern.


