Archeologia lidar agentica: 5 miti verificati
Una pipeline di agenti AI ha segnalato un sito maya nei dati lidar. Testiamo 5 miti sull'archeologia lidar agentica e il vero ruolo del ciclo di verifica.
 Sarah Chen

Quarantotto agenti AI hanno scansionato durante la notte 1.200 km² di giungla con dati lidar e hanno segnalato un centro civico maya che non compariva nel registro ufficiale dei siti archeologici messicani. Poi è arrivata la parte scomoda: si è scoperto che gli archeologi avevano già mappato esattamente quel sito in un articolo del 2025, e gli agenti — e il loro operatore umano — non l'avevano trovato nella ricerca bibliografica. Questa storia, in piccolo, racchiude tutto ciò che serve sapere sull'archeologia lidar agentica: la pipeline di scoperta funziona davvero, mentre il ciclo di verifica non funziona affatto, a meno che non lo si costruisca nel modo giusto.
Ho passato anni a costruire pipeline di machine learning in cui il costo di un falso positivo era un ingegnere svegliato di notte, non un sito archeologico riportato erroneamente. Quindi prendo le cinque convinzioni che continuo a sentire su questo tipo di pipeline di scoperta agentica e le metto alla prova, una per una, confrontandole con quello che è successo davvero.
Mito 1: Per trovare rovine serve un modello addestrato su misura
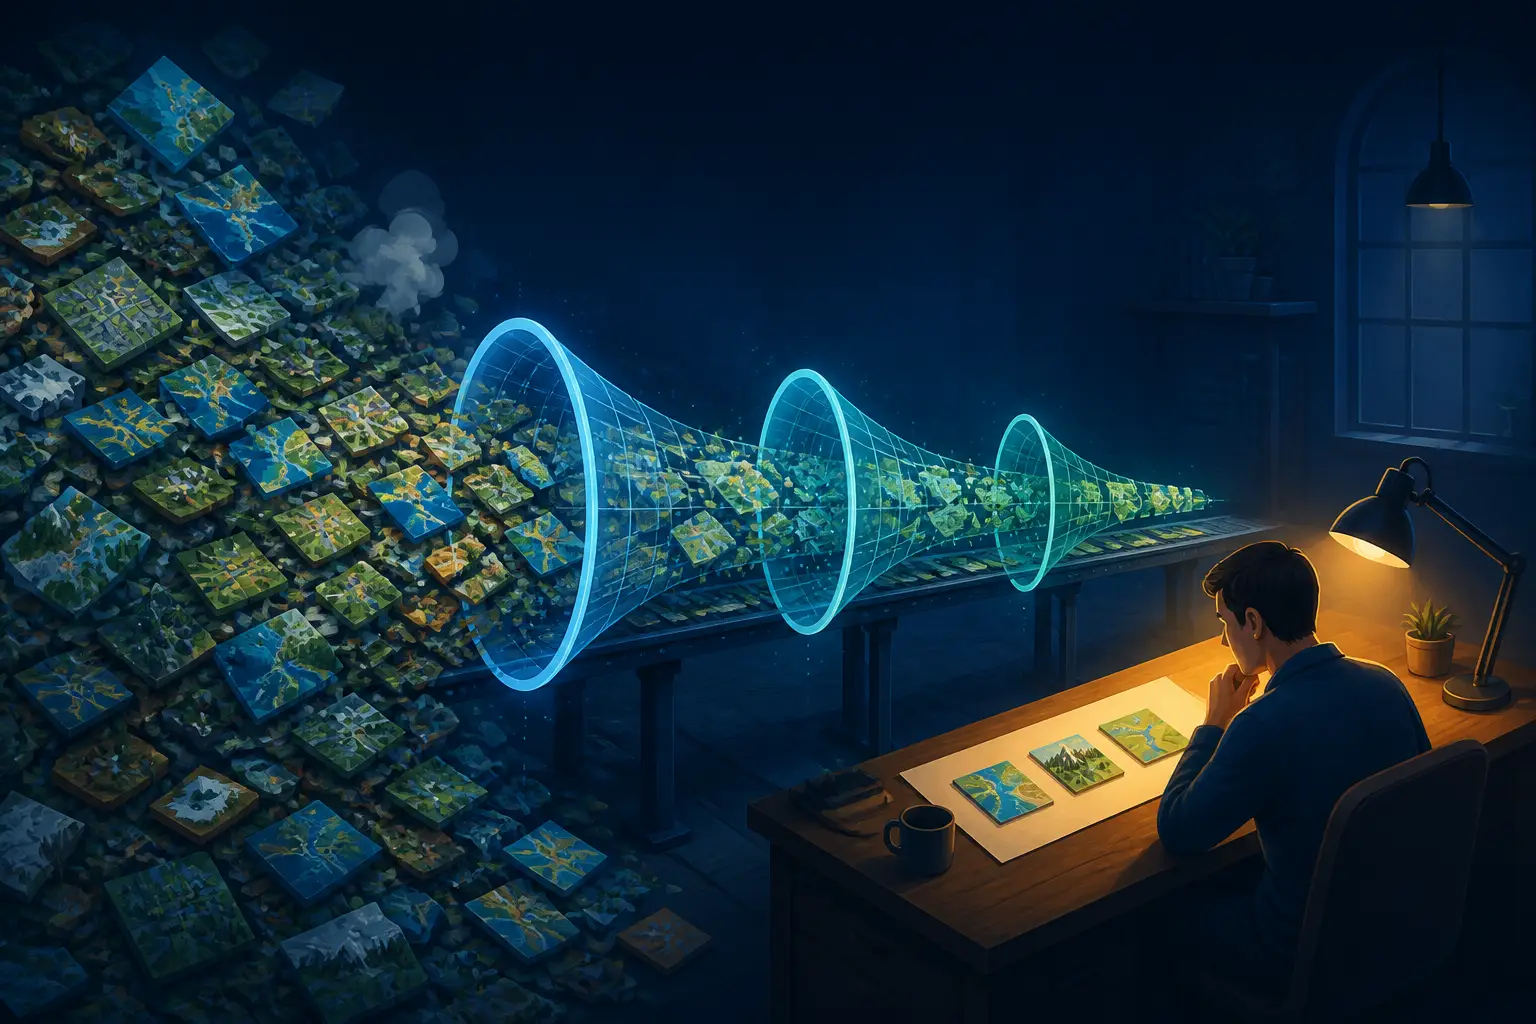
Il dettaglio più sorprendente di tutta la storia: non c'era nessun modello speciale. Nessuna CNN addestrata su piastrelle etichettate di piramidi, nessun rilevatore affinato. La pipeline ha convertito le strisce lidar in immagini in stile hillshade e ha fatto esaminare una per una a degli agenti visione-linguaggio generici, seguendo una guida scritta che descriveva come appaiono piramidi, piattaforme e piazze rispetto a colline, doline e strade.
Funziona perché i modelli di visione di frontiera hanno assorbito una enorme quantità di conoscenza visiva pregressa. Una piazza livellata con bordi dritti sotto la chioma della giungla è un problema di rilevamento di anomalie, e i VLM moderni sono degli ottimi individuatori di anomalie quando ricevono input renderizzati in modo pulito. Il trucco non sta nel modello, ma nel rendering. Le nuvole di punti lidar sono inutili per un modello di visione così come sono; bisogna convertirle in qualcosa di leggibile: modelli digitali del terreno, hillshade con più angolazioni del sole, mappe delle pendenze. Se la visualizzazione è corretta, un modello generalista diventa un topografo sorprendentemente competente.
Detto questo, è una frontiera che difendo con qualche riserva. Per il lavoro in produzione ad alto volume, un classificatore specializzato vince ancora in termini di costi e coerenza — ne abbiamo già parlato in CNN specializzate contro LLM di frontiera per la classificazione delle immagini. Far girare 48 sessioni di agenti su oltre mille piastrelle di immagini è costoso e non deterministico. Ma per l'esplorazione, dove stai generando ipotesi invece di gestire un servizio? L'approccio generalista con un buon prompt è pragmaticamente corretto, e non costa nulla in termini di dati di addestramento etichettati, che per compiti di archeologia di nicchia praticamente non esistono.
Verdetto: sfatato, con un asterisco. Non serve un modello su misura per generare candidati. Probabilmente lo vorrai se questa diventa un'operazione ripetuta e su larga scala.
Mito 2: Sono stati gli agenti a fare la scoperta
Leggi attentamente la cronologia e vedrai cosa hanno fatto davvero gli agenti: filtrare. La scoperta vera e propria era stata fatta anni prima dalle squadre che avevano volato con i lidar aerei, dai ricercatori che avevano pubblicato sul riuso dei dati lidar ambientali per l'archeologia e, in particolare, dagli autori dell'articolo di rassegna del 2025 che aveva già mappato proprio quella collina. Gli agenti hanno ridotto lo spazio di ricerca da 1.200 km² di giungla a una manciata di tessere candidate che una persona può controllare davanti a un caffè.
Non è una critica: a quella scala, filtrare è il vero collo di bottiglia in quasi tutte le scienze ricche di dati. Radioastronomia, fisica delle particelle, genomica: lo schema è sempre lo stesso. I sensori producono molti più dati di quanti un essere umano possa guardarne, quindi il ritmo delle scoperte è limitato dalla capacità di smistamento, non dalla disponibilità dei dati. È esattamente la dinamica dietro perché i benchmark AI non colgono gran parte del lavoro reale: il compito prezioso non è mai stato «essere intelligenti», ma «guardare un milione di cose noiose e far emergere le cinque interessanti».
Verdetto: perlopiù sfatato. Gli agenti sono moltiplicatori dell'attenzione, non fonti di scoperta. Nel momento in cui li inquadri come scopritori, inizi a fidarti dei loro risultati negativi — «la ricerca bibliografica non ha trovato nulla» — ed è lì che si annida il punto debole di questa storia.
Mito 3: I bordi dritti di un agente di visione sono verità di riferimento
Ecco la parte della pipeline che ho trovato tecnicamente più solida. Dopo che un agente di visione ha segnalato la collina, il flusso di lavoro non si è fermato all'immagine renderizzata. È tornato alla nuvola di punti grezza e ha verificato che i ritorni classificati come terreno (e non quelli della chioma) tracciassero davvero la piazza, la piramide e il cortile — sotto 10–17 metri di foresta. È l'abitudine più importante in qualsiasi pipeline di machine learning geospaziale: i rendering mentono, i punti no.
Perché tutta questa diffidenza? La classificazione del terreno nell'elaborazione lidar è a sua volta un modello, e sotto una chioma tropicale fitta può interpolare superfici lisce dove non ha quasi ritorni reali. Una «piazza» può essere un artefatto dell'algoritmo di ricerca del suolo che allucina una planarità inesistente. Anche la struttura della vegetazione può produrre vuoti nella chioma stranamente lineari che si propagano negli hillshade. Chiunque abbia lavorato con pipeline di dati geografici a scala nazionale si è scottato con artefatti di elaborazione che sembrano più significativi del segnale stesso.
Quindi la checklist di verifica che pretenderei, e che questa storia ha in gran parte seguito:
- Confermare la caratteristica nella nuvola di punti grezza, tagliata lungo almeno due assi, non solo in un DTM renderizzato.
- Renderizzare con più azimut dell'hillshade: gli artefatti dovuti alla direzione delle linee di scansione scompaiono o si spostano, le strutture reali no.
- Confrontare con una seconda fonte di dati, se esiste (un rilievo diverso, un anno diverso).
- Filtrare i noti generatori di falsi positivi: doline (la regione maya è carsica e ne è piena), strade moderne, cicatrici di disboscamento e terrazzamenti geologici.
- Quantificare l'anomalia: rettilineità dei bordi, angoli, area delle piattaforme rispetto allo sfondo regionale. «Sembra rettangolare» è un'impressione; un rapporto d'aspetto misurato è un'affermazione.
La pipeline ha superato la maggior parte di questi controlli. E, fatto notevole, la tesi fisica ha retto: il sito è reale, e gli archeologi concordano nel definirlo un centro civico del periodo Classico. Il cedimento è avvenuto su un asse completamente diverso.
Mito 4: Controllare la letteratura è un compito delegabile
Questo è il mito che la storia ha sfatato da sola, in pubblico. Gli agenti hanno cercato nella letteratura e nel registro ufficiale dell'INAH, non hanno trovato nulla e hanno riportato il sito come non registrato. Tecnicamente vero: non era nel registro dell'INAH. Ma un articolo sottoposto a revisione paritaria, pubblicato nello stesso anno, aveva mappato il sito, e la ricerca bibliografica agentica gli è sfilata accanto senza vederlo. Il termine «riscoperta» è entrato nel titolo solo dopo che un esperto del settore ha indicato la citazione.
Se hai costruito agenti che fanno una qualche forma di verifica dell'arte precedente o della novità, questo dovrebbe farti sussultare per il riconoscimento. La ricerca bibliografica è la cosa più difficile da delegare, per ragioni strutturali:
- La copertura è invisibile. Un agente non può dirti cosa non è riuscito ad accedere: riviste a pagamento, PDF dietro i repository universitari, articoli in cui il sito compare come una coordinata in una tabella a pagina 14. Ed è esattamente lì che si trovava questo sito.
- I risultati negativi non sono falsificabili. «Non ho trovato nulla» appare identico sia che non esista nulla, sia che la tua ricerca sia stata superficiale. Non c'è nessun segnale di errore.
- Le pubblicazioni recenti sono sempre in ritardo rispetto agli indici. Un articolo del 2025 può essere indicizzato male, non essere ripreso dagli strumenti di ricerca o essere noto solo attraverso interventi a convegni e server di preprint.
- L'abbinamento spaziale è un problema a sé. Gli articoli non sempre pubblicano le coordinate; i siti hanno più nomi; una didascalia dice «collina vicino a X» e la mappa è un raster a bassa risoluzione. Collegare il tuo candidato a tutto questo richiede un vero ragionamento geografico.
La regola che mi sono dato con il lavoro di ML in produzione: gli agenti possono generare affermazioni candidate, ma l'affermazione di novità — «nessuno ha mai segnalato questo» — è l'unico output che si verifica a mano, con la ricerca più approfondita possibile, prima che esca dall'azienda. Anche il lato geospaziale ha una trappola analoga con i sistemi di coordinate e i confini; chi ha affrontato i compromessi dell'indicizzazione spaziale sa che «questo punto è in questo dataset?» non è mai semplice come sembra.
Verdetto: sfatato, e senza pietà. In questa storia la verifica fisica è stata delegata bene. La verifica della novità è stata delegata malissimo. Progetta la pipeline di conseguenza: automatizza la ricerca, ma tratta «nessun lavoro precedente trovato» come una bozza, mai come una conclusione.
Mito 5: Il ciclo di verifica è un unico passaggio
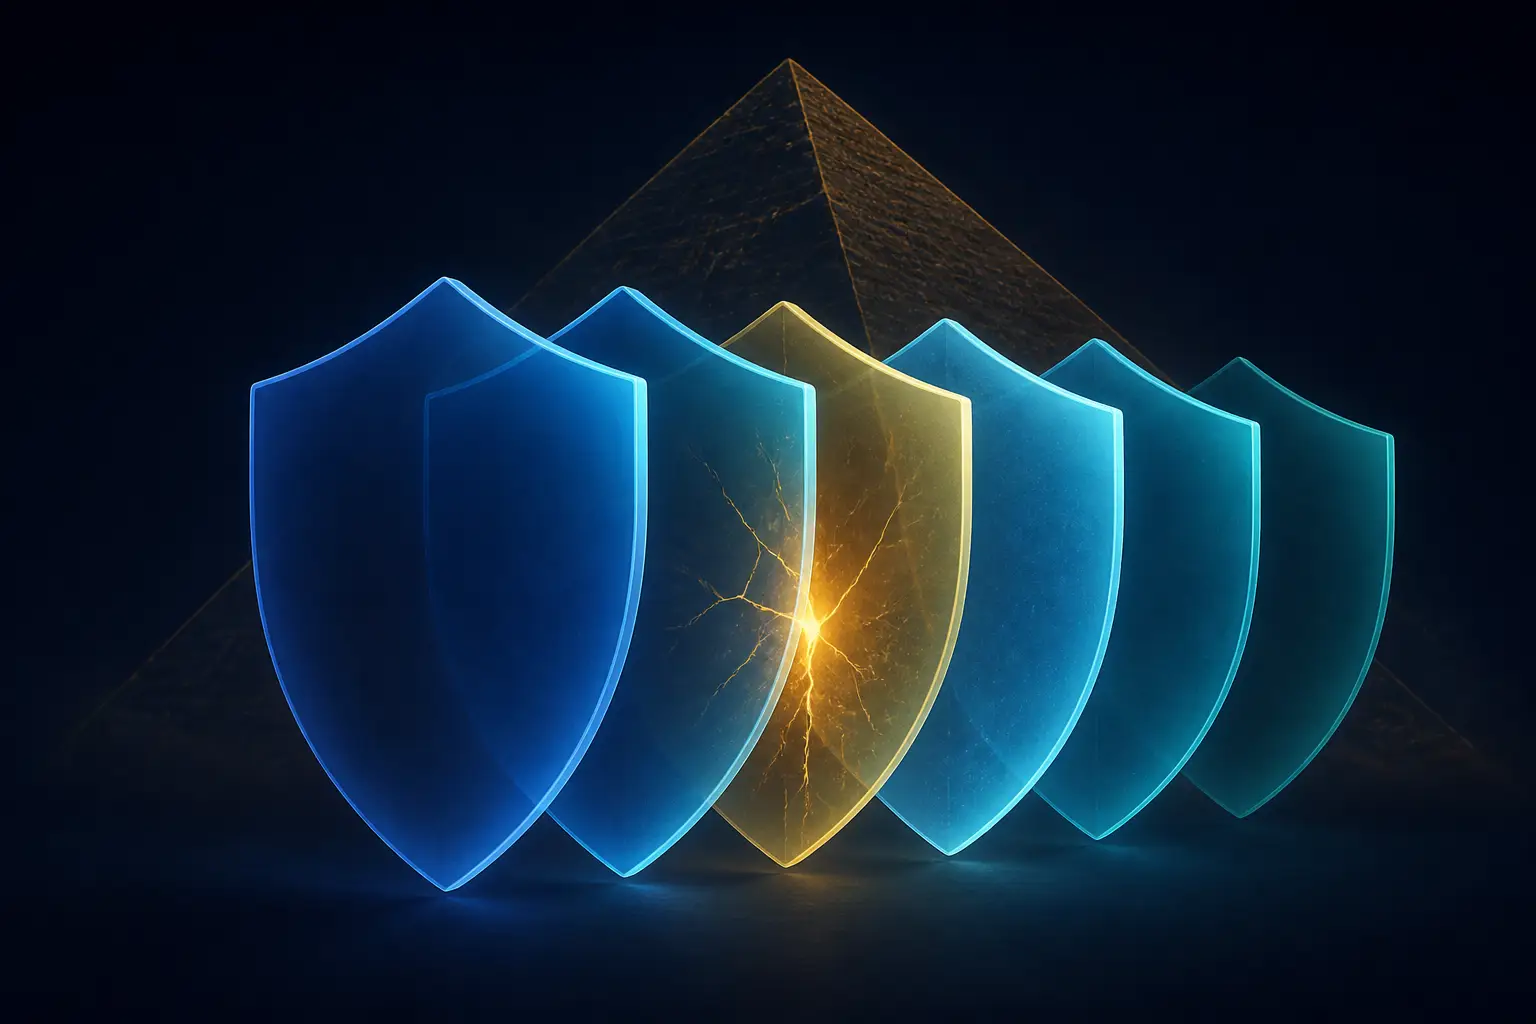
Il modo più utile per leggere l'intero arco delle 72 ore è come un progetto di verifica a strati, in cui alcuni livelli hanno tenuto e uno è crollato. Vale la pena dare un nome agli strati, perché sono gli stessi che costruiresti per qualsiasi sistema agentico di generazione di affermazioni:
- Livello 1 — Controllo a livello di sensore. I dati grezzi supportano la caratteristica renderizzata? (Sezioni della nuvola di punti. Superato.)
- Livello 2 — Revisione da parte di agenti indipendenti. Agenti diversi, prompt diversi, riesaminano i candidati; i disaccordi passano all'essere umano. (In gran parte superato; nessuna evidenza pubblicata di prompt avversariali, che io aggiungerei.)
- Livello 3 — Autorità esterna. Interrogazione del registro ufficiale: l'INAH ha confermato che non c'era nulla di registrato. (Superato, ma ha dimostrato solo l'assenza dal registro, non la novità.)
- Livello 4 — Ricerca di arte precedente. (Fallito: non ha trovato l'articolo di rassegna del 2025.)
- Livello 5 — Esperto del settore. Fornito in ultima istanza dalla comunità e dagli autori originali, dopo la pubblicazione. (È il livello che ha intercettato l'errore.)
La lezione non è «non fidarti degli agenti»: ogni livello verifica un'affermazione diversa, e superarne tre su cinque non ti dice nulla sugli altri due. Il superamento del livello 3 è stato fuorviante, perché «non nel registro» è diventato nella testa dell'operatore «non noto alla scienza». È un errore di join tra due dataset con copertura diversa, della stessa classe di bug che si ha quando si dà per scontato che un confine di codice postale significhi ciò che pensi — il genere di cose che approfondiamo in disallineamenti tra confini ZCTA e USPS. Due fonti dall'aspetto autorevole, un disaccordo silenzioso, una conclusione sbagliata ma sicura di sé.
Ogni livello di uno stack di verifica controlla un'affermazione diversa. Superare tre livelli non ti dice nulla sul quarto.
Se dovessi irrobustire questa pipeline, aggiungerei due meccanismi economici. Primo, un passaggio avversariale sulla letteratura: un agente separato il cui unico compito è smentire la novità, dotato di strumenti di ricerca più aggressivi e con istruzioni di partire dal presupposto che un lavoro precedente esista. Secondo, un confronto con un esperto prima della pubblicazione: inviare la lista dei candidati a un vero specialista del settore prima di annunciare qualsiasi cosa. La reazione della comunità dimostra che gli esperti sono pronti a intervenire rapidamente; la correzione è arrivata entro poche ore dalla pubblicazione del post.
Cosa dimostra davvero la riscoperta
Il risultato, però, lo difendo, perché penso che gli scettici abbiano sbagliato l'analisi del fallimento. Un outsider con un laptop e un po' di calcolo è arrivato in modo indipendente allo stesso sito che un rilievo professionale aveva pubblicato, usando dati pubblici, in un paio di notti di tempo macchina degli agenti. Se la tua pipeline di smistamento riscopre siti noti, è un segnale di calibrazione, non un imbarazzo: significa che il rilevatore ha una sensibilità reale. Dovresti preoccuparti molto di più se facesse emergere solo cose che nessuno potrebbe mai confermare.
La ricetta replicabile, privata della narrazione avventurosa:
- Scegli un dominio in cui i dati dei sensori pubblici superano di gran lunga l'attenzione umana (il lidar è il caso canonico; gli archivi di scienze della Terra della NASA sono un altro esempio).
- Converti i dati grezzi in rendering visivi di alta qualità: questo passaggio conta più della scelta del modello.
- Distribuisci agenti di visione economici con una rubrica scritta e precisa di positivi e falsi positivi noti.
- Verifica i sopravvissuti sui dati grezzi, non sui rendering.
- Tratta la novità come una traccia di verifica separata e guidata da esseri umani, e fai passare le affermazioni per un esperto del settore prima di annunciarle.
C'è un'altra cosa sollevata dalla comunità archeologica su cui vale la pena riflettere: la scoperta non è più il collo di bottiglia, lo è la tutela. I siti trovati più in fretta di quanto possano essere scavati o protetti diventano bersagli di saccheggi, e le coordinate sono informazioni sensibili (l'autore del rapporto ha fatto bene a metterle in un allegato riservato). Se costruisci pipeline di scoperta su domini sensibili, costruisci per prima cosa la politica di divulgazione. La verifica non riguarda solo avere ragione; riguarda avere ragione in modo responsabile.
Il riassunto onesto: le pipeline agentiche su dati geospaziali pubblici possono senza dubbio generare affermazioni reali e verificabili, e il trucco del modello di visione come topografo funziona meglio di quanto la maggior parte dei praticanti si aspettasse. Ma l'affermazione che sopravvive è quella il cui ciclo di verifica è stato progettato per lo strato che cede in silenzio. In questa storia, i controlli lidar hanno cantato e il controllo bibliografico ha sussurrato. Costruisci per il sussurro.


