エージェント型LiDAR考古学:5つの神話を検証
AIエージェントのパイプラインが一晩でマヤ遺跡を検出。エージェント型LiDAR考古学の5つの通説を実際に試し、検証ループの実態を解説します。
 Sarah Chen

48体のAIエージェントが一晩で1,200平方キロメートルのジャングルのLiDARデータを走査し、メキシコの公式な考古学台帳に載っていないマヤの市民センターを検出しました。そして厄介なことが起きます。研究者たちは2025年の論文で、まさにその遺跡をすでに地図化していたのです。エージェントも、その背後にいた人間も、文献調査でそれを見落としていました。この出来事を一言で言えば、エージェント型LiDAR考古学について知るべきことがすべて詰まっています。発見のパイプラインは確かに機能する。しかし、適切に作り込まない限り、検証ループは機能しない、ということです。
私は長年、偽陽性のコストがエンジニアのページ呼び出しで済んでいたMLパイプラインを作ってきました。ですから、この種のエージェント型発見パイプラインについて私が繰り返し目にする5つの思い込みを取り上げ、実際に起きたことと照らし合わせて一つずつ検証します。
神話1:遺跡を見つけるには独自に学習させたモデルが必要
この話でもっとも意外な点は、特別なモデルが一切使われていないことです。ピラミッドのラベル付きタイルで学習させたCNNもなければ、ファインチューニングした検出器もありません。パイプラインはLiDARのストリップデータをヒルシェード風の画像に変換し、汎用の視覚言語エージェントが一枚ずつ確認しました。その際、ピラミッド、基壇、広場がどう見えるかを、丘、陥没穴、道路と比べて説明した文書ガイドに従わせています。
これがうまくいくのは、最新の視覚基盤モデルが膨大な視覚的事前知識をすでに身につけているからです。ジャングルの樹冠の下にある直線的な縁を持つ平坦な広場は、異常検出の問題であり、クリーンなレンダリング画像を与えれば、最新のVLMは十分に優れた異常検出器として機能します。肝はモデルではなくレンダリングです。LiDARの点群は視覚モデルにとってそのままでは役に立ちません。数値標高モデル、複数の太陽角度によるヒルシェード、傾斜マップなど、読み取れる形に変換する必要があります。可視化を正しく行えば、汎用モデルでも驚くほど有能な測量士になります。
とはいえ、これは条件付きで擁護するフロンティアです。大量の本番処理では、専用の分類器が依然としてコストと一貫性の面で勝ります。このトレードオフは以前画像分類における専用CNNとフロンティアLLMの比較で取り上げました。千枚を超える画像タイルに対して48のエージェントセッションを走らせるのは高くつき、結果も非決定的です。しかし、運用するサービスではなく仮説を生成する探索段階であれば?汎用モデルと適切なプロンプトによるアプローチは実用的に正しく、ラベル付き学習データのコストもかかりません。ニッチな考古学のタスクでは、そもそもそんなデータはほとんど存在しないのですから。
判定:誤り(但し条件付き)。候補を生成するだけなら独自モデルは不要です。ただし、これが繰り返し行われるスケールの大きな作業になるなら、おそらく必要になるでしょう。
神話2:発見したのはエージェントだ
タイムラインを注意深く読むと、エージェントが実際に行ったことが見えてきます。それはフィルタリングです。発見そのものは、何年も前に機上LiDARの調査チーム、環境用LiDARを考古学に再利用する研究を発表した研究者たち、そして特にこの丘をすでに地図化していた2025年のサーベイ論文の著者たちによってなされていました。エージェントは1,200平方キロメートルのジャングルから、人間がコーヒーを飲みながら確認できる程度の候補タイルへと探索範囲を絞り込んだのです。
これは批判ではありません。この規模でのフィルタリングこそ、多くのデータ駆動型の科学における実際のボトルネックです。電波天文学、素粒子物理学、ゲノミクス、どれもパターンは同じです。センサーは人間が見きれないほど多くのデータを生成するため、発見の速度はデータの有無ではなく、トリアージの処理能力によって制限されます。これはまさにAIベンチマークが実際の仕事の大半を捉えられない理由と同じ力学です。価値のあるタスクは「賢いこと」ではなく、「退屈なものを百万個見て、面白いものを五つ浮かび上がらせること」だったのです。
判定:概ね誤り。エージェントは注意力の増幅装置であり、発見の源ではありません。エージェントを発見者と見なした瞬間、その否定的な結果、つまり「文献調査では何も見つからなかった」を信頼し始めてしまいます。この話の失敗モードはまさにそこにあります。
神話3:視覚エージェントが示す直線の縁は確かな事実だ
パイプラインの中で私がもっとも技術的に堅実だと感じた部分がここです。視覚エージェントが丘を検出した後、ワークフローはレンダリング画像で止まりませんでした。生の点群に戻り、地上に分類された反射点(樹冠からの反射点とは区別される)が、10〜17メートルの森林の下で本当に広場、ピラミッド、中庭をなぞっているかを確認したのです。これは、あらゆる地理空間MLパイプラインにおいてもっとも重要な習慣です。レンダリングは嘘をつくが、点は嘘をつかない。
なぜそこまで慎重になるのか。LiDAR処理における地面分類そのものがモデルであり、密な熱帯の樹冠の下では、実際の反射点がほとんどないところで滑らかな面を補間してしまうことがあります。「広場」が、地面を探すアルゴリズムが平坦さを幻覚的に生み出した産物である可能性があるのです。植生の構造も、不気味なほど直線的な樹冠の隙間を生み、それがヒルシェードに反映されることがあります。国レベルの地理データパイプラインを扱ったことがある人なら、シグナルよりも意味ありげに見える処理アーティファクトに痛い目を見た経験があるでしょう。
私が求める検証チェックリストは次のとおりで、この話もおおむねこれに沿っていました。
- レンダリングされたDTMだけでなく、少なくとも二つの軸で切り出した生の点群で特徴を確認する。
- 複数のヒルシェード方位角でレンダリングする。スキャンラインの方向によるアーティファクトは消えるか移動するが、実在する構造物はそのままである。
- 別のデータソース(別の測量、別の年)があれば、それと照合する。
- 既知の偽陽性を生む要因を除外する。マヤ地域はカルスト地形で陥没穴が多く、そのほか現代の道路、伐採跡、地質学的な段丘も含まれる。
- 異常を数値化する。縁の直線性、角度、基壇の面積と周辺の背景との比較を行う。「長方形っぽく見える」は印象にすぎず、測定された縦横比こそが主張の根拠になる。
パイプラインはこれらのほとんどを通過しました。そして注目すべきことに、物理的な主張は裏付けられました。その場所は実在し、考古学者も古典期の市民センターであることに同意しています。失敗は、まったく別の軸で起きたのです。
神話4:文献調査は委任できるタスクだ
これは、この話が公の場で自ら崩した神話です。エージェントは文献と公式のINAH台帳を検索し、何も見つからなかったため、その遺跡は未登録だと報告しました。技術的には正しいです。INAHの台帳には載っていなかったのですから。しかし、同じ年に査読付き論文がその遺跡を地図化しており、エージェントによる文献検索はそれを素通りしていました。「再発見」という見出しは、専門家が引用を指摘して初めて登場したのです。
先行技術や新規性の確認を行うエージェントを作ったことがあるなら、この話には身に覚えがあるはずです。文献調査は、構造的な理由から、もっとも委任が難しいタスクです。
- カバレッジは見えない。エージェントは、アクセスできなかったものを教えてくれません。有料の学術誌、大学リポジトリの背後にあるPDF、遺跡が14ページ目の表の一つの座標としてしか載っていない論文など。まさにこの遺跡がそうでした。
- 否定的な結果は反証できない。「何も見つからなかった」は、本当に存在しないのか、検索が浅かったのかに関係なく同じように見えます。エラーのシグナルは存在しません。
- 新しい論文はどの索引でも遅れる。2025年の論文は、インデックスが不十分であったり、検索ツールに拾われなかったり、学会発表やプレプリントサーバーでしか知られていなかったりすることがあります。
- 空間的なマッチングは別の問題である。論文が常に座標を公開しているとは限らず、遺跡には複数の名称があり、図の説明に「Xの近くの丘」と書かれ、地図が低解像度のラスタ画像であることもあります。候補地をそれに照合するには、地理に関する実際の推論が必要です。
本番のMLの仕事から得た私のルールはこうです。エージェントは候補となる主張を生成できますが、新規性の主張、つまり「これを報告した者はいない」は、最も深い検索を尽くして人間が手作業で検証し、外部に出す前に確認すべき唯一の出力です。地理空間の分野にも、座標系や境界系に関する同様の罠があります。空間インデックスのトレードオフに取り組んだことがある人なら、「この点はこのデータセットに含まれるか」が見た目ほど単純ではないと知っているでしょう。
判定:完全に誤り、かなり深刻。この話では、物理的な検証は適切に委任されていました。一方、新規性の検証は酷いものでした。それに応じてパイプラインを設計してください。検索は自動化してかまいませんが、「先行研究は見つからなかった」は結論ではなく、下書きとして扱うべきです。
神話5:検証ループは一段階で済む
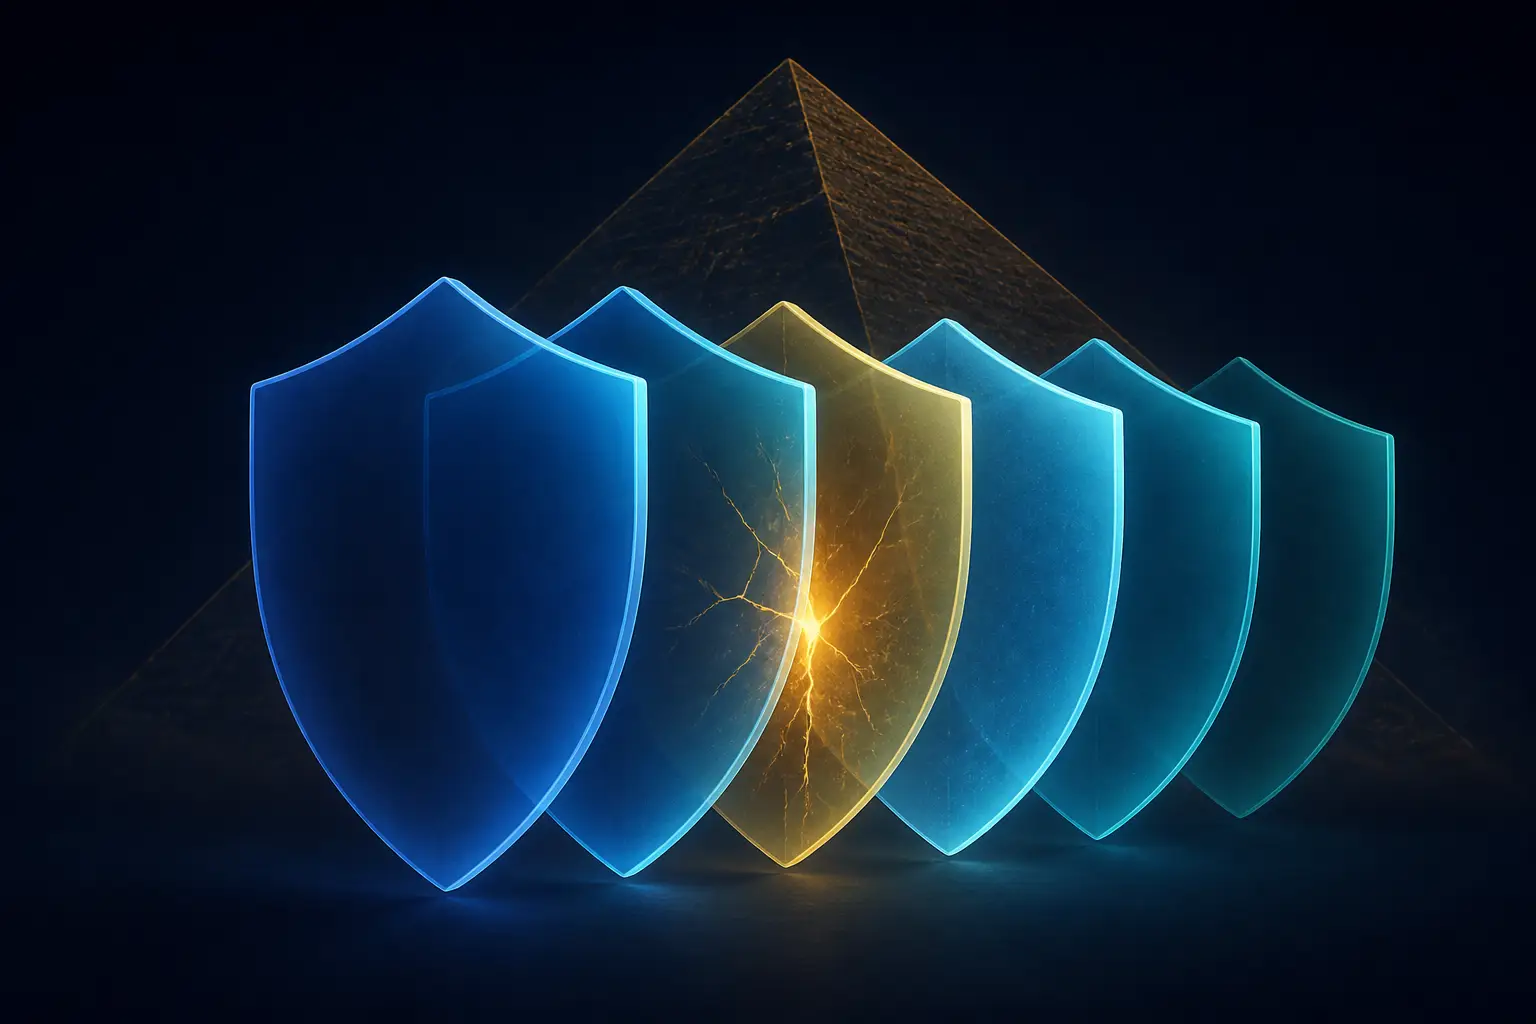
72時間にわたる一連の流れを読み解く有効な方法は、多層的な検証設計として見ることです。そこでは、いくつかの層は機能し、一つの層は崩壊しました。どの層がどういう役割を持っていたかを名前付けしておく価値があります。エージェントによる主張生成システムを作るなら、同じ層を作ることになるはずだからです。
- 第1層 ― センサーレベルの確認。生データはレンダリングされた特徴を裏付けているか?(点群の断面。合格。)
- 第2層 ― 独立したエージェントによるレビュー。異なるエージェントが、異なるプロンプトで候補を再検討し、意見が割れた場合は人間に回す。(概ね合格。ただし敵対的なプロンプトを使った公表された証拠はなく、これは追加すべきだと考えます。)
- 第3層 ― 外部の権威による確認。公式の台帳に問い合わせ、INAHは未登録であることを確認した。(合格だが、登録されていないことを証明しただけで、新規性は証明していない。)
- 第4層 ― 先行研究の検索。(失敗。2025年のサーベイ論文を見逃した。)
- 第5層 ― 分野の専門家。最終的には、公開後にコミュニティと原著者が提供した。(誤りを捉えたのはこの層でした。)
教訓は「エージェントを信用するな」ではありません。各層は異なる主張を検証しており、五つのうち三つが合格しても、残りの二つについては何も教えてくれないということです。ここでは第3層の合格がむしろ誤解を招きました。「台帳に載っていない」が、人間の頭の中では「科学的に知られていない」へとすり替えられたのです。これは、カバレッジの異なる二つのデータセットの結合エラーであり、ZIPコードの境界が自分の思っている意味を持つと仮定してしまうバグと同じ種類です。ZCTAとUSPS境界の不一致で掘り下げたような問題です。権威があるように見える二つの情報源が、静かに食い違い、確信に満ちた誤った結論に至ったのです。
検証スタックの各層は、それぞれ異なる主張を検査している。三つの層が通過しても、四つ目の層について何も教えてはくれない。
私がこのパイプラインを強化するなら、安価な仕組みを二つ加えます。第一に、敵対的な文献検査です。新規性を否定することだけを目的とする別のエージェントを用意し、より攻撃的な検索ツールを与え、先行研究が存在すると仮定するよう指示します。第二に、公表前の専門家への事前確認です。何かを発表する前に、候補リストを実在する分野の専門家一人に送ります。今回のコミュニティの反応は、専門家が迅速に関わってくれることを示しており、投稿の公開から数時間以内に訂正が届きました。
再発見が実際に証明したこと
とはいえ、結果そのものは擁護したいと思います。懐疑派は失敗の分析を誤っていると考えるからです。ノートPCと少しの計算資源を持った部外者が、公開データを使い、数晩分のエージェントの作業時間で、専門の調査が発表したのと同じ遺跡に独立して行き着いたのです。トリアージのパイプラインが既知の遺跡を再発見するなら、それは恥ずかしいことではなく校正のシグナルです。検出器に実際の感度があることを意味します。むしろ、誰にも確認できないものだけを見つけていたなら、そちらを心配すべきでした。
冒険談を取り除いた、再現可能な手順は次のとおりです。
- 公開されたセンサーデータが人間の注意力を大きく上回る分野を選ぶ(LiDARは典型例で、NASAの地球科学アーカイブもその一つです)。
- 生データを高品質な視覚的レンダリングに変換する。このステップはモデルの選択よりも重要です。
- 安価な視覚エージェントを多数並列で走らせ、正例と既知の偽陽性について精密に書かれたルーブリックを与える。
- 生き残った候補は、レンダリング画像ではなく生データに照らして検証する。
- 新規性は独立した、人間が主導する検証のトラックとして扱い、公表前に分野の専門家を通す。
考古学コミュニティが指摘したもう一つの点も、じっくり考える価値があります。発見はもはやボトルネックではなく、保全こそがボトルネックになっているということです。発掘や保護が追いつかないほど速く発見される遺跡は、盗掘の標的になります。また、座標は機微な情報です(報告書の著者が座標を機密の附属書に入れたのは正しい判断でした)。機微な領域で発見パイプラインを構築するなら、まず開示のポリシーを作ってください。検証は正しくあることだけでなく、責任を持って正しくあることでもあるのです。
率直にまとめると、公開された地理空間データに対するエージェント型パイプラインは、現実の検証可能な主張を確実に生み出せますし、「視覚モデルを測量士として使う」という手法は、多くの実務家の予想を上回る成果を出しています。しかし、生き残る主張は、静かに失敗する層のために設計された検証ループを持つものだけです。この話では、LiDARの検査は順調に機能し、文献の検査は小声で警告していました。その小声の警告に備えて作ってください。


