智能体激光雷达考古:五个误区实测
一套AI智能体流水线连夜在激光雷达数据中标出一处玛雅遗址。我们实测智能体激光雷达考古的五个误区,并看看验证闭环究竟起了什么作用。
 Sarah Chen

一夜之间,48个AI智能体扫描了1200平方公里的丛林激光雷达数据,标记出一处不在墨西哥官方考古名录中的玛雅公共建筑群。接下来尴尬的部分出现了:考古学家早在2025年的一篇论文中就测绘过这个确切的遗址,而智能体以及它们背后的人类,在文献检索中漏掉了它。这个故事浓缩了智能体激光雷达考古的全部要点:发现流水线确实有效,而验证闭环如果没有认真搭建,确实无效。
我做了多年机器学习流水线,那里的误报成本是半夜被呼醒的工程师,而不是一条错误的考古记录。所以我想把我反复听到的关于这类智能体发现流水线的五个说法拿出来,逐一对照这次实际发生的事情来检验。
误区一:找遗迹必须训练定制模型
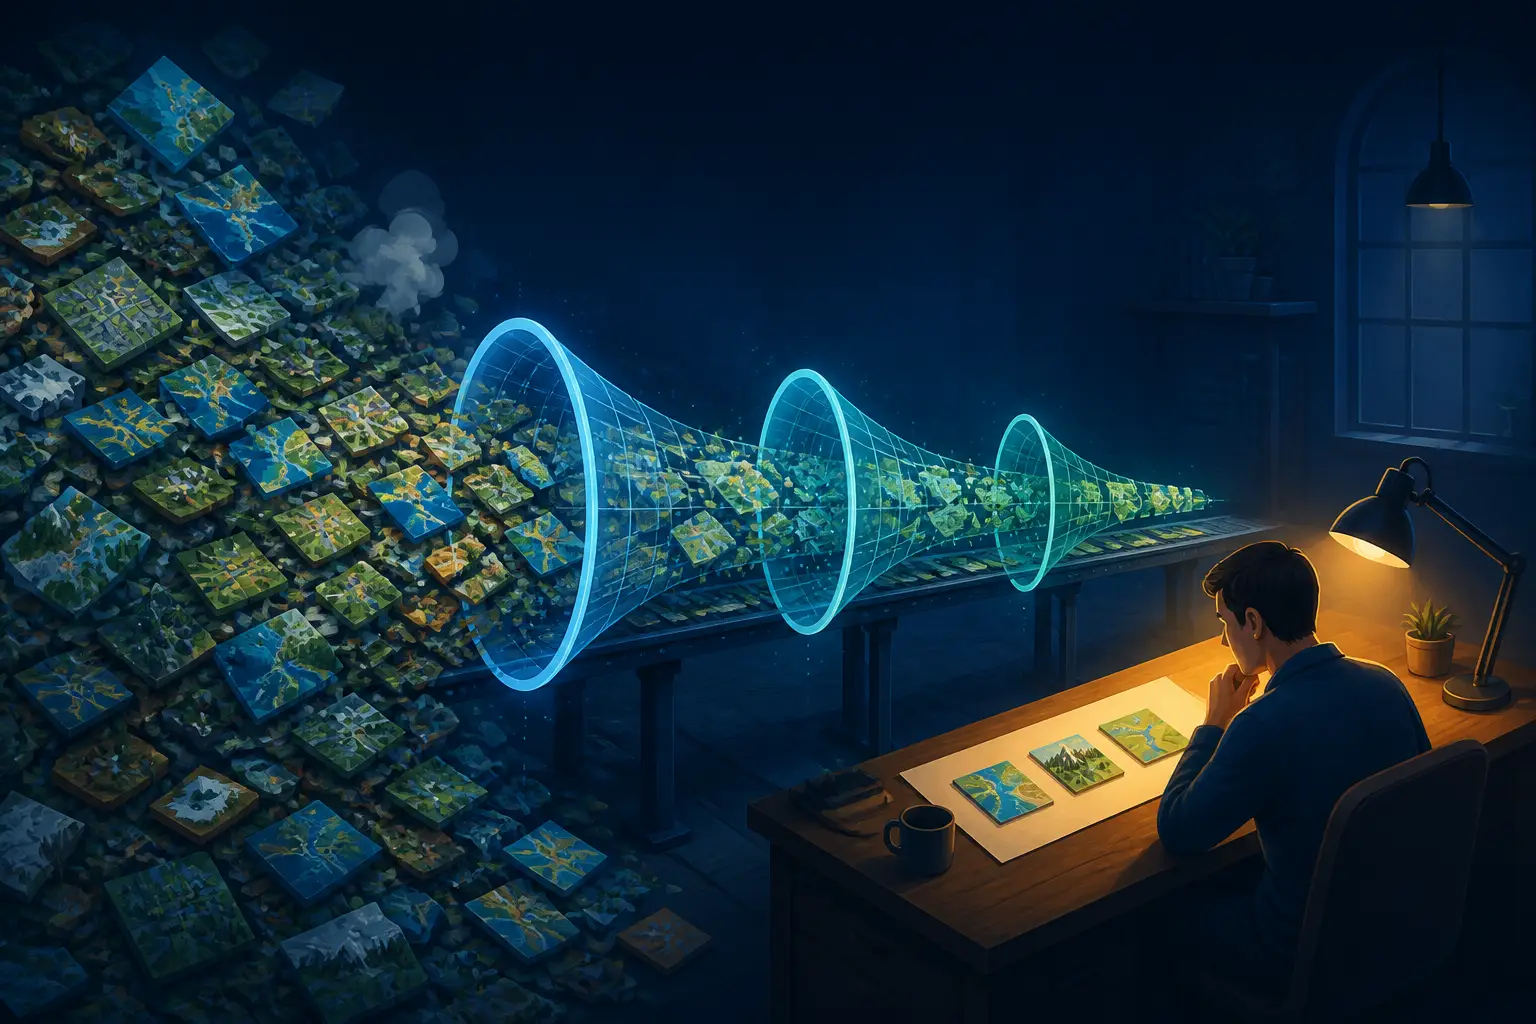
整个故事里最出人意料的细节是:根本没有用什么专用模型。没有在标注过的金字塔图块上训练的CNN,也没有经过微调的检测器。流水线把激光雷达数据条带转换成类似山影图的图像,然后让通用视觉语言智能体逐张查看,依据一份书面指南来判断:什么样子是金字塔、平台和广场,什么样子是山丘、天坑和道路。
这之所以行得通,是因为前沿视觉模型已经吸收了大量视觉先验知识。丛林树冠下一块平整、边缘笔直的场地,本质上是一个异常检测问题,而现代VLM在拿到干净的渲染输入时,本身就是不错的异常侦测器。关键不在模型,而在渲染。激光雷达点云本身对视觉模型毫无用处,必须转换成可读的形式:数字地形模型、多光照角度的山影图、坡度图。把可视化做对,通用模型就能成为相当称职的测绘员。
不过,这个方向我只敢带着保留意见来支持。在高频、生产级的工作中,专用分类器在成本和一致性上依然更胜一筹,我们之前在专用CNN与前沿大模型做图像分类一文中讨论过这个取舍。对上千个图块运行48次智能体会话,既昂贵又不确定。但如果目标是探索,也就是生成假设而不是运营一项服务呢?通用模型加好提示词的做法在工程上是正确的,而且不需要标注训练数据,对于这类小众的考古任务来说,这种数据本来就几乎不存在。
结论:不成立,但有附加条件。生成候选目标不需要定制模型。如果这件事变成反复进行、规模化的操作,你大概率还是需要一个定制模型。
误区二:发现遗迹的是智能体
仔细看时间线,就能看清智能体实际做了什么:它们做的是筛选。真正的发现早在几年前就完成了,由机载激光雷达团队、那些研究如何将环境激光雷达用于考古的研究者完成,尤其是2025年那篇综述论文的作者,他们早已测绘过这座山顶。智能体把搜索范围从1200平方公里的丛林,压缩到几个候选图块,人类喝杯咖啡的工夫就能逐一查看。
这并不是在贬低它们。在大多数数据密集型科学中,这种规模下的筛选恰恰是真正的瓶颈:射电天文、粒子物理、基因组学,模式都一样。传感器产生的数据远超人类能看完的量,因此发现速率受限于分诊的吞吐量,而不是数据是否可得。这正是为什么AI基准测试漏掉了大部分真实工作背后的逻辑:有价值的任务从来不是“变聪明”,而是“看完一百万件无聊的东西,挑出其中五件有意思的”。
结论:基本不成立。智能体是注意力的倍增器,而不是发现的来源。一旦你把它们当成发现者,你就会开始相信它们的否定结果,比如“文献检索没找到”,而这个故事的失败模式恰恰就藏在这里。
误区三:视觉智能体看到的直线边缘就是地面真值
这条流水线中我觉得技术上最扎实的一环是:视觉智能体标记出山顶之后,工作流并没有停在渲染图上。它回到原始点云,检查被归类为地面的回波(区别于树冠回波)是否真的勾勒出了广场、金字塔和庭院,而这些都在10到17米的森林之下。这是任何地理空间机器学习流水线中最重要的习惯:渲染图会骗人,点云不会。
为什么要这么多疑?激光雷达处理中的地面分类本身就是一个模型,而在茂密的热带树冠下,它可能在几乎没有真实回波的地方插值出平滑的表面。一个“广场”很可能只是地面滤波算法凭空“脑补”出来的平整感。植被结构也会产生异常规整的线性林窗,并一路传递到山影图中。凡是处理过国家尺度地理数据流水线的人,都吃过这类处理伪影的亏,它们看起来比真实信号还要有意义。
我会坚持要求的验证清单如下,而这个故事基本也遵循了它:
- 在原始点云中确认该特征,至少沿两个轴切片观察,而不只看渲染出的数字地形模型。
- 用多个山影方位角渲染;扫描线方向造成的伪影会消失或移位,真实结构则不会。
- 如果存在第二数据源(不同的测量、不同的年份),进行交叉核对。
- 过滤已知的误报来源:天坑(玛雅地区是喀斯特地貌,遍布天坑)、现代道路、伐木痕迹和地质阶地。
- 量化异常:边缘直线度、拐角角度、平台面积与区域背景的对比。“看起来是方形的”只是一种感觉;测得的长宽比才是一个论断。
这条流水线通过了其中大部分检验。值得注意的是,实体层面的论断站得住脚:这处遗址是真实存在的,考古学家一致认为它是古典时期的公共建筑群。问题出在完全不同的另一个维度上。
误区四:查文献可以交给智能体去做
这正是这个故事自己公开打破的误区。智能体检索了文献和INAH官方名录,没有找到任何记录,于是把该遗址报告为未登记。从技术上讲这没错,它确实不在INAH名录中。但同一年,一篇同行评审论文已经测绘过这座遗址,而智能体的文献检索却与它擦肩而过。“重新发现”这个说法,是在一位领域专家指出那条引文之后才进入标题的。
如果你构建过任何做先前技术检索或新颖性检查的智能体,这一段应该会让你心里一紧,产生强烈的共鸣。文献检索恰恰是最难交给别人(或别的系统)做的事情,原因在结构上:
- 覆盖范围是不可见的。智能体无法告诉你它没能访问到什么,比如付费期刊、藏在大学知识库里的PDF,或者把遗址作为表格中某一个坐标写在第14页的论文。而这座遗址恰恰就属于这一类。
- 否定结果无法证伪。“我没找到”的表现,无论是真的不存在,还是检索做得太浅,看起来完全一样。系统里没有任何报错信号。
- 新发表的文献总是滞后于各种索引。一篇2025年的论文可能索引不全、搜索工具抓不到,或者只通过会议报告和预印本服务器为人所知。
- 空间匹配本身就是一个独立的问题。论文不一定会公布坐标;遗址常有多个名字;图注写着“X附近的山顶”,地图却是低分辨率的栅格图。要把候选目标与之对应,需要对地理信息进行真正的推理。
我在生产环境机器学习工作中总结的规则是:智能体可以生成候选主张,但新颖性主张(“没有人报告过这个”)是唯一必须人工验证的输出,要在它离开这个大楼之前,用你能调动的最深入的检索来核实。地理空间这一侧也有类似的陷阱,涉及坐标和边界系统;凡是处理过空间索引取舍的人都知道,“这个点是否在这个数据集里”从来没有看上去那么简单。
结论:彻底不成立。在这个故事里,物理层面的验证委派得不错,新颖性层面的验证委派得一塌糊涂。据此设计你的流水线:检索可以自动化,但“未找到先前工作”只能当作草稿,永远不能当作结论。
误区五:验证闭环只是一步
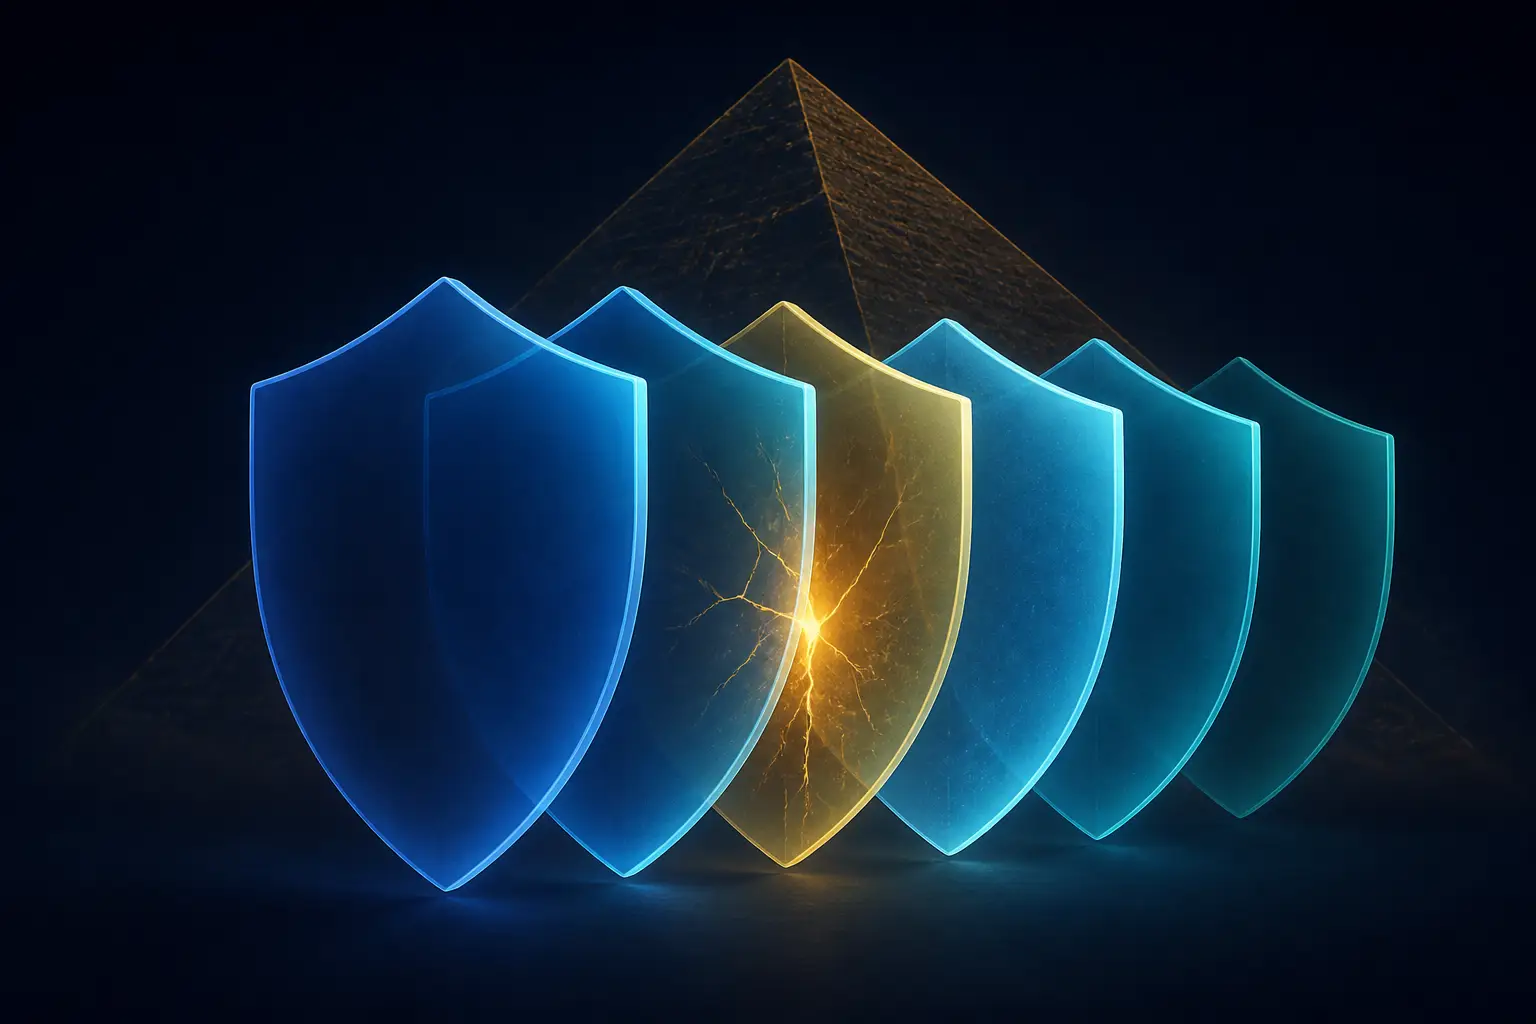
回顾这整个72小时的过程,最有用的读法是把它看作一套分层的验证设计,其中有些层守住了,有一层崩了。值得把这些层明确列出来,因为它们正是你为任何智能体主张生成系统都会搭建的那些层:
- 第一层:传感器级检查。原始数据是否支持渲染图中的特征?(点云切片。通过。)
- 第二层:独立的智能体复核。不同的智能体、不同的提示词重新检查候选目标;出现分歧时交由人类裁定。(基本通过;没有公开证据表明使用了对抗式提示,这一点我会补上。)
- 第三层:外部权威来源。查询官方名录,INAH确认没有登记记录。(通过,但只证明了“名录中没有”,并不能证明“新颖”。)
- 第四层:先前成果检索。(失败,漏掉了2025年的综述论文。)
- 第五层:领域专家。最终由学界社区和原作者在发表之后给出。(正是这一层发现了错误。)
这个教训并不是“不要相信智能体”,而是:每一层验证的是不同的主张,前三层通过,并不能告诉你后两层的情况。这里第三层的通过反而具有误导性,因为“不在名录中”在人类的脑海里被升级成了“科学界不知道”。这是两个覆盖范围不同的数据集之间的连接错误,与把邮政编码边界当成你以为的含义是同一类问题,我们在ZCTA与USPS边界不匹配一文中深入讨论过这类问题。两个看似权威的来源悄无声息地互相矛盾,然后得出了一个自信满满却错误的结论。
验证栈的每一层检查的都是不同的主张。前三层通过,对第四层什么也说明不了。
如果让我来加固这条流水线,我会加两个成本不高的机制。第一,对抗式文献检索:单独设一个智能体,它唯一的任务就是推翻新颖性主张,配备更激进的检索工具,并被指示假定先前工作一定存在。第二,发布前的专家咨询:在公布任何东西之前,把候选清单发给一位真正的领域专家。这次事件中社区的反应表明,专家们愿意快速参与;帖子发出后几小时内,更正就到来了。
“重新发现”究竟证明了什么
不过,我要为这个结果辩护,因为我认为怀疑者对失败的分析并不到位。一个拿着笔记本电脑、配了些算力的局外人,用公开数据、在几个晚上的智能体运行时间里,独立地找到了专业测绘已经发表过的同一座遗址。如果你的分诊流水线重新发现了已知遗址,这是一个校准信号,而不是尴尬:它说明检测器确实具备真实的灵敏度。真正该担心的是它只标出了无人能够证实的东西。
剥去冒险叙事之后,可复现的方法如下:
- 选择一个公开传感器数据远超人类注意力的领域(激光雷达是典型案例;NASA的地球科学档案库是另一个)。
- 把原始数据转换为高质量的视觉渲染图,这一步比模型选择更重要。
- 派出大量廉价的视觉智能体,并附上一份精确的书面规则,写明正例以及已知的误报。
- 用原始数据而不是渲染图来验证幸存的候选目标。
- 把新颖性作为一条独立的、由人主导的验证轨道,并在公布之前把主张交给领域专家审核。
考古界还提出了一点值得细想的问题:发现已经不再是瓶颈,保护才是。被发现的速度快于发掘和保护能力的遗址,会成为盗掘的目标;而坐标本身就是敏感信息(报告作者把坐标放进保密附件,这一做法是对的)。如果你要在敏感领域构建发现流水线,先把披露政策搭建好。验证不只是为了正确,更是为了负责任地正确。
坦率地总结:基于公开地理空间数据的智能体流水线,确实能够生成真实、可验证的主张,而“把视觉模型当测绘员”的做法,效果比多数从业者预想的要好。但真正能够存活下来的主张,是那些验证闭环为最容易悄无声息失效的那一层而设计的主张。在这个故事里,激光雷达的检查响亮地通过了,而文献检查却在低声细语。设计时要为那句低语而设防。


