Агентная лидарная археология: 5 мифов под проверкой
ИИ-агенты за ночь нашли майя-город в лидарных данных. Проверяем 5 мифов агентной лидарной археологии и то, как на самом деле работает цикл верификации.
 Sarah Chen

Сорок восемь ИИ-агентов за ночь просканировали 1200 км² лидарных данных по джунглям и пометили центр майя, которого нет в официальном археологическом реестре Мексики. Потом начялось неприятное: оказалось, что археологи уже картографировали этот самый участок в статье 2025 года, а агенты и их человек пропустили её при поиске по литературе. Эта история в миниатюре объясняет всё, что нужно знать про агентную лидарную археологию: конвейер поиска реально работает, а цикл верификации — нет, если его не построить как следует.
Годами я строил ML-конвейеры, где цена ложноположительного срабатывания — разбуженный ночью инженер, а не ошибочно описанный археологический объект. Поэтому разберу пять убеждений, которые постоянно встречаю об этом типе агентного поиска, и проверю каждое на том, что реально произошло.
Миф 1: для поиска руин нужна собственная обученная модель
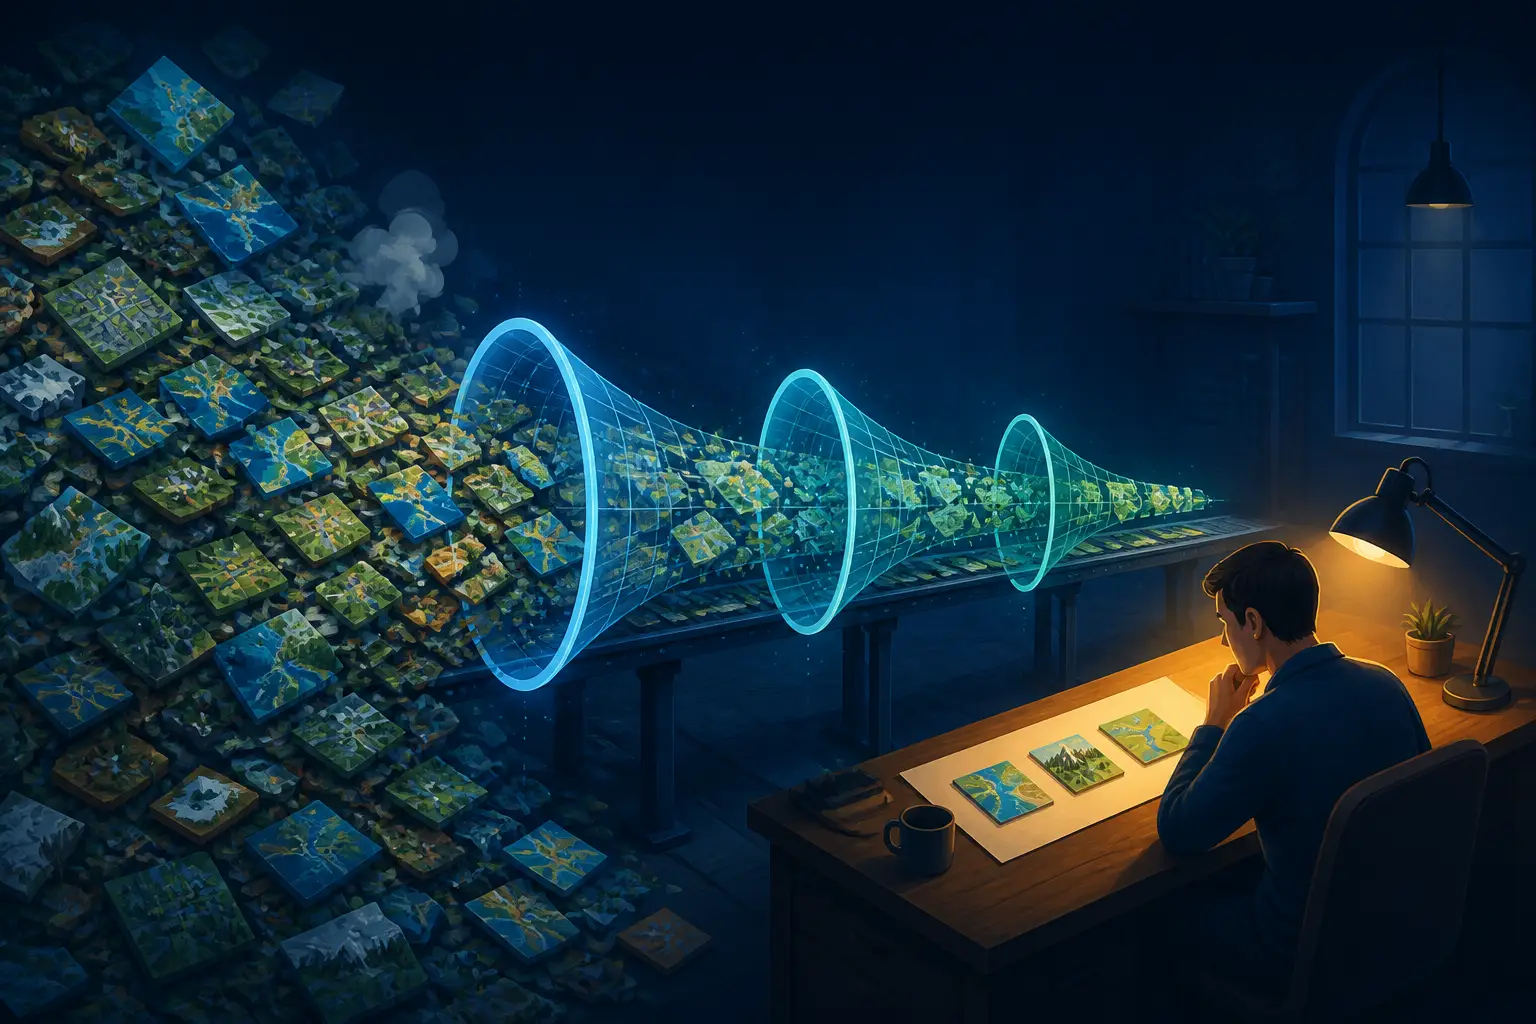
Самая неожиданная деталь всей истории: никакой специальной модели там не было. Ни CNN, обученной на размеченных плитках с пирамидами, ни дообученного детектора. Конвейер превращал полосы лидарных данных в изображения в стиле теневого рельефа (hillshade), а универсальные vision-language агенты разглядывали их по одному, следуя письменному руководству с описанием того, как выглядят пирамиды, платформы и площади, в отличие от холмов, воронок и дорог.
Это работает, потому что современные мультимодальные модели фактически впитали огромный объём визуальных априорных знаний. Ровная площадка с прямыми краями под пологом джунглей — это задача поиска аномалий, и современные VLM неплохо с ней справляются, если дать им чистые отрендеренные входные данные. Фокус не в модели, а в рендеринге. Облака точек лидара для vision-модели бесполезны напрямую, их нужно превратить во что-то читаемое: цифровые модели рельефа, теневые рельефы при нескольких углах солнца, карты уклонов. Правильно подобранная визуализация превращает универсальную модель в удивительно компетентного геодезиста.
Впрочем, это направление я готов защищать с оговорками. Для массовых продакшн-задач специализированный классификатор по-прежнему выигрывает по стоимости и стабильности, и мы уже разбирали этот компромисс в статье специализированные CNN против frontier-LLM для классификации изображений. Запускать 48 агентных сессий над тысячами тайлов изображений дорого и недетерминированно. Но для исследования, где вы генерируете гипотезы, а не эксплуатируете сервис, подход «универсальная модель плюс хороший промпт» прагматически верен, и он не требует размеченных обучающих данных, а для узких археологических задач их почти нет.
Вердикт: миф разоблачён, с оговоркой. Чтобы генерировать кандидатов, собственная модель не нужна. Она, скорее всего, понадобится, если это станет повторяемой масштабируемой операцией.
Миф 2: открытия делали агенты
Если внимательно посмотреть на хронологию, видно, что агенты на самом деле фильтровали. Само открытие было сделано годами раньше: авиалидарными командами, исследователями, которые публиковали работы о повторном использовании экологических лидарных данных для археологии, и в частности авторами статьи-обзора 2025 года, которые уже картографировали именно этот холм. Агенты сократили пространство поиска с 1200 км² джунглей до горстки кандидатных тайлов, которые человек может просмотреть за чашкой кофе.
Это не упрёк: фильтрация в таком масштабе — реальное узкое место в большинстве наук, богатых данными. Радиоастрономия, физика частиц, геномика: паттерн всегда один. Датчики производят гораздо больше данных, чем люди способны просмотреть, поэтому скорость открытий ограничена пропускной способностью триажа, а не доступностью данных. Это та же динамика, что стоит за тем, почему AI-бенчмарки пропускают большую часть реальной работы: ценная задача никогда не была «быть умным», она была «просмотреть миллион скучных вещей и выделить пять интересных».
Вердикт: скорее разоблачён. Агенты — это множители внимания, а не источники открытий. Как только вы начинаете считать их первооткрывателями, вы начинаете доверять их отрицательным результатам, вроде «поиск в литературе ничего не нашёл», и именно здесь живёт режим отказа этой истории.
Миф 3: прямые края, найденные vision-агентом, — это эталонная истина
Самая технически грамотная часть конвейера, на мой взгляд, вот эта. После того как vision-агент пометил холм, процесс не остановился на отрендеренном изображении. Он вернулся к исходному облаку точек и проверил, что точки, классифицированные как земля (а не возвраты от полога), действительно повторяют контур площадки, пирамиды и внутреннего двора под 10–17 метрами леса. Это самая важная привычка в любом геопространственном ML-конвейере: рендеринги врут, точки — нет.
Откуда такая паранойя? Классификация земли при обработке лидара — это тоже модель, и под плотным тропическим пологом она может интерполировать гладкие поверхности там, где реальных возвратов почти нет. «Площадка» может оказаться артефактом алгоритма поиска земли, который галлюцинирует ровность. Растительная структура тоже способна создавать пугающе линейные просветы в пологе, которые попадают в теневые рельефы. Любой, кто работал с геоданными в масштабе страны, обжигался на артефактах обработки, которые выглядят осмысленнее самого сигнала.
Вот чеклист проверки, на котором я бы настаивал и которому в основном следовала эта история:
- Подтвердите признак в исходном облаке точек, в срезах минимум по двум осям, а не только в отрендеренной DTM.
- Рендерьте с несколькими азимутами освещения: артефакты от направления сканирования исчезают или смещаются, реальные структуры — нет.
- Сверьтесь со вторым источником данных, если он есть (другая съёмка, другой год).
- Отфильтруйте известные генераторы ложных срабатываний: воронки (регион майя — карст, их там полно), современные дороги, следы вырубок и геологические террасы.
- Измерьте аномалию: прямолинейность краёв, углы, площадь платформы относительно фона региона. «Похоже на прямоугольник» — это ощущение, а измеренное соотношение сторон — это утверждение.
Конвейер прошёл большинство этих проверок. И, что важно, физическое утверждение подтвердилось: объект реален, археологи согласны, что это гражданский центр классического периода. Сбой произошёл по совершенно другой оси.
Миф 4: проверку литературы можно делегировать
Это миф, который история разоблачила на самой себе, публично. Агенты искали по литературе и в официальном реестре INAH, ничего не нашли и отметили объект как незарегистрированный. Формально верно: его не было в реестре INAH. Но рецензируемая статья, опубликованная в том же году, уже картографировала этот объект, и агентный поиск в литературе её благополучно проскочил. «Повторное открытие» попало в заголовок только после того, как эксперт предметной области указал на цитату.
Если вы строили агентов, которые проверяют предшествующие работы или новизну, это должно вызвать узнавание. Поиск литературы — самая трудная для делегирования задача по структурным причинам:
- Охват невидим. Агент не может сказать, до чего он не смог добраться: журналы за пейволлом, PDF в университетских репозиториях, статьи, где объект фигурирует как одна координата в таблице на 14-й странице. Именно там и был этот объект.
- Отрицательные результаты не опровергнуть. «Ничего не нашёл» выглядит одинаково, существует ли что-то на самом деле или ваш поиск был поверхностным. Сигнала об ошибке нет.
- Свежие публикации отстают от всех индексов. Статья 2025 года может плохо индексироваться, не подхватываться поисковыми инструментами или быть известна только по докладам на конференциях и препринтам.
- Пространственное сопоставление — отдельная проблема. Статьи не всегда публикуют координаты; у объектов бывает несколько названий; подпись к рисунку гласит «холм рядом с X», а карта — растр низкого разрешения. Сопоставить с ней кандидата можно только рассуждая о географии.
Моё правило из продакшн-работы с ML: агенты могут генерировать кандидатные утверждения, но утверждение о новизне («никто об этом не сообщал») — единственный результат, который нужно проверять вручную, самым глубоким поиском, на который вы способны, прежде чем он покинет стены лаборатории. У геопространственной стороны есть аналогичная ловушка с системами координат и границ; тот, кто сталкивался с компромиссами пространственных индексов, знает, что вопрос «попадает ли эта точка в этот датасет» никогда не бывает таким простым, каким кажется.
Вердикт: миф разоблачён, и жёстко. Физическую проверку в этой истории делегировали хорошо, проверку новизны — ужасно. Соответственно и проектируйте конвейер: автоматизируйте поиск, но «предшествующих работ не найдено» считайте черновиком, а не выводом.
Миф 5: цикл верификации — это один шаг
Полезно читать всю 72-часовую историю как многослойную систему верификации, где одни слои выдержали, а один рухнул. Стоит назвать эти слои, потому что именно их вы построили бы для любой агентной системы генерации утверждений:
- Слой 1 — проверка на уровне датчика. Подтверждают ли исходные данные отрендеренный признак? (Срезы облака точек. Пройдено.)
- Слой 2 — независимая проверка агентом. Разные агенты с разными промптами перепроверяют кандидатов, расхождения передаются человеку. (В основном пройдено; опубликованных свидетельств состязательных промптов нет, и я бы их добавил.)
- Слой 3 — внешний авторитет. Запрос в официальный реестр: INAH подтвердил, что объект не зарегистрирован. (Пройдено, но доказало лишь отсутствие в реестре, а не новизну.)
- Слой 4 — поиск предшествующих работ. (Провален: пропущена статья-обзор 2025 года.)
- Слой 5 — эксперт предметной области. В итоге обеспечен сообществом и первыми авторами уже после публикации. (Именно этот слой поймал ошибку.)
Урок не в том, что «не доверяйте агентам». Каждый слой проверяет другое утверждение, и то, что три из пяти прошли, ничего не говорит о двух остальных. Прохождение слоя 3 здесь было откровенно обманчивым: «нет в реестре» в голове человека превратилось в «неизвестно науке». Это ошибка соединения двух наборов данных с разным охватом, того же класса, что и предположение, будто граница почтового индекса означает то, что вы думаете; об этом мы подробно говорим в статье о несоответствиях границ ZCTA и USPS. Два авторитетных на вид источника, молчаливое расхождение, уверенный неверный вывод.
Каждый слой стека верификации проверяет своё утверждение. Прохождение трёх слоёв ничего не говорит о четвёртом.
Если бы я укреплял этот конвейер, я добавил бы два недорогих механизма. Первое — состязательный проход по литературе: отдельный агент, единственная задача которого — опровергнуть новизну, с более агрессивными поисковыми инструментами и инструкцией исходить из того, что предшествующая работа существует. Второе — экспертная проверка до публикации: отправить список кандидатов одному реальному специалисту в предметной области до каких-либо анонсов. Реакция сообщества показывает, что эксперты готовы включаться быстро: поправка пришла через несколько часов после публикации поста.
Что на самом деле доказывает повторное открытие
Но результат я защищу, потому что считаю, что скептики неверно поняли анализ провала. Посторонний человек с ноутбуком и каким-то вычислительным ресурсом независимо пришёл к тому же объекту, который опубликовала профессиональная экспедиция, используя открытые данные и пару ночей агентного времени. Если ваш конвейер триажа заново открывает известные объекты, это сигнал калибровки, а не повод для стыда: значит, детектор действительно чувствителен. Гораздо больше стоило бы беспокоиться, если бы он выдавал только то, что никто никогда не сможет подтвердить.
Воспроизводимый рецепт без приключенческого нарратива:
- Выберите область, где публичные данные датчиков намного превосходят человеческое внимание (лидар — канонический случай, архивы NASA по наукам о Земле — ещё один).
- Преобразуйте сырые данные в качественные визуальные рендеринги: этот шаг важнее выбора модели.
- Запустите дешёвых vision-агентов параллельно с точной письменной рубрикой положительных примеров и известных ложных срабатываний.
- Проверяйте выживших кандидатов по сырым данным, а не по рендерингам.
- Ведите новизну как отдельный трек верификации под руководством человека и направляйте утверждения эксперту предметной области перед анонсом.
Есть ещё одна вещь, которую поднимало археологическое сообщество и которую стоит обдумать: поиск больше не узкое место, узкое место — сохранность. Объекты, которые находят быстрее, чем их успевают раскопать или защитить, становятся мишенями для грабителей, а координаты — чувствительная информация (автор отчёта был прав, когда вынес их в конфиденциальное приложение). Если вы строите конвейеры поиска по чувствительным областям, сначала постройте политику раскрытия информации. Верификация — это не только про то, чтобы быть правым; это про то, чтобы быть правым ответственно.
Честный итог: агентные конвейеры над публичными геопространственными данными действительно могут генерировать реальные, проверяемые утверждения, и трюк с vision-моделью как геодезистом работает лучше, чем ожидали большинство практиков. Но выживает то утверждение, цикл верификации которого был спроектирован с учётом слоя, который ломается молча. В этой истории проверки по лидару пели, а проверка литературы шептала. Стройте под шёпот.


