Arqueología lidar con agentes IA: 5 mitos, probados
Un pipeline de agentes IA detectó un sitio maya en datos lidar en una noche. Probamos 5 mitos sobre la arqueología lidar agéntica.
 Sarah Chen

Cuarenta y ocho agentes de IA escanearon durante la noche 1.200 km² de lidar de selva y marcaron un centro cívico maya que no figuraba en el registro arqueológico oficial de México. Entonces llegó la parte incómoda: resulta que los arqueólogos ya habían mapeado ese mismo sitio en un artículo de 2025, y los agentes, y también su humano, lo habían pasado por alto en la búsqueda bibliográfica. Esa historia, en miniatura, lo resume todo sobre la arqueología lidar agéntica: el pipeline de descubrimiento funciona de verdad, y el bucle de verificación no funciona, a menos que lo construyas bien.
Llevo años construyendo pipelines de ML donde el coste de un falso positivo era un ingeniero despertado con una alerta, no un sitio arqueológico mal reportado. Así que voy a tomar las cinco creencias que sigo viendo sobre este tipo de pipelines de descubrimiento agéntico y a contrastar cada una con lo que pasó de verdad.
Mito 1: necesitas un modelo entrenado a medida para encontrar ruinas
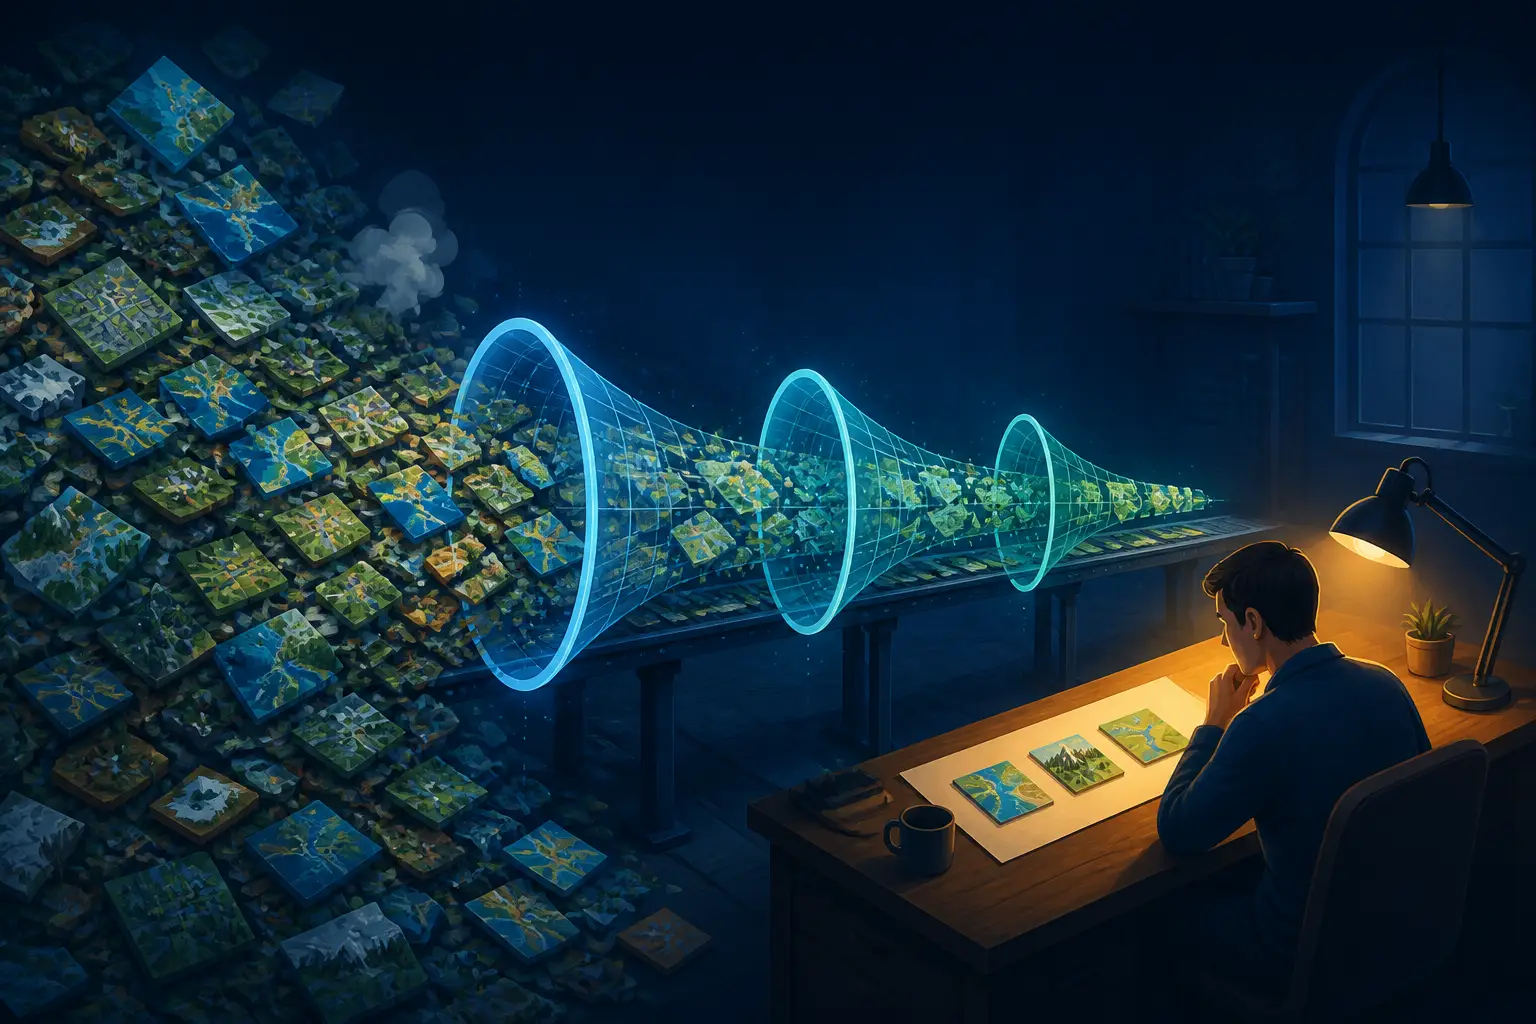
El detalle más sorprendente de toda la historia: no hubo ningún modelo especial. Ni una CNN entrenada con teselas etiquetadas de pirámides, ni un detector ajustado con fine-tuning. El pipeline convirtió las franjas de lidar en imágenes estilo sombreado de relieve (hillshade) y dejó que agentes generalistas de visión y lenguaje las revisaran una por una, siguiendo una guía escrita que describía cómo son las pirámides, las plataformas y las plazas frente a colinas, dolinas y caminos.
Esto funciona porque los modelos de visión de frontera han absorbido, en la práctica, una enorme cantidad de conocimiento visual previo. Una plaza nivelada con bordes rectos bajo el dosel de la selva es un problema de detección de anomalías, y los VLM actuales son buenos detectando anomalías cuando les das entradas renderizadas y limpias. El truco no está en el modelo, sino en el renderizado. Las nubes de puntos de lidar no le sirven de nada a un modelo de visión tal cual; hay que convertirlas en algo legible: modelos digitales del terreno, sombreados de relieve con varios ángulos de sol, mapas de pendiente. Si la visualización está bien hecha, un modelo generalista se convierte en un topógrafo sorprendentemente competente.
Dicho esto, es una frontera que defiendo con matices. Para trabajo de alto volumen en producción, un clasificador especializado sigue ganando en coste y consistencia; ya cubrimos ese compromiso en CNN especializadas frente a LLM de frontera para clasificación de imágenes. Ejecutar 48 sesiones de agentes sobre más de mil teselas de imagen es caro y no determinista. Pero ¿para la exploración, donde generas hipótesis en lugar de operar un servicio? El enfoque generalista con un buen prompt es pragmáticamente correcto, y no requiere datos de entrenamiento etiquetados, que en arqueología de nicho prácticamente no existen.
Veredicto: refutado, con asterisco. No necesitas un modelo a medida para generar candidatos. Probablemente sí lo quieras si esto se convierte en una operación repetida y escalada.
Mito 2: fueron los agentes quienes hicieron el descubrimiento
Lee la cronología con atención y verás lo que los agentes hicieron realmente: filtrar. El descubrimiento en sí lo hicieron años antes los equipos de lidar aerotransportado, los investigadores que publicaron sobre la reutilización de lidar ambiental para arqueología y, en concreto, los autores del artículo de revisión de 2025 que ya habían mapeado esta misma colina. Los agentes redujeron el espacio de búsqueda de 1.200 km² de selva a un puñado de teselas candidatas que una persona podía revisar tomando un café.
No es una crítica: filtrar a esa escala es el cuello de botella real en la mayoría de las ciencias con mucho dato. Radioastronomía, física de partículas, genómica: el patrón siempre es el mismo. Los sensores producen mucho más dato del que las personas pueden mirar, así que la tasa de descubrimiento la limita la capacidad de triaje, no la disponibilidad de datos. Esta es exactamente la dinámica detrás de por qué los benchmarks de IA no reflejan la mayor parte del trabajo real: la tarea valiosa nunca fue «ser listo», sino «mirar un millón de cosas aburridas y sacar las cinco interesantes».
Veredicto: mayormente refutado. Los agentes son multiplicadores de atención, no fuentes de descubrimiento. En el momento en que los presentas como descubridores, empiezas a confiar en sus resultados negativos («la búsqueda bibliográfica no encontró nada»), y ahí es donde vive el modo de fallo de esta historia.
Mito 3: los bordes rectos de un agente de visión son la verdad de referencia
Esta es la parte del pipeline que me pareció más sólida técnicamente. Después de que un agente de visión marcara la colina, el flujo no se detuvo en la imagen renderizada. Volvió a la nube de puntos original y comprobó que los retornos clasificados como suelo (no los del dosel) trazaban de verdad la plaza, la pirámide y el patio, bajo 10 a 17 metros de bosque. Este es el hábito más importante en cualquier pipeline de ML geoespacial: los renderizados engañan, los puntos no.
¿Por qué tanta paranoia? La clasificación de suelo en el procesado de lidar es en sí misma un modelo, y bajo un dosel tropical denso puede interpolar superficies lisas allí donde casi no hay retornos reales. Una «plaza» puede ser un artefacto del algoritmo de búsqueda de suelo que alucina llanura. La estructura de la vegetación también puede producir huecos en el dosel asombrosamente lineales que se propagan a los sombreados de relieve. Quien haya trabajado con pipelines de datos geográficos a escala de país se ha quemado alguna vez con artefactos de procesado que parecen más significativos que la señal.
Así que la lista de verificación que yo exigiría, y que esta historia en gran parte siguió, es:
- Confirmar el rasgo en la nube de puntos original, cortada al menos en dos ejes, no solo en un MDT renderizado.
- Renderizar con varios azimuts de sombreado; los artefactos de la dirección de las líneas de escaneo desaparecen o se desplazan, las estructuras reales no.
- Contrastar con una segunda fuente de datos si existe (otro levantamiento, otro año).
- Filtrar los generadores conocidos de falsos positivos: dolinas (la región maya es kárstica y está llena de ellas), caminos modernos, cicatrices de tala y terrazas geológicas.
- Cuantificar la anomalía: rectitud de los bordes, ángulos de las esquinas, área de la plataforma frente al fondo regional. «Parece rectangular» es una sensación; una relación de aspecto medida es una afirmación.
El pipeline superó la mayoría de estas comprobaciones. Y, lo que es notable, la afirmación física se sostuvo: el sitio es real y los arqueólogos coinciden en que se trata de un centro cívico del periodo Clásico. El fallo se produjo en un eje completamente distinto.
Mito 4: revisar la bibliografía es una tarea que puedes delegar
Este es el mito que la historia refutó contra sí misma, en público. Los agentes buscaron en la literatura y en el registro oficial del INAH, no encontraron nada y reportaron el sitio como no registrado. Técnicamente era cierto: no estaba en el registro del INAH. Pero un artículo revisado por pares publicado ese mismo año había mapeado el sitio, y la búsqueda bibliográfica agéntica lo dejó pasar de largo. El término «redescubrimiento» solo entró en el titular después de que un experto del dominio señalara la cita.
Si has construido agentes que hacen algún tipo de comprobación de arte previo o de novedad, esto debería provocarte una mueca de reconocimiento. La búsqueda bibliográfica es lo más difícil de delegar, por razones estructurales:
- La cobertura es invisible. Un agente no puede saber qué no pudo consultar: revistas de pago, PDFs detrás de repositorios universitarios, artículos donde el sitio aparece como una coordenada en una tabla de la página 14. Justo donde estaba este sitio.
- Los resultados negativos no son falsables. «No encontré nada» se ve igual tanto si no existe nada como si tu búsqueda fue superficial. No hay señal de error.
- Las publicaciones recientes van por detrás de todos los índices. Un artículo de 2025 puede estar mal indexado, no haber sido recogido por las herramientas de búsqueda o ser conocido solo por charlas de congresos y servidores de preprints.
- La correspondencia espacial es un problema aparte. Los artículos no siempre publican coordenadas; los sitios tienen varios nombres; un pie de figura dice «colina cerca de X» y el mapa es un ráster de baja resolución. Relacionar tu candidato con eso exige razonamiento real sobre geografía.
Mi regla, de mi trabajo de ML en producción: los agentes pueden generar afirmaciones candidatas, pero la afirmación de novedad («nadie ha informado de esto») es el único resultado que verificas a mano, con la búsqueda más profunda que puedas reunir, antes de que salga del edificio. El lado geoespacial tiene una trampa análoga con los sistemas de coordenadas y de límites; quien haya lidiado con compromisos de índices espaciales sabe que «¿está este punto en este conjunto de datos?» nunca es tan simple como parece.
Veredicto: refutado, y con fuerza. La verificación física se delegó bien en esta historia. La verificación de novedad se delegó muy mal. Diseña tu pipeline en consecuencia: automatiza la búsqueda, pero trata «no encontré trabajo previo» como un borrador, nunca como una conclusión.
Mito 5: el bucle de verificación es un solo paso
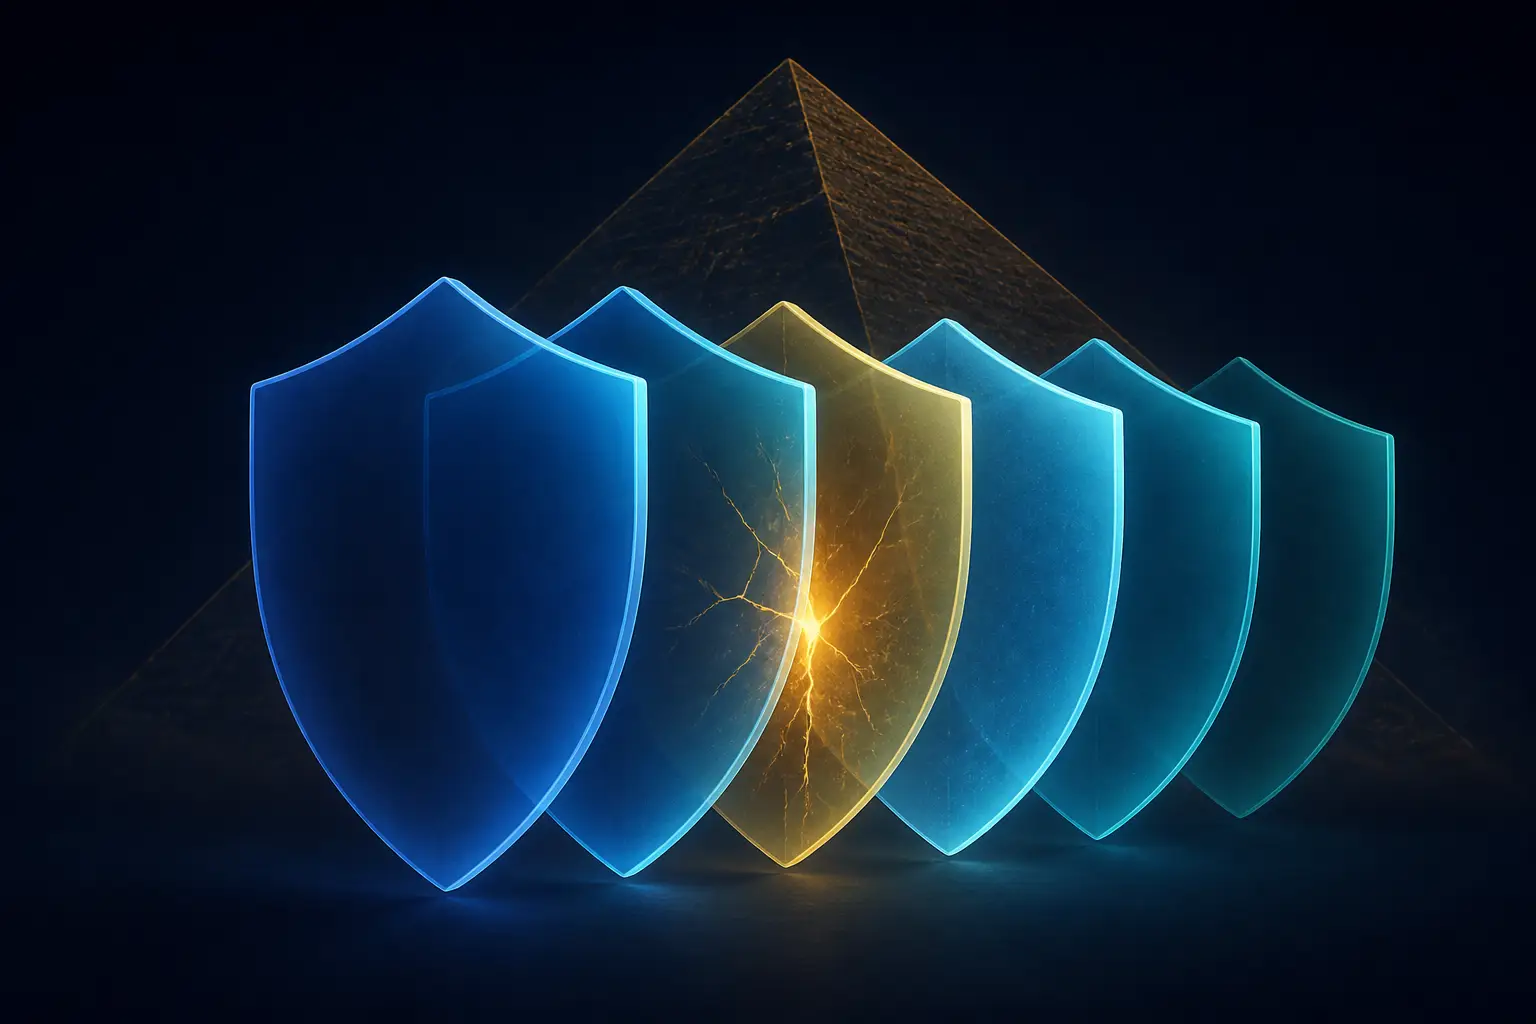
La forma útil de leer el arco completo de 72 horas es como un diseño de verificación en capas, donde algunas capas aguantaron y una se colapsó. Merece la pena nombrarlas porque son las mismas que construirías para cualquier sistema agéntico de generación de afirmaciones:
- Capa 1: comprobación a nivel de sensor. ¿Los datos crudos respaldan el rasgo renderizado? (Cortes de la nube de puntos. Superada.)
- Capa 2: revisión independiente por agentes. Agentes distintos, prompts distintos, reexaminan los candidatos; los desacuerdos pasan a una persona. (En su mayoría superada; no hay evidencia publicada de prompting adversarial, que yo añadiría.)
- Capa 3: autoridad externa. Consulta del registro oficial: el INAH confirmó que no estaba registrado. (Superada, pero solo demostró la ausencia en el registro, no la novedad.)
- Capa 4: búsqueda de arte previo. (Fallida: no encontró el artículo de revisión de 2025.)
- Capa 5: experto del dominio. Aportado en última instancia por la comunidad y los autores originales, después de la publicación. (Esta es la capa que detectó el error.)
La lección no es «no confíes en los agentes», sino que cada capa verifica una afirmación distinta, y que superar tres de cinco no te dice nada sobre las otras dos. Que la capa 3 pasara fue incluso engañoso aquí, porque «no está en el registro» se transformó en «la ciencia no lo conoce» en la cabeza de la persona. Eso es un error de unión entre dos conjuntos de datos con cobertura distinta, y pertenece a la misma clase de fallo que asumir que un límite de código postal significa lo que crees que significa: el tipo de problema que analizamos en discrepancias entre límites ZCTA y USPS. Dos fuentes con aspecto de autoridad, un desacuerdo silencioso y una conclusión errónea con total seguridad.
Cada capa de una pila de verificación comprueba una afirmación distinta. Superar tres capas no te dice nada sobre la cuarta.
Si yo fuera a endurecer este pipeline, añadiría dos mecanismos baratos. Primero, una pasada adversarial de bibliografía: un agente separado cuyo único trabajo sea refutar la novedad, con herramientas de búsqueda más agresivas e instrucciones para asumir que existe trabajo previo. Segundo, un aviso previo a la publicación a un experto: enviar la lista de candidatos a un especialista del dominio antes de anunciar nada. La respuesta de la comunidad aquí demuestra que los expertos están dispuestos a participar rápido; la corrección llegó a las pocas horas de publicar el post.
Lo que el redescubrimiento demuestra realmente
Aun así, defiendo el resultado, porque creo que los escépticos se equivocaron en el análisis del fallo. Alguien externo, con un portátil y algo de cómputo, llegó de forma independiente al mismo sitio que un levantamiento profesional había publicado, usando datos públicos, en un par de noches de tiempo de agentes. Si tu pipeline de triaje redescubre sitios conocidos, eso es una señal de calibración, no una vergüenza: significa que el detector tiene sensibilidad real. Me preocuparía mucho más que solo encontrara cosas que nadie pudiera confirmar nunca.
La receta replicable, sin la narrativa de aventura:
- Elige un dominio donde los datos públicos de sensores superen con mucho la atención humana (el lidar es el caso canónico; los archivos de ciencias de la Tierra de la NASA son otro).
- Convierte los datos crudos en renderizados visuales de alta calidad: este paso importa más que la elección del modelo.
- Despliega agentes de visión baratos con una rúbrica escrita y precisa de positivos y falsos positivos conocidos.
- Verifica los supervivientes contra los datos crudos, no contra los renderizados.
- Trata la novedad como una vía de verificación aparte, dirigida por personas, y pasa las afirmaciones por un experto del dominio antes de anunciarlas.
Hay una cosa más que planteó la comunidad arqueológica y que merece reflexión: el descubrimiento ya no es el cuello de botella; lo es la custodia. Los sitios que se encuentran más rápido de lo que se pueden excavar o proteger acaban como objetivos de saqueo, y las coordenadas son información sensible (el autor del informe hizo bien en ponerlas en un anexo confidencial). Si construyes pipelines de descubrimiento sobre dominios sensibles, define primero la política de divulgación. Verificar no consiste solo en acertar; consiste en acertar con responsabilidad.
El resumen honesto: los pipelines agénticos sobre datos geoespaciales públicos pueden generar afirmaciones reales y verificables, y el truco del modelo de visión como topógrafo funciona mejor de lo que esperaban la mayoría de los practicantes. Pero la afirmación que sobrevive es aquella cuyo bucle de verificación se diseñó pensando en la capa que falla en silencio. En esta historia, las comprobaciones de lidar cantaron y la de bibliografía susurró. Diseña para el susurro.


