واجهات الكلام الصامت: لماذا فاز RF على الأقطاب؟
واجهات الكلام الصامت تفكّ شيفرة الكلمات الملفوظة بلا صوت عبر إشارات العضلات وRF. اكتشف لماذا تختلف عن الإملاء الصوتي وما الذي يعقّد الأمر.
 James Whitfield
أنت في المكتبة، وتطبيق الإملاء يعمل، وقد نطقت الإيميل نفسه أربع مرات بشفتيك أمام حاسوبك المحمول كأنك فقدت عقلك، لأن النطق بصوت عالٍ سيجلب لك نظرات الطابق كله. واجهات الكلام الصامت وُجدت لهذه اللحظة بالذات: أنظمة تفكّ شيفرة الكلمات التي تنطقها بشفتيك، أو حتى التي تنوي نطقها، دون أن يصدر عنك أي صوت مسموع. موجة جديدة من الشركات الناشئة تراهن على أن جهاز الإدخال الناقص في عصر الذكاء الاصطناعي ليس ميكروفونًا أفضل، بل لا ميكروفون على الإطلاق.
الفكرة أقدم مما توحي به العروض الحديثة. بدأ باحثو ناسا تجارب على التعرف على الكلام تحت الصوتي في منتصف العقد الأول من الألفية، في الأصل لرواد الفضاء وطواقم الطيران العاملين في بيئات صاخبة أو مع بدلات الضغط. وجعل مختبر الوسائط في MIT الفكرة مشهورة بجهاز AlterEgo عام 2018، وهو سماعة تُلبس تلتقط الإشارات العصبية العضلية من الفك والوجه. ما تغيّر مؤخرًا ليس المفهوم، بل أن أجهزة الراديو الرخيصة وتحسّن تعلّم الآلة وانتشار الذكاء الاصطناعي الصوتي تقاطعت لتجعل الهندسة قابلة للتنفيذ تقريبًا. تقريبًا فقط. مشكلة نسبة الإشارة إلى الضجيج هنا قاسية حقًا، والطريقة التي تحلّ بها الفرق هذه المشكلة تحدد كل شيء في المنتج الذي ستطلقه في النهاية.
النطق بلا صوت: ما هو التحدث تحت الصوتي فعلًا
هناك مصطلحات تستحق أن نضبطها، لأن المجال يخلط بين ثلاثة أشياء مختلفة. أولًا، هناك النطق بالشفاه: تشكيل كامل للحروف بالشفتين واللسان والفك، لكن بلا صوت. ثانيًا، الكلام الداخلي: الشفتان مغلقتان، لكن اللسان والحنك الرخو يتحركان بقصد كما لو كانا يشكّلان كلمات. ثالثًا، التحدث تحت الصوتي الحقيقي، وهو التنشيط العضلي الخافت وغير الإرادي الذي يحدث عندما تقرأ أو تفكّر بالكلمات. هذا الأخير هو النسخة الخيالية العلمية، ويكاد لا يُرصد خارج المختبر. المنتجات العاملة اليوم تعيش في الفئتين الأوليين. أحد الفرق التي تبني نظارات تعمل بالراديو يصف السلوك المستهدف بأنه «النطق بالشفاه مغلقة»، وهو هجين غريب يتعلمه المستخدمون، على ما يبدو، خلال جلسات قليلة.
بالنسبة لمحبّ اللغات، فإن علم اللغة هنا ممتع. النطق برنامج حركي يشغّله الدماغ سواء اهتزت الحبال الصوتية أم لا. والتصويت مجرد مرحلة واحدة في إنتاج الكلام، وهي المرحلة التي تضيف فيها الحنجرة الطاقة الصوتية. إذا أزلتها بقيت كل الحركة السابقة: موضع اللسان للحروف الصائتة، وتدوير الشفتين، والتحكم بالحنك اللين في الأصوات الأنفية. الواجهة الصامتة تحاول في جوهرها إعادة بناء تسلسل الفونيمات من بقايا تلك الحركة، أشبه باستنتاج لحن من مراقبة أصابع عازف بيانو على بيانو مكتوم. إنها قراءة الشفاه من الداخل.
هذا التأطير مهم لأنه يخبرك بما يجب أن تقيسه الحساسات. لا أحد يقرأ عقلك. كل نظام ناجح يلمس نوعًا من المرتبطات الفيزيائية للنطق، سواء كانت نبضات كهربائية أو حركة أنسجة أو طاقة منعكسة، واختيار المرتبط الذي تلاحقه هو القرار الهندسي الحاسم.
EMG: الحساس البديهي الذي يخونك
تبدأ معظم الفرق من تخطيط كهربية العضلات، لأن المنطق مغرٍ جدًا. العضلات تنقبض لأن الخلايا العصبية الحركية تُطلق جهودًا كهربائية عبر الأغشية، وإذا وضعت قطبًا على الجلد فوق العضلة الصحيحة يمكنك أن تراقب ذلك يحدث. EMG السطحي تقنية ناضجة، فالأطراف الصناعية يُتحكم بها بإشارات العضلات المتبقية منذ عقود. ولنموذج هاكاثون في عطلة نهاية الأسبوع، يمكنك ببساطة لصق الأقطاب على وجهك وتوصيلها بمضخّم، والحصول على شيء يومض بتطابق تقريبي مع الحروف الملفوظة بالشفاه. بُنيت نماذج أولية كثيرة للكلام الصامت بهذه الطريقة بالضبط، منها AlterEgo الشهير من MIT، وعلى الأرجح أول محاولة خام لدى الفريق الذي يطلق نظارات RF اليوم.
ثم يتدخل الواقع بقائمة من أنماط الفشل المتوقعة إلى حد محبط:
- العرق. تتغير موصلية الجلد مع التعرق، فتبدو الكلمة نفسها الملفوظة بالشفاه مختلفة في التاسعة صباحًا وبعد الغداء. معايرتك تتآكل باستمرار من تحتك.
- التداخل الكهربائي. إشارات EMG للوجه في نطاق الميكروفولت. خطوط الكهرباء القريبة، ومزوّد طاقة الحاسوب المحمول، وحتى الرمش قد تغمرها.
- تباين الوضعية. انزياح بمقدار مليمترين في موضع القطب يغيّر الألياف العضلية التي تهيمن على القراءة. انزع الجهاز وأعده، فيصبح نموذج الأمس يقيس شخصًا مختلفًا قليلًا.
- عائق المظهر. لن يرتدي أحد أقطابًا جيلية على وجهه في الأماكن العامة. يبدو هذا تافهًا، لكنه أسقط النهج على أي حال.
تستحق هذه النقطة الأخيرة الاحترام. الأجهزة الاستهلاكية تفشل بسبب الاحتكاك أكثر بكثير مما تفشل بسبب الفيزياء. تاريخ الأجهزة القابلة للارتداء مقبرة من أجهزة عملت في المختبر لكنها طلبت من المستخدم خطوة زائدة. سماعات التوصيل العظمي، وأحزمة الصدر لقياس نبض القلب، وعصابات EEG للرأس، كلها سليمة تقنيًا، وكلها متخصصة. عندما يتطلب حساسك تحضير الجلد يوميًا، فأنت تكون قد بنيت جهازًا طبيًا، لا ملحقًا للإدخال.
RF Sensing: قراءة الفم من الداخل
النهج الذي يكتسب زخمًا الآن يستبدل الأقطاب بالراديو. الفكرة: هوائيات مدمجة في إطارات النظارات تبعث موجات راديوية منخفضة الطاقة، بترددات قريبة من البلوتوث، تخترق وجهك. وعندما تعبر الموجات أنسجة متحركة كاللسان والشفتين والحنك الرخو، تتعدل بطرق دقيقة ومنظمة. تلتقط هوائيات الاستقبال الإشارة المضطربة، وتتعلم شبكة عصبية تحويل تلك الاضطرابات إلى نص. هذه من عائلة الفيزياء نفسها التي تستخدمها استشعارات الإيماءات عبر Wi-Fi، والرادار الذي وضعته Google في Pixel 4 لإيماءات اليد، لكنه موجّه إلى هدف أدق بكثير.
الجاذبية في أن RF يرى ما لا تراه الكاميرات ولا أقطاب الجلد. اللسان غير مرئي من الخارج بمجرد إغلاق الشفتين، لكنه عضلة كبيرة غنية بالماء تتفاعل معها موجات الراديو بقوة. الكلام الداخلي بالشفاه المغلقة، وهو الوضع الكتوم الذي يريده الناس فعلًا في الاجتماعات، لا يمكن الوصول إليه إلا عبر وسيلة تخترق الأنسجة كهذه. هذه هي الحجة الكاملة للمنتج في جملة واحدة: EMG والكاميرات تلتقط الخارج من النطق، أما RF فيلتقط الداخل.
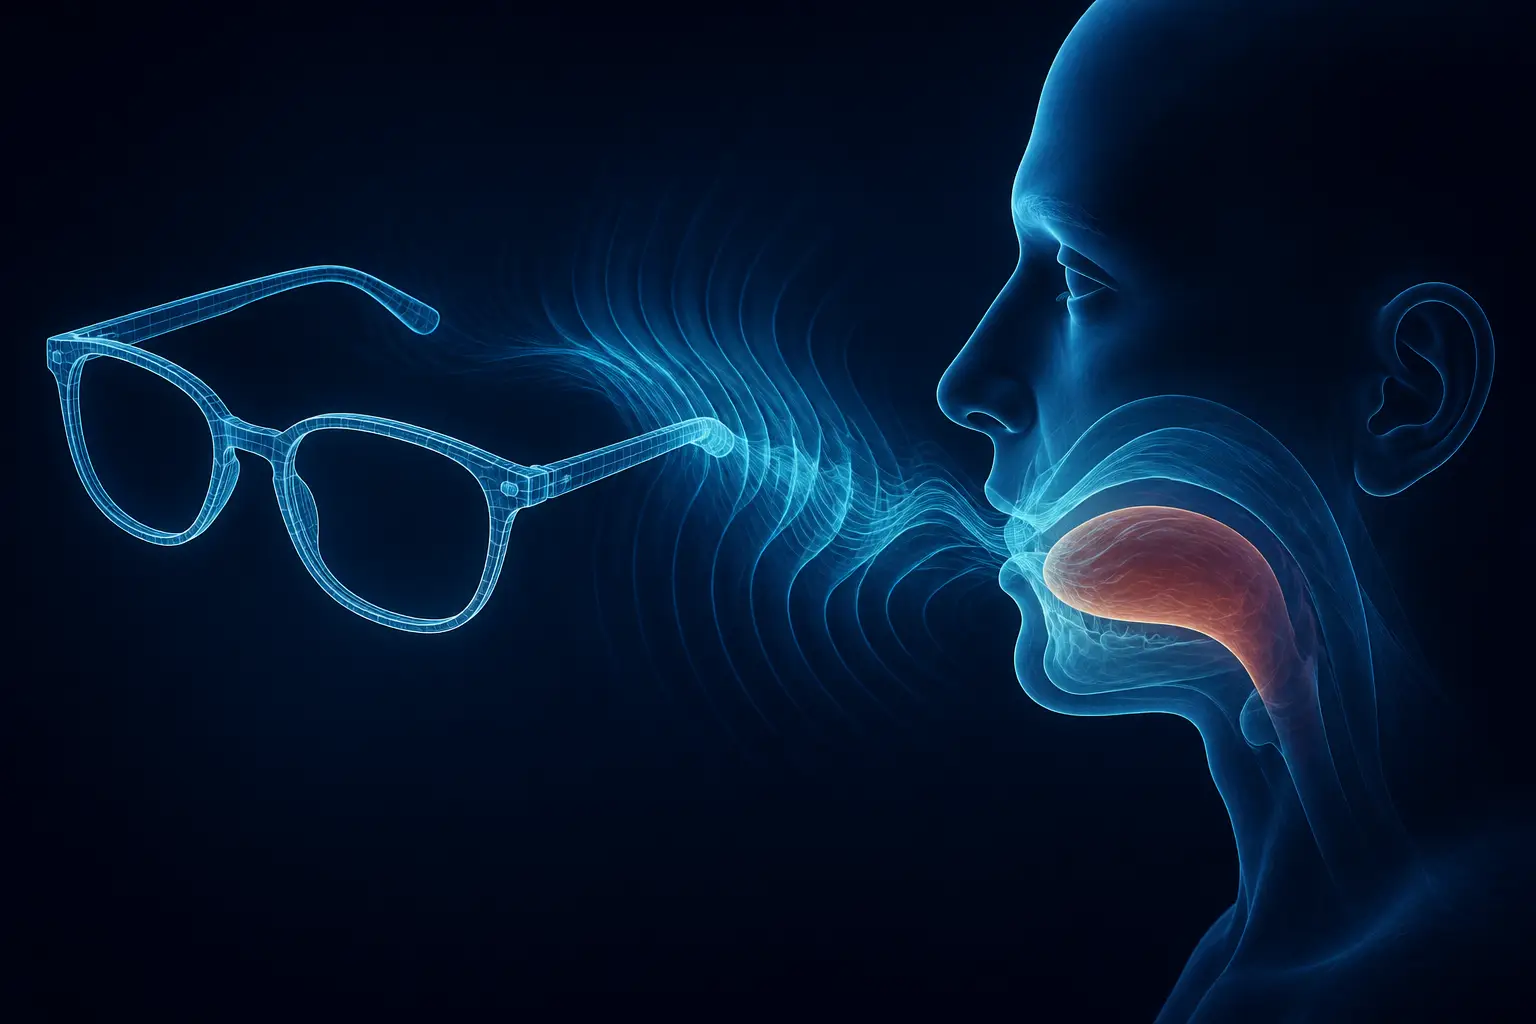
الهندسة اللازمة للوصول إلى ذلك ليست سهلة. الإشارة التي تبحث عنها تعديل خافت يركب على موجة حاملة، لذلك يجب أن تكون واجهة RF بأكملها منخفضة الضجيج بشكل استثنائي. وضع الهوائي مسألة تحسين صعبة: يجب أن تتداخل حقول الكهرومغناطيسية بأقصى قدر مع الأعضاء النطقية، ما يعني تصميم إطارات تعتمد على المحاكاة المكثفة، حيث تغيّر أجزاء المليمتر في موضع الهوائي ما يستطيع النظام سماعه. يقرّ الفريق الذي يبني نموذج النظارات الحالي بأن أول محاولة مدمجة في النظارات فشلت تمامًا، فعادوا إلى لصق الهوائيات على وجوههم، ثم إلى هيكل رأس صلب لتثبيت الهندسة، قبل أن تنجح أعمال المحاكاة في تصحيح الإطارات. هذا التسلسل من الشريط اللاصق إلى الهيكل ثم المنتج هو الأرشيف الصادق لأي عتاد يصل فعلًا إلى الأسواق.
الكاميرات والموجات فوق الصوتية: البدائل ذات الشرائح الحقيقية
مسار الكاميرا، أي قراءة الشفاه بصريًا، يملك أعمق سجل بحثي. أظهر LipNet قبل سنوات قراءة الشفاه من الفيديو على مستوى الجمل بشكل شامل، وتواصل مشاريع مفتوحة المصدر تكرار الحيلة بكاميرا ويب وأداة تتبع للوجه. إنه أرخص حساس يمكن تخيله: أنت تملك ثلاث كاميرات بالفعل. لكنه يرث القيد القاسي نفسه، فهو يرى الخارج من وجهك فقط. الكلام الداخلي بالفم المغلق غير مرئي بالتعريف، والإضاءة وزاوية الرأس تفسدان المدخلات باستمرار، وتوجيه كاميرا إلى وجهك طوال اليوم له تكاليف على الخصوصية والبطارية لا تزول أبدًا. تبقى قراءة الشفاه ممتازة كتعزيز للتعرف على الكلام الصوتي، فالنماذج السمعية البصرية تتفوق فعلًا على الصوتية وحدها في الضوضاء، لكنها كواجهة صامتة مستقلة محصورة في طرف «النطق الواضح بالشفاه» من الطيف.
الموجات فوق الصوتية تحتل موقعًا وسطيًا أغرب. استخدمت أنظمة أكاديمية مرسلات فوق صوتية موجهة نحو الفك، وأعادت بناء حركة اللسان من الأصداء، وتصوير اللسان بالموجات فوق الصوتية أداة قياسية في علم الأصوات، وهكذا رصدنا تكوّن الحروف الصائتة لعقود. الاستشعار جيد. أما الشكل الخارجي فلا. لم يكتشف أحد بعد كيف يُعبّأ مسبار فوق صوتي مثبت على الذقن في شيء ترتديه في اجتماع وقوف. كما أن الاقتران الصوتي عبر الهواء مفقود للإشارة وحساس للزاوية. رأيي: الموجات فوق الصوتية الإجابة الصحيحة لعلاج النطق السريري ومختبرات علم الأصوات، والإجابة الخاطئة لأدوات الإدخال الاستهلاكية.
إذا كنت تحتسب النقاط، فجدول المفاضلات تقريبًا كالتالي:
- EMG: إشارة عضلية مباشرة، وعرض نطاق جيد، لكن العرق والانزياح والموضع وضرورة وضع الأقطاب على الوجه تفسد كل شيء.
- قراءة الشفاه بالكاميرا: تكلفة عتاد صفرية ونماذج ناضجة، لكنها عمياء أمام الكلام بالفم المغلق، وهشة أمام الإضاءة، ومعادية للخصوصية.
- الموجات فوق الصوتية: تصوّر اللسان مباشرة، لكن الاقتران والشكل الخارجي يجعلانها أداة مختبرية.
- استشعار RF عبر الوجه: يرى الأعضاء النطقية الداخلية عبر الجلد، ويُدمج في النظارات، لكنه يتطلب مكدسًا غريبًا منخفض الضجيج وجبالًا من بيانات التدريب.
مشكلة نسبة الإشارة إلى الضجيج ليست مشكلة الإملاء
هذا هو الخطأ المفاهيمي الذي يقع فيه معظمنا حين نسمع عن هذه الأجهزة لأول مرة: نفترض أنها التعرف على الكلام مطروحًا منه الهواء. لكنها ليست كذلك. الإملاء الصوتي يعتمد على إشارة صممتها الطبيعة للتواصل، عشرات الديسيبلات من موجة ضغط نظيفة، شكّلها التطور لتحمل الفونيمات عبر الغرفة. الأجزاء الصعبة في التعرف الآلي على الكلام هي اللهجات والمفردات وإزالة الضجيج. أما الإشارة نفسها فسخية.
الكلام الصامت يملك النقيض. الحامل، سواء كان ميكروفولتات من EMG أو تعديلًا خافتًا من RF، لم يُصمم أصلًا ليشفّر اللغة. معلومات الفونيمات مبعثرة عبر قنوات الحساس دون تطابق واضح، والمشوشات فسيولوجية لا صوتية. البلع، وشد الفك، وإدارة الرأس، ولمس الوجه: كل واحد منها يُدخل عابرًا قد يطغى على إشارة النطق. حيث يحارب نظام التعرف الآلي على الكلام غرفة صاخبة، يحارب نظام الكلام الصامت جسدك أنت. أنت أرضية الضجيج.
يترتب على ذلك أمران. أولًا، تعتمد هذه الأنظمة على نمذجة اللغة أكثر بكثير من الإملاء. حين يكون دليل الحساس على فونيم ما ملتبسًا، يحسمه المفكك بتوقعات عمّا تريد قوله غالبًا، وهي الحيلة نفسها التي تجعل فك الترميز المقيّد فعّالًا جدًا في تحويل مخرجات النماذج الضبابية إلى قرارات موثوقة. توقّع أن تكون أنظمة الكلام الصامت جيدة بشكل مخيف في النصوص المتوقعة، كالأوامر والإيميلات بأسلوبك أنت، وأسوأ بوضوح في الكلمات النادرة والأسماء ومعرّفات الشيفرة، حيث لا يستطيع التوقع إنقاذ إشارة ضعيفة. ثانيًا، المعايرة بنيوية لا عرضية. تعمّمت أنظمة التعرف الصوتي عبر المتحدثين منذ عقود لأن الموجة الصوتية موجة. أما توقيع الإشارة الراديوية للوجه فليس كذلك، وهذا يقودنا إلى أصعب مشكلة في المجال.
كل وجه مسألة هوائي مختلفة
التعميم عبر المستخدمين هو المكان الذي تموت فيه النماذج الأولية للكلام الصامت. تشريح الوجه، من طول الفك وحجم اللسان وكثافة الأنسجة وسماكة الجلد، يختلف بشدة، وكل متغير من هذه يعيد تشكيل الإشارة. نموذج مدرّب على وجهي قد يكون عديم الفائدة تقريبًا على وجهك. وتعج أدبيات EMG المبكرة بأنظمة تعلن دقة ممتازة «لكل شخص، بعد المعايرة»، وهو تحفظ يدفن المنتج بهدوء. جهاز يحتاج ساعة تدريب لكل مستخدم قبل أن يعمل هو عرض بحثي، لا ملحق إدخال.
ما أجده مثيرًا فعلًا في جهد RF الحالي أنهم جرّبوا المسار الذكي أولًا، أي التكيف الخوارزمي للنطاق وحيل تطبيع الإشارة، وخلصوا إلى أن الرافعة الوحيدة التي تنجح هي الحجم الهائل للتدريب المسبق. فبنوا غرف تسجيل في مكتبهم، ودفعوا لأشخاص ليقرأوا نصوصًا وهم يرتدون النظارات، وراقبوا معدلات الخطأ تنخفض على منحنى توسع واضح مع نمو البيانات. النتيجة المعلنة: يحتاج المستخدم الجديد نحو عشرين جملة معايرة فقط قبل أن يعمل النظام بشكل جيد. هذا الرقم يهم أكثر من أي رقم دقة. عشرون جملة تدفق إعداد مقبول، أما ساعة من القراءات فطلب إرجاع.
هذا هو الدرس نفسه الذي يعيد تعليمنا إياه تعلم الآلة باستمرار: حين يفشل النموذج في التعميم، فالجواب عادةً بيانات أكثر تنوعًا، لا معمارية أذكى. رأينا ذلك يتكرر في التعرف على الكلام، وفي الترجمة الآلية للغات قليلة الموارد، وفي كل مجال تتغير فيه توزيعات المدخلات لكل مستخدم. الكلام الصامت يعاني تحولًا لكل مستخدم شرسًا بشكل خاص، لأن «الميكروفون» مصنوع جزئيًا من المستخدم نفسه.
أين يفوز الكلام الصامت فعلًا
إذا نزعنا الطرافة، تترتب حالات الاستخدام في تسلسل واضح. في القمة: إمكانية الوصول. هناك شريحة من المعلّقين، مطورون يعانون إصابات الإجهاد المتكرر ويواجهون جراحة نفق رسغي مزدوجة، وأشخاص يعودون إلى المكاتب المفتوحة حيث يستحيل الإملاء اجتماعيًا، وهؤلاء لا يرون في هذا أداة، بل الفرق بين العمل وعدم العمل. ومرضى استئصال الحنجرة والأشخاص المصابون بفقدان الكلام المرتبط بالتصلب الجانبي الضموري هم النسخة الأعمق والأهم من القصة نفسها. أي تقييم صادق لهذه التقنية يجب أن يزن ذلك بثقل كبير.
ثانيًا: البيئات الصاخبة، وهي الأكثر مفارقة. وسيلة استشعار تتجاهل الصوتيات تمامًا لا تهتم بمنشار العشب أو غرفة الخوادم أو أرضية المصنع. الصوت يفشل تحديدًا حيث يكون استشعار RF غير مبالٍ. ثالثًا: الكتمان، أي الإملاء في المكتبات والمكاتب المفتوحة والقطارات. هذا هو الطرح الاستهلاكي الشائع، وهو حقيقي، لكنني أشير إلى أنه الأضعف بين الثلاثة، لأنه ميزة راحة اجتماعية لا فتح لقدرة جديدة.
موقفي من المفاضلات: هذه التقنية تستحق شكلها الخارجي فقط إذا كان الاستدلال يتم على الجهاز نفسه، أو على الأقل قادرًا على العمل بلا اتصال. حساس يراقب حركة لسانك داخل فمك المغلق، ويبث البيانات الخام إلى واجهة برمجة سحابية، هو بنية خصوصية لا ينبغي لأحد قبولها. المعلقون القلقون من تسرب الإشارات غير الإرادية لديهم شكوى مشروعة، وإن كانت بعض المخاوف الأكثر تخمينًا مبالغًا فيها. الخبر الجيد أن نماذج فك الترميز صغيرة بما يكفي لتعمل محليًا، وينبغي للمجال أن يعامل التصميم الذي يعمل دون اتصال أولًا كحد أدنى لا كفئة متميزة. وتهم أيضًا نظائر كلمة التنشيط: ينبغي أن تحتاج النظارات إلى نية مادية واضحة، كإيماءة أو نمط شد للفك، قبل أن تبدأ الاستماع، وإلا فقد صنعت جهازًا قابلًا للارتداء يكتب كل حركة فم غير إرادية لديك.
هناك صدى أقدم لا أستطيع تجاهله. تعلّم مشغلو التلغراف في سبعينيات القرن التاسع عشر قراءة الرسائل من صوت نقرات المرحّل، وهي قناة إدخال لم يصممها أحد. تاريخ الواجهات مليء بهذه القنوات الجانبية التي تصبح قنوات رئيسية بمجرد أن يبني أحد المفكك. ثرثرة العضلات تحت الصوتية قناة جانبية للقراءة والتفكير، وقد كان البشر يسرّبونها منذ امتلكوا حوارًا داخليًا. وتحويلها إلى جهاز إدخال ليس اختراعًا بقدر ما هو ترقية، وإن استمرت منحنيات التوسع، فقد يكون أهدأ شخص في المكتبة هو من ينجز أكبر قدر من الكتابة.