無声音声インターフェース:RFが電極に勝つ理由
無声音声インターフェースは筋電や電波から無音の発話を解読します。電極よりRFが有利な理由と、音声入力と違うノイズ問題を解説。
 James Whitfield
図書館にいて、音声入力アプリを立ち上げたまま、同じメールの文面を四回も口パクで打ち込んでいる。声に出せば、フロア中から白い目で見られるからだ。サイレントスピーチ・インターフェースは、まさにこういう場面のために存在する。音を一切出さず、口の動き、あるいは口を動かそうとする意図だけを解読するシステムだ。新しいスタートアップ群は、AI時代に必要な入力デバイスはより良いマイクではなく、マイクそのものが要らないものだと賭けている。
このアイデアは、最近のデモ群が示すより古い。NASAの研究者は2000年代半ばに、騒音がひどい環境や与圧服を着る宇宙飛行士向けに、サブボーカル認識を試していた。MITメディアラボは2018年にAlterEgoで注目を集めた。顎や顔の神経筋信号を読み取るウェアラブルヘッドセットだ。最近変わったのは、コンセプトではない。安価な無線ハードウェア、より良い機械学習、そして音声AIの急速な普及が重なり、工学的にほぼ現実的になったことだ。ほぼ、だけど。ここでの信号対雑音比の問題は本当に厄介で、チームがそれをどう解決するかで、最終的に出す製品のすべてが決まる。
声を出さずに話す:サブボーカライゼーションの実態
用語を正しく押さえておく価値がある。この分野では三つの違うものが混同されがちだからだ。まずマウシング(口パク)。唇、舌、顎を完全に動かすが、声は出さない。次に内的発話。唇は閉じたままだが、舌と軟口蓋は言葉を作るように意図的に動いている。最後に本当のサブボーカライゼーション。文字を読んだり考えたりするときに起きる、かすかで不随意な筋活動だ。最後のものはSFの世界の話で、研究室の外ではほとんど検出できない。今日の実用製品は最初の二つの領域にある。RFセンシングのグラスを開発しているあるチームは、ターゲットの動きを「唇を閉じたまま口パクする」と表現している。奇妙なハイブリッドだが、ユーザーは数回使えばすぐ慣れるらしい。
言語オタクとして、ここの言語学は本当に面白いと思っている。調音は、声帯が振動するかどうかに関係なく脳が走らせる運動プログラムだ。有声化は発話の一段階にすぎず、喉頭が音響エネルギーを加える部分にあたる。それを取り除いても、上流の振り付け全体は残る。母音のための舌の位置、唇の丸め、鼻音のための軟口蓋の制御。無声音声インターフェースは、要するにその振り付けの残滓から音素列を再構成しようとしている。消音されたピアノの鍵盤を弾くピアニストの指の動きを見て、メロディを推測するようなものだ。内側から見た読唇術、とでも言おうか。
この枠組みは重要だ。センサーが何を測るべきかを教えてくれるからだ。誰も心を読んでいるわけではない。成功したシステムはすべて、調音の何らかの物理的な相関、つまり電気信号、組織の動き、反射されたエネルギーのいずれかに頼っている。どの相関を追うかの選択こそが、設計上の決定的な判断になる。
筋電(EMG):一見確実なセンサーは裏切り者
筋電図(EMG)は、ほぼ全員が最初に手を出すところだ。ロジックが抗いがたいからだ。運動神経が膜を越えて電位を放出するため筋肉が収縮し、適切な筋肉の上の皮膚に電極を貼れば、その様子を観察できる。表面筋電はすでに成熟した技術で、義手は何十年も残存筋信号で操作されてきた。週末のハッカソンなら、顔に電極を貼り、アンプにつなぐだけで、口パクの文字と大まかに対応して点滅するものが得られる。複数の無声音声プロトタイプがまさにこの方法で作られており、有名なMIT AlterEgoや、現在RFグラスを出荷しているチームによる最初の粗い試みもそうだったと報じられている。
そこに現実が割り込んでくる。憂鬱なほど予想通りの故障モードが並ぶ:
- 汗。汗をかくと皮膚の導電率が変化するため、同じ口パクの単語でも午前9時と昼食後では違って見える。キャリブレーションは、足元で絶えず劣化していく。
- 電気的干渉。顔の筋電信号はマイクロボルトの範囲にある。近くの電源線、ノートPCのスイッチング電源、さらには瞬きでさえ、信号を飲み込んでしまう。
- 装着位置のばらつき。電極の位置が2ミリずれるだけで、読み取りに支配的な筋線維が変わる。デバイスを外して付け直すと、昨日のモデルは少し別の人物を計測していることになる。
- 見た目の致命傷。人前で顔にジェル電極を貼りたがる人はいない。些細なことに聞こえるが、それだけでこのアプローチは潰れた。
その最後の点は、もっと重く見るべきだ。コンシューマー向けハードウェアは、物理法則より手間の面で失敗することのほうがずっと多い。ウェアラブルの歴史は、研究室では動いたのに、ユーザーに一手間多く要求したせいで消えていったデバイスの墓場だ。骨伝導ヘッドセット、胸ベルト型の心拍計、EEGヘッドバンド。どれも技術的には健全だったが、みな一部のニッチ止まりだった。センサーが毎日の肌の下準備を要求するなら、それはもう入力周辺機器ではなく医療機器を作ってしまっている。
RFセンシング:口の内側を外から読む
いま勢いを増しているアプローチは、電極を電波に置き換える。仕組みはこうだ。メガネのフレームに埋め込まれたアンテナが、Bluetoothに近い周波数の低出力電波を発し、それが顔を通り抜ける。電波が舌、唇、軟口蓋といった動く組織を横切ると、微細で構造的な変調を受ける。受信アンテナが乱れた信号を拾い、ニューラルネットワークがその乱れをテキストに対応づけることを学習する。Wi-Fiを使ったジェスチャー認識や、GoogleがPixel 4でハンドジェスチャーに使ったレーダーと同じ系統の物理だが、対象ははるかに繊細だ。
RFの強みは、カメラや皮膚電極には見えないものが見えることにある。唇を閉じてしまえば舌は外からは見えないが、舌は大きく水分を多く含む筋肉で、電波と強く相互作用する。会議中に人が本当に使いたがる、控えめな唇を閉じたままの内的発話は、この種の透過組織型の手段でしか捉えられない。製品の論理は一文に集約される。EMGとカメラは調音の外側を捉え、RFは内側を捉える。
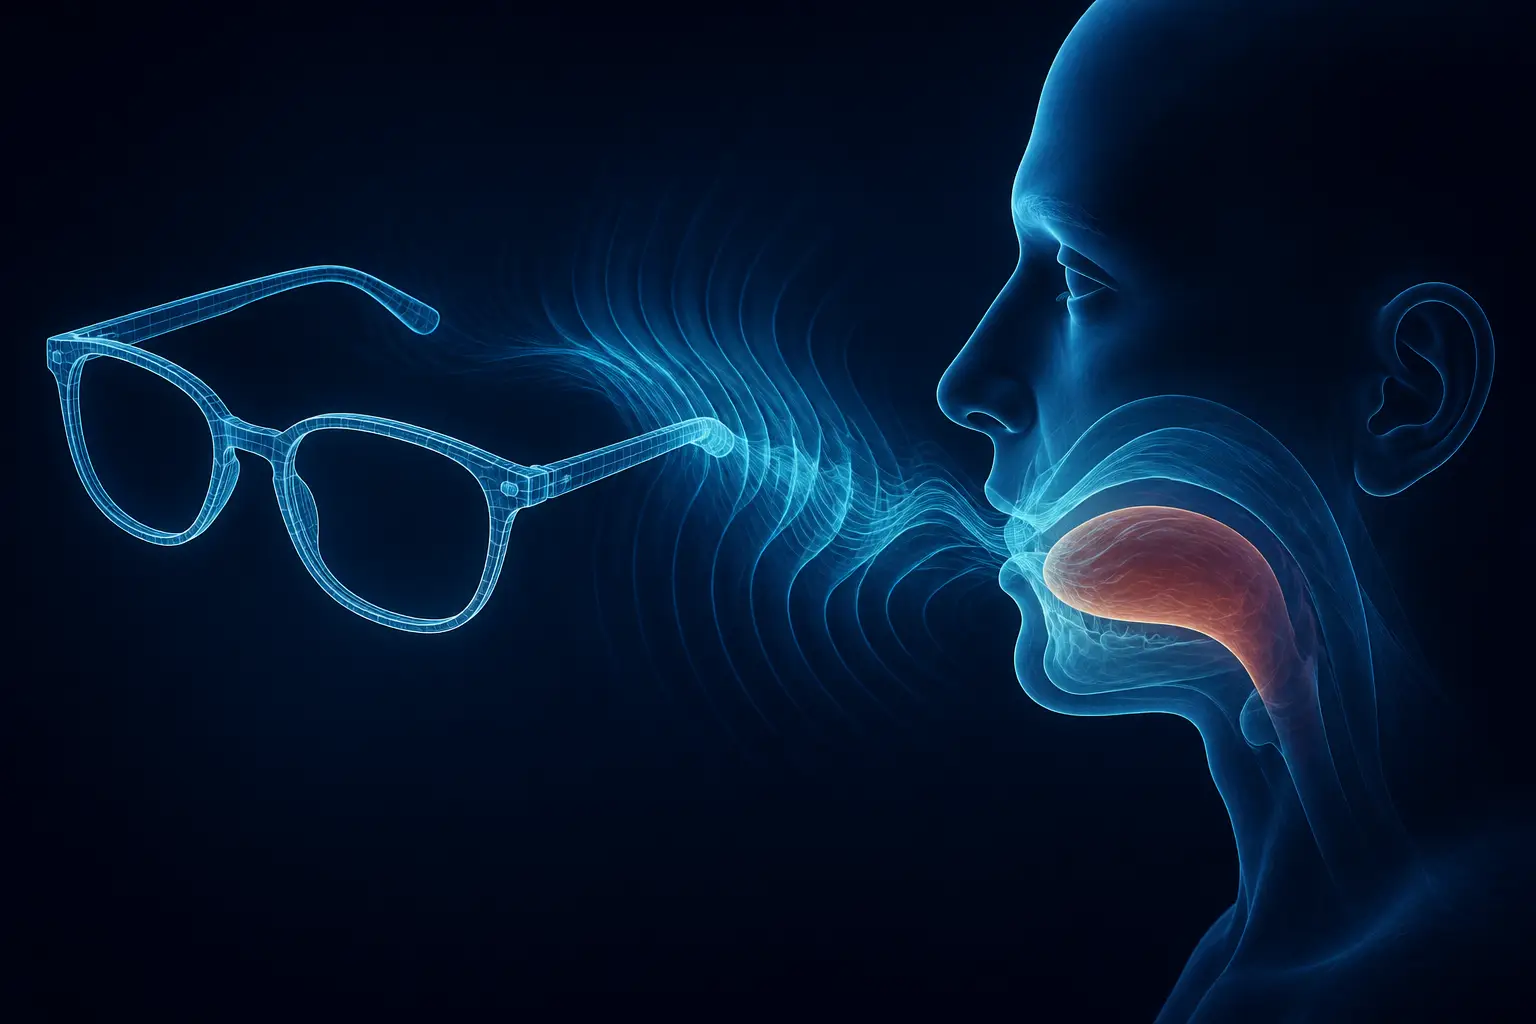
そこに至るまでの工学は、甘くない。求める信号は搬送波に乗った微弱な変調なので、RFフロントエンド全体が非常に低ノイズでなければならない。アンテナ配置は、厳しい最適化問題だ。電磁界が調音器官に最大限重なる必要があり、つまりシミュレーションを多用したフレーム設計になり、アンテナ位置がミリ単位で変わるだけで、システムが聞き取れるものが変わる。現在のグラスのプロトタイプを作るチームは、最初のグラス統合型の試みが完全に失敗したと認めている。その後は顔にアンテナをテープで貼る方式に戻り、形状を一定に保つための固定ヘッドリグを使い、シミュレーションでようやくフレームが正しくなった。テープ、リグ、製品という流れこそ、実際に出荷されるハードウェアの正直な発掘史だ。
カメラと超音波:脇役だが、ニッチは確かにある
カメラによる方式、つまり視覚的な読唇術は、研究の歴史が最も深い。LipNetは数年前に、動画からの文レベルの読唇をエンドツーエンドで実証し、オープンソースのプロジェクトはWebカメラと顔トラッカーでこの手法を再現し続けている。想像しうる中で最も安価なセンサーだ。カメラは既に三台は持っているのだから。しかし、顔の外側しか見えないという厳しい制約を引きずる。唇を閉じた内的発話は定義上見えず、照明や頭の角度が入力を絶えず乱し、一日中自分の顔にカメラを向けることには、プライバシーとバッテリーのコストがつきまとう。読唇は音声認識を補強するものとしては依然として優秀で、音声と映像を組み合わせたモデルは、ノイズの中で音声単独のモデルを実際に上回る。しかし単独の無声インターフェースとしては、「明らかに口を動かしている」側の端に限定される。
超音波は、もっと奇妙な中間的な立ち位置にある。学術系のシステムは、顎に向けた超音波トランスデューサーで、エコーから舌の動きを再構成してきた。舌の超音波画像化は、音声学研究では正式な標準ツールであり、母音がどう作られるかを何十年も観察してきた手段でもある。センシングは良好だ。しかしフォームファクターがだめだ。顎に密着させる超音波プローブを、朝会に着けていけるものにまとめる方法は誰も見つけていない。空気を介した音響結合は損失が大きく、角度にも敏感だ。私の見立てでは、超音波は臨床の言語療法や音声学研究室には正解だが、コンシューマー向け入力としては不正解だ。
点数をつけるなら、トレードオフ表はおおむねこうなる。
- EMG:筋肉の信号を直接取得でき、帯域も良好。しかし汗、ドリフト、装着位置、顔に電極を貼る必要性によって台無しになる。
- カメラによる読唇:ハードウェアコストはゼロで、モデルも成熟している。しかし唇を閉じた発話は見えず、照明に弱く、プライバシー面でも厳しい。
- 超音波:舌を直接画像化する。しかし結合とフォームファクターのせいで、研究室の計測機器にとどまる。
- RFの顔透過センシング:皮膚を通して内部の調音器官を捉え、グラスに組み込める。ただし特殊な低ノイズRFスタックと膨大な学習データを必要とする。
信号対雑音比の問題は、音声入力の問題とは別物だ
これらのデバイスについて初めて聞いたとき、多くの人が犯しがちな概念的な誤りがある。空気を抜いた音声認識だと思ってしまうことだ。違う。音声入力は、コミュニケーションのために自然が設計した信号、つまり部屋を渡って音素を運ぶために進化が形作った、数十デシベルのクリーンな圧力波に乗っている。ASRの難しい部分はアクセント、語彙、ノイズ除去だ。信号そのものは豊かだ。
無声音声のセンシングは、その正反対の性質を持つ。搬送波は、マイクロボルト単位の筋電であれ微弱なRF変調であれ、言語を符号化するためのものではなかった。音素情報はセンサーのチャンネル全体に、きれいな対応関係なしに広がっており、ノイズ源は音響的ではなく生理的だ。唾を飲む、顎を食いしばる、頭を回す、顔に触れる。どれも一時的な信号を注入し、それが調音信号を簡単に上回る。ASRがうるさい部屋と戦うなら、無声音声システムは自分の身体と戦っている。あなた自身がノイズフロアなのだ。
その結果、二つのことが言える。第一に、これらのシステムは音声入力よりずっと言語モデルに頼る。ある音素に対するセンサーの証拠があいまいなとき、デコーダーは「本当は何を言いたかったのか」という事前知識で解決する。これは、制約付きデコーディングがあいまいなモデル出力を確実な判断に変えるのに非常に効果的なのと同じ手口だ。無声音声システムは、予測しやすいテキスト(コマンド、自分の口調で書くメール)では不気味なほど良いが、事前知識では弱い信号を救えない稀な単語、固有名詞、コードの識別子では目に見えて劣ると思っておくといい。第二に、キャリブレーションは偶発的な問題ではなく構造的な問題だ。音声ASRが話者間で汎化したのは数十年前のことで、それは波形は波形だからだ。顔のRFシグネチャーはそうではない。それがこの分野で最も難しい問題につながる。
顔ごとに違うアンテナ問題
ユーザー間の汎化は、無声音声のプロトタイプが死んでいく場所だ。顎の長さ、舌の大きさ、組織の密度、皮膚の厚さといった顔の解剖学的構造は大きく異なり、その変数の一つひとつが信号の形を変える。自分の顔で学習したモデルが、他人の顔ではほとんど役に立たないことがある。初期のEMG研究の文献には、「被験者ごと、キャリブレーション後」なら精度が高いと報告するシステムがあふれている。その但し書きは、静かに製品を埋葬している。使う前に一人ひとり一時間の学習が必要なデバイスは、研究デモであって周辺機器ではない。
現在のRFの取り組みで私が本当に面白いと思うのは、彼らがまず賢い道を試したことだ。アルゴリズムによるドメイン適応や信号の正規化といった工夫だ。そして、効く手段は結局、事前学習の規模を力ずくで大きくすることだけだと結論づけた。そこで社内に録音ブースを作り、人を雇ってグラスをかけたままプロンプトを読んでもらい、データセットが大きくなるにつれて誤り率がきれいなスケーリング曲線に沿って下がっていくのを確認した。報告によると、新しいユーザーはおよそ二十文の校正用の文を読めば、システムがうまく動くという。この数字は、どんな精度の数字よりも重要だ。二十文ならオンボーディングとして我慢できる。一時間の読み取りは返品依頼だ。
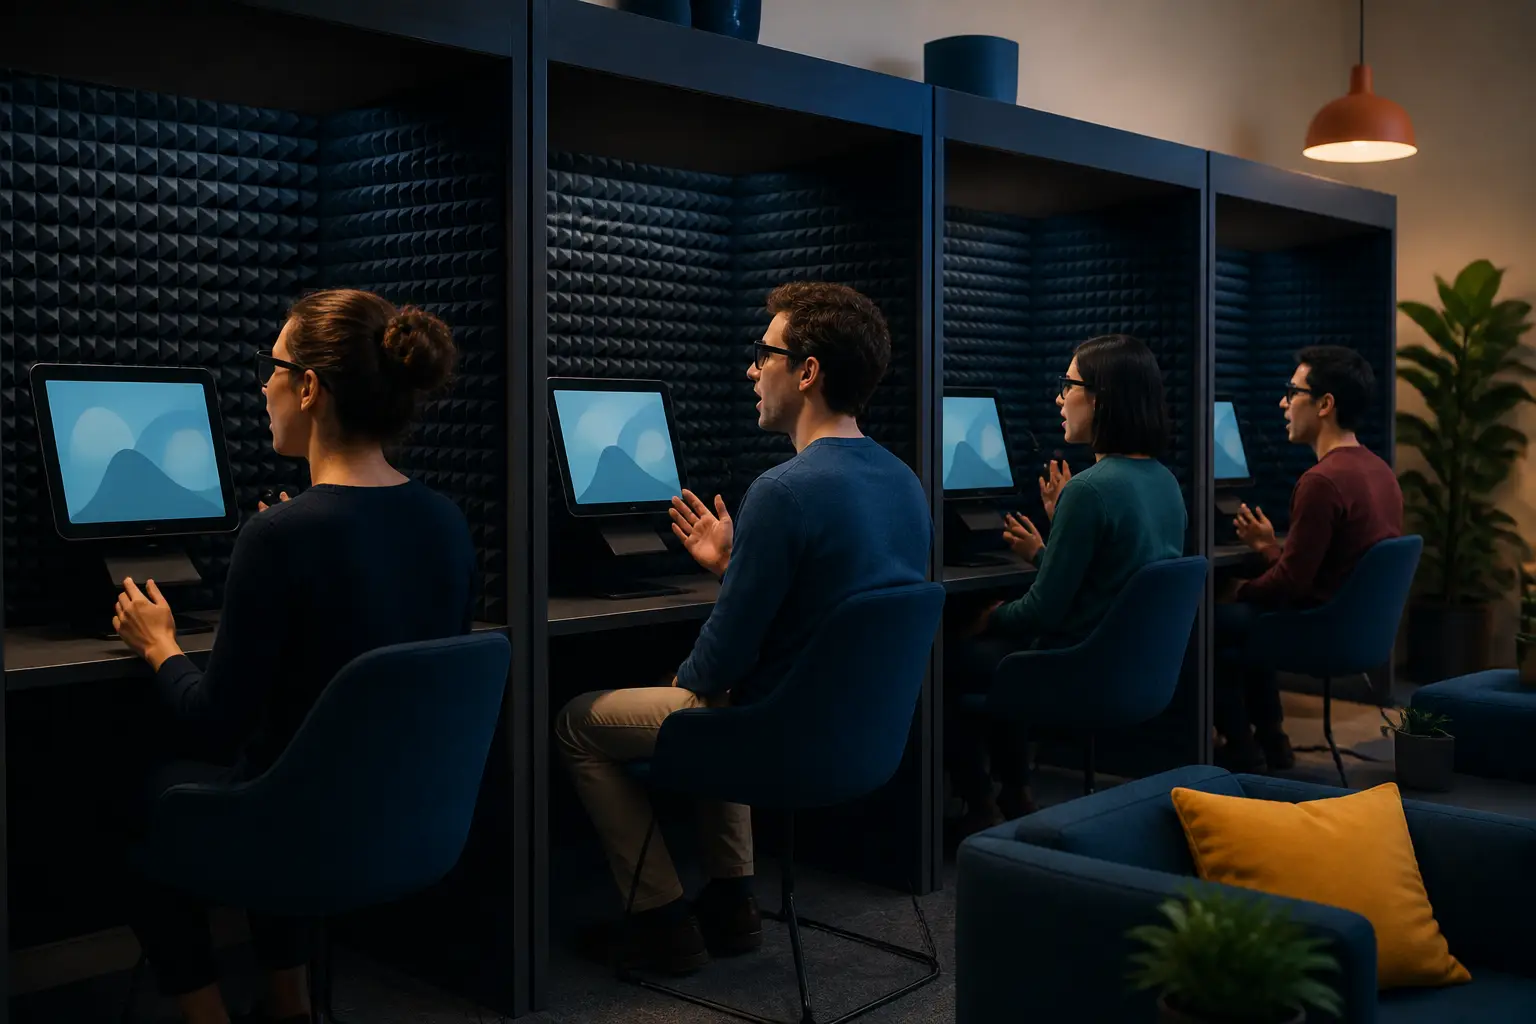
これは機械学習の他の分野が繰り返し教えてくれることと同じだ。モデルが汎化しないとき、答えはたいてい賢いアーキテクチャではなく、より多様なデータである。音声認識でも、低リソース言語の機械翻訳でも、入力分布がユーザーごとにずれるあらゆる領域で、この展開を見てきた。無声音声は、「マイク」が一部ユーザー自身でできているため、ユーザーごとのずれが特に厄介なだけだ。
無声音声が本当に勝てる場所
目新しさを取り払えば、用途ははっきりした階層に分かれる。最上位はアクセシビリティだ。反復性ストレス障害を抱え、両手根管の手術を受けようとしている開発者や、音声入力が社会的に不可能なオープンオフィスに戻る人たちがいる。彼らにとって、これはガジェットではなく、働けるかどうかの差だ。喉頭摘出者や、ALSに近い発話の喪失を抱える人々は、同じ話のより深く重要なバージョンだ。この技術の誠実な評価は、そこに大きな重みを置くべきだ。
第二に、騒がしい環境。これは直感に反する方だ。音響をまったく無視するセンシング手法は、芝刈り機もサーバールームも工場の床も気にしない。音声が失敗する場所こそ、RFセンシングが無関心でいられる場所だ。第三に、慎み深さ。図書館、オープンオフィス、電車の中での口述だ。これは主流のコンシューマー向けの訴求で、確かに本物だが、三つの中で最も弱いと私は思う。社会的な快適さの機能であって、能力の解放ではないからだ。
トレードオフについての私の立場はこうだ。この技術が、そのフォームファクターに見合うのは、推論がオンデバイスか、少なくともオフラインで動く場合だけだ。閉じた口の中で動く舌を監視し、生データをクラウドAPIに流し続けるセンサーは、誰も受け入れるべきではないプライバシー設計だ。不随意の信号が漏れることを心配するコメントの人々は、正当な不満を持っている。もっとも、より推測的な恐れのいくつかは誇張されているが。良いニュースは、デコードモデルがローカルで動くほど小さいことだ。この分野は、オフラインファースト設計をプレミア機能ではなく必須条件として扱うべきだ。ウェイクワードに相当する仕組みも重要だ。グラスは、耳を傾ける前に、意図的な物理的合図(ジェスチャーや顎の食いしばりのパターン)を必要とすべきだ。さもないと、あなたの不随意な口の動きをすべて文字起こしするウェアラブルを作ってしまうことになる。
ここには古い話の響きがあり、どうしても触れたくなる。1870年代の電信技士は、リレーのカチカチという音を聞いてメッセージを読み取ることを覚えた。誰も設計していない入力チャンネルだ。インターフェースの歴史は、誰かがデコーダーを作った瞬間に、こうした副次的チャンネルが第一級のチャンネルへと昇格する話で満ちている。サブボーカルの筋肉のざわめきは、人が内なる独り言を持って以来、読書や思考について漏らし続けてきた副次的チャンネルだ。それを入力デバイスに変えることは、発明というより昇格に近い。スケーリング曲線が維持されるなら、図書館で一番静かな人が、もっともタイピングを進める人になるかもしれない。