Interfacce Silent Speech: perché l'RF batte gli elettrodi
Le interfacce silent speech leggono le parole mimate da segnali muscolari e RF. Sensori e rapporto segnale-rumore le rendono diverse dalla dettatura.
 James Whitfield
Sei in biblioteca, l'app di dettatura è attiva, e hai appena mimato per quattro volte la stessa email nel laptop come un pazzo, perché parlare ad alta voce ti farebbe guardare da tutto il piano. Le interfacce silent speech esistono proprio per questo momento: sistemi che decodificano le parole che mimi, o anche solo che intendi mimare, senza che esca dal tuo corpo un solo suono udibile. Una nuova ondata di startup scommette che il dispositivo di input mancante nell'era dell'AI non sia un microfono migliore. È nessun microfono.
L'idea è più vecchia di quanto suggeriscano le demo attuali. I ricercatori della NASA sperimentavano il riconoscimento subvocale a metà degli anni 2000, in origine per astronauti ed equipaggi di volo che lavoravano in ambienti rumorosi o con tute pressurizzate. Il Media Lab del MIT l'ha reso famoso con AlterEgo nel 2018, un headset indossabile che catturava i segnali neuromuscolari di mascella e viso. Ciò che è cambiato di recente non è il concetto: è che hardware radio economico, machine learning migliore e la diffusione improvvisa dell'AI vocale hanno convergito rendendo l'ingegneria quasi praticabile. Quasi. Il problema del rapporto segnale-rumore qui è davvero brutale, e il modo in cui i team lo risolvono determina tutto del prodotto che finiscono per rilasciare.
Parlare senza suono: cos'è davvero la subvocalizzazione
Vale la pena chiarire un po' di terminologia, perché il settore confonde tre cose diverse. Primo, c'è il mimare: articolazione completa con labbra, lingua e mascella, solo senza voce. Secondo, c'è il parlato interno: labbra chiuse, ma lingua e palato molle che si muovono deliberatamente come per formare parole. Terzo, c'è la vera subvocalizzazione, la debole attivazione muscolare involontaria che avviene quando leggi o pensi in parole. Quest'ultima è la versione da fantascienza, ed è appena rilevabile fuori da un laboratorio. I prodotti funzionanti oggi stanno nelle prime due categorie. Un team che costruisce occhiali con sensing RF descrive il comportamento target come «mimare con le labbra chiuse», un ibrido strano che gli utenti apparentemente imparano in poche sessioni.
Da appassionato di linguistica, trovo la linguistica qui deliziosa. L'articolazione è un programma motorio che il cervello esegue indipendentemente dal fatto che le corde vocali vibrino. La fonazione è solo una fase della produzione del parlato, quella in cui la laringe aggiunge energia acustica. Togliila e resta tutta la coreografia a monte: posizione della lingua per le vocali, arrotondamento delle labbra, controllo del velo palatino per le nasali. Un'interfaccia silent speech cerca essenzialmente di ricostruire la sequenza dei fonemi dai residui di quella coreografia, come dedurre una melodia guardando le dita di un pianista su un pianoforte muto. È lettura labiale vista dall'interno.
Questa impostazione conta perché ti dice cosa devono misurare i sensori. Nessuno legge la tua mente. Ogni sistema che funziona si aggancia a qualche correlato fisico dell'articolazione — impulsi elettrici, movimento dei tessuti o energia riflessa — e la scelta di quale correlato inseguire è la decisione ingegneristica che definisce tutto.
EMG: il sensore ovvio che ti tradisce
L'elettromiografia è da dove quasi tutti partono, perché la logica è irresistibile. I muscoli si attivano perché i motoneuroni rilasciano potenziali elettrici attraverso le membrane; applica un elettrodo sulla pelle sopra il muscolo giusto e puoi osservarlo. L'EMG di superficie è una tecnica matura: le protesi degli arti sono controllate da segnali muscolari residui da decenni. Per un hackathon del weekend puoi letteralmente attaccare elettrodi al viso, collegarli a un amplificatore e ottenere qualcosa che lampeggia in rozza corrispondenza con lettere mimate. Diversi prototipi di silent speech sono stati costruiti esattamente così, incluso il celebre AlterEgo del MIT e, a quanto si dice, il primo tentativo grezzo del team che oggi realizza gli occhiali RF.
Poi la realtà interviene, con un elenco deprimentemente prevedibile di modalità di guasto:
- Sudore. La conducibilità della pelle cambia mentre sudi, quindi la stessa parola mimata sembra diversa alle 9 del mattino e dopo pranzo. La tua calibrazione si degrada continuamente sotto di te.
- Interferenze elettriche. I segnali EMG facciali sono nell'ordine dei microvolt. Linee elettriche vicine, l'alimentatore a commutazione del laptop, perfino il battito di ciglia possono sommergerli.
- Variabilità di posizionamento. Uno spostamento di due millimetri dell'elettrodo cambia quali fibre muscolari dominano la lettura. Togli il dispositivo e rimettilo, e il modello di ieri misura una persona leggermente diversa.
- Il deal-breaker estetico. Nessuno indosserà elettrodi in gel sul viso in pubblico. Sembra banale; ha comunque ucciso l'approccio.
Quel dettaglio finale merita rispetto. L'hardware di consumo fallisce per attrito molto più spesso che per fisica. La storia dei wearable è un cimitero di dispositivi che funzionavano in laboratorio e chiedevano un passaggio in più del dovuto all'utente. Auricolari a conduzione ossea, cardiofrequenzimetri a fascia toracica, fascette EEG: tutti tecnicamente validi, tutti di nicchia. Quando il tuo sensore richiede una preparazione quotidiana della pelle, hai costruito un dispositivo medico, non una periferica di input.
Sensing RF: leggere la bocca dall'interno
L'approccio che sta guadagnando terreno oggi sostituisce gli elettrodi con la radio. L'idea: antenne incorporate nelle montature degli occhiali emettono onde radio a bassa potenza, a frequenze vicine al Bluetooth, che attraversano il viso. Quando le onde attraversano tessuti in movimento — lingua, labbra, palato molle — vengono modulate in modi minuscoli e strutturati. Le antenne riceventi captano il segnale perturbato, e una rete neurale impara a mappare quelle perturbazioni in testo. È la stessa famiglia di fisica del sensing gestuale basato su Wi-Fi e del radar che Google ha montato sul Pixel 4 per i gesti della mano, puntato però su un bersaglio molto più sottile.
Il vantaggio è che l'RF vede ciò che telecamere ed elettrodi cutanei non possono. La lingua è invisibile dall'esterno quando le labbra sono chiuse, ma è un grande muscolo ricco d'acqua con cui le onde radio interagiscono fortemente. Il parlato interno a labbra chiuse — la modalità discreta che le persone vogliono davvero in riunione — è raggiungibile solo con una modalità attraverso i tessuti come questa. È l'intero argomento di prodotto in una frase: EMG e telecamere catturano l'esterno dell'articolazione, l'RF cattura l'interno.
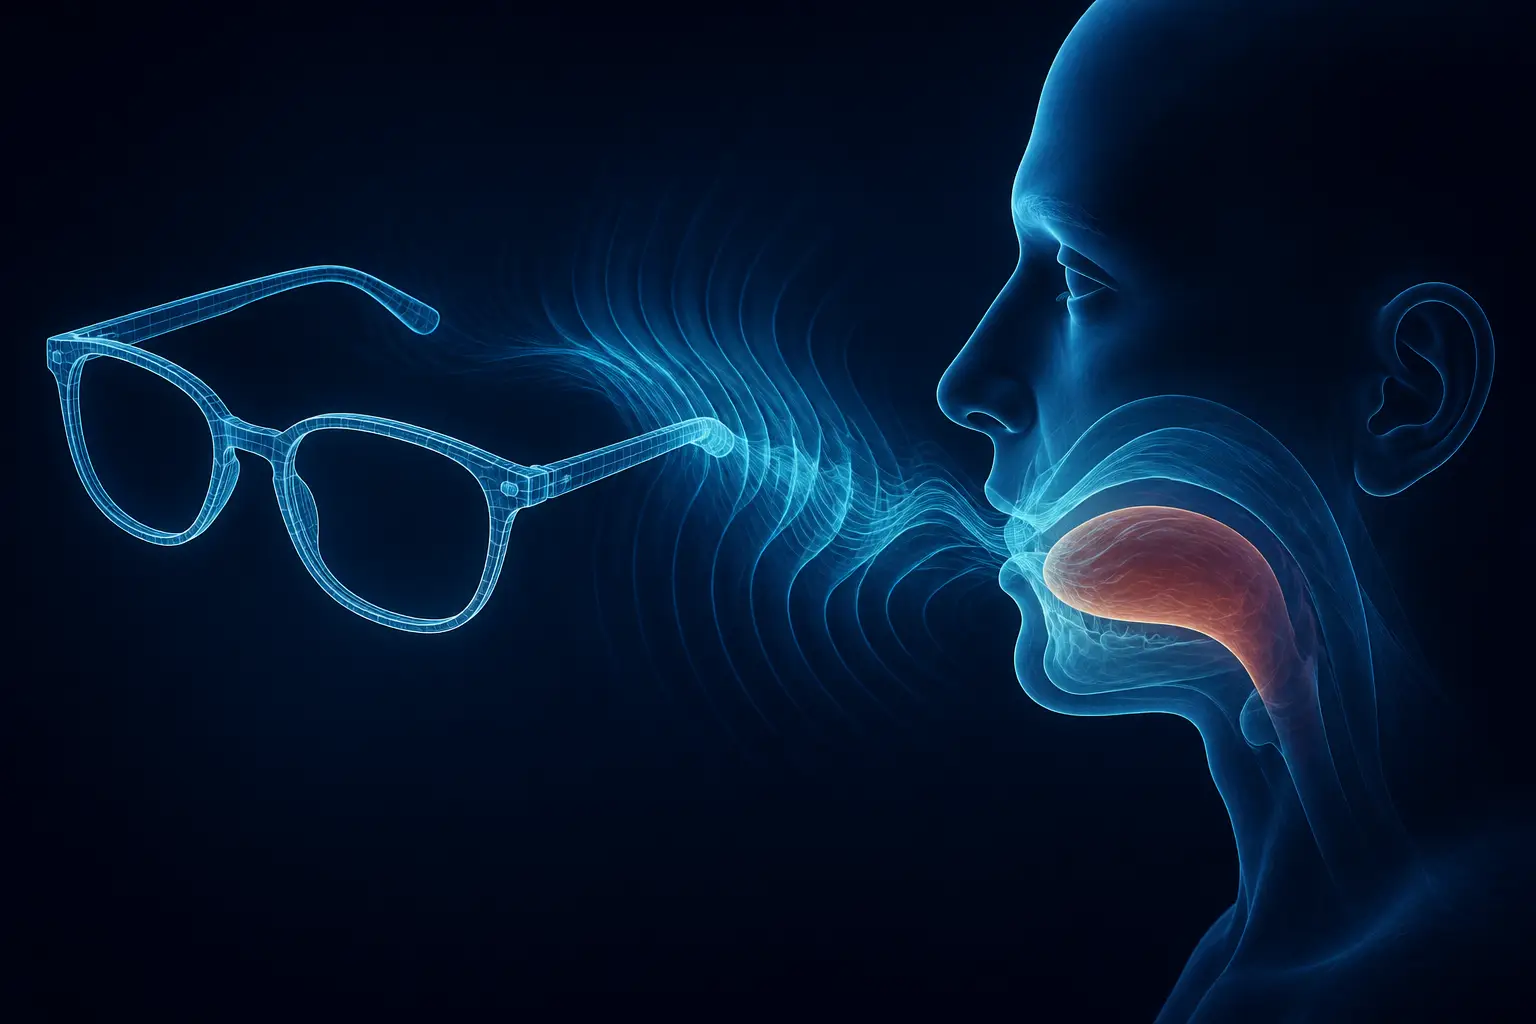
L'ingegneria per arrivarci non è morbida. Il segnale che cerchi è una modulazione debole sovrapposta a una portante, quindi l'intera parte RF deve essere straordinariamente a basso rumore. Il posizionamento delle antenne è un problema di ottimizzazione tosto: i campi elettromagnetici devono sovrapporsi il più possibile agli articolatori, il che significa un design delle montature molto basato su simulazioni, dove pochi millimetri di posizione dell'antenna cambiano ciò che il sistema riesce a sentire. Il team che costruisce l'attuale prototipo di occhiali ammette che il primo tentativo integrato negli occhiali è fallito completamente, e sono tornati ad attaccare antenne al viso, poi a una struttura rigida per tenere fissa la geometria, prima che il lavoro di simulazione producesse montature corrette. Quella progressione — nastro, struttura, prodotto — è l'archeologia onesta di un hardware che arriva davvero sul mercato.
Telecamere e ultrasuoni: i comprimari con nicchie reali
La strada delle telecamere — la lettura labiale visiva — ha il pedigree di ricerca più profondo. LipNet ha dimostrato anni fa la lettura labiale end-to-end a livello di frase da video, e progetti open source continuano a replicare il trucco con una webcam e un tracciatore del volto. È il sensore più economico immaginabile: hai già tre telecamere. Ma eredita il vincolo brutale che vede solo l'esterno del viso. Il parlato interno a bocca chiusa è invisibile per definizione, luce e angolo della testa corrompono continuamente l'input, e puntare una telecamera sul proprio viso tutto il giorno ha costi di privacy e batteria che non scompaiono mai. La lettura labiale resta eccellente come supporto al riconoscimento vocale audio — i modelli audiovisivi superano davvero quelli solo audio nel rumore — ma come interfaccia silent autonoma è confinata all'estremità del «chiaramente mimare» dello spettro.
Gli ultrasuoni occupano una zona intermedia più strana. Sistemi accademici hanno puntato trasduttori ultrasonici sulla mascella e ricostruito il movimento della lingua dagli echi, e l'imaging ultrasonico della lingua è letteralmente uno strumento standard nella ricerca fonetica — è così che per decenni abbiamo osservato la formazione delle vocali. Il sensing è buono. La forma no. Nessuno ha ancora capito come impacchettare una sonda ultrasonica appoggiata al mento in qualcosa che indosseresti a una riunione in piedi, e l'accoppiamento acustico attraverso l'aria è dispersivo e sensibile all'angolo. La mia lettura: gli ultrasuoni sono la risposta giusta per la logopedia clinica e i laboratori di fonetica, e quella sbagliata per l'input di consumo.
Se stai tenendo il punteggio, la tabella dei compromessi somiglia più o meno a questa:
- EMG: segnale muscolare diretto, buona banda — rovinato da sudore, deriva, posizionamento e dalla necessità di indossare elettrodi sul viso.
- Lettura labiale con telecamera: costo hardware zero, modelli maturi — ciechi al parlato a bocca chiusa, fragili alla luce, ostili alla privacy.
- Ultrasuoni: riprendono direttamente la lingua — accoppiamento e forma ne fanno uno strumento da laboratorio.
- Sensing RF attraverso il viso: vede gli articolatori interni attraverso la pelle, si integra negli occhiali — richiede uno stack RF esotico a basso rumore e montagne di dati di addestramento.
Il problema del rapporto segnale-rumore non è il problema della dettatura
Ecco l'errore concettuale che molti di noi fanno la prima volta che sentono parlare di questi dispositivi: si presume che sia riconoscimento vocale meno l'aria. Non è così. La dettatura audio si basa su un segnale che la natura ha progettato per la comunicazione — decine di decibel di onda di pressione pulita, plasmata dall'evoluzione per portare fonemi attraverso una stanza. Le parti difficili dell'ASR sono accenti, vocabolario e reiezione del rumore. Il segnale in sé è generoso.
Il silent speech ha il profilo opposto. La portante — che sia la manciata di microvolt dell'EMG o una debole modulazione RF — non è mai stata pensata per codificare il linguaggio. L'informazione sui fonemi è spalmata su canali di sensori senza una mappatura pulita, e i disturbi sono fisiologici, non acustici. Deglutire, stringere la mascella, girare la testa, toccarsi il viso: ciascuno introduce un transitorio che può oscurare il segnale dell'articolazione. Dove un sistema ASR combatte una stanza rumorosa, un sistema silent speech combatte il proprio corpo. Sei tu il rumore di fondo.
Ne seguono due conseguenze. Primo, questi sistemi si appoggiano molto più pesantemente al modello linguistico rispetto alla dettatura. Quando l'evidenza del sensore per un fonema è ambigua, il decoder la risolve con priors su cosa probabilmente volevi dire — lo stesso trucco che rende il constrained decoding così efficace nel trasformare output sfocati dei modelli in decisioni affidabili. Aspettati che i sistemi silent speech siano stranamente bravi su testi prevedibili (comandi, email nel tuo stile) e sensibilmente peggiori su parole rare, nomi e identificatori di codice, dove il prior non può salvare un segnale debole. Secondo, la calibrazione è strutturale, non incidentale. L'ASR audio si è generalizzato tra parlanti decenni fa perché una forma d'onda è una forma d'onda. Una firma RF facciale non lo è — e questo ci porta al problema più difficile del settore.
Ogni viso è un problema d'antenna diverso
La generalizzazione tra utenti è dove i prototipi di silent speech vanno a morire. L'anatomia facciale — lunghezza della mascella, dimensione della lingua, densità dei tessuti, spessore della pelle — varia enormemente, e ogni variabile rimodella il segnale. Un modello addestrato sul mio viso può essere quasi inutile sul tuo. La letteratura EMG delle origini è piena di sistemi che riportano un'accuratezza eccellente «per soggetto, dopo calibrazione», una precisazione che silenziosamente seppellisce il prodotto. Un dispositivo che richiede un'ora di addestramento per utente prima di funzionare è una demo di ricerca, non una periferica.
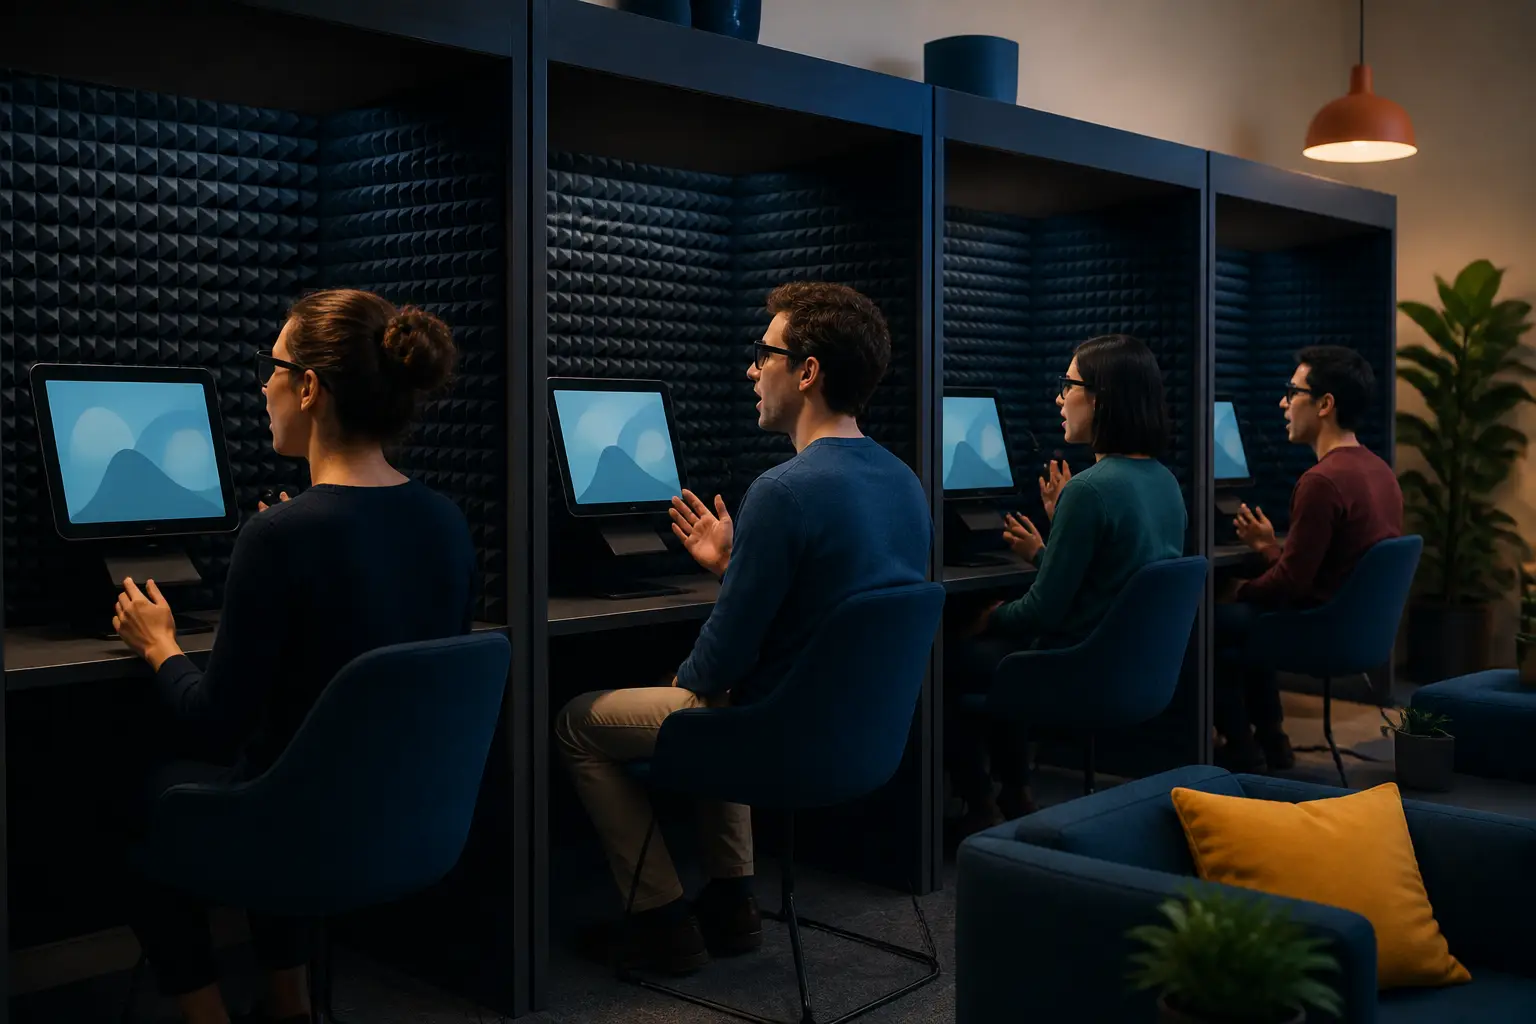
Ciò che trovo davvero interessante nello sforzo RF attuale è che hanno provato prima la strada intelligente — adattamento di dominio algoritmico, trucchi di normalizzazione del segnale — e hanno concluso che l'unica leva che funziona è la scala brutale del pretraining. Così hanno costruito cabine di registrazione nel loro ufficio, pagato persone per leggere prompt indossando gli occhiali, e osservato i tassi d'errore scendere lungo una curva di scala pulita man mano che il dataset cresceva. Il risultato riportato: un nuovo utente ha bisogno di circa venti frasi di calibrazione prima che il sistema funzioni bene. Quel numero conta più di qualsiasi cifra di accuratezza. Venti frasi sono un onboarding tollerabile; un'ora di letture è una richiesta di rimborso.
È la stessa lezione che il resto del machine learning continua a ribadire: quando un modello non generalizza, la risposta di solito sono dati più diversi, non un'architettura più intelligente. L'abbiamo vista accadere nel riconoscimento vocale, nella traduzione automatica per le lingue a basse risorse, e in ogni dominio in cui la distribuzione dell'input cambia per utente. Il silent speech ha semplicemente uno spostamento per utente particolarmente vizioso, perché il «microfono» è in parte fatto dall'utente.
Dove il silent speech vince davvero
Tolta la novità, i casi d'uso si dispongono in una gerarchia chiara. In cima: l'accessibilità. C'è un pubblico di sviluppatori con lesioni da sforzo ripetitivo che affrontano un doppio intervento per la sindrome del tunnel carpale, persone che tornano in open space dove la dettatura è socialmente impossibile — per loro non è un gadget, è la differenza tra lavorare e non lavorare. I pazienti laringectomizzati e le persone con perdita della parola affini alla SLA sono la versione più profonda e importante della stessa storia. Qualsiasi valutazione onesta di questa tecnologia dovrebbe pesarla molto.
Secondo: gli ambienti rumorosi, che è quello controintuitivo. Una modalità di sensing che ignora del tutto l'acustica non si preoccupa del tuo tagliaerba, della tua sala server o del tuo reparto di produzione. La voce fallisce proprio dove il sensing RF è indifferente. Terzo: la discrezione — dettare in biblioteca, in open space, in treno. È la proposta mainstream per i consumatori, ed è reale, ma la considero la più debole delle tre perché è una funzione di comfort sociale più che uno sblocco di capacità.
La mia posizione sui compromessi: questa tecnologia giustifica la sua forma solo se l'inferenza avviene sul dispositivo o almeno è possibile offline. Un sensore che osserva la tua lingua muoversi dentro la bocca chiusa, inviando dati grezzi a un'API cloud, è un'architettura di privacy che nessuno dovrebbe accettare — chi teme la fuga di segnali involontari ha una lamentela legittima, anche se alcuni timori più speculativi sono esagerati. La buona notizia è che i modelli di decodifica sono abbastanza piccoli da girare in locale; il settore farebbe bene a trattare il design offline-first come requisito minimo e non come fascia premium. Anche i equivalenti della parola di attivazione contano: gli occhiali hanno bisogno di un segnale di intenzione deliberato e fisico (un gesto, uno schema di serramento della mascella) prima di ascoltare, altrimenti hai costruito un indossabile che trascrive ogni movimento involontario della bocca.
C'è un'eco più antica che non posso evitare. Negli anni 1870 i telegrafisti imparavano a leggere i messaggi dal suono dello scatto del relè, un canale di input che nessuno aveva progettato. La storia delle interfacce è piena di questi canali laterali che diventano canali di prima classe appena qualcuno costruisce il decoder. Il brusio muscolare subvocale è un canale laterale della lettura e del pensiero che gli esseri umani perdono da quando hanno un monologo interiore. Trasformarlo in dispositivo di input è meno un'invenzione che una promozione — e se le curve di scala reggono, la persona più silenziosa della biblioteca potrebbe presto essere quella che scrive di più.