Interfaces de Fala Silenciosa: RF vs. Eletrodos
Interfaces de fala silenciosa decodificam palavras articuladas via sinais musculares e RF. Veja por que sensores e ruído as tornam diferentes do ditado.
 James Whitfield
Você está na biblioteca, com o app de ditado rodando, e acabou de articular o mesmo e-mail quatro vezes para o notebook feito um maluco, porque falar em voz alta faria o andar inteiro te encarar. As interfaces de fala silenciosa existem exatamente para esse momento: sistemas que decodificam as palavras que você articula, ou até apenas pensa em articular, sem que um único som saia do seu corpo. Uma nova leva de startups aposta que o dispositivo de entrada que falta na era da IA não é um microfone melhor. É nenhum microfone.
A ideia é mais antiga do que a onda atual de demos sugere. Pesquisadores da NASA já experimentavam reconhecimento subvocal no meio dos anos 2000, originalmente para astronautas e tripulações que trabalhavam em ambientes barulhentos ou com trajes pressurizados. O Media Lab do MIT a tornou famosa com o AlterEgo, em 2018, um headset vestível que captava sinais neuromusculares da mandíbula e do rosto. O que mudou recentemente não é o conceito. É que hardware de rádio barato, machine learning melhor e a popularização súbita da IA de voz convergiram para tornar a engenharia quase viável. Quase. O problema de relação sinal-ruído aqui é genuinamente brutal, e a forma como as equipes o resolvem determina tudo sobre o produto que acabam lançando.
Falar Sem Som: O Que é Subvocalização de Fato
Vale acertar uma terminologia útil, porque a área mistura três coisas diferentes. Primeiro, há a articulação sem voz: articulação completa com lábios, língua e mandíbula, só que sem voz. Segundo, há a fala interna: lábios fechados, mas a língua e o palato mole ainda se movem deliberadamente, como se formassem palavras. Terceiro, há a subvocalização de verdade, a ativação muscular fraca e involuntária que acontece quando você lê ou pensa em palavras. Esta última é a versão de ficção científica, e é quase impossível de detectar fora de laboratório. Os produtos que funcionam hoje vivem nas duas primeiras categorias. Uma equipe que constrói óculos com sensoriamento por RF descreve o comportamento-alvo como “articular com os lábios fechados”, um híbrido estranho que, pelo visto, os usuários aprendem em poucas sessões.
Como nerd de línguas, acho a linguística aqui deliciosa. A articulação é um programa motor que o cérebro executa independentemente de as pregas vocais vibrarem. A vocalização é apenas uma etapa da produção da fala, a parte em que a laringe adiciona energia acústica. Tire isso e toda a coreografia anterior continua: posição da língua para as vogais, arredondamento dos lábios, controle do véu palatino para as nasais. Uma interface de fala silenciosa basicamente tenta reconstruir a sequência de fonemas a partir do resíduo dessa coreografia, como deduzir uma melodia observando os dedos de um pianista num piano mudo. É leitura labial por dentro.
Esse enquadramento importa porque diz o que os sensores precisam medir. Ninguém está lendo sua mente. Todo sistema bem-sucedido se conecta a algum correlato físico da articulação, como impulsos elétricos, movimento de tecidos ou energia refletida, e a escolha de qual correlato perseguir é a decisão de engenharia que define tudo.
EMG: O Sensor Óbvio que Trai Você
A eletromiografia é por onde quase todo mundo começa, porque a lógica é irresistível. Os músculos disparam porque neurônios motores liberam potenciais elétricos através de membranas; cole um eletrodo na pele sobre o músculo certo e você consegue ver isso acontecer. A EMG de superfície é uma técnica madura: próteses de membros são controladas por sinais musculares residuais há décadas. Para um hackathon de fim de semana, você pode literalmente colar eletrodos no rosto, ligá-los a um amplificador e obter algo que oscila em correspondência aproximada com letras articuladas. Vários protótipos de fala silenciosa foram construídos exatamente assim, incluindo o famoso AlterEgo do MIT e, segundo consta, a primeira tentativa rudimentar da equipe que hoje lança óculos com RF.
Aí a realidade intervém, numa lista deprimentemente previsível de modos de falha:
- Suor. A condutividade da pele muda conforme você transpira, então a mesma palavra articulada parece diferente às 9h e depois do almoço. Sua calibração está se degradando continuamente por baixo de você.
- Interferência elétrica. Sinais de EMG facial estão na faixa de microvolts. Linhas de energia próximas, a fonte chaveada do seu notebook e até piscar podem submergi-los.
- Variabilidade de posicionamento. Um deslocamento de dois milímetros no eletrodo muda quais fibras musculares dominam a leitura. Tire o dispositivo e coloque de novo, e o modelde ontem estará medindo uma pessoa ligeiramente diferente.
- O impeditivo estético. Ninguém vai usar eletrodos de gel no rosto em público. Parece trivial; mesmo assim, matou a abordagem.
Esse último ponto merece respeito. Hardware de consumo falha por atrito muito mais do que por física. A história dos wearables é um cemitério de dispositivos que funcionavam no laboratório e exigiam um passo a mais do usuário. Headsets de condução óssea, monitores cardíacos de cinta no peito, faixas de EEG: tecnicamente sólidos, todos de nicho. Quando seu sensor exige preparação diária da pele, você construiu um dispositivo médico, não um periférico de entrada.
Sensoriamento por RF: Lendo a Boca por Dentro
A abordagem que ganha tração agora substitui eletrodos por rádio. A ideia: antenas embutidas em armações de óculos emitem ondas de rádio de baixa potência, em frequências próximas às do Bluetooth, que atravessam seu rosto. Conforme as ondas cruzam tecidos em movimento (língua, lábios, palato mole), elas são moduladas de maneiras minúsculas e estruturadas. Antenas receptoras captam o sinal perturbado, e uma rede neural aprende a mapear essas perturbações de volta para texto. É a mesma família de física do sensoriamento de gestos por Wi-Fi e do radar que o Google colocou no Pixel 4 para gestos com as mãos, só que apontado para um alvo muito mais sutil.
O apelo é que o RF enxerga o que câmeras e eletrodos de pele não conseguem. A língua é invisível de fora quando os lábios estão fechados, mas é um músculo grande e rico em água, com o qual ondas de rádio interagem fortemente. A fala interna de lábios fechados, o modo discreto que as pessoas realmente querem numa reunião, só é alcançável por uma modalidade que atravessa o tecido, como essa. Esse é o argumento inteiro do produto em uma frase: EMG e câmeras capturam o lado de fora da articulação; o RF captura o lado de dentro.
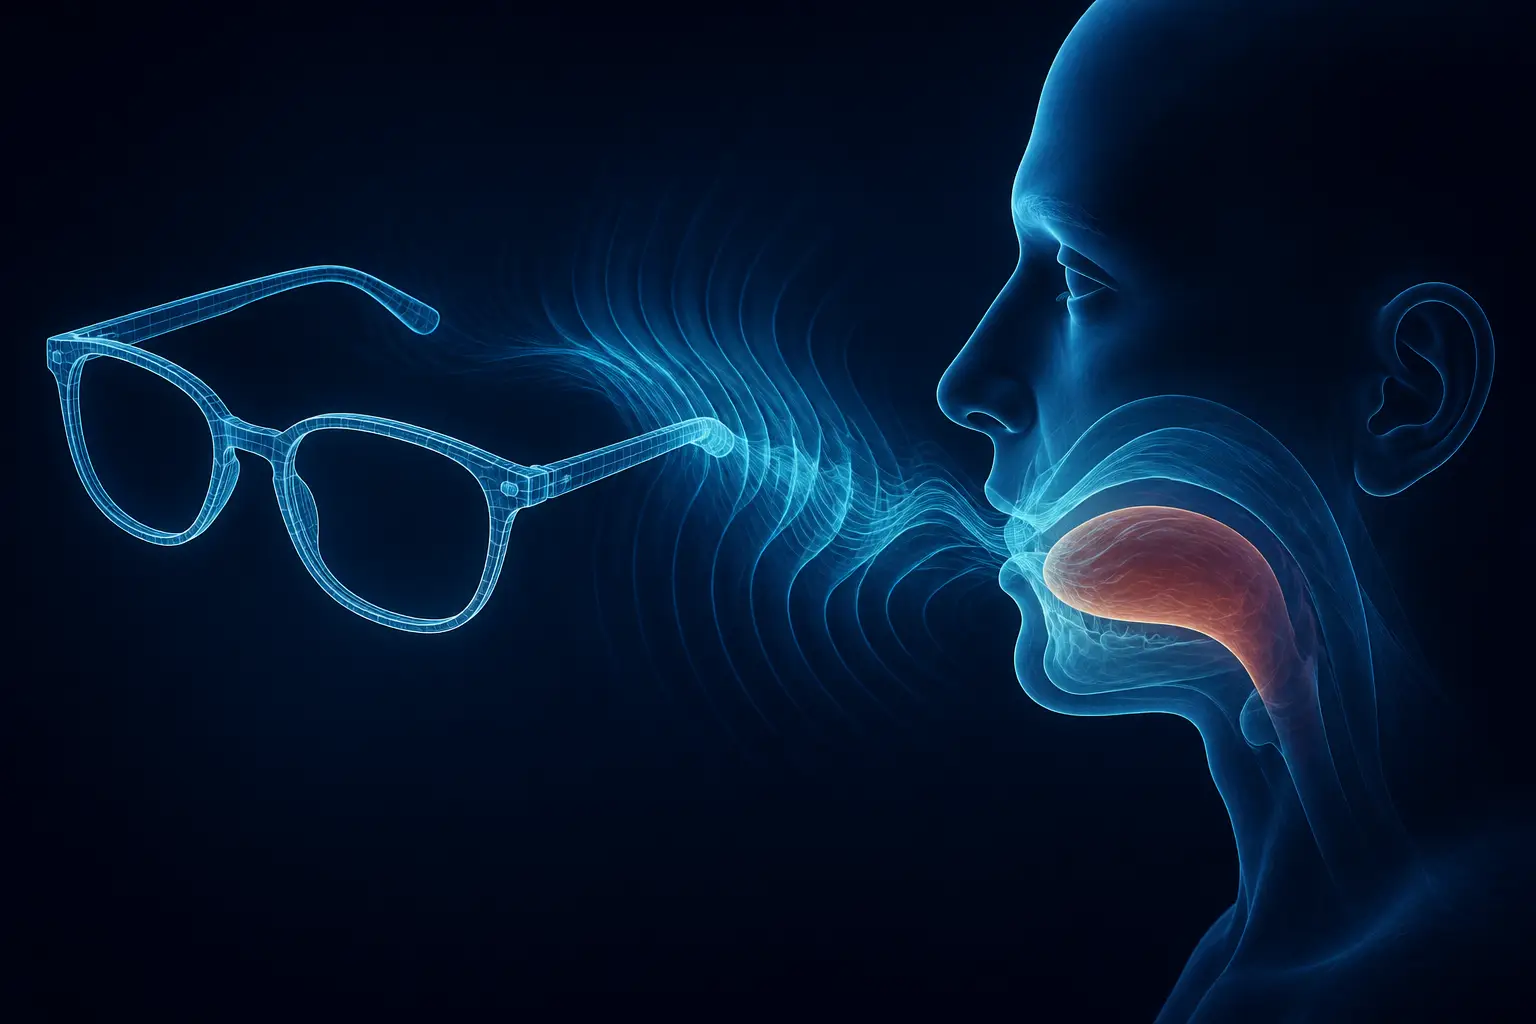
A engenharia para chegar lá não é gentil. O sinal que você busca é uma modulação fraca sobre uma portadora, então toda a parte frontal de RF precisa ter ruído extraordinariamente baixo. O posicionamento da antena é um problema de otimização com dentes: os campos eletromagnéticos precisam se sobrepor ao máximo com os articuladores, o que significa um design de armação muito dependente de simulação, em que milímetros de posição da antena mudam o que o sistema consegue ouvir. A equipe que constrói os óculos atuais admite que a primeira tentativa integrada aos óculos falhou completamente, e eles voltaram a colar antenas no rosto, depois a um suporte rígido para manter a geometria constante, até que o trabalho de simulação acertou as armações. Essa progressão (fita, suporte, produto) é a arqueologia honesta de um hardware que de fato chega ao mercado.
Câmeras e Ultrassom: Os Coadjuvantes com Nichos Reais
O caminho das câmeras, a leitura labial visual, tem a linhagem de pesquisa mais profunda. O LipNet demonstrou leitura labial de ponta a ponta, em nível de frase, a partir de vídeo, anos atrás, e projetos open source continuam replicando o truque com uma webcam e um rastreador facial. É o sensor mais barato imaginável: você já tem três câmeras. Mas herda a restrição brutal de que só enxerga o lado de fora do seu rosto. A fala interna de boca fechada é invisível por definição, iluminação e ângulo da cabeça corrompem a entrada o tempo todo, e apontar uma câmera para o próprio rosto o dia inteiro traz custos de privacidade e bateria que nunca desaparecem. A leitura labial continua excelente como complemento ao reconhecimento de fala por áudio (os modelos audiovisuais de fato superam os só de áudio em ambientes ruidosos), mas como interface silenciosa independente ela fica presa à ponta do “obviamente articulando”.
O ultrassom ocupa um meio-termo mais estranho. Sistemas acadêmicos apontaram transdutores ultrassônicos para a mandíbula e reconstruíram o movimento da língua a partir de ecos, e a imagem ultrassonográfica da língua é literalmente uma ferramenta padrão em pesquisa de fonética; é assim que observamos vogais sendo produzidas há décadas. A captação é boa. O formato não é. Ninguém descobriu como embalar uma sonda ultrassônica acoplada ao queixo em algo que você usaria numa reunião de pé, e o acoplamento acústico pelo ar é cheio de perdas e sensível ao ângulo. Minha leitura: o ultrassom é a resposta certa para terapia da fala clínica e laboratórios de fonética, e a resposta errada para entrada de consumo.
Se você está acompanhando o placar, a tabela de trade-offs fica mais ou menos assim:
- EMG: sinal muscular direto, boa largura de banda; arruinado por suor, deriva, posicionamento e pela necessidade de usar eletrodos no rosto.
- Leitura labial por câmera: custo de hardware zero, modelos maduros; cega para a fala de boca fechada, frágil à iluminação, hostil à privacidade.
- Ultrassom: gera imagem direta da língua; acoplamento e formato fazem dele um instrumento de laboratório.
- Sensoriamento por RF através do rosto: enxerga os articuladores internos através da pele, se integra a óculos; exige uma pilha de RF de baixo ruído pouco comum e montanhas de dados de treino.
O Problema da Relação Sinal-Ruído Não É o Problema do Ditado
Aqui está o erro conceitual que a maioria de nós comete quando ouve falar desses dispositivos pela primeira vez: achamos que é reconhecimento de fala menos o ar. Não é. O ditado por áudio se apoia num sinal que a natureza projetou para comunicação: dezenas de decibéis de onda de pressão limpa, moldada pela evolução para carregar fonemas por uma sala. As partes difíceis do ASR são sotaques, vocabulário e rejeição de ruído. O sinal em si é generoso.
O sensoriamento de fala silenciosa tem o perfil oposto. A portadora, seja microvolts de EMG ou uma modulação fraca de RF, nunca foi feita para codificar linguagem. A informação fonêmica fica espalhada por canais de sensor sem um mapeamento limpo, e as confusões são fisiológicas, não acústicas. Engolir, apertar a mandíbula, virar a cabeça, tocar o rosto: cada um injeta um transitório que pode ofuscar o sinal da articulação. Onde um sistema de ASR luta contra uma sala barulhenta, um sistema de fala silenciosa luta contra o próprio corpo. Você é o piso de ruído.
Duas consequências decorrem disso. Primeiro, esses sistemas dependem muito mais de modelagem de linguagem do que o ditado. Quando a evidência do sensor para um fonema é ambígua, o decodificador a resolve com prioris sobre o que você provavelmente quis dizer, o mesmo truque que torna a decodificação restrita tão eficaz para transformar saídas nebulosas de modelos em decisões confiáveis. Espere que sistemas de fala silenciosa sejam estranhamente bons em texto previsível (comandos, e-mails no seu próprio tom) e perceptivelmente piores em palavras raras, nomes e identificadores de código, onde a priori não consegue salvar um sinal fraco. Segundo, a calibração é estrutural, não incidental. O ASR por áudio se generalizou entre falantes décadas atrás porque uma forma de onda é uma forma de onda. Uma assinatura facial de RF não é, e isso nos leva ao problema mais difícil do campo.
Cada Rosto É um Problema de Antena Diferente
A generalização entre usuários é onde os protótipos de fala silenciosa vão morrer. A anatomia facial (comprimento da mandíbula, tamanho da língua, densidade dos tecidos, espessura da pele) varia enormemente, e cada uma dessas variáveis remodela o sinal. Um modelo treinado no meu rosto pode ser quase inútil no seu. A literatura inicial de EMG está cheia de sistemas que reportam excelente precisão “por sujeito, após calibração”, uma ressalva que discretamente enterra o produto. Um dispositivo que precisa de uma hora de treino por usuário antes de funcionar é uma demo de pesquisa, não um periférico.
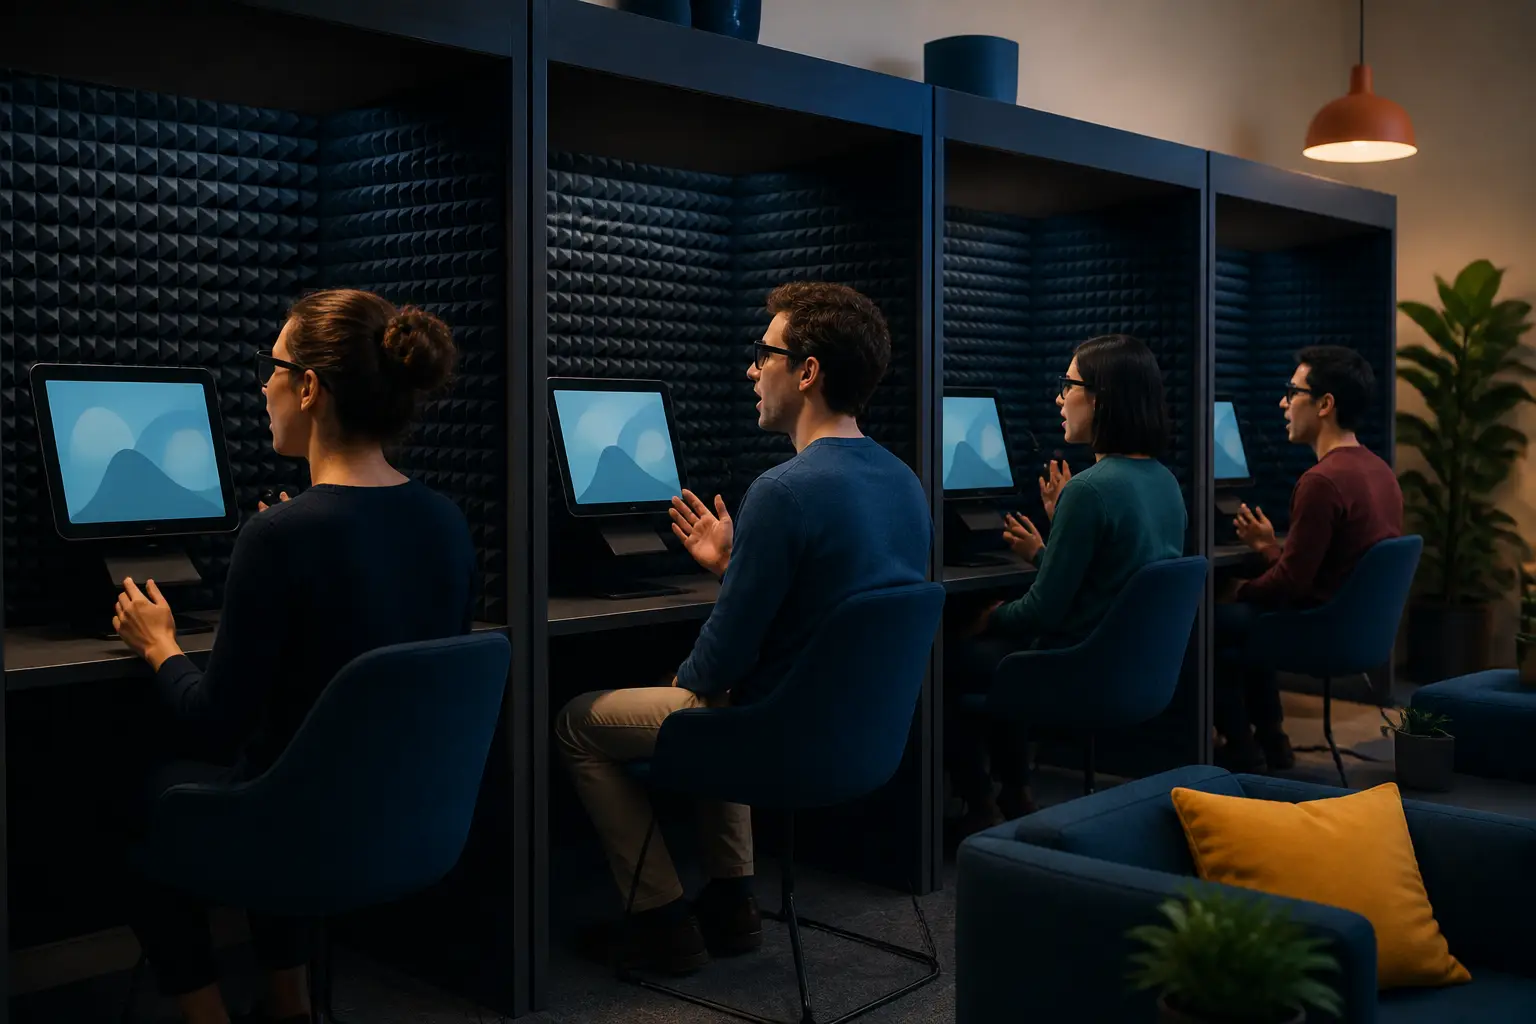
O que acho genuinamente interessante no esforço atual com RF é que eles tentaram primeiro o caminho engenhoso, adaptação de domínio algorítmica e truques de normalização de sinal, e concluíram que a única alavanca que funciona é escala bruta de pré-treinamento. Então montaram cabines de gravação no escritório, pagaram pessoas para ler prompts usando os óculos e observaram as taxas de erro caírem ao longo de uma curva de escala limpa conforme o conjunto de dados crescia. O resultado relatado: um novo usuário precisa de cerca de vinte frases de calibração para o sistema funcionar bem. Esse número importa mais do que qualquer métrica de precisão. Vinte frases são um onboarding tolerável; uma hora de leituras é um pedido de devolução.
É a mesma lição que o resto do machine learning continua nos reensinando: quando um modelo não generaliza, a resposta costuma ser mais dados diversos, não uma arquitetura mais esperta. Vimos isso acontecer em reconhecimento de fala, em tradução automática para idiomas de poucos recursos e em todo domínio em que a distribuição da entrada muda por usuário. A fala silenciosa apenas tem uma mudança por usuário particularmente viciosa, porque o “microfone” é parcialmente feito do próprio usuário.
Onde a Fala Silenciosa Realmente Vence
Tirando a novidade, os casos de uso se organizam numa hierarquia clara. No topo: acessibilidade. Há um perfil de comentaristas (desenvolvedores com lesões por esforço repetitivo prestes a passar por cirurgia de túnel do carpo dupla, pessoas voltando para escritórios abertos onde ditar é socialmente impossível) para quem isso não é um gadget, é a diferença entre trabalhar e não trabalhar. Pacientes laringectomizados e pessoas com perda de fala associada à ELA são a versão mais profunda e mais importante da mesma história. Qualquer avaliação honesta dessa tecnologia deveria pesar isso bastante.
Segundo: ambientes barulhentos, que é o caso contraintuitivo. Uma modalidade de sensoriamento que ignora a acústica por completo não se importa com seu cortador de grama, sua sala de servidores ou o chão de fábrica. A voz falha justamente onde o sensoriamento por RF é indiferente. Terceiro: discrição, ditar em bibliotecas, escritórios abertos, trens. Esse é o argumento de venda para o consumidor comum, e é real, mas vou apontar que é o mais fraco dos três, porque é um recurso de conforto social, não um desbloqueio de capacidade.
Minha posição sobre os trade-offs: essa tecnologia só se justifica se a inferência for no dispositivo ou pelo menos capaz de funcionar offline. Um sensor que observa sua língua se mover dentro da boca fechada, enviando dados brutos para uma API na nuvem, é uma arquitetura de privacidade que ninguém deveria aceitar. Quem se preocupa com vazamento de sinais involuntários tem uma queixa legítima, mesmo que alguns dos medos mais especulativos sejam exagerados. A boa notícia é que os modelos de decodificação são pequenos o bastante para rodar localmente; o campo faria bem em tratar o design offline-first como requisito básico, e não como um diferencial premium. Equivalentes de wake word também importam: os óculos precisam de um sinal de intenção deliberado e físico (um gesto, um padrão de aperto da mandíbula) antes de escutar, ou você construiu um vestível que transcreve cada movimento involuntário da sua boca.
Há um eco antigo aqui que não consigo resistir a mencionar. Operadores de telégrafo nos anos 1870 aprenderam a ler mensagens pelo som dos cliques do relé, um canal de entrada que ninguém projetou. A história das interfaces está cheia desses canais laterais que se tornam canais de primeira classe assim que alguém constrói o decodificador. O ruído muscular subvocal é um canal lateral da leitura e do pensamento que os humanos vazam desde que têm monólogos internos. Transformá-lo em dispositivo de entrada é menos uma invenção do que uma promoção, e, se as curvas de escala se sustentarem, a pessoa mais silenciosa da biblioteca pode em breve ser a que mais digita.