Silent Speech Interface: Kenapa RF Mengalahkan Elektroda
Silent speech interface membaca gerakan mulut tanpa suara lewat sinyal otot dan RF. Kenapa tradeoff sensor dan masalah SNR membuatnya beda dari dikte suara.
 James Whitfield
Kamu lagi di perpustakaan, aplikasi dikte menyala, dan kamu baru saja mengetik ulang email yang sama empat kali lewat mulut ke laptop seperti orang kurang waras, karena kalau bicara keras-keras, seisi lantai bakal melirik. Silent speech interface ada persis untuk momen seperti ini: sistem yang menerjemahkan kata yang kamu gerakkan di mulut, atau bahkan cuma kamu niatkan untuk digerakkan, tanpa satu pun suara keluar dari tubuhmu. Sekumpulan startup baru sedang bertaruh bahwa perangkat input yang hilang di era AI bukanlah mikrofon yang lebih bagus. Melainkan tanpa mikrofon sama sekali.
Idenya lebih tua daripada kesan dari gelombang demo terbaru. Peneliti NASA sudah bereksperimen dengan pengenalan subvokal sejak pertengahan 2000-an, awalnya untuk astronot dan kru penerbangan yang bekerja di lingkungan bising atau mengenakan baju tekanan. MIT Media Lab membuatnya terkenal lewat AlterEgo pada 2018, sebuah headset wearable yang menangkap sinyal neuromuskular dari rahang dan wajah. Yang berubah belakangan ini bukan konsepnya, melainkan hardware radio yang murah, machine learning yang makin baik, dan booming voice AI yang tiba-tiba jadi arus utama, semuanya bertemu dan membuat rekayasanya hampir layak. Hampir. Masalah signal-to-noise di sini benar-benar brutal, dan cara tim menyelesaikannya menentukan segalanya tentang produk yang akhirnya mereka rilis.
Bicara Tanpa Suara: Sebenarnya Apa Itu Subvokalisasi
Ada terminologi yang perlu dipahami dengan benar, karena bidang ini sering mencampuradukkan tiga hal berbeda. Pertama, ada mouthing: artikulasi penuh dengan bibir, lidah, dan rahang, hanya tanpa suara. Kedua, ada internal speech: bibir tertutup, tapi lidah dan langit-langit lunak tetap bergerak dengan sengaja seolah membentuk kata. Ketiga, ada subvokalisasi yang sebenarnya, yaitu aktivasi otot yang samar dan tidak disadari saat kamu membaca atau berpikir dalam kata-kata. Yang terakhir ini versi fiksi ilmiahnya, dan hampir tidak terdeteksi di luar laboratorium. Produk yang berfungsi hari ini berada di dua kategori pertama. Satu tim yang membangun kacamata sensing RF menggambarkan target perilakunya sebagai “mouthing dengan bibir tertutup”, sebuah hibrida aneh yang ternyata dipelajari pengguna dalam beberapa sesi saja.
Sebagai nerd bahasa, menurutku linguistik di sini menyenangkan. Artikulasi adalah program motorik yang dijalankan otak kamu terlepas dari apakah pita suara bergetar atau tidak. Voicing hanyalah satu tahap dalam produksi ucapan, yaitu bagian di mana laring menambahkan energi akustik. Kalau bagian itu dihilangkan, koreografi hulunya tetap utuh: posisi lidah untuk vokal, pembulatan bibir, kontrol velum untuk bunyi nasal. Silent speech interface pada dasarnya mencoba merekonstruksi urutan fonem dari sisa koreografi itu, seperti menebak melodi dari melihat jari pianis di piano yang dibisukan. Ini semacam membaca gerak bibir, tapi dari dalam.
Kerangka ini penting karena memberitahu kamu apa yang harus diukur sensor. Tidak ada yang membaca pikiranmu. Setiap sistem yang berhasil memanfaatkan beberapa korelat fisik dari artikulasi, seperti impuls listrik, gerakan jaringan, atau energi yang dipantulkan, dan pilihan korelat mana yang dikejar adalah keputusan rekayasa yang paling menentukan.
EMG: Sensor Paling Jelas yang Justru Mengkhianatimu
Elektromiografi adalah titik awal hampir semua orang, karena logikanya sangat menggoda. Otot aktif karena neuron motorik melepaskan potensial listrik melintasi membran; tempelkan elektroda di kulit di atas otot yang tepat dan kamu bisa melihatnya terjadi. Surface EMG adalah teknik yang sudah matang, prostetik lengan sudah dikendalikan dengan sinyal otot sisa selama puluhan tahun. Untuk hackathon akhir pekan, kamu benar-benar bisa menempelkan elektroda ke wajah, menyambungkannya ke amplifier, dan mendapatkan sesuatu yang berkedip-kedip kasar mengikuti huruf yang digerakkan di mulut. Banyak prototipe silent speech dibuat persis dengan cara ini, termasuk MIT AlterEgo yang terkenal itu dan, menurut laporan, upaya kasar pertama dari tim yang sekarang merilis kacamata RF.
Lalu realita ikut campur, dalam daftar mode kegagalan yang bisa diprediksi dan bikin frustrasi:
- Keringat. Konduktivitas kulit berubah saat kamu berkeringat, jadi kata yang sama yang digerakkan di mulut terlihat berbeda pada jam 9 pagi dan setelah makan siang. Kalibrasimu terus membusuk di bawah kakimu.
- Interferensi listrik. Sinyal EMG wajah berada dalam rentang mikrovolt. Kabel listrik di dekatmu, power supply switching laptop, bahkan kedipan mata bisa menenggelamkannya.
- Variasi penempatan. Pergeseran dua milimeter posisi elektroda sudah mengubah serabut otot mana yang mendominasi pembacaan. Lepas perangkat lalu pasang lagi, dan model kemarin sedang mengukur orang yang sedikit berbeda.
- Penghalang kosmetik. Tidak ada yang mau memakai elektroda gel di wajahnya di depan umum. Kedengarannya sepele; tetap saja pendekatan ini mati karenanya.
Poin terakhir itu layak dihormati. Perangkat konsumen lebih sering gagal karena friksi daripada fisika. Sejarah wearable adalah kuburan perangkat yang berfungsi di lab tapi menuntut satu langkah ekstra dari pengguna. Headset konduksi tulang, strap dada untuk monitor jantung, headband EEG, semuanya secara teknis solid, semuanya niche. Ketika sensormu butuh persiapan kulit setiap hari, kamu sebenarnya sedang membangun perangkat medis, bukan periferal input.
RF Sensing: Membaca Mulut dari Dalam
Pendekatan yang sekarang makin dilirik menggantikan elektroda dengan radio. Idenya: antena yang tertanam di bingkai kacamata memancarkan gelombang radio berdaya rendah, di frekuensi yang mirip Bluetooth, yang menembus wajahmu. Saat gelombang melintasi jaringan yang bergerak, seperti lidah, bibir, dan langit-langit lunak, gelombang itu termodulasi dengan cara kecil yang terstruktur. Antena penerima menangkap sinyal yang terganggu, lalu jaringan saraf belajar memetakan gangguan tersebut kembali menjadi teks. Ini keluarga fisika yang sama dengan sensing gestur berbasis Wi-Fi dan radar yang dipasang Google di Pixel 4 untuk gestur tangan, hanya diarahkan ke target yang jauh lebih halus.
Daya tariknya, RF melihat apa yang tidak bisa dilihat kamera maupun elektroda kulit. Lidah tidak terlihat dari luar begitu bibirmu tertutup, tapi ia adalah otot besar yang kaya air, dan gelombang radio berinteraksi kuat dengannya. Internal speech dengan bibir tertutup, mode diskret yang benar-benar diinginkan orang saat rapat, hanya bisa dijangkau lewat modalitas tembus jaringan seperti ini. Itulah seluruh argumen produknya dalam satu kalimat: EMG dan kamera menangkap bagian luar artikulasi, RF menangkap bagian dalamnya.
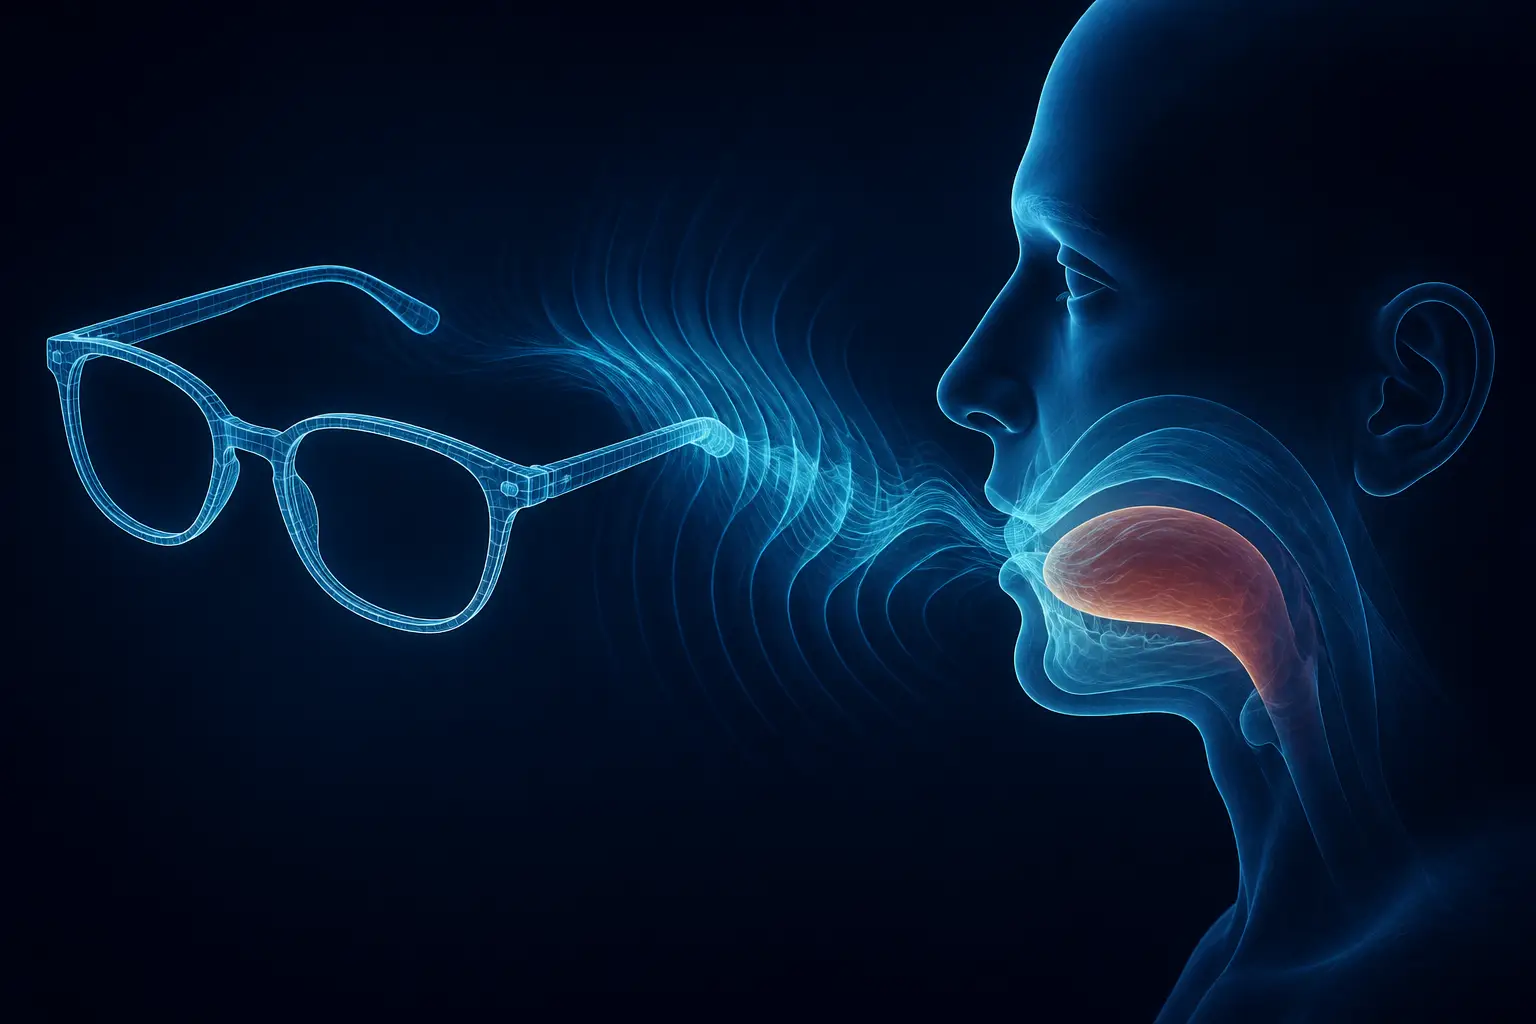
Rekayasa untuk sampai ke sana tidak mudah. Sinyal yang kamu kejar adalah modulasi samar yang menumpang pada carrier, jadi seluruh front end RF harus sangat rendah noise. Penempatan antena adalah masalah optimasi yang menggigit: medan elektromagnetik harus overlap semaksimal mungkin dengan artikulator, yang berarti desain bingkai yang sangat bergantung simulasi, di mana pergeseran antena beberapa milimeter mengubah apa yang bisa didengar sistem. Tim yang membangun prototipe kacamata saat ini mengakui bahwa upaya pertama mereka dengan antena terintegrasi gagal total, lalu mereka mundur ke menempelkan antena di wajah, lalu ke rig kepala yang kaku untuk menjaga geometri tetap konstan, sebelum kerja simulasi akhirnya membuat bingkainya benar. Progresi itu, dari plester ke rig ke produk, adalah arkeologi jujur dari hardware yang benar-benar dikirim.
Kamera dan Ultrasound: Pemeran Pendukung dengan Ceruk Nyata
Jalur kamera, yaitu membaca gerak bibir secara visual, punya rekam jejak riset paling dalam. LipNet mendemonstrasikan lip reading end-to-end tingkat kalimat dari video bertahun-tahun lalu, dan proyek open-source terus mereplikasi trik ini dengan webcam dan face tracker. Ini sensor paling murah yang bisa dibayangkan: kamu sudah punya tiga kamera. Tapi ia mewarisi batasan brutal bahwa ia hanya melihat bagian luar wajahmu. Internal speech dengan mulut tertutup menurut definisinya memang tidak terlihat, pencahayaan dan sudut kepala terus merusak input, dan mengarahkan kamera ke wajahmu sepanjang hari punya biaya privasi dan baterai yang tidak pernah hilang. Lip reading tetap sangat bagus sebagai augmentasi untuk pengenalan ucapan audio, model audiovisual memang mengungguli model audio-only di lingkungan bising, tapi sebagai silent interface mandiri ia terbatas di ujung spektrum “jelas-jelas menggerakkan mulut”.
Ultrasound menempati posisi tengah yang lebih aneh. Sistem akademik sudah mengarahkan transduser ultrasonik ke rahang dan merekonstruksi gerakan lidah dari gema, dan pencitraan ultrasound lidah secara harfiah adalah alat standar dalam riset fonetik, begitulah kita mengamati pembentukan vokal selama puluhan tahun. Sensing-nya bagus. Bentuk fisiknya tidak. Belum ada yang berhasil mengemas probe ultrasound yang ditempelkan ke dagu menjadi sesuatu yang bisa kamu pakai di rapat berdiri, dan kopling akustik lewat udara itu lossy dan sensitif terhadap sudut. Pendapatku: ultrasound adalah jawaban yang tepat untuk terapi wicara klinis dan laboratorium fonetik, dan jawaban yang salah untuk input konsumen.
Kalau kamu mau menghitung skor, tabel tradeoff-nya kira-kira seperti ini:
- EMG: sinyal otot langsung, bandwidth bagus, tapi rusak oleh keringat, drift, penempatan, dan keharusan memakai elektroda di wajah.
- Lip reading kamera: biaya hardware nol, model matang, tapi buta terhadap ucapan mulut tertutup, rapuh terhadap pencahayaan, dan bermusuhan dengan privasi.
- Ultrasound: mencitrakan lidah secara langsung, tapi kopling dan bentuk fisiknya membuatnya jadi instrumen laboratorium.
- RF sensing tembus wajah: melihat artikulator internal lewat kulit, tertanam di kacamata, tapi butuh tumpukan RF low-noise yang eksotis dan gunung data latih.
Masalah Signal-to-Noise Bukan Masalah Dikte
Ini kesalahan konseptual yang kebanyakan dari kita buat saat pertama mendengar tentang perangkat ini: kita menganggapnya sebagai pengenalan ucapan dikurangi udara. Bukan. Dikte audio menumpang pada sinyal yang dirancang alam untuk komunikasi, puluhan desibel gelombang tekanan yang bersih, dibentuk evolusi untuk membawa fonem melintasi ruangan. Bagian sulit ASR adalah aksen, kosakata, dan penolakan noise. Sinyalnya sendiri sangat murah hati.
Silent speech sensing punya profil yang berkebalikan. Carrier-nya, baik mikrovolt EMG maupun modulasi RF yang samar, tidak pernah dimaksudkan untuk menyandikan bahasa. Informasi fonem tersebar di seluruh channel sensor tanpa pemetaan yang bersih, dan confound-nya bersifat fisiologis, bukan akustik. Menelan, mengatupkan rahang, memutar kepala, menyentuh wajah: masing-masing menyuntikkan transien yang bisa menenggelamkan sinyal artikulasi. Di mana ASR melawan ruangan yang bising, sistem silent speech melawan tubuhmu sendiri. Kamu adalah noise floor-nya.
Ada dua konsekuensi. Pertama, sistem ini jauh lebih bergantung pada language modeling dibanding dikte. Saat bukti sensor untuk sebuah fonem ambigu, decoder menyelesaikannya dengan prior tentang apa yang kemungkinan ingin kamu katakan, trik yang sama yang membuat constrained decoding sangat efektif mengubah output model yang kabur menjadi keputusan yang andal. Harapkan sistem silent speech terasa sangat bagus untuk teks yang bisa diprediksi (perintah, email dengan gaya bahasamu sendiri) dan lumayan lebih buruk untuk kata langka, nama, dan identifier kode, di mana prior tidak bisa menyelamatkan sinyal yang lemah. Kedua, kalibrasi itu struktural, bukan kebetulan. ASR audio sudah digeneralisasi lintas pembicara sejak puluhan tahun lalu karena gelombang suara tetaplah gelombang suara. Tanda tangan sinyal RF di wajah tidak demikian, dan itu membawa kita ke masalah tersulit di bidang ini.
Setiap Wajah adalah Masalah Antena yang Berbeda
Generalisasi lintas pengguna adalah tempat prototipe silent speech mati. Anatomi wajah, panjang rahang, ukuran lidah, kepadatan jaringan, ketebalan kulit, semuanya sangat bervariasi, dan setiap variabel itu membentuk ulang sinyal. Model yang dilatih dengan wajahku bisa hampir tidak berguna untuk wajahmu. Literatur EMG awal dipenuhi sistem yang melaporkan akurasi bagus “per subjek, setelah kalibrasi”, kualifikasi yang diam-diam mengubur produknya. Perangkat yang butuh satu jam latihan per pengguna sebelum berfungsi adalah demo riset, bukan periferal.
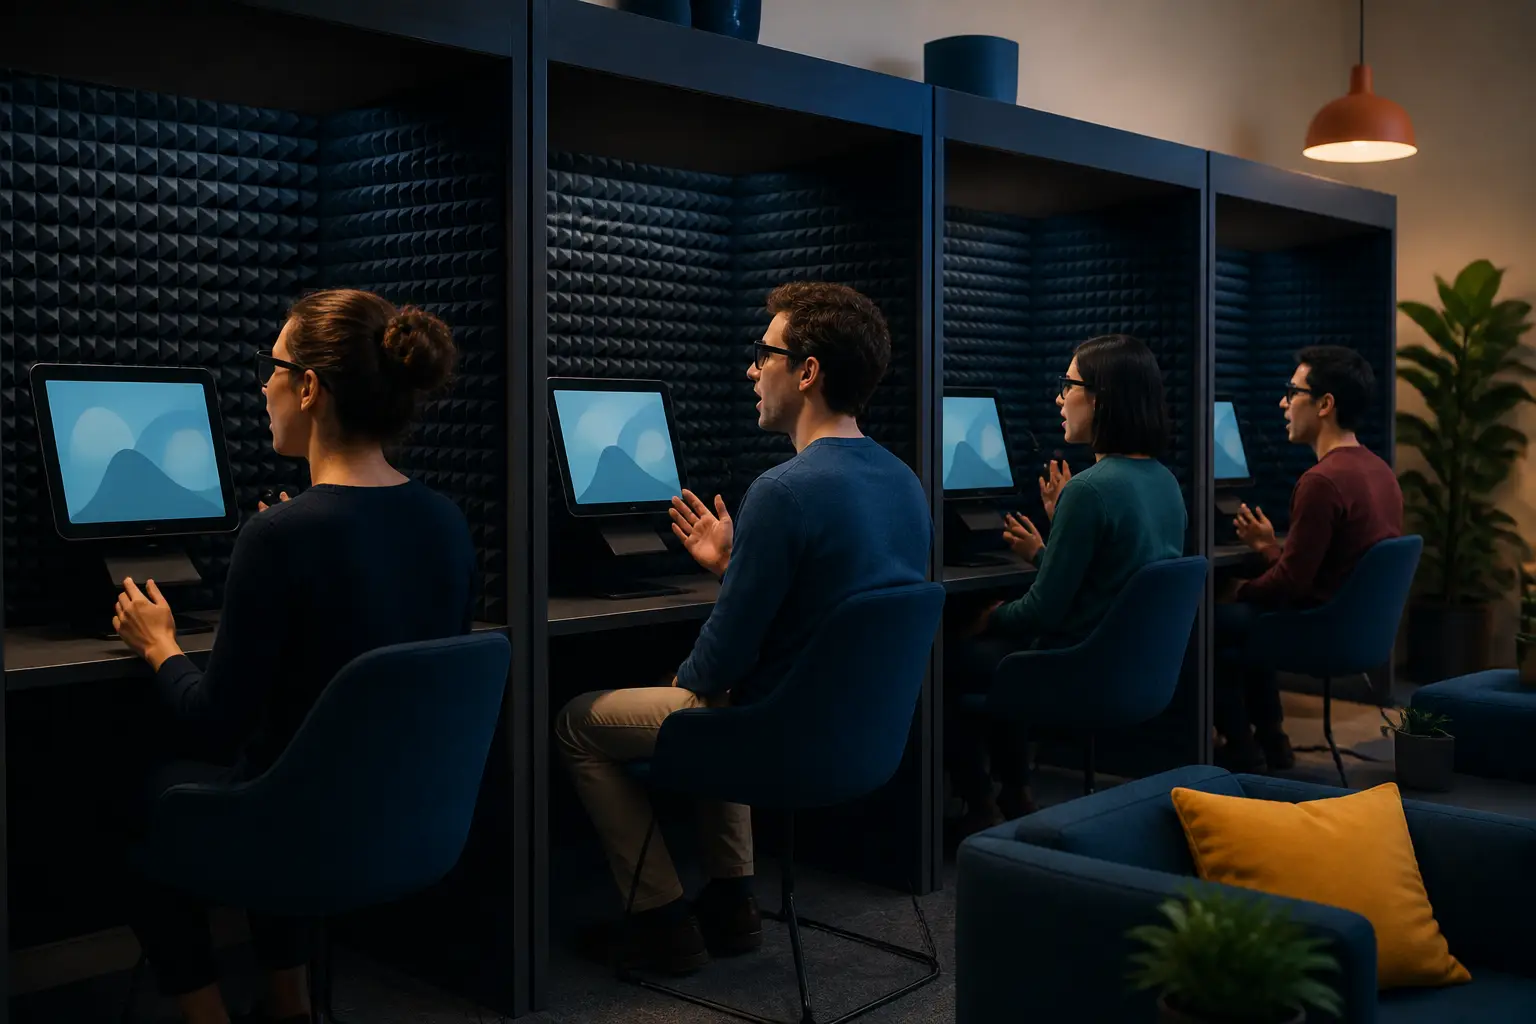
Yang menurutku benar-benar menarik dari upaya RF saat ini: mereka mencoba jalur pintar dulu, yaitu domain adaptation algoritmik dan trik normalisasi sinyal, lalu menyimpulkan bahwa satu-satunya tuas yang berhasil adalah skala pretraining brute force. Jadi mereka membangun ruang rekaman di kantor, membayar orang untuk membaca prompt sambil memakai kacamata, dan melihat tingkat error turun mengikuti kurva scaling yang jelas seiring bertambahnya dataset. Hasil yang dilaporkan: pengguna baru hanya butuh sekitar dua puluh kalimat kalibrasi sebelum sistem bekerja dengan baik. Angka itu lebih penting daripada angka akurasi mana pun. Dua puluh kalimat adalah alur onboarding yang bisa ditoleransi; satu jam pembacaan adalah permintaan refund.
Ini pelajaran yang terus diulang machine learning: ketika model gagal digeneralisasi, jawabannya biasanya data yang lebih beragam, bukan arsitektur yang lebih cerdik. Kita sudah melihatnya terjadi di pengenalan ucapan, di machine translation untuk bahasa low-resource, dan di setiap domain di mana distribusi input bergeser per pengguna. Silent speech punya pergeseran per pengguna yang sangat jahat, karena “mikrofon”-nya sebagian terbuat dari si pengguna itu sendiri.
Di Mana Silent Speech Benar-Benar Menang
Kalau kebaruannya dikesampingkan, use case tersusun dalam hierarki yang jelas. Di puncak: aksesibilitas. Ada demografi yang sering muncul di komentar, yaitu developer dengan cedera regangan berulang yang menghadapi operasi carpal tunnel ganda, dan orang yang kembali ke open office di mana dikte secara sosial mustahil. Untuk mereka ini bukan gadget, tapi perbedaan antara bisa bekerja atau tidak. Pasien laringektomi dan orang dengan kehilangan bicara mirip ALS adalah versi cerita yang sama tapi lebih dalam dan lebih penting. Evaluasi jujur apa pun terhadap teknologi ini harus memberi bobot besar untuk itu.
Kedua: lingkungan bising, yang justru berlawanan dengan intuisi. Modalitas sensing yang mengabaikan akustik sepenuhnya tidak peduli dengan mesin pemotong rumput, server room, atau lantai pabrik. Suara gagal justru di tempat RF sensing tidak terpengaruh. Ketiga: diskresi, dikte di perpustakaan, open office, atau kereta. Ini pitch konsumen mainstream, dan memang nyata, tapi aku catat ini yang terlemah dari ketiganya karena ini fitur kenyamanan sosial, bukan pembuka kapabilitas.
Posisiku soal tradeoff: teknologi ini hanya layak dengan form factor-nya jika inferensinya berjalan on-device atau setidaknya bisa offline. Sensor yang mengawasi lidahmu bergerak di dalam mulut tertutup, sambil mengalirkan data mentah ke cloud API, adalah arsitektur privasi yang tidak boleh diterima siapa pun. Komentar yang khawatir soal kebocoran sinyal tak disengaja punya keluhan yang sah, meski beberapa ketakutan yang lebih spekulatif memang dibesar-besarkan. Kabar baiknya, model decoding cukup kecil untuk berjalan lokal; bidang ini sebaiknya memperlakukan desain offline-first sebagai syarat minimum, bukan fitur premium. Padanan wake-word juga penting: kacamata perlu sinyal niat fisik yang disengaja (gestur, pola katupan rahang) sebelum mulai mendengarkan, atau kamu sudah membangun wearable yang mentranskripsi setiap gerakan mulut yang tidak disengaja.
Ada gema lama di sini yang tidak bisa kulewatkan. Operator telegraf di tahun 1870-an belajar membaca pesan dari bunyi klik relay, sebuah kanal input yang tidak pernah didesain siapa pun. Sejarah antarmuka penuh dengan side channel seperti ini yang menjadi kanal kelas satu begitu seseorang membangun decoder-nya. Gumaman otot subvokal adalah side channel dari membaca dan berpikir yang sudah bocor sejak manusia punya monolog batin. Mengubahnya menjadi perangkat input lebih merupakan promosi daripada penemuan, dan jika kurva scaling-nya bertahan, orang paling diam di perpustakaan mungkin akan jadi orang yang paling banyak mengetik.