Interface de parole silencieuse : la RF bat les électrodes
Les interfaces de parole silencieuse décodent les mots articulés via signaux musculaires ou RF. Pourquoi elles diffèrent de la dictée.
 James Whitfield
Vous êtes à la bibliothèque, l'application de dictée tourne, et vous venez d'articuler le même e-mail quatre fois à votre ordinateur comme un fou, parce que le dire à voix haute vous vaudrait les regards de tout l'étage. Les interfaces de parole silencieuse existent précisément pour ce moment : des systèmes qui décodent les mots que vous articulez, ou même simplement que vous avez l'intention d'articuler, sans qu'aucun son audible ne sorte de votre corps. Une nouvelle vague de startups parie que le périphérique d'entrée qui manquait à l'ère de l'IA n'est pas un meilleur micro. C'est l'absence de micro.
L'idée est plus ancienne que ne le laissent penser les démos actuelles. Des chercheurs de la NASA expérimentaient la reconnaissance subvocale au milieu des années 2000, à l'origine pour des astronautes et des équipages évoluant dans des environnements bruyants ou en combinaison pressurisée. Le Media Lab du MIT l'a rendue célèbre avec AlterEgo en 2018, un casque portable qui captait les signaux neuromusculaires de la mâchoire et du visage. Ce qui a changé récemment, ce n'est pas le concept : c'est la convergence de matériel radio bon marché, de meilleurs modèles d'apprentissage automatique et de la démocratisation soudaine de l'IA vocale, qui rend l'ingénierie presque faisable. Presque. Le problème du rapport signal sur bruit est vraiment brutal, et la façon dont les équipes le résolvent détermine tout le produit qu'elles finiront par livrer.
Parler sans son : ce qu'est vraiment la subvocalisation
Il est utile de bien poser la terminologie, car le domaine confond trois choses différentes. D'abord, il y a l'articulation sans voix (mouthing) : une articulation complète avec les lèvres, la langue et la mâchoire, simplement sans voix. Ensuite, il y a la parole interne : lèvres fermées, mais la langue et le voile du palais bougent encore délibérément comme pour former des mots. Enfin, il y a la véritable subvocalisation, cette activation musculaire faible et involontaire qui se produit quand on lit ou pense en mots. Cette dernière relève de la science-fiction et reste à peine détectable hors laboratoire. Les produits qui fonctionnent aujourd'hui se situent dans les deux premières catégories. Une équipe qui construit des lunettes à détection RF décrit son comportement cible comme « articuler avec les lèvres fermées », une hybride étrange que les utilisateurs apprendraient apparemment en quelques sessions.
En passionné de langues, je trouve la linguistique ici délicieuse. L'articulation est un programme moteur que le cerveau exécute qu'il y ait ou non vibration des cordes vocales. La phonation n'est qu'une étape de la production de la parole, celle où le larynx ajoute de l'énergie acoustique. Retirez-la et toute la chorégraphie en amont demeure : position de la langue pour les voyelles, arrondissement des lèvres, contrôle du voile du palais pour les nasales. Un système de parole silencieuse tente essentiellement de reconstruire la séquence de phonèmes à partir du résidu de cette chorégraphie, un peu comme deviner une mélodie en regardant les doigts d'un pianiste jouer sur un piano muet. C'est de la lecture labiale vue de l'intérieur.
Ce cadrage est important, car il dit ce que les capteurs doivent mesurer. Personne ne lit dans votre esprit. Chaque système qui fonctionne exploite une corrélation physique de l'articulation (impulsions électriques, mouvements des tissus ou énergie réfléchie), et le choix de la corrélation à poursuivre est la décision d'ingénierie déterminante.
EMG : le capteur évident qui vous trahit
L'électromyographie est le point de départ de presque tout le monde, car la logique est irrésistible. Les muscles se contractent parce que les motoneurones libèrent des potentiels électriques à travers les membranes ; posez une électrode sur la peau au-dessus du bon muscle et vous pouvez le voir se produire. L'EMG de surface est une technique mature : les prothèses de membres sont pilotées par les signaux musculaires résiduels depuis des décennies. Pour un hackathon d'un week-end, vous pouvez littéralement scotcher des électrodes sur votre visage, les brancher à un amplificateur et obtenir quelque chose qui scintille en correspondance approximative avec des lettres articulées. Plusieurs prototypes de parole silencieuse ont été construits exactement de cette façon, dont le fameux AlterEgo du MIT et, selon les rumeurs, la première tentative sommaire de l'équipe qui livre aujourd'hui les lunettes RF.
Puis la réalité s'impose, avec une liste de modes de défaillance tristement prévisibles :
- La transpiration. La conductivité de la peau varie avec la sudation, donc le même mot articulé ne ressemble pas à 9 h et après le déjeuner. Votre calibration se dégrade en continu.
- Les interférences électriques. Les signaux EMG faciaux sont de l'ordre du microvolt. Les lignes électriques voisines, l'alimentation à découpage de votre ordinateur, voire le clignement des yeux peuvent les noyer.
- La variabilité du placement. Un décalage de deux millimètres de l'électrode change les fibres musculaires qui dominent la mesure. Retirez l'appareil puis remettez-le, et le modèle de la veille mesure une personne légèrement différente.
- Le rédhibitoire esthétique. Personne ne portera d'électrodes en gel sur le visage en public. Cela semble anodin ; ça a quand même tué l'approche.
Ce dernier point mérite qu'on s'y arrête. Le matériel grand public échoue bien plus souvent à cause de la friction que de la physique. L'histoire des objets connectés est un cimetière d'appareils qui fonctionnaient en laboratoire mais exigeaient une étape de trop à l'utilisateur. Casques à conduction osseuse, ceintures cardiaques, bandeaux EEG : tous techniquement solides, tous de niche. Quand votre capteur exige une préparation quotidienne de la peau, vous avez fabriqué un dispositif médical, pas un périphérique de saisie.
Détection RF : lire la bouche de l'intérieur
L'approche qui gagne du terrain aujourd'hui remplace les électrodes par la radio. Le principe : des antennes intégrées aux montures de lunettes émettent des ondes radio de faible puissance, à des fréquences proches du Bluetooth, qui traversent votre visage. Lorsque ces ondes croisent des tissus en mouvement (langue, lèvres, voile du palais), elles sont modulées de façon minuscule et structurée. Des antennes de réception captent le signal perturbé, et un réseau de neurones apprend à reconvertir ces perturbations en texte. C'est la même famille de physique que la détection de gestes par Wi-Fi et le radar que Google a intégré au Pixel 4 pour les gestes de la main, mais pointé vers une cible bien plus subtile.
L'intérêt de la RF est qu'elle voit ce que les caméras et les électrodes cutanées ne voient pas. La langue est invisible de l'extérieur dès que les lèvres sont fermées, mais c'est un gros muscle riche en eau, avec lequel les ondes radio interagissent fortement. La parole interne lèvres fermées, le mode discret que les gens veulent vraiment en réunion, n'est accessible que par une modalité à travers les tissus comme celle-ci. C'est tout l'argument produit en une phrase : l'EMG et les caméras captent l'extérieur de l'articulation, la RF capte l'intérieur.
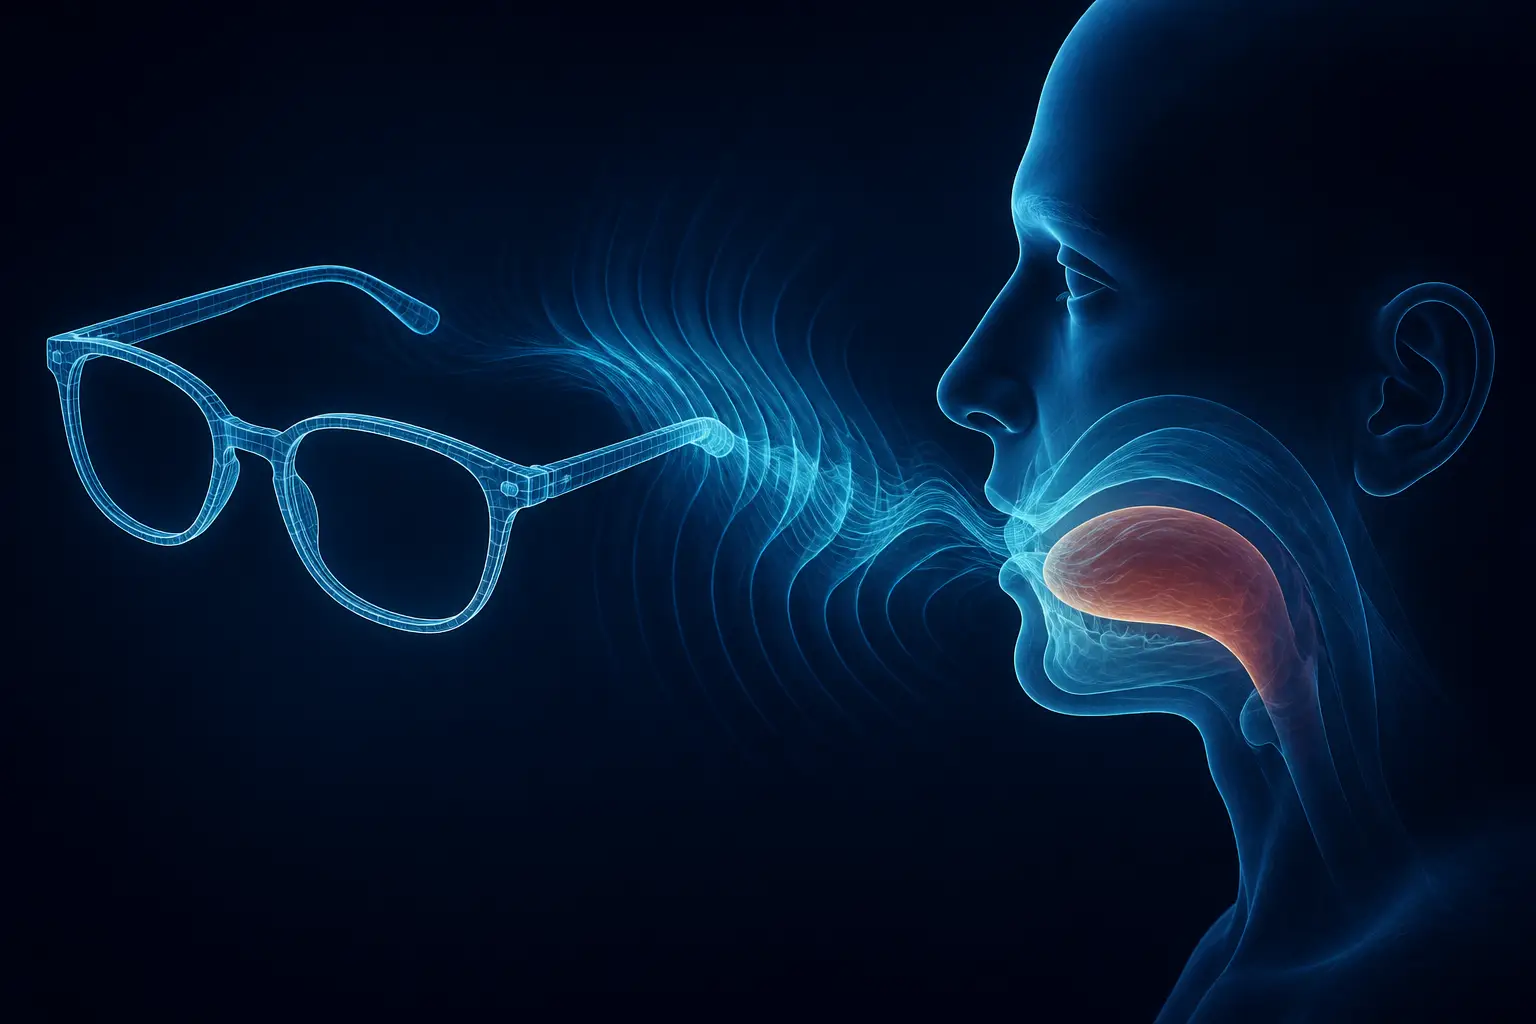
L'ingénierie nécessaire pour y arriver n'a rien de doux. Le signal recherché est une modulation faible posée sur une porteuse, donc toute la chaîne RF doit être extraordinairement peu bruitée. Le placement des antennes est un problème d'optimisation redoutable : les champs électromagnétiques doivent recouvrir au maximum les articulateurs, ce qui impose une conception de monture très gourmande en simulations, où quelques millimètres de position d'antenne changent ce que le système peut « entendre ». L'équipe qui développe les lunettes actuelles reconnaît que sa première tentative intégrée aux lunettes a complètement échoué. Elle est revenue à des antennes scotchées sur le visage, puis à un montage rigide pour figer la géométrie, avant que le travail de simulation ne fasse enfin les bonnes montures. Cette progression (scotch, montage, produit) est l'archéologie honnête d'un matériel qui arrive réellement sur le marché.
Caméras et ultrasons : les outsiders aux vraies niches
La voie caméra, la lecture labiale visuelle, a le pedigree de recherche le plus profond. LipNet a démontré il y a plusieurs années la lecture labiale de phrases de bout en bout à partir de vidéos, et des projets open source reproduisent sans cesse l'astuce avec une webcam et un suiveur de visage. C'est le capteur le moins cher imaginable : vous possédez déjà trois caméras. Mais elle hérite de la contrainte brutale de ne voir que l'extérieur du visage. La parole interne bouche fermée est invisible par définition, l'éclairage et l'angle de la tête corrompent constamment l'entrée, et pointer une caméra sur son propre visage toute la journée a des coûts de confidentialité et de batterie qui ne disparaissent jamais. La lecture labiale reste excellente en complément de la reconnaissance vocale audio (les modèles audiovisuels surpassent vraiment les modèles audio seuls dans le bruit), mais en tant qu'interface silencieuse autonome, elle reste cantonnée à l'extrémité « articulation évidente » du spectre.
Les ultrasons occupent un terrain intermédiaire plus étrange. Des systèmes académiques ont pointé des transducteurs ultrasonores vers la mâchoire et reconstruit le mouvement de la langue à partir des échos, et l'imagerie ultrasonore de la langue est littéralement un outil standard en phonétique : c'est ainsi que l'on observe la production des voyelles depuis des décennies. La détection est bonne. Le format, non. Personne n'a encore réussi à emballer une sonde ultrasonore couplée au menton dans quelque chose qu'on porterait à une réunion debout, et le couplage acoustique dans l'air est très atténuant et sensible à l'angle. Mon avis : les ultrasons sont la bonne réponse pour l'orthophonie clinique et les laboratoires de phonétique, et la mauvaise pour la saisie grand public.
Si vous tenez le score, le tableau des compromis ressemble à peu près à ceci :
- EMG : signal musculaire direct, bonne bande passante, mais ruiné par la transpiration, la dérive, le placement et la nécessité de porter des électrodes sur le visage.
- Lecture labiale par caméra : coût matériel nul, modèles matures, mais aveugle à la parole bouche fermée, fragile face à l'éclairage et hostile à la vie privée.
- Ultrasons : imagent directement la langue, mais le couplage et le format en font un instrument de laboratoire.
- Détection RF à travers le visage : voit les articulateurs internes à travers la peau, s'intègre dans des lunettes, mais exige une pile RF exotique à faible bruit et des montagnes de données d'entraînement.
Le problème du rapport signal sur bruit n'est pas celui de la dictée
Voici l'erreur conceptuelle que nous faisons presque tous à la première présentation de ces appareils : on suppose qu'il s'agit de la reconnaissance vocale moins l'air. Ce n'est pas le cas. La dictée audio repose sur un signal que la nature a conçu pour la communication : des dizaines de décibels d'onde de pression propre, façonnés par l'évolution pour transporter des phonèmes à travers une pièce. Les parties difficiles de la reconnaissance automatique de la parole sont les accents, le vocabulaire et le rejet du bruit. Le signal lui-même est généreux.
La détection de parole silencieuse a le profil inverse. La porteuse, qu'il s'agisse de microvolts d'EMG ou d'une faible modulation RF, n'a jamais été censée encoder le langage. L'information phonémique est étalée sur les canaux du capteur sans correspondance nette, et les perturbations sont physiologiques, pas acoustiques. Avaler, serrer la mâchoire, tourner la tête, toucher son visage : chacun injecte un transitoire qui peut éclipser le signal d'articulation. Là où un système ASR lutte contre une pièce bruyante, un système de parole silencieuse lutte contre votre propre corps. Vous êtes le plancher de bruit.
Deux conséquences en découlent. D'abord, ces systèmes s'appuient bien davantage sur la modélisation du langage que la dictée. Quand la preuve capteur d'un phonème est ambiguë, le décodeur tranche avec des a priori sur ce que vous vouliez probablement dire, la même astuce qui rend le décodage contraint si efficace pour transformer des sorties de modèles floues en décisions fiables. Attendez-vous à ce que les systèmes de parole silencieuse soient étonnamment bons sur un texte prévisible (commandes, e-mails dans votre propre registre) et nettement moins bons sur les mots rares, les noms propres et les identifiants de code, là où l'a priori ne peut pas sauver un signal faible. Ensuite, la calibration est structurelle, pas accessoire. La reconnaissance audio s'est généralisée entre locuteurs il y a des décennies, parce qu'une forme d'onde reste une forme d'onde. Une signature RF faciale, non, et on arrive ici au problème le plus difficile du domaine.
Chaque visage est un problème d'antenne différent
La généralisation d'un utilisateur à l'autre est là où les prototypes de parole silencieuse meurent. L'anatomie faciale (longueur de mâchoire, taille de la langue, densité des tissus, épaisseur de la peau) varie énormément, et chacune de ces variables remodèle le signal. Un modèle entraîné sur mon visage peut être presque inutile sur le vôtre. La littérature EMG ancienne regorge de systèmes annonçant une excellente précision « par sujet, après calibration », une précision qui enterre discrètement le produit. Un appareil qui nécessite une heure d'entraînement propre à chaque utilisateur avant de fonctionner est une démo de recherche, pas un périphérique.
Ce qui me semble vraiment intéressant dans l'effort RF actuel, c'est qu'ils ont d'abord tenté la voie astucieuse (adaptation de domaine algorithmique, astuces de normalisation du signal) et conclu que le seul levier qui fonctionne est la puissance brute du pré-entraînement. Ils ont donc construit des cabines d'enregistrement dans leurs locaux, payé des participants pour lire des consignes tout en portant les lunettes, et observé les taux d'erreur baisser selon une courbe de mise à l'échelle nette à mesure que le jeu de données grossissait. Le résultat annoncé : un nouvel utilisateur n'a besoin que d'une vingtaine de phrases de calibration pour que le système fonctionne bien. Ce chiffre compte davantage que n'importe quel taux de précision. Vingt phrases, c'est un parcours d'accueil tolérable ; une heure de relevés, c'est une demande de remboursement.
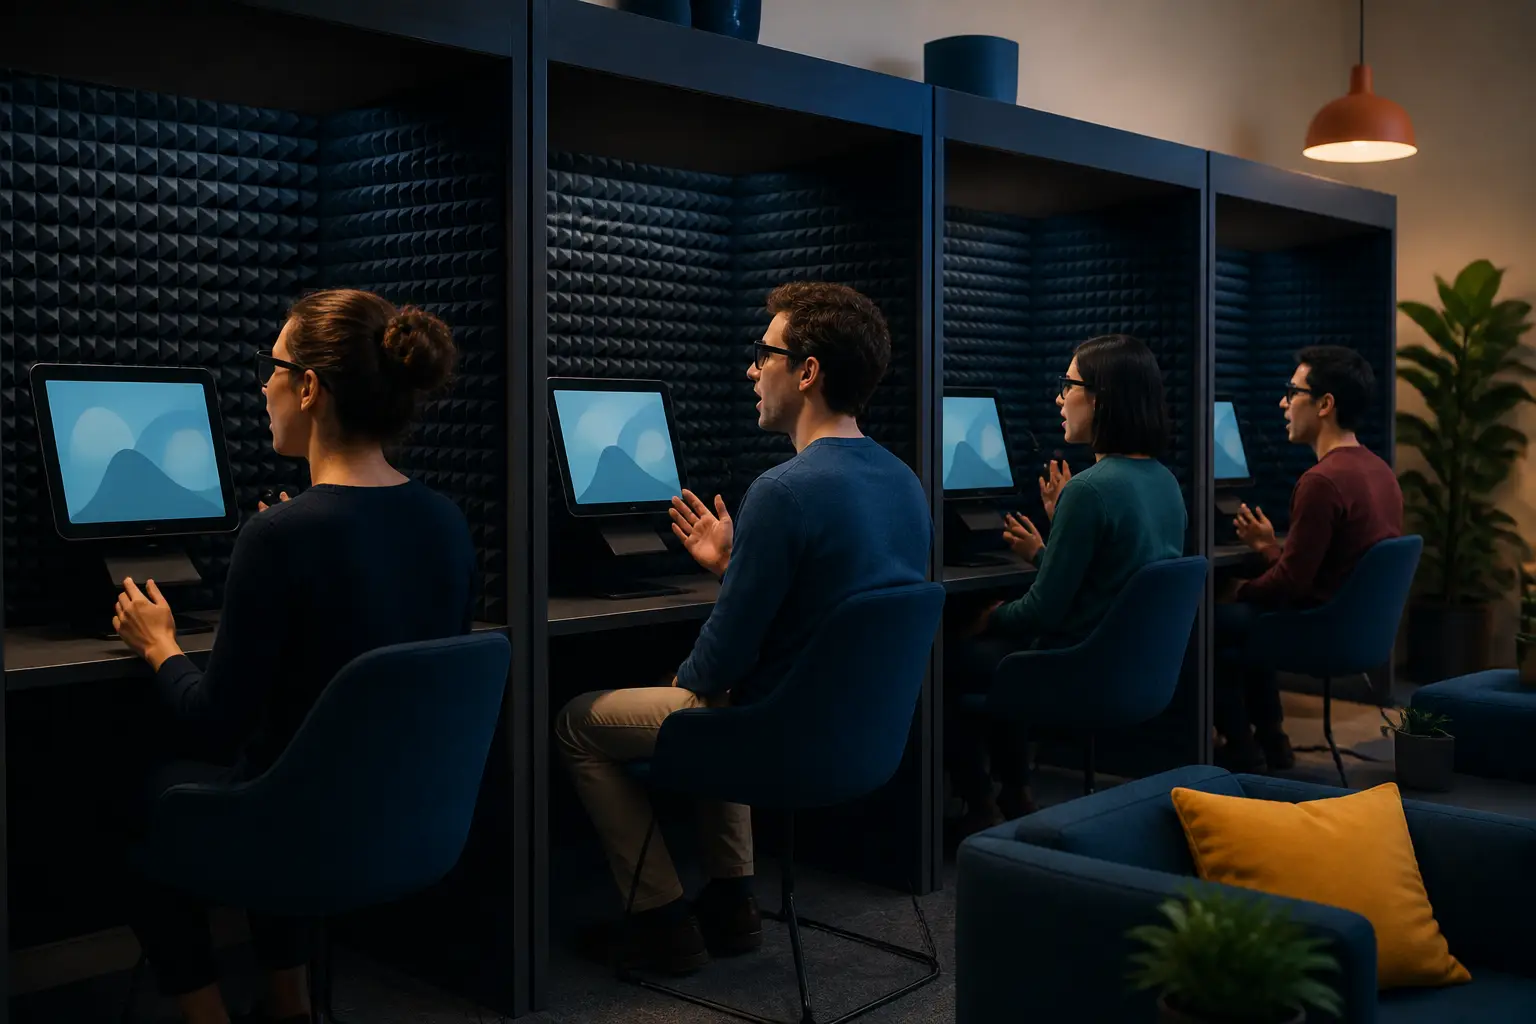
C'est la leçon que l'apprentissage automatique ne cesse de nous rappeler : quand un modèle ne généralise pas, la réponse est généralement davantage de données diversifiées, pas une architecture plus astucieuse. Nous l'avons vu se jouer dans la reconnaissance vocale, dans la traduction automatique pour les langues peu dotées, et dans chaque domaine où la distribution des entrées change d'un utilisateur à l'autre. La parole silencieuse subit simplement un décalage par utilisateur particulièrement vicieux, car le « micro » est en partie constitué de l'utilisateur lui-même.
Là où la parole silencieuse gagne vraiment
Une fois la nouveauté écartée, les cas d'usage se rangent dans une hiérarchie claire. En tête : l'accessibilité. Il y a une population de commentateurs (développeurs souffrant de lésions de répétition face à une opération du canal carpien double, personnes revenant dans des open spaces où la dictée est socialement impossible) pour qui ce n'est pas un gadget, mais la différence entre travailler et ne pas travailler. Les patients laryngectomisés et les personnes ayant une perte de parole liée à la SLA en sont la version plus profonde et plus importante. Toute évaluation honnête de cette technologie devrait en tenir largement compte.
Deuxièmement : les environnements bruyants, c'est l'argument contre-intuitif. Une modalité de détection qui ignore totalement l'acoustique ne se soucie ni de votre tondeuse, ni de votre salle serveur, ni de votre atelier. La voix échoue précisément là où la détection RF est indifférente. Troisièmement : la discrétion, dicter dans les bibliothèques, les open spaces, les trains. C'est l'argument grand public, et il est réel, mais je le considère comme le plus faible des trois, car il s'agit d'un confort social plutôt que d'une capacité nouvelle.
Ma position sur les compromis : cette technologie ne justifie son format que si l'inférence se fait sur l'appareil, ou du moins peut fonctionner hors ligne. Un capteur qui observe votre langue bouger dans votre bouche fermée et envoie les données brutes vers une API cloud est une architecture de confidentialité qu'aucun utilisateur ne devrait accepter. Les commentateurs inquiets des fuites de signaux involontaires ont un grief légitime, même si certaines craintes les plus spéculatives sont exagérées. La bonne nouvelle, c'est que les modèles de décodage sont assez petits pour tourner localement ; le domaine gagnerait à traiter la conception offline-first comme un minimum et non comme une option premium. Les équivalents du mot de réveil comptent aussi : les lunettes ont besoin d'un signal d'intention délibéré et physique (un geste, une série de serrements de mâchoire) avant d'écouter, sans quoi vous aurez construit un objet portable qui transcrit chacun de vos mouvements buccaux involontaires.
Un écho ancien me vient ici, impossible à ignorer. Dans les années 1870, les télégraphistes apprenaient à lire les messages au son du clic du relais, un canal d'entrée que personne n'avait conçu. L'histoire des interfaces est pleine de ces canaux latéraux qui deviennent des canaux de premier plan dès qu'on construit le décodeur. Le murmure musculaire subvocal est un canal latéral de la lecture et de la pensée, que les humains laissent fuir depuis qu'ils ont un monologue intérieur. En faire un périphérique de saisie relève moins de l'invention que de la promotion. Et si les courbes de mise à l'échelle tiennent, la personne la plus silencieuse de la bibliothèque sera peut-être bientôt celle qui tape le plus.