Silent-Speech-Schnittstellen: Warum RF Elektroden schlägt
Silent-Speech-Schnittstellen dekodieren lautlos geformte Wörter per Muskel- und HF-Signal. Warum Sensorwahl und Rauschproblem sie vom Diktat unterscheiden.
 James Whitfield
Du sitzt in der Bibliothek, die Diktier-App läuft, und du hast gerade dieselbe E-Mail viermal lautlos in deinen Laptop gemurmelt wie ein Verrückter, weil Sprechen dir im ganzen Lesesaal einen Blick einbrächte. Genau für diesen Moment gibt es Silent-Speech-Schnittstellen – Systeme, die Wörter dekodieren, die du formst oder auch nur formen willst, ohne dass ein einziger hörbarer Laut deinen Körper verlässt. Eine neue Generation von Startups setzt darauf, dass das fehlende Eingabegerät des KI-Zeitalters kein besseres Mikrofon ist. Sondern gar keins.
Die Idee ist älter, als die aktuelle Welle an Demos vermuten lässt. NASA-Forscher experimentierten Mitte der 2000er-Jahre mit subvokaler Erkennung, ursprünglich für Astronauten und Flugcrews in lauten oder druckangezogenen Raumanzügen. Das MIT Media Lab machte sie 2018 mit AlterEgo berühmt, einem tragbaren Headset, das neuromuskuläre Signale von Kiefer und Gesicht erfasste. Was sich jüngst verändert hat, ist nicht das Konzept, sondern dass günstige Funkhardware, bessere Machine-Learning-Verfahren und die plötzliche Verbreitung von Voice-AI zusammengekommen sind und die Technik fast beherrschbar machen. Fast. Das Signal-Rausch-Problem ist hier wirklich brutal, und wie Teams es lösen, bestimmt alles am Produkt, das am Ende ausgeliefert wird.
Sprechen ohne Ton: Was Subvokalisation wirklich ist
Es lohnt sich, eine nützliche Terminologie sauber zu trennen, denn das Feld vermischt drei verschiedene Dinge. Erstens das Mundbewegen: volle Artikulation mit Lippen, Zunge und Kiefer, nur ohne Stimme. Zweitens innere Sprache – die Lippen sind geschlossen, aber Zunge und weicher Gaumen bewegen sich gezielt, als würden sie Wörter formen. Drittens die echte Subvokalisation, die schwache, unwillkürliche Muskelaktivierung, die beim Lesen oder Denken in Worten auftritt. Letztere ist die Science-Fiction-Variante und außerhalb eines Labors kaum messbar. Funktionierende Produkte bewegen sich heute in den ersten beiden Kategorien. Ein Team, das RF-Sensorbrillen baut, beschreibt das Zielverhalten als „Mundbewegen mit geschlossenen Lippen“ – ein merkwürdiger Hybrid, den Nutzer offenbar nach wenigen Sitzungen lernen.
Als Sprachnerd finde ich die Linguistik hier faszinierend. Artikulation ist ein motorisches Programm, das dein Gehirn unabhängig davon abspult, ob die Stimmlippen schwingen. Stimmhaftigkeit ist nur eine Stufe der Sprachproduktion – der Teil, in dem der Kehlkopf akustische Energie hinzufügt. Entfernt man ihn, bleibt die gesamte vorgelagerte Choreografie erhalten: Zungenposition für Vokale, Lippenrundung, Gaumensegelsteuerung für Nasale. Eine Silent-Speech-Schnittstelle versucht im Grunde, die Phonemfolge aus den Resten dieser Choreografie zu rekonstruieren – ähnlich, wie man eine Melodie aus den Fingern eines Pianisten auf einem stummen Klavier erraten würde. Es ist Lippenlesen von innen.
Dieser Rahmen ist wichtig, weil er vorgibt, was die Sensoren messen müssen. Niemand liest deine Gedanken. Jedes erfolgreiche System greift auf ein physisches Korrelat der Artikulation zurück – elektrische Impulse, Gewebebewegung oder reflektierte Energie –, und die Wahl dieses Korrelats ist die zentrale technische Entscheidung.
EMG: Der naheliegende Sensor, der dich verrät
Elektromyografie ist der Ausgangspunkt, bei dem fast alle anfangen, weil die Logik unwiderstehlich ist. Muskeln feuern, weil Motoneuronen elektrische Potenziale über Membranen verteilen; klebst du eine Elektrode auf die Haut über dem richtigen Muskel, kannst du das live beobachten. Die Oberflächen-EMG ist eine ausgereifte Technik – Prothesen werden seit Jahrzehnten über Restmuskelsignale gesteuert. Für einen Wochenend-Hackathon kannst du dir Elektroden wörtlich ins Gesicht kleben, sie an einen Verstärker anschließen und bekommst etwas, das grob mit gemurmelten Buchstaben korreliert. Mehrere Silent-Speech-Prototypen wurden genau so gebaut, darunter das inzwischen berühmte MIT AlterEgo und, Berichten zufolge, der erste grobe Versuch des Teams, das heute RF-Brillen ausliefert.
Dann holt einen die Realität ein, mit einer deprimierend vorhersehbaren Liste an Fehlerquellen:
- Schweiß. Die Hautleitfähigkeit verändert sich beim Schwitzen, sodass dasselbe gemurmelte Wort um 9 Uhr morgens anders aussieht als nach dem Mittagessen. Deine Kalibrierung veraltet ständig unter dir.
- Elektrische Störungen. Die EMG-Signale des Gesichts liegen im Mikrovoltbereich. Nahe Stromleitungen, das Schaltnetzteil deines Laptops oder sogar Blinzeln können sie überlagern.
- Platzierungsschwankungen. Eine Verschiebung der Elektrode um zwei Millimeter ändert, welche Muskelfasern das Signal dominieren. Nimmst du das Gerät ab und setzt es wieder auf, misst das gestrige Modell eine etwas andere Person.
- Das kosmetische Ausschlusskriterium. Niemand trägt öffentlich Gel-Elektroden im Gesicht. Das klingt banal, hat den Ansatz trotzdem zu Fall gebracht.
Dieser letzte Punkt verdient Respekt. Consumer-Hardware scheitert weitaus öfter an Reibung als an der Physik. Die Geschichte der Wearables ist ein Friedhof von Geräten, die im Labor funktionierten und den Nutzer einen Schritt zu viel kosteten. Knochenleitungs-Headsets, Brustgurt-Herzfrequenzmesser, EEG-Stirnbänder – alle technisch solide, alle Nischenprodukte. Verlangt dein Sensor tägliche Hautvorbereitung, hast du ein Medizinprodukt gebaut, keine Eingabeperipherie.
RF-Sensorik: Den Mund von innen lesen
Der Ansatz, der jetzt an Fahrt gewinnt, ersetzt Elektroden durch Funk. Die Idee: In Brillengestelle eingebettete Antennen senden schwache Funkwellen im Bluetooth-nahen Frequenzbereich aus, die durch dein Gesicht dringen. Wenn die Wellen sich bewegendes Gewebe durchqueren – Zunge, Lippen, weichen Gaumen –, werden sie auf winzige, strukturierte Weise moduliert. Empfangsantennen fangen das veränderte Signal auf, und ein neuronales Netz lernt, diese Veränderungen wieder in Text zu übersetzen. Es ist dieselbe physikalische Familie wie die WLAN-basierte Gestenerkennung und das Radar, das Google im Pixel 4 für Handgesten verbaut hat, nur auf ein deutlich subtileres Ziel gerichtet.
Der Reiz: RF sieht, was Kameras und Hautelektroden nicht sehen können. Die Zunge ist von außen unsichtbar, sobald die Lippen geschlossen sind, aber sie ist ein großer, wasserreicher Muskel, mit dem Radiowellen stark interagieren. Innere Sprache bei geschlossenen Lippen – der diskrete Modus, den Menschen in einem Meeting tatsächlich wollen – ist nur über eine Durchdringungs-Modalität wie diese erreichbar. Das ist das gesamte Produktargument in einem Satz: EMG und Kameras erfassen die Außenseite der Artikulation, RF erfasst die Innenseite.
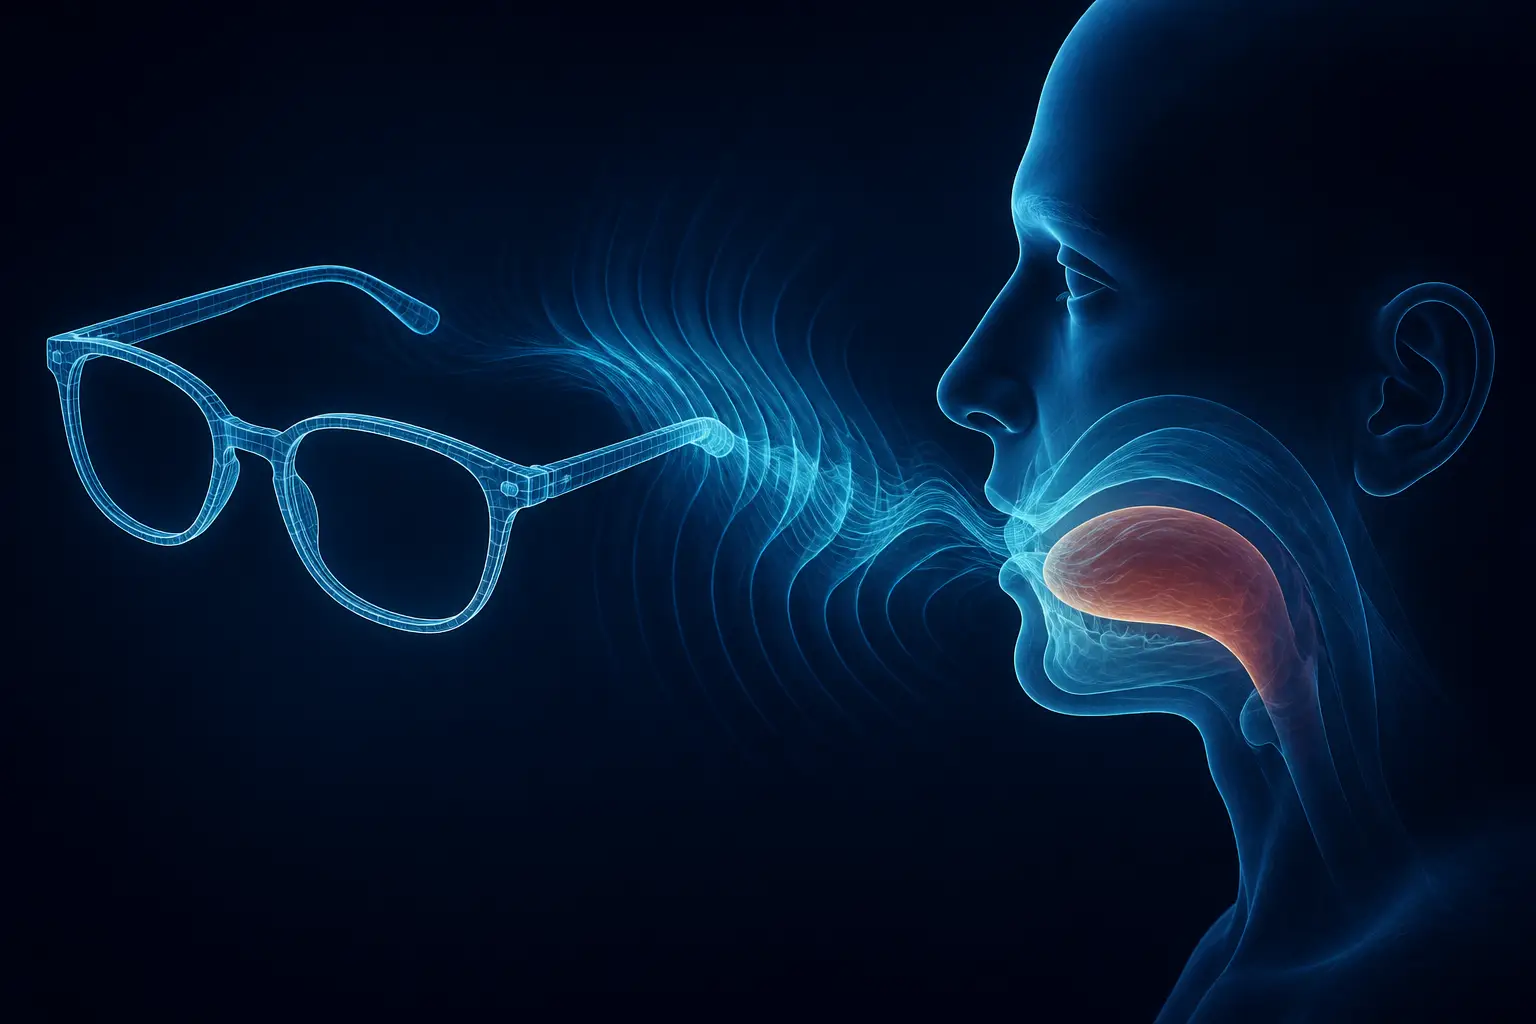
Der Weg dorthin ist technisch alles andere als sanft. Das Signal, das du suchst, ist eine winzige Modulation auf einem Trägersignal, also muss das gesamte HF-Frontend extrem rauscharm sein. Die Antennenplatzierung ist ein Optimierungsproblem mit Biss: Die elektromagnetischen Felder müssen sich maximal mit den Artikulatoren überschneiden, was simulationslastiges Rahmendesign bedeutet, bei dem Millimeter der Antennenposition bestimmen, was das System hören kann. Das Team hinter dem aktuellen Brillenprototyp gibt zu, dass der erste brillenintegrierte Versuch komplett scheiterte. Sie gingen zurück zu Antennen, die im Gesicht festgeklebt wurden, dann zu einer starren Kopfhalterung, um die Geometrie konstant zu halten, bevor Simulationsarbeit die Rahmen richtig machte. Diese Abfolge – Klebeband, Halterung, Produkt – ist die ehrliche Archäologie von Hardware, die tatsächlich ausgeliefert wird.
Kameras und Ultraschall: Die Mitläufer mit echten Nischen
Der Kameraweg – visuelles Lippenlesen – hat die tiefste Forschungstradition. LipNet zeigte vor Jahren das satzweise Lippenlesen aus Video, Open-Source-Projekte replizieren den Trick seitdem mit einer Webcam und einem Gesichtstracker. Es ist der denkbar günstigste Sensor: Du besitzt ohnehin drei Kameras. Aber er erbt die brutale Einschränkung, dass er nur die Außenseite deines Gesichts sieht. Innere Sprache bei geschlossenem Mund ist per Definition unsichtbar, Licht und Kopfwinkel verfälschen den Input ständig, und eine Kamera den ganzen Tag auf das eigene Gesicht zu richten, kostet Privatsphäre und Akku, und zwar dauerhaft. Lippenlesen bleibt hervorragend als Ergänzung zur Spracherkennung – audiovisuelle Modelle übertreffen reine Audiomodelle im Lärm tatsächlich deutlich –, doch als eigenständige lautlose Schnittstelle ist es auf das Ende des Spektrums „offensichtlich Mundbewegen“ beschränkt.
Ultraschall besetzt eine seltsamere Mittelposition. Akademische Systeme haben Ultraschallwandler auf den Kiefer gerichtet und die Zungenbewegung aus Echos rekonstruiert, und Zungen-Ultraschallbildgebung ist ein Standardwerkzeug der Phonetikforschung – so beobachtet man seit Jahrzehnten, wie Vokale entstehen. Die Sensorik ist gut. Die Bauform ist es nicht. Niemand hat herausgefunden, wie man eine kinngekoppelte Ultraschallsonde in etwas verpackt, das man zu einem Stand-up-Meeting tragen würde, und akustische Kopplung über Luft ist verlustbehaftet und winkelempfindlich. Meine Einschätzung: Ultraschall ist die richtige Antwort für die klinische Sprachtherapie und Phonetiklabore und die falsche für Consumer-Eingabe.
Wenn du mitzählst, sieht die Abwägung ungefähr so aus:
- EMG: direktes Muskelsignal, gute Bandbreite – ruiniert durch Schweiß, Drift, Platzierung und die Notwendigkeit, Elektroden im Gesicht zu tragen.
- Lippenlesen per Kamera: keine Hardwarekosten, ausgereifte Modelle – blind für Sprache bei geschlossenem Mund, anfällig für Licht, datenschutzfeindlich.
- Ultraschall: bildet die Zunge direkt ab – Kopplung und Bauform machen ihn zu einem Laborinstrument.
- RF-Durchdringungssensorik: erfasst innere Artikulatoren durch die Haut, lässt sich in Brillen einbauen – erfordert einen exotischen rauscharmen HF-Stack und Berge an Trainingsdaten.
Das Signal-Rausch-Problem ist nicht das Diktat-Problem
Hier liegt der gedankliche Fehler, den die meisten von uns zuerst machen, wenn sie von diesen Geräten hören: Wir nehmen an, es sei Spracherkennung minus die Luft. Ist es nicht. Audiodiktat setzt auf ein Signal, das die Natur für Kommunikation konstruiert hat – Zig Dezibel sauberer Druckwelle, von der Evolution so geformt, dass sie Phoneme durch einen Raum trägt. Die harten Teile von ASR sind Akzente, Wortschatz und Rauschunterdrückung. Das Signal selbst ist großzügig.
Die lautlose Sprachsensorik hat das genaue Gegenteil als Profil. Der Träger – ob Mikrovolt bei EMG oder eine schwache RF-Modulation – war nie dafür gedacht, Sprache zu kodieren. Phonem-Information ist über die Sensorkanäle verschmiert, ohne saubere Zuordnung, und die Störfaktoren sind physiologisch, nicht akustisch. Schlucken, Kiefer anspannen, den Kopf drehen, das Gesicht berühren: Jedes davon erzeugt einen Transienten, der das Artikulationssignal übertönen kann. Wo ein ASR-System gegen einen lauten Raum kämpft, kämpft ein Silent-Speech-System gegen deinen eigenen Körper. Du bist das Grundrauschen.
Daraus folgen zwei Konsequenzen. Erstens lehnen sich diese Systeme viel stärker auf Sprachmodellierung an als Diktat. Wenn die Sensorevidenz für ein Phonem mehrdeutig ist, löst der Decoder sie mit Vorannahmen darüber auf, was du wahrscheinlich sagen wolltest – derselbe Trick, der constrained decoding so wirksam macht, wenn es darum geht, unscharfe Modellausgaben in verlässliche Entscheidungen zu verwandeln. Erwarte, dass Silent-Speech-Systeme bei vorhersehbarem Text (Befehle, E-Mails in deinem eigenen Stil) erstaunlich gut sind und bei seltenen Wörtern, Namen und Code-Bezeichnern merklich schlechter, wo die Vorannahme ein schwaches Signal nicht retten kann. Zweitens ist die Kalibrierung strukturell, nicht zufällig. Audio-ASR hat sich vor Jahrzehnten über Sprecher hinweg verallgemeinert, weil eine Wellenform eine Wellenform ist. Eine Gesichts-RF-Signatur ist das nicht – und damit kommen wir zum schwierigsten Problem des Feldes.
Jedes Gesicht ist ein eigenes Antennenproblem
Nutzerübergreifende Generalisierung ist der Ort, an dem Silent-Speech-Prototypen sterben. Die Gesichtsanatomie – Kieferlänge, Zungengröße, Gewebedichte, Hautdicke – variiert enorm, und jede dieser Variablen formt das Signal um. Ein Modell, das an meinem Gesicht trainiert wurde, kann an deinem nahezu nutzlos sein. Die frühe EMG-Literatur ist voll von Systemen, die eine hervorragende Genauigkeit „pro Person, nach Kalibrierung“ melden – eine Einschränkung, die das Produkt stillschweigend begräbt. Ein Gerät, das vor der Nutzung eine Stunde Training pro Person braucht, ist eine Forschungsdemo, kein Peripheriegerät.
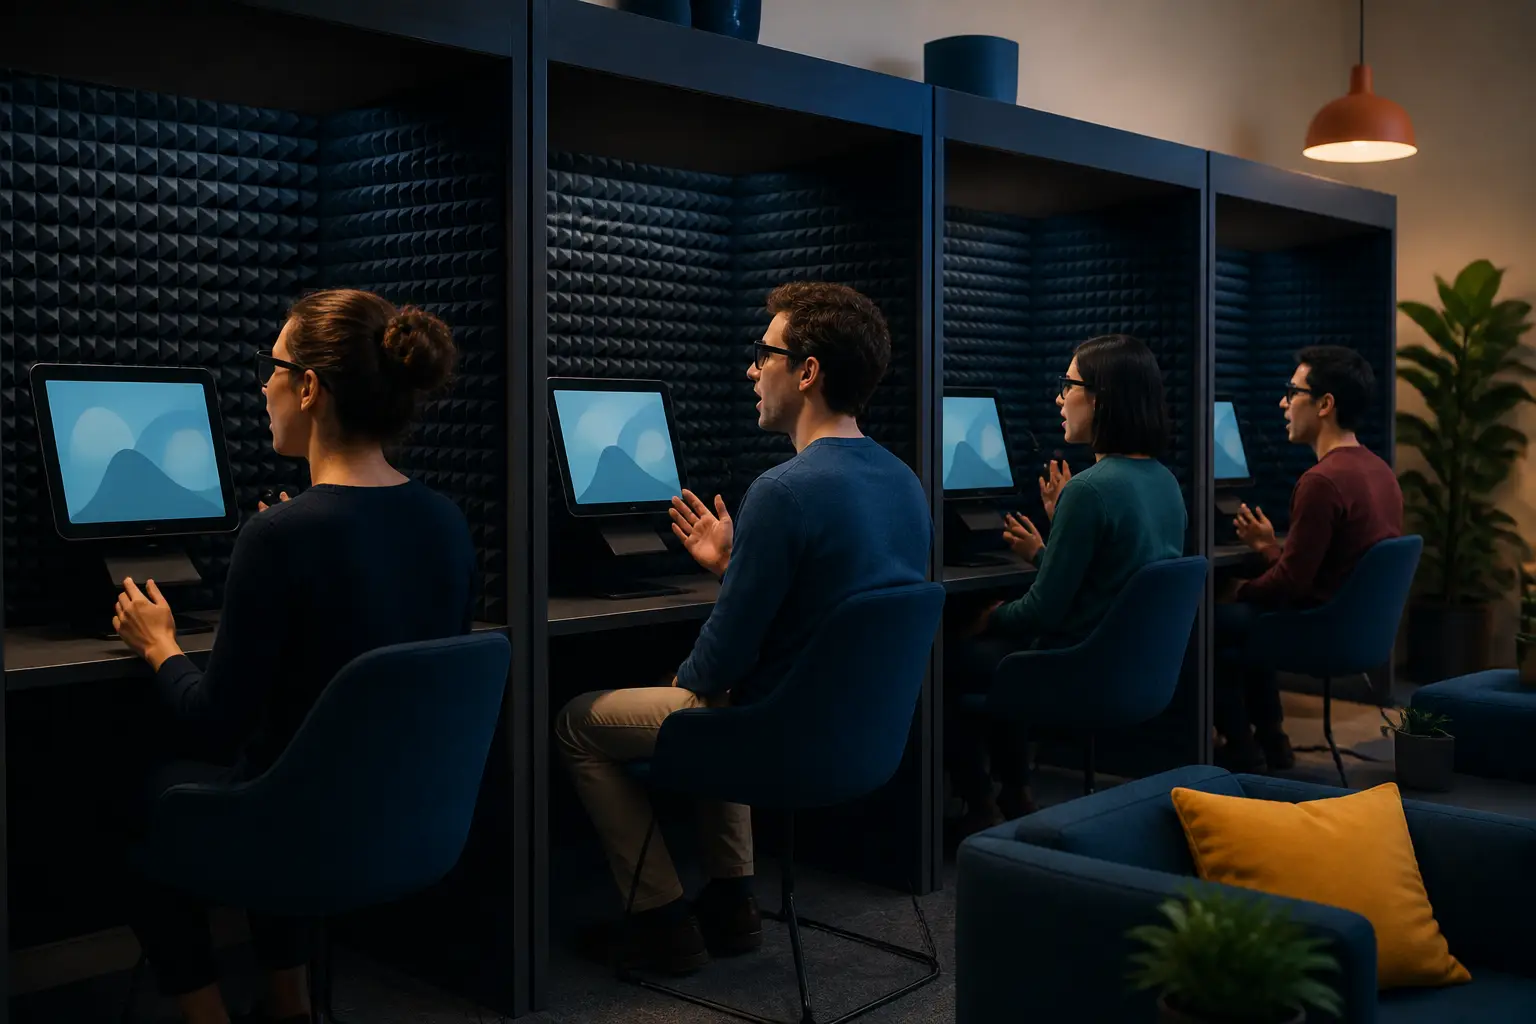
Was ich an der aktuellen RF-Arbeit wirklich spannend finde: Sie haben zuerst den cleveren Weg versucht – algorithmische Domänenanpassung, Signalnormalisierungstricks – und kamen zu dem Schluss, dass nur ein Hebel funktioniert: schiere Vortrainingsskala. Also bauten sie Aufnahmekabinen in ihrem Büro, bezahlten Leute, damit sie Prompts vorlesen, während sie die Brille trugen, und sahen zu, wie die Fehlerquoten entlang einer sauberen Skalierungskurve fielen, je größer der Datensatz wurde. Das berichtete Ergebnis: Ein neuer Nutzer braucht nur etwa zwanzig Kalibrierungssätze, bevor das System gut funktioniert. Diese Zahl ist wichtiger als jede Genauigkeitsangabe. Zwanzig Sätze sind ein erträglicher Onboarding-Ablauf; eine Stunde Messungen ist eine Rücksendung.
Dieselbe Lektion lehrt uns der Rest des Machine Learning immer wieder: Wenn ein Modell nicht generalisiert, liegt die Antwort meist in mehr und vielfältigeren Daten, nicht in einer cleveren Architektur. Wir haben das bei der Spracherkennung beobachtet, bei maschineller Übersetzung für ressourcenarme Sprachen und überall dort, wo sich die Eingabeverteilung pro Nutzer verschiebt. Silent Speech hat nur eine besonders heimtückische Verschiebung pro Nutzer, weil das „Mikrofon“ teilweise aus dem Nutzer selbst besteht.
Wo Silent Speech tatsächlich gewinnt
Entfernt man die Neuheit, sortieren sich die Anwendungsfälle in eine klare Hierarchie. Ganz oben steht Barrierefreiheit. Es gibt eine Gruppe von Kommentatoren – Entwickler mit Verletzungen durch wiederholte Belastung, die sich einer doppelten Karpaltunnel-Operation gegenübersehen, Menschen, die in offene Büros zurückkehren, wo Diktieren gesellschaftlich unmöglich ist –, für die das kein Gadget ist, sondern der Unterschied zwischen Arbeiten und Nichtarbeiten. Kehlkopflose Patienten und Menschen mit sprachlichen Verlusten im Umfeld von ALS sind die tiefere, wichtigere Version derselben Geschichte. Jede ehrliche Bewertung dieser Technik sollte das stark gewichten.
Zweitens: laute Umgebungen, und das ist der kontraintuitive Punkt. Eine Sensorik, die Akustik vollständig ignoriert, kümmert sich nicht um deinen Rasenmäher, deinen Serverraum oder deine Fabrikhalle. Sprache versagt genau dort, wo RF-Sensorik unbeeindruckt bleibt. Drittens: Diskretion – Diktieren in Bibliotheken, offenen Büros, Zügen. Das ist der Mainstream-Consumer-Pitch, und er ist real, aber ich würde ihn als den schwächsten der drei einstufen, weil er eher eine soziale Komfortfunktion als ein Fähigkeitszuwachs ist.
Meine Position zu den Abwägungen: Diese Technik rechtfertigt ihre Bauform nur, wenn die Inferenz auf dem Gerät oder zumindest offline möglich ist. Ein Sensor, der deine Zunge bei geschlossenem Mund beobachtet und Rohdaten an eine Cloud-API streamt, ist eine Datenschutzarchitektur, die niemand akzeptieren sollte – die Kommentatoren, die sich über das Leaken unwillkürlicher Signale sorgen, haben ein berechtigtes Anliegen, auch wenn manche der spekulativeren Ängste übertrieben sind. Die gute Nachricht: Die Dekodierungsmodelle sind klein genug, um lokal zu laufen. Die Branche täte gut daran, Offline-first-Design als Grundvoraussetzung zu behandeln statt als Premium-Stufe. Auch Entsprechungen zu Wake-Words sind wichtig: Die Brille braucht eine bewusste, physische Absichtsbekundung – eine Geste oder ein Kiefermuster –, bevor sie zuhört, sonst hast du ein Wearable gebaut, das jede unwillkürliche Mundbewegung transkribiert.
Ein älteres Echo kann ich mir hier nicht verkneifen. Telegrafisten der 1870er-Jahre lernten, Nachrichten am Klicken des Relais zu lesen, einem Eingabekanal, den niemand entworfen hatte. Die Geschichte der Schnittstellen ist voll von solchen Nebenkanälen, die zu vollwertigen Kanälen wurden, sobald jemand den Decoder baute. Das subvokale Muskelgemurmel ist ein Nebenkanal des Lesens und Denkens, den Menschen so lange ausgesendet haben, wie sie innere Monologe führen. Ihn in ein Eingabegerät zu verwandeln, ist weniger eine Erfindung als eine Beförderung – und wenn die Skalierungskurven halten, erledigt vielleicht bald der leiseste Mensch in der Bibliothek die meiste Tipparbeit.