साइलेंट स्पीच इंटरफ़ेस: इलेक्ट्रोड्स से आगे RF क्यों जीता
साइलेंट स्पीच इंटरफ़ेस मांसपेशी और RF सिग्नल से बिना आवाज़ के बोले शब्द पहचानते हैं। जानिए सेंसर के ट्रेडऑफ़ और सिग्नल-टू-नॉइज़ समस्या इन्हें डिक्टेशन से अलग क्यों बनाती है।
 James Whitfield
आप लाइब्रेरी में बैठे हैं, डिक्टेशन ऐप चालू है, और आपने अभी-अभी लैपटॉप में एक ही ईमेल चार बार होठों से बुदबुदाया है, किसी पागल की तरह, क्योंकि ज़ोर से बोलते तो पूरे फ़्लोर की नज़रें आप पर होतीं। साइलेंट स्पीच इंटरफ़ेस ठीक ऐसे ही पल के लिए बने हैं, ऐसे सिस्टम जो आपके होठों की हरकत को, या बस बोलने के इरादे को भी डिकोड कर लें, और शरीर से एक भी आवाज़ बाहर न निकले। स्टार्टअप्स की एक नई खेप यह दांव लगा रही है कि AI युग का गायब इनपुट डिवाइस कोई बेहतर माइक्रोफ़ोन नहीं होगा। असल में कोई माइक्रोफ़ोन होगा ही नहीं।
यह विचार मौजूदा डेमो की लहर से कहीं पुराना है। NASA के शोधकर्ता 2000 के दशक के मध्य में सबवोकल रिकग्निशन के प्रयोग कर रहे थे, शुरुआत में अंतरिक्ष यात्रियों और उन फ़्लाइट क्रू के लिए जो शोर वाले या प्रेशर सूट वाले माहौल में काम करते हैं। MIT Media Lab ने 2018 में AlterEgo के साथ इसे मशहूर किया, एक पहनने वाला हेडसेट जो जबड़े और चेहरे से न्यूरोमस्कुलर सिग्नल पकड़ता था। हाल में जो बदला है वह कॉन्सेप्ट नहीं है, बल्कि यह है कि सस्ता रेडियो हार्डवेयर, बेहतर मशीन लर्निंग और वॉयस AI की अचानक मुख्यधारा में आई लोकप्रियता एक साथ आए, जिससे इंजीनियरिंग लगभग व्यावहारिक लगने लगी है। लगभग। यहां सिग्नल-टू-नॉइज़ समस्या सचमुच बेरहम है, और टीमें इसे जैसे सुलझाती हैं, उसी से तय होता है कि आखिर में वे कैसा प्रोडक्ट शिप करेंगी।
बिना आवाज़ के बोलना: सबवोकलाइज़ेशन असल में क्या है
यहां एक काम की टर्मिनोलॉजी समझना ज़रूरी है, क्योंकि यह फ़ील्ड तीन अलग चीज़ों को आपस में मिला देता है। पहली है माउथिंग: होंठ, जीभ और जबड़े की पूरी आर्टिक्युलेशन, बस आवाज़ नहीं। दूसरी है इंटरनल स्पीच: होंठ बंद, लेकिन जीभ और सॉफ़्ट पैलेट अब भी जानबूझकर शब्द बनाने की तरह हिल रहे हों। तीसरी है असली सबवोकलाइज़ेशन, मांसपेशियों की वह हल्की, अनैच्छिक सक्रियता जो तब होती है जब आप शब्दों में पढ़ते या सोचते हैं। आखिरी वाली साइंस-फ़िक्शन जैसी है और लैब के बाहर मुश्किल से पकड़ में आती है। आज के काम के प्रोडक्ट पहली दो श्रेणियों में हैं। RF-सेंसिंग ग्लास बनाने वाली एक टीम अपने लक्ष्य व्यवहार को “होंठ बंद करके माउथिंग” कहती है, यानी एक अजीब-सा हाइब्रिड, जिसे यूज़र कुछ सेशन में सीख लेते हैं।
भाषाविज्ञान का छात्र होने के नाते मुझे यहां की लिंग्विस्टिक्स बहुत मज़ेदार लगती है। आर्टिक्युलेशन एक मोटर प्रोग्राम है, जिसे आपका दिमाग तब भी चलाता है जब वोकल फ़ोल्ड्स कंपन न करें। वॉइसिंग स्पीच प्रोडक्शन का सिर्फ़ एक चरण है, वह हिस्सा जहां लैरिंक्स ध्वनिक ऊर्जा जोड़ता है। उसे हटा दें तो ऊपर की पूरी कोरियोग्राफ़ी बची रहती है: स्वरों के लिए जीभ की स्थिति, होंठों का गोल होना, नासिक्य ध्वनियों के लिए वेलम का नियंत्रण। साइलेंट स्पीच इंटरफ़ेस असल में इसी कोरियोग्राफ़ी के अवशेष से फ़ोनीम का क्रम दोबारा बनाने की कोशिश है, जैसे किसी म्यूट पियानो पर पियानोवादक की उंगलियां देखकर धुन पहचानना। यह अंदर से होंठ पढ़ने जैसा है।
यह फ़्रेमिंग मायने रखती है, क्योंकि यह बताती है कि सेंसर को क्या मापना होगा। कोई आपका मन नहीं पढ़ रहा। हर सफल सिस्टम आर्टिक्युलेशन के किसी भौतिक संकेत से जुड़ता है: विद्युत आवेग, ऊतक की गति, या परावर्तित ऊर्जा। और कौन-सा संकेत पकड़ना है, यही बुनियादी इंजीनियरिंग फ़ैसला होता है।
EMG: वह स्पष्ट सेंसर जो आपको धोखा देता है
इलेक्ट्रोमायोग्राफ़ी से लगभग सभी लोग शुरुआत करते हैं, क्योंकि तर्क बहुत आकर्षक है। मोटर न्यूरॉन झिल्लियों के पार विद्युत विभव छोड़ते हैं, इसलिए मांसपेशी चलने पर त्वचा पर सही जगह लगाया गया इलेक्ट्रोड उसे दर्ज कर लेता है। सरफ़ेस EMG एक परिपक्व तकनीक है, प्रोस्थेटिक अंग दशकों से अवशेष मांसपेशी सिग्नल से चलाए जाते रहे हैं। किसी वीकेंड हैकाथॉन के लिए आप सचमुच चेहरे पर इलेक्ट्रोड चिपका सकते हैं, उन्हें एम्प्लिफ़ायर से जोड़ सकते हैं, और ऐसा कुछ पा सकते हैं जो बुदबुदाए अक्षरों से मोटे तौर पर मेल खाता हो और टिमटिमाता हो। कई साइलेंट स्पीच प्रोटोटाइप ठीक इसी तरह बने हैं, जिनमें मशहूर MIT AlterEgo और, कहा जाता है, RF ग्लास शिप कर रही टीम की पहली कच्ची कोशिश भी शामिल है।
फिर हकीकत सामने आती है, विफलता के मोड्स की एक निराशाजनक रूप से अनुमानित सूची के साथ:
- पसीना। पसीना आने पर त्वचा की चालकता बदलती है, इसलिए वही बुदबुदाया शब्द सुबह 9 बजे और लंच के बाद अलग दिखता है। आपकी कैलिब्रेशन लगातार आपके नीचे से खिसकती रहती है।
- इलेक्ट्रिकल इंटरफ़ेरेंस। चेहरे के EMG सिग्नल माइक्रोवोल्ट रेंज में होते हैं। पास की बिजली की लाइनें, आपके लैपटॉप की स्विचिंग सप्लाई, यहां तक कि पलक झपकना भी उन्हें दबा सकता है।
- प्लेसमेंट की परिवर्तनशीलता। इलेक्ट्रोड की स्थिति में दो मिलीमीटर का खिसकाव भी बदल देता है कि कौन-से मांसपेशी फ़ाइबर रीडिंग पर हावी हैं। डिवाइस उतारकर दोबारा लगाएं, तो कल का मॉडल थोड़े अलग इंसान को माप रहा होता है।
- कॉस्मेटिक डीलब्रेकर। कोई भी सार्वजनिक जगह पर चेहरे पर जेल इलेक्ट्रोड नहीं लगाना चाहेगा। यह मामूली लगता है, फिर भी इसी ने इस तरीके को वैसे भी मार दिया।
इस आखिरी बात को गंभीरता से लेना चाहिए। कंज़्यूमर हार्डवेयर भौतिकी से कम, घर्षण से ज़्यादा फ़ेल होता है। वियरेबल्स का इतिहास ऐसे डिवाइसों का कब्रिस्तान है जो लैब में चलते थे, पर यूज़र से एक कदम ज़्यादा मांगते थे। बोन-कंडक्शन हेडसेट, चेस्ट-स्ट्रैप हार्ट मॉनिटर, EEG हेडबैंड, तकनीकी रूप से सब ठीक थे, सब सीमित दायरे तक ही पहुंचे। जब आपके सेंसर को रोज़ त्वचा की तैयारी चाहिए, तो आपने इनपुट पेरिफ़ेरल नहीं, मेडिकल डिवाइस बना दिया है।
RF सेंसिंग: अंदर से मुंह पढ़ना
जो तरीका अभी ज़ोर पकड़ रहा है, वह इलेक्ट्रोड की जगह रेडियो लाता है। विचार यह है कि चश्मे के फ़्रेम में लगे एंटीना कम-पावर रेडियो तरंगें छोड़ते हैं, Bluetooth के आसपास की फ़्रीक्वेंसी पर, जो आपके चेहरे से गुज़रती हैं। जब ये तरंगें चलते हुए ऊतकों, जैसे जीभ, होंठ और सॉफ़्ट पैलेट, के पार जाती हैं, तो वे छोटे और संरचित तरीकों से मॉड्यूलेट होती हैं। रिसीव एंटीना बदला हुआ सिग्नल उठाते हैं, और एक न्यूरल नेटवर्क उन बदलावों को वापस टेक्स्ट में मैप करना सीखता है। यह वही भौतिकी है जो Wi-Fi-आधारित जेस्चर सेंसिंग में है, और वही रडार जो Google ने हाथ के इशारों के लिए Pixel 4 में लगाया था, बस यहां निशाना कहीं ज़्यादा बारीक है।
RF की खूबी यह है कि वह वह देखता है जो कैमरा और त्वचा के इलेक्ट्रोड नहीं देख सकते। होंठ बंद होने के बाद जीभ बाहर से अदृश्य होती है, पर वह एक बड़ी, पानी से भरपूर मांसपेशी है, जिससे रेडियो तरंगें मज़बूती से इंटरैक्ट करती हैं। होंठ बंद करके किया जाने वाला इंटरनल स्पीच, यानी वह विवेकपूर्ण मोड जो लोग असल में मीटिंग में चाहते हैं, सिर्फ़ ऐसे ही थ्रू-टिश्यू मॉडेलिटी से पहुंच में आता है। पूरा प्रोडक्ट तर्क एक वाक्य में यही है: EMG और कैमरे आर्टिक्युलेशन का बाहरी हिस्सा पकड़ते हैं, RF अंदर का।
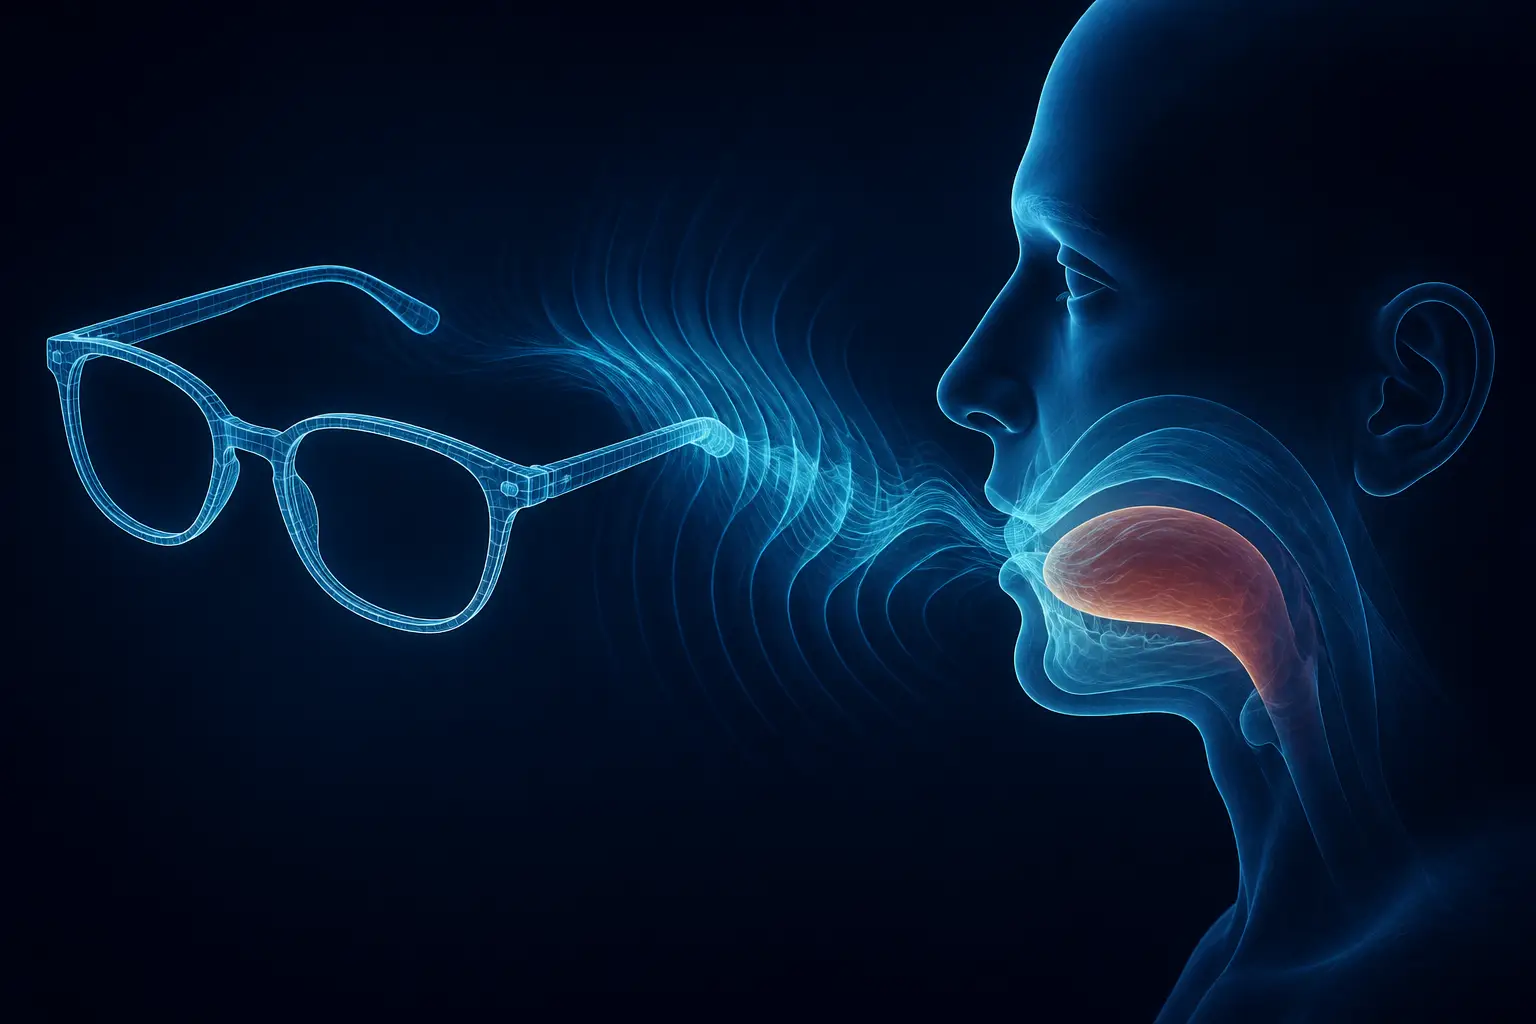
वहां तक पहुंचने की इंजीनियरिंग आसान नहीं है। जो सिग्नल आप चाहते हैं वह कैरियर पर सवार एक हल्का मॉड्यूलेशन है, इसलिए पूरा RF फ़्रंट एंड असाधारण रूप से कम-शोर वाला होना चाहिए। एंटीना प्लेसमेंट एक कठिन ऑप्टिमाइज़ेशन समस्या है: विद्युत-चुंबकीय क्षेत्र आर्टिक्युलेटर्स से अधिकतम ओवरलैप होने चाहिए, यानी फ़्रेम डिज़ाइन सिमुलेशन-भारी होता है, जहां एंटीना की कुछ मिलीमीटर स्थिति से तय होता है कि सिस्टम क्या सुन सकता है। मौजूदा ग्लास प्रोटोटाइप बना रही टीम मानती है कि उनका पहला चश्मा-एकीकृत प्रयास पूरी तरह विफल रहा, फिर वे एंटीना चेहरे पर चिपकाने पर लौटे, फिर ज्यामिति स्थिर रखने के लिए एक कठोर हेड रिग पर, और तब जाकर सिमुलेशन काम ने फ़्रेम सही किए। यह प्रगति, टेप, रिग, प्रोडक्ट, असल में उस हार्डवेयर का ईमानदार इतिहास है जो सचमुच शिप होता है।
कैमरा और अल्ट्रासाउंड: पीछे छूटे, पर असली निचे वाले
कैमरे वाला रास्ता, यानी विज़ुअल लिप रीडिंग, सबसे गहरी रिसर्च विरासत रखता है। LipNet ने कुछ साल पहले वीडियो से वाक्य-स्तर की एंड-टू-एंड लिप रीडिंग दिखाई थी, और ओपन-सोर्स प्रोजेक्ट वेबकैम और फ़ेस ट्रैकर से वही तरकीब दोहराते रहते हैं। यह सोचा जा सकने वाला सबसे सस्ता सेंसर है: आपके पास पहले से तीन कैमरे हैं। पर इसमें वही कठोर सीमा है कि यह आपके चेहरे का सिर्फ़ बाहरी हिस्सा देखता है। बंद मुंह वाला इंटरनल स्पीच परिभाषा से ही अदृश्य है, रोशनी और सिर का कोण इनपुट को लगातार बिगाड़ते हैं, और दिन भर अपने चेहरे पर कैमरा रखने की गोपनीयता और बैटरी लागत कभी खत्म नहीं होती। लिप रीडिंग ऑडियो स्पीच रिकग्निशन के लिए शानदार सहायक है, ऑडियो-विज़ुअल मॉडल शोर में सचमुच सिर्फ़-ऑडियो मॉडलों से बेहतर प्रदर्शन करते हैं, पर अकेले साइलेंट इंटरफ़ेस के रूप में यह स्पेक्ट्रम के “साफ़ तौर पर माउथिंग” छोर तक ही सीमित है।
अल्ट्रासाउंड एक अजीब बीच की ज़मीन पर है। शैक्षणिक सिस्टम जबड़े पर अल्ट्रासोनिक ट्रांसड्यूसर लगाकर गूंज से जीभ की गति दोबारा बना चुके हैं, और जीभ-अल्ट्रासाउंड इमेजिंग फ़ोनेटिक्स रिसर्च में सचमुच एक मानक उपकरण है, दशकों से इसी से स्वरों को बनते देखा गया है। सेंसिंग अच्छी है। फ़ॉर्म फ़ैक्टर नहीं। किसी ने अब तक यह नहीं सुलझाया कि ठोड़ी से जुड़े अल्ट्रासाउंड प्रोब को ऐसी चीज़ में कैसे पैक करें जिसे आप स्टैंडअप मीटिंग में पहनें, और हवा के ज़रिए ध्वनिक कपलिंग नुकसानदेह और कोण-संवेदी है। मेरी राय में अल्ट्रासाउंड क्लिनिकल स्पीच थेरेपी और फ़ोनेटिक्स लैब्स के लिए सही उत्तर है, और कंज़्यूमर इनपुट के लिए गलत।
अगर आप स्कोर रख रहे हैं, तो ट्रेडऑफ़ की तालिका लगभग ऐसी दिखती है:
- EMG: सीधा मांसपेशी सिग्नल, अच्छी बैंडविड्थ, लेकिन पसीना, ड्रिफ़्ट, प्लेसमेंट और चेहरे पर इलेक्ट्रोड पहनने की ज़रूरत इसे बिगाड़ देती है।
- कैमरा लिप रीडिंग: हार्डवेयर लागत शून्य, परिपक्व मॉडल, लेकिन बंद मुंह वाले स्पीच के प्रति अंधा, रोशनी से कमज़ोर, और गोपनीयता के लिए प्रतिकूल।
- अल्ट्रासाउंड: सीधे जीभ की इमेजिंग करता है, लेकिन कपलिंग और फ़ॉर्म फ़ैक्टर इसे लैब इंस्ट्रूमेंट बना देते हैं।
- RF थ्रू-फ़ेस सेंसिंग: त्वचा के पार अंदरूनी आर्टिक्युलेटर्स देखता है, चश्मों में समा जाता है, लेकिन इसके लिए एक विदेशी कम-शोर RF स्टैक और पहाड़ जितना ट्रेनिंग डेटा चाहिए।
सिग्नल-टू-नॉइज़ समस्या डिक्टेशन की समस्या जैसी नहीं है
यहां वह वैचारिक गलती है जो हममें से ज़्यादातर लोग पहली बार इन डिवाइसों के बारे में सुनते समय करते हैं: हम मान लेते हैं कि यह हवा निकालकर स्पीच रिकग्निशन है। ऐसा नहीं है। ऑडियो डिक्टेशन उस सिग्नल पर चलता है जिसे प्रकृति ने संचार के लिए बनाया है, साफ़ दबाव तरंग के दसियों डेसिबल, जो विकास के दौरान फ़ोनीम को कमरे भर तक ले जाने के लिए आकार पाई। ASR के कठिन हिस्से हैं उच्चारण, शब्दावली और शोर को छानना। सिग्नल खुद उदार है।
साइलेंट स्पीच सेंसिंग का प्रोफ़ाइल ठीक उल्टा है। कैरियर, चाहे EMG के माइक्रोवोल्ट हों या RF का हल्का मॉड्यूलेशन, कभी भाषा एन्कोड करने के लिए बना ही नहीं था। फ़ोनीम की जानकारी सेंसर चैनलों पर बिना साफ़ मैपिंग के फैली होती है, और भ्रम ध्वनिक नहीं बल्कि शारीरिक होते हैं। निगलना, जबड़ा भींचना, सिर घुमाना, चेहरे को छूना: हर एक ऐसा क्षणिक झटका पैदा करता है जो आर्टिक्युलेशन सिग्नल को बौना कर दे। जहां ASR शोरगुल वाले कमरे से लड़ता है, वहीं साइलेंट स्पीच सिस्टम अपने ही शरीर से लड़ता है। आप खुद नॉइज़ फ़्लोर हैं।
इससे दो नतीजे निकलते हैं। पहला, ये सिस्टम डिक्टेशन की तुलना में भाषा मॉडलिंग पर कहीं ज़्यादा निर्भर होते हैं। जब किसी फ़ोनीम का सेंसर सबूत अस्पष्ट होता है, तो डिकोडर इस अंदाज़े से उसे सुलझाता है कि आपका शायद क्या मतलब था, वही तरकीब जो constrained decoding को धुंधले मॉडल आउटपुट को भरोसेमंद फ़ैसलों में बदलने में इतना असरदार बनाती है। उम्मीद कीजिए कि साइलेंट स्पीच सिस्टम अनुमानित टेक्स्ट पर अजीब तरह से अच्छे होंगे (कमांड, आपके अपने लहजे में लिखे ईमेल), और दुर्लभ शब्दों, नामों और कोड पहचानकर्ताओं पर उल्लेखनीय रूप से कमज़ोर, जहां अंदाज़ा कमज़ोर सिग्नल को नहीं बचा सकता। दूसरा, कैलिब्रेशन ढांचागत है, संयोग नहीं। ऑडियो ASR दशकों पहले वक्ताओं के पार सामान्यीकृत हो गया, क्योंकि वेवफ़ॉर्म एक वेवफ़ॉर्म है। चेहरे का RF हस्ताक्षर वैसा नहीं है, और यही हमें इस फ़ील्ड की सबसे कठिन समस्या तक लाता है।
हर चेहरा एक अलग एंटीना समस्या है
यूज़र के पार सामान्यीकरण वह जगह है जहां साइलेंट स्पीच प्रोटोटाइप दम तोड़ते हैं। चेहरे की शारीरिक बनावट, जबड़े की लंबाई, जीभ का आकार, ऊतक का घनत्व, त्वचा की मोटाई, बहुत अलग-अलग होती है, और इनमें से हर चर सिग्नल को नए सिरे से आकार देता है। मेरे चेहरे पर ट्रेन किया गया मॉडल आपके चेहरे पर लगभग बेकार हो सकता है। शुरुआती EMG साहित्य ऐसे सिस्टमों से भरा है जो “प्रति सब्जेक्ट, कैलिब्रेशन के बाद” बढ़िया सटीकता बताते हैं, और यह योग्यता चुपचाप प्रोडक्ट को दफ़न कर देती है। जो डिवाइस काम करने से पहले हर यूज़र के लिए एक घंटे की ट्रेनिंग मांगे, वह रिसर्च डेमो है, पेरिफ़ेरल नहीं।
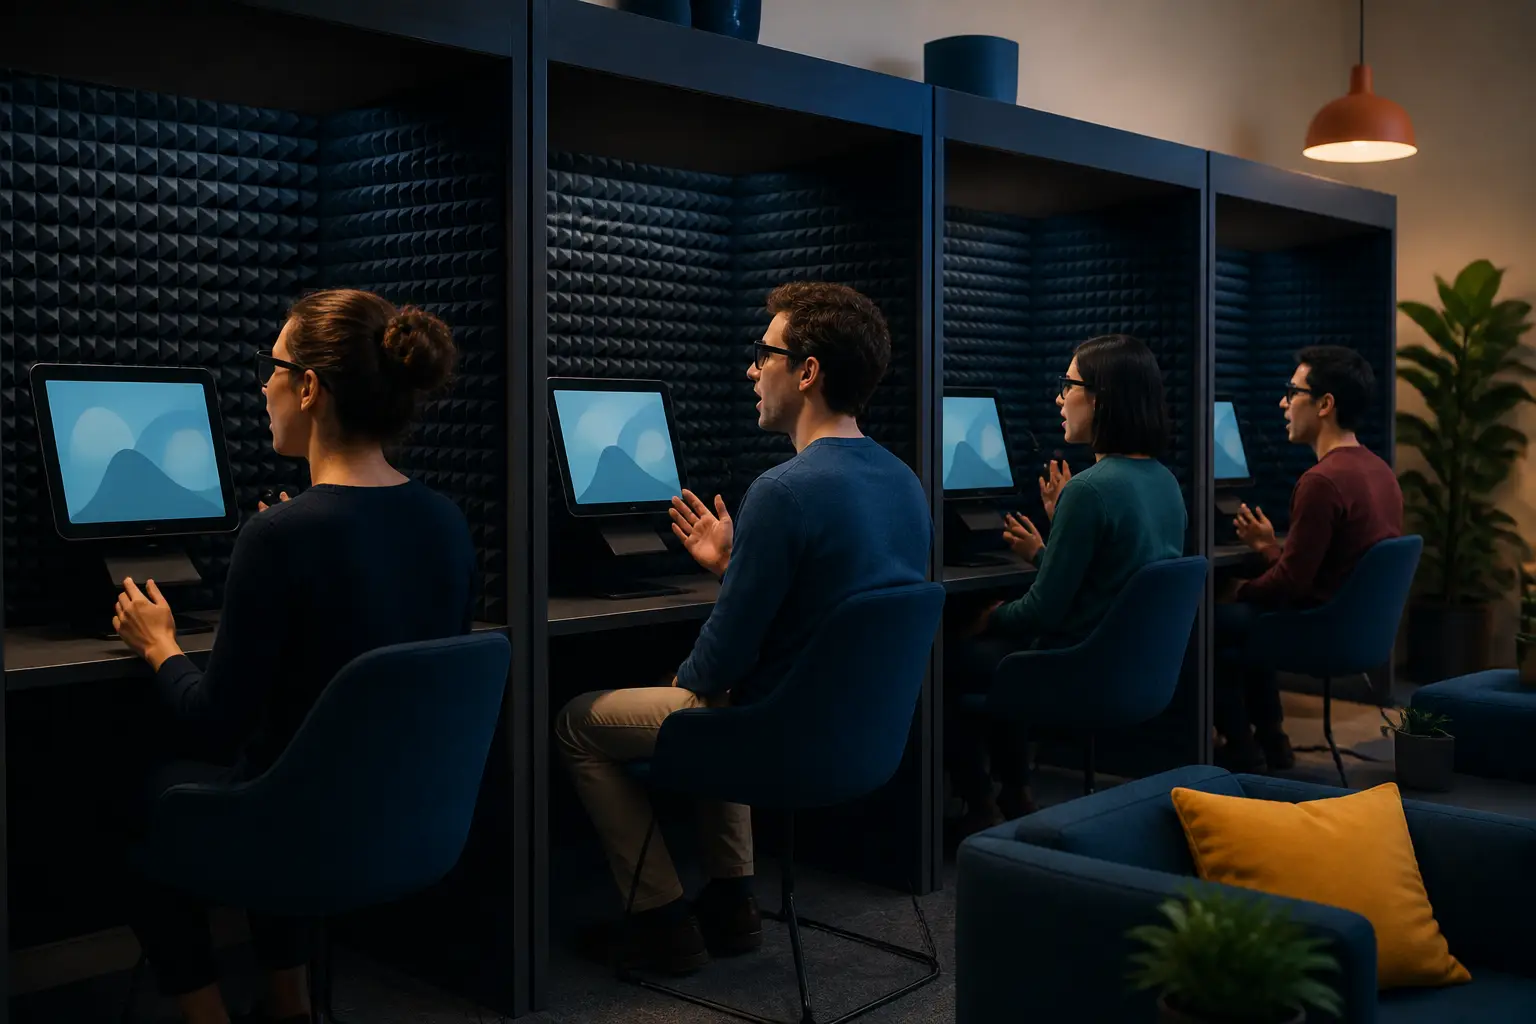
मुझे मौजूदा RF प्रयास में जो सचमुच दिलचस्प लगता है, वह यह है कि उन्होंने पहले चतुर रास्ता आज़माया, एल्गोरिदमिक डोमेन एडेप्टेशन और सिग्नल नॉर्मलाइज़ेशन की तरकीबें, और निष्कर्ष निकाला कि जो लीवर काम करता है वह सिर्फ़ ब्रूट-फ़ोर्स प्री-ट्रेनिंग स्केल है। इसलिए उन्होंने अपने ऑफ़िस में रिकॉर्डिंग बूथ बनाए, लोगों को पैसे देकर ग्लास पहनकर प्रॉम्प्ट पढ़ने को कहा, और डेटासेट बढ़ने के साथ एरर रेट एक साफ़ स्केलिंग कर्व पर गिरते देखे। रिपोर्ट किया गया नतीजा: नए यूज़र को सिस्टम अच्छी तरह काम करने से पहले सिर्फ़ लगभग बीस कैलिब्रेशन वाक्य चाहिए। यह संख्या किसी भी सटीकता आंकड़े से ज़्यादा मायने रखती है। बीस वाक्य सहनीय ऑनबोर्डिंग फ़्लो है; एक घंटे की रीडिंग रिफ़ंड की मांग है।
यही सबक मशीन लर्निंग का बाकी हिस्सा बार-बार दोहराता है: जब मॉडल सामान्यीकरण नहीं कर पाता, तो आम तौर पर जवाब बेहतर आर्किटेक्चर नहीं, बल्कि ज़्यादा विविध डेटा होता है। हमने यही स्पीच रिकग्निशन में, कम-संसाधन भाषाओं की मशीन ट्रांसलेशन में, और हर उस डोमेन में होते देखा है जहां इनपुट वितरण हर यूज़र के साथ बदलता है। साइलेंट स्पीच में प्रति-यूज़र बदलाव खास तौर पर खतरनाक है, क्योंकि उसका “माइक्रोफ़ोन” आंशिक रूप से खुद यूज़र से बना है।
साइलेंट स्पीच असल में कहां जीतता है
नवीनता हटा दें तो इस्तेमाल के मामले एक साफ़ क्रम में आ जाते हैं। सबसे ऊपर है एक्सेसिबिलिटी। ऐसे डेवलपर्स जिन्हें रिपीटेटिव स्ट्रेन इंजरी है और जिन्हें डबल कार्पल टनल सर्जरी की ज़रूरत है, या जो खुले ऑफ़िस में लौट रहे हैं जहां डिक्टेशन सामाजिक रूप से असंभव है, उनके लिए यह गैजेट नहीं, काम कर पाने और न कर पाने के बीच का फ़र्क है। लैरिंजेक्टॉमी के मरीज़ और ALS से मिलते-जुलते बोलने की क्षमता खोने वाले लोग उसी कहानी का गहरा और ज़्यादा ज़रूरी रूप हैं। किसी भी ईमानदार मूल्यांकन में इस तकनीक को इसी पर भारी वज़न देना चाहिए।
दूसरा: शोरगुल वाले माहौल, जो उम्मीद के उलट लगता है। ऐसी सेंसिंग विधि जो ध्वनिकी को पूरी तरह नज़रअंदाज़ करती है, उसे आपकी लॉनमॉवर, सर्वर रूम या फ़ैक्ट्री फ़्लोर की परवाह नहीं। आवाज़ वहीं फ़ेल होती है जहां RF सेंसिंग बेपरवाह होती है। तीसरा: विवेक, यानी लाइब्रेरी, खुले ऑफ़िस और ट्रेनों में डिक्टेशन। यही मुख्यधारा का कंज़्यूमर पिच है, और यह असली है, पर मैं मानता हूं कि तीनों में यह सबसे कमज़ोर है, क्योंकि यह क्षमता का नहीं, सामाजिक सुविधा का फ़ीचर है।
ट्रेड-ऑफ़ पर मेरी राय: यह तकनीक अपने फ़ॉर्म फ़ैक्टर को तभी सही ठहराती है जब इन्फ़रेंस ऑन-डिवाइस हो, या कम से कम ऑफ़लाइन चल सके। एक सेंसर जो आपकी बंद मुंह के अंदर जीभ की हरकत देखता है और कच्चा डेटा क्लाउड API पर भेजता है, वह ऐसी गोपनीयता व्यवस्था है जिसे किसी को स्वीकार नहीं करना चाहिए। जो टिप्पणीकार अनैच्छिक सिग्नल लीक होने को लेकर चिंतित हैं, उनकी शिकायत वैध है, भले ही कुछ ज़्यादा अटकलबाज़ डर बढ़ा-चढ़ाकर कहे गए हों। अच्छी खबर यह है कि डिकोडिंग मॉडल स्थानीय रूप से चलाने लायक छोटे हैं, और इस फ़ील्ड को offline-first डिज़ाइन को प्रीमियम टियर नहीं, बल्कि बुनियादी शर्त मानना चाहिए। वेक-वर्ड जैसी व्यवस्था भी ज़रूरी है: ग्लास को सुनना शुरू करने से पहले एक जानबूझकर, भौतिक इरादे का संकेत चाहिए (कोई इशारा, या जबड़ा भींचने का पैटर्न), वरना आपने ऐसा वियरेबल बना दिया है जो आपकी हर अनैच्छिक मुंह की हरकत को ट्रांसक्राइब करता है।
यहां एक पुरानी गूंज है जिसे मैं छोड़ नहीं सकता। 1870 के दशक में टेलीग्राफ़ ऑपरेटर रिले की क्लिक सुनकर संदेश पढ़ना सीखते थे, एक ऐसा इनपुट चैनल जिसे किसी ने डिज़ाइन नहीं किया था। इंटरफ़ेस के इतिहास में ऐसे साइड चैनल भरे पड़े हैं, जो किसी के डिकोडर बनाते ही पहली श्रेणी के चैनल बन जाते हैं। सबवोकल मांसपेशी की फुसफुसाहट पढ़ने और सोचने का ऐसा साइड चैनल है जिसे इंसान तब से लीक करता आ रहा है जब से उसके भीतर आंतरिक संवाद है। इसे इनपुट डिवाइस बनाना आविष्कार से ज़्यादा पदोन्नति है, और अगर स्केलिंग कर्व टिके रहे, तो शायद लाइब्रेरी का सबसे शांत व्यक्ति ही सबसे ज़्यादा टाइपिंग कर रहा होगा।