Habla silenciosa: por qué RF superó a los electrodos
Las interfaces de habla silenciosa decodifican palabras articuladas con EMG y RF. Sensores, ruido y calibración las hacen muy distintas del dictado.
 James Whitfield
Estás en la biblioteca, con la app de dictado abierta, y acabas de articular el mismo correo cuatro veces en tu portátil como un loco, porque hablar en voz alta haría que toda la planta te mirara. Las interfaces de habla silenciosa existen justo para este momento: sistemas que decodifican las palabras que articulas, o incluso las que solo tienes intención de articular, sin que salga ni un solo sonido de tu cuerpo. Una nueva ola de startups apuesta a que el dispositivo de entrada que falta en la era de la IA no es un micrófono mejor. Es no tener micrófono.
La idea es más antigua de lo que sugieren las demos actuales. Investigadores de la NASA experimentaban con reconocimiento subvocal a mediados de los 2000, originalmente para astronautas y tripulaciones que trabajaban en entornos ruidosos o con trajes presurizados. El Media Lab del MIT la hizo famosa con AlterEgo en 2018, un auricular portátil que captaba señales neuromusculares de la mandíbula y la cara. Lo que ha cambiado recientemente no es el concepto, sino que el hardware de radio barato, el mejor aprendizaje automático y la repentina masificación de la IA de voz han convergido para que la ingeniería sea casi viable. Casi. El problema de la relación señal-ruido aquí es realmente brutal, y la forma en que los equipos lo resuelven determina todo sobre el producto que acaban lanzando.
Hablar sin sonido: qué es realmente la subvocalización
Vale la pena tener clara una terminología útil, porque el campo mezcla tres cosas distintas. Primero está la articulación sin voz: articulación completa con labios, lengua y mandíbula, pero sin voz. Segundo, el habla interna: labios cerrados, pero la lengua y el velo del paladar siguen moviéndose deliberadamente como si formaran palabras. Tercero, la auténtica subvocalización, la activación muscular tenue e involuntaria que ocurre cuando lees o piensas en palabras. Esta última es la versión de ciencia ficción, y es apenas detectable fuera del laboratorio. Los productos que funcionan hoy están en las dos primeras categorías. Un equipo que construye gafas con sensado RF describe su comportamiento objetivo como «articular con los labios cerrados», una extraña hibridación que los usuarios aparentemente aprenden en unas pocas sesiones.
Como friki de la lingüística, encuentro fascinante la lingüística aquí. La articulación es un programa motor que tu cerebro ejecuta tanto si las cuerdas vocales vibran como si no. La fonación es solo una etapa de la producción del habla: la parte en la que la laringe añade energía acústica. Quitarla deja intacta toda la coreografía previa: la posición de la lengua para las vocales, el redondeo de labios, el control del velo para las nasales. Una interfaz de habla silenciosa intenta, en esencia, reconstruir la secuencia de fonemas a partir de los restos de esa coreografía, como deducir una melodía observando los dedos de un pianista sobre un piano silenciado. Es lectura labial desde dentro.
Este enfoque importa porque indica qué deben medir los sensores. Nadie está leyendo tu mente. Todos los sistemas que funcionan se apoyan en alguna correlación física de la articulación (impulsos eléctricos, movimiento de tejidos o energía reflejada), y la elección de qué correlación perseguir es la decisión de ingeniería que define todo.
EMG: el sensor obvio que te traiciona
La electromiografía es por donde casi todos empiezan, porque la lógica es irresistible. Los músculos se activan porque las neuronas motoras liberan potenciales eléctricos a través de las membranas; pon un electrodo en la piel sobre el músculo correcto y podrás verlo. La EMG de superficie es una técnica madura: las prótesis de miembros llevan décadas controladas por señales de músculos residuales. Para un hackathon de fin de semana, puedes literalmente pegarte electrodos en la cara, conectarlos a un amplificador y obtener algo que parpadea en correspondencia aproximada con las letras articuladas. Se han construido varios prototipos de habla silenciosa exactamente así, incluido el ya famoso AlterEgo del MIT y, según se informa, el primer intento rudimentario del equipo que ahora lanza gafas RF.
Luego la realidad interviene, con una lista de fallos deprimentemente predecible:
- Sudor. La conductividad de la piel cambia cuando sudas, así que la misma palabra articulada se ve distinta a las 9 de la mañana que después de comer. Tu calibración se va degradando continuamente.
- Interferencias eléctricas. Las señales EMG faciales están en el rango de los microvoltios. Los cables de la red eléctrica cercana, la fuente conmutada de tu portátil e incluso el parpadeo pueden saturarlas.
- Variabilidad de colocación. Un desplazamiento de dos milímetros del electrodo cambia qué fibras musculares dominan la lectura. Quítate el dispositivo y vuelve a ponértelo, y el modelo de ayer estará midiendo a una persona ligeramente distinta.
- El obstáculo estético. Nadie se pondrá electrodos de gel en la cara en público. Suena trivial; aun así, acabó con el enfoque.
Ese último punto merece respeto. El hardware de consumo fracasa por fricción mucho más a menudo que por física. La historia de los wearables es un cementerio de dispositivos que funcionaban en el laboratorio y exigían un paso de más al usuario. Auriculares de conducción ósea, cinturones pectorales para la frecuencia cardíaca, diademas de EEG: todos técnicamente sólidos, todos de nicho. Cuando tu sensor requiere preparar la piel a diario, has construido un dispositivo médico, no un periférico de entrada.
RF: leer la boca desde dentro
El enfoque que hoy gana tracción sustituye los electrodos por radio. La idea: antenas integradas en las patillas de las gafas emiten ondas de radio de baja potencia, en frecuencias cercanas a Bluetooth, que atraviesan la cara. Cuando las ondas cruzan tejido en movimiento (lengua, labios, velo del paladar), se modulan de formas diminutas y estructuradas. Las antenas receptoras captan la señal perturbada y una red neuronal aprende a traducir esas perturbaciones a texto. Es la misma familia de física que el sensado de gestos por Wi-Fi y el radar que Google incluyó en el Pixel 4 para gestos con la mano, apuntado a un objetivo mucho más sutil.
Lo atractivo es que el RF ve lo que las cámaras y los electrodos de piel no pueden. La lengua es invisible desde fuera una vez cerrados los labios, pero es un músculo grande y rico en agua con el que las ondas de radio interactúan con fuerza. El habla interna con labios cerrados, el modo discreto que la gente realmente quiere en una reunión, solo es alcanzable con una modalidad que atraviesa el tejido como esta. Ese es todo el argumento de producto en una frase: la EMG y las cámaras capturan el exterior de la articulación; el RF capta el interior.
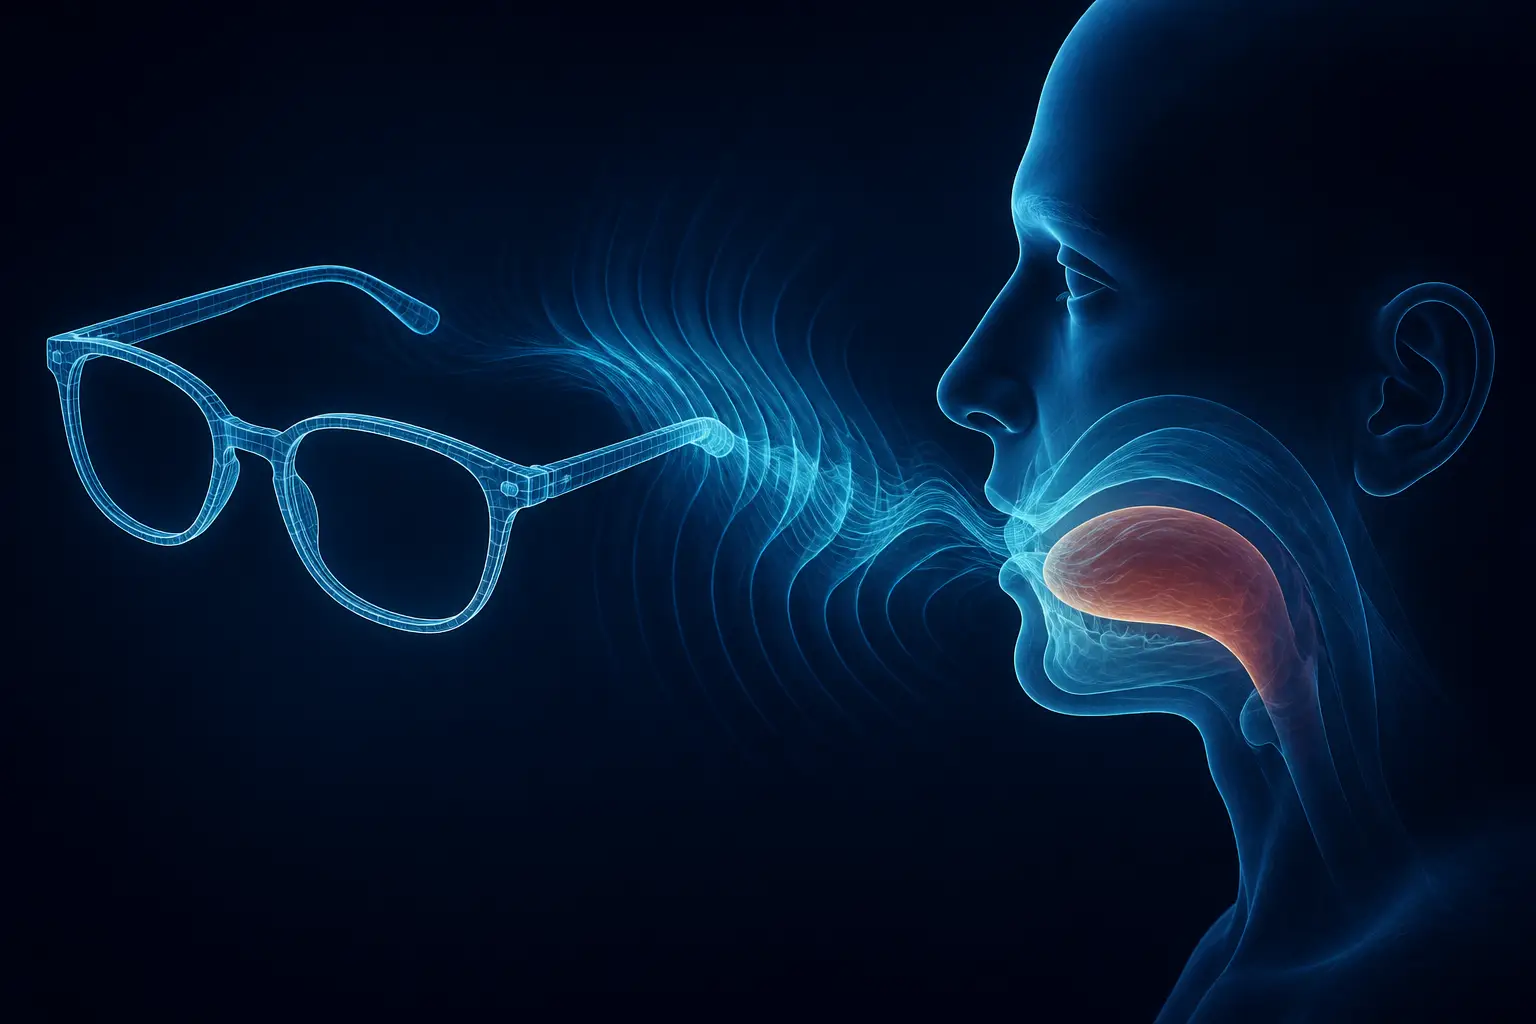
La ingeniería para llegar ahí no es sencilla. La señal que buscas es una modulación tenue sobre una portadora, así que toda la etapa de radiofrecuencia debe tener un ruido extraordinariamente bajo. La colocación de la antena es un problema de optimización con mucho filo: los campos electromagnéticos deben solaparse al máximo con los articuladores, lo que exige un diseño de montura muy basado en simulación, donde unos milímetros de posición de la antena cambian lo que el sistema puede oír. El equipo que construye el prototipo actual de gafas admite que su primer intento integrado en las gafas fracasó por completo, y volvieron a pegar antenas en la cara, luego a un soporte rígido para mantener constante la geometría, hasta que el trabajo de simulación consiguió que las monturas fueran correctas. Esa progresión (cinta adhesiva, soporte, producto) es la arqueología honesta del hardware que de verdad llega a fabricarse.
Cámaras y ultrasonido: los alternativos con nichos reales
La vía de la cámara, la lectura labial visual, es la que tiene el pedigrí investigador más profundo. LipNet demostró hace años la lectura labial de extremo a extremo a nivel de frase a partir de vídeo, y los proyectos de código abierto siguen replicando el truco con una webcam y un rastreador facial. Es el sensor más barato imaginable: ya tienes tres cámaras. Pero hereda la restricción brutal de que solo ve el exterior de tu cara. El habla interna con la boca cerrada es invisible por definición, la iluminación y el ángulo de la cabeza corrompen la entrada constantemente, y apuntar una cámara a tu propia cara todo el día tiene costes de privacidad y batería que nunca desaparecen. La lectura labial sigue siendo excelente como complemento del reconocimiento de voz: los modelos audiovisuales superan de verdad a los solo de audio en entornos ruidosos, pero como interfaz silenciosa independiente se queda limitada al extremo de «claramente articulando».
El ultrasonido ocupa un terreno intermedio más extraño. Sistemas académicos han apuntado transductores ultrasónicos a la mandíbula y han reconstruido el movimiento de la lengua a partir de ecos, y la ecografía de lengua es literalmente una herramienta estándar en la investigación fonética: es como llevamos décadas observando cómo se forman las vocales. La detección es buena. El factor de forma no. Nadie ha descubierto cómo empaquetar una sonda ultrasónica acoplada al mentón en algo que te pongas para una reunión de pie, y el acoplamiento acústico a través del aire es disipativo y sensible al ángulo. Mi opinión: el ultrasonido es la respuesta correcta para la logopedia clínica y los laboratorios de fonética, y la equivocada para la entrada de consumo.
Si llevas la cuenta, la tabla de compromisos se parece más o menos a esto:
- EMG: señal muscular directa, buen ancho de banda; arruinada por el sudor, la deriva, la colocación y la necesidad de llevar electrodos en la cara.
- Lectura labial con cámara: coste de hardware nulo, modelos maduros; ciega al habla con la boca cerrada, frágil ante la iluminación y hostil para la privacidad.
- Ultrasonido: obtiene una imagen directa de la lengua; el acoplamiento y el factor de forma lo convierten en un instrumento de laboratorio.
- RF a través de la cara: ve los articuladores internos a través de la piel, se integra en gafas; exige una pila de RF de bajo ruido poco habitual y montañas de datos de entrenamiento.
El problema de la relación señal-ruido no es el problema del dictado
Aquí está el error conceptual que cometemos la mayoría cuando oímos hablar de estos dispositivos: suponemos que es reconocimiento de voz menos el aire. No lo es. El dictado por audio se apoya en una señal que la naturaleza diseñó para comunicarse: decenas de decibelios de onda de presión limpia, moldeada por la evolución para transportar fonemas por una habitación. Las partes difíciles del ASR son los acentos, el vocabulario y el rechazo de ruido. La señal en sí es generosa.
El sensado de habla silenciosa tiene el perfil opuesto. La portadora (ya sean microvoltios de EMG o una modulación RF tenue) nunca estuvo pensada para codificar lenguaje. La información fonémica aparece difuminada entre los canales del sensor sin una correspondencia limpia, y las confusiones son fisiológicas, no acústicas. Tragar, apretar la mandíbula, girar la cabeza, tocarte la cara: cada una introduce un transitorio que puede eclipsar la señal de articulación. Donde un sistema ASR lucha contra una habitación ruidosa, un sistema de habla silenciosa lucha contra tu propio cuerpo. Tú eres el suelo de ruido.
De ello se derivan dos consecuencias. Primero, estos sistemas dependen mucho más del modelado del lenguaje que el dictado. Cuando la evidencia del sensor para un fonema es ambigua, el decodificador la resuelve con priors sobre lo que probablemente querías decir, el mismo truco que hace tan eficaz la decodificación restringida para convertir salidas difusas de modelos en decisiones fiables. Espera que los sistemas de habla silenciosa sean asombrosamente buenos con texto predecible (comandos, correos en tu propio registro) y notablemente peores con palabras raras, nombres e identificadores de código, donde el prior no puede rescatar una señal débil. Segundo, la calibración es estructural, no incidental. El ASR de audio se generalizó entre hablantes hace décadas porque una forma de onda es una forma de onda. Una firma RF facial no lo es, y eso nos lleva al problema más difícil del campo.
Cada cara es un problema de antena distinto
La generalización entre usuarios es donde los prototipos de habla silenciosa van a morir. La anatomía facial (longitud de la mandíbula, tamaño de la lengua, densidad de tejidos, grosor de la piel) varía enormemente, y cada una de esas variables remodela la señal. Un modelo entrenado con mi cara puede ser casi inútil con la tuya. La literatura temprana sobre EMG está llena de sistemas que reportan una precisión excelente «por sujeto, tras calibración», un matiz que entierra discretamente el producto. Un dispositivo que necesita una hora de entrenamiento por usuario antes de funcionar es una demo de investigación, no un periférico.
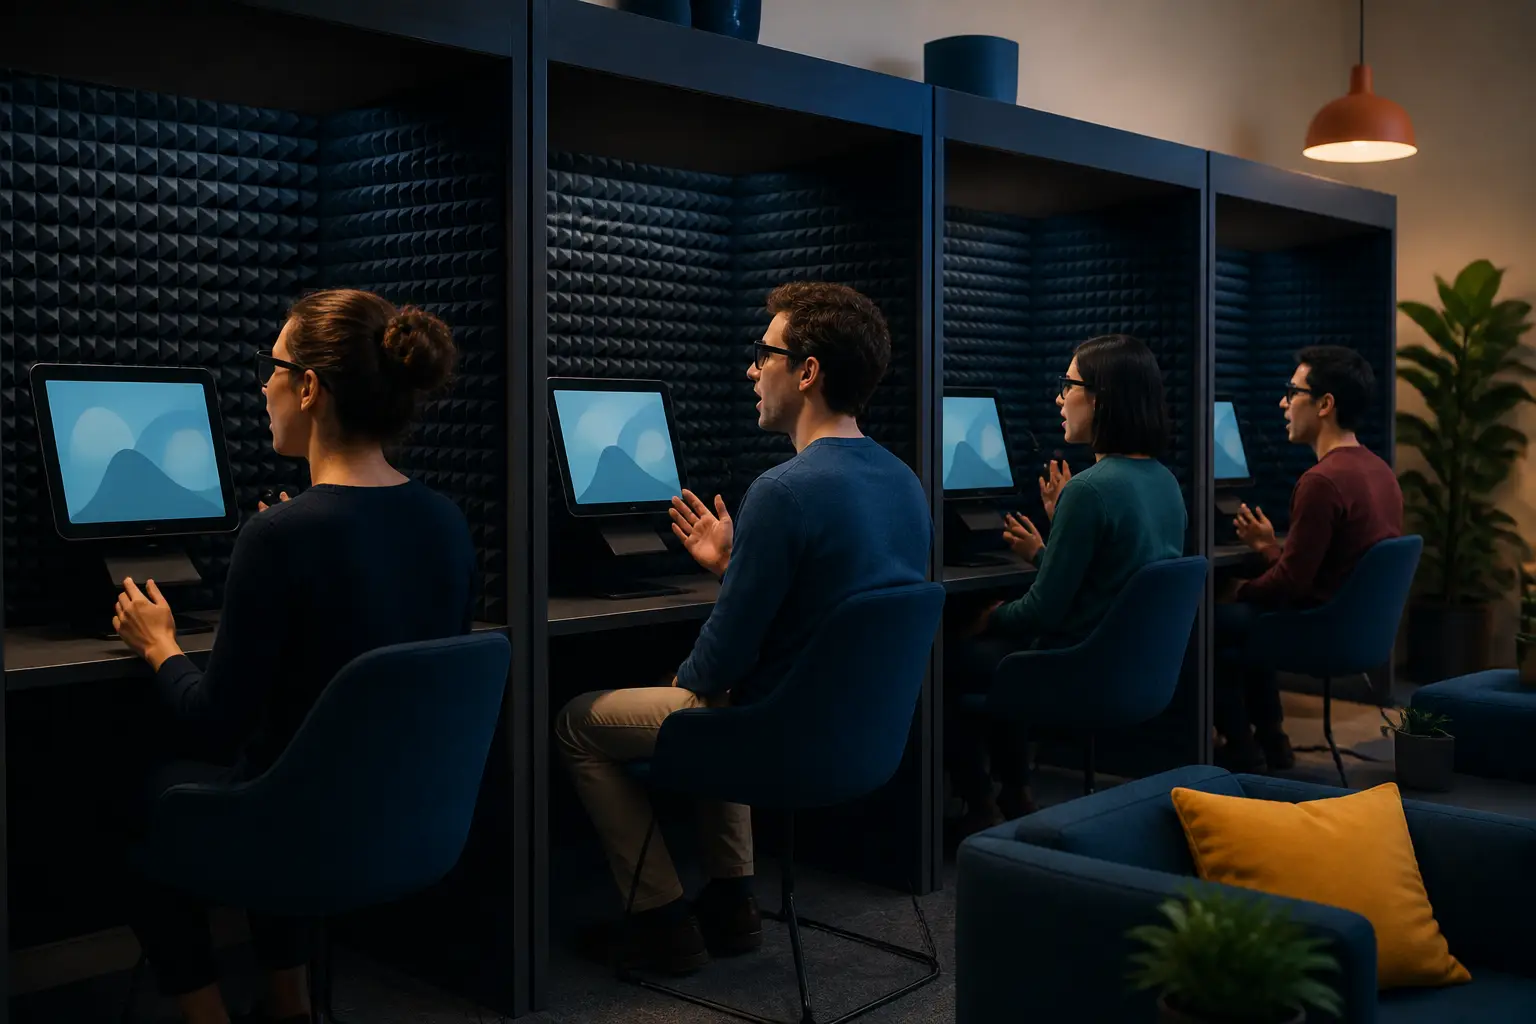
Lo que me parece genuinamente interesante del esfuerzo RF actual es que probaron primero el camino ingenioso (adaptación de dominio algorítmica, trucos de normalización de señal) y concluyeron que la única palanca que funciona es la escala de preentrenamiento bruto. Así que construyeron cabinas de grabación en su oficina, pagaron a personas para leer mensajes mientras llevaban las gafas y observaron cómo las tasas de error caían siguiendo una curva de escalado limpia a medida que crecía el conjunto de datos. El resultado comunicado: un usuario nuevo solo necesita unas veinte frases de calibración para que el sistema funcione bien. Ese número importa más que cualquier cifra de precisión. Veinte frases son un proceso de incorporación tolerable; una hora de lecturas es una solicitud de devolución.
Es la misma lección que el resto del aprendizaje automático nos sigue repitiendo: cuando un modelo no generaliza, la respuesta suele ser más datos diversos, no una arquitectura más ingeniosa. Lo hemos visto en el reconocimiento de voz, en la traducción automática para lenguas de bajos recursos y en cada dominio donde la distribución de entrada cambia según el usuario. El habla silenciosa tiene un cambio por usuario especialmente cruel, porque el «micrófono» está parcialmente hecho del propio usuario.
Dónde gana de verdad el habla silenciosa
Quitando la novedad, los casos de uso se ordenan en una jerarquía clara. Arriba del todo: la accesibilidad. Hay un perfil de comentaristas (desarrolladores con lesiones por esfuerzo repetitivo que enfrentan una cirugía de doble túnel carpiano, personas que vuelven a oficinas abiertas donde el dictado es socialmente imposible) para quienes esto no es un gadget, sino la diferencia entre trabajar y no poder hacerlo. Los pacientes laringectomizados y las personas con pérdida del habla asociada a ELA son la versión más profunda e importante de la misma historia. Cualquier evaluación honesta de esta tecnología debería pesar eso mucho.
Segundo: los entornos ruidosos, que es el punto contraintuitivo. Una modalidad de sensado que ignora por completo la acústica no se preocupa por tu cortacésped, tu sala de servidores ni tu planta de fábrica. La voz falla justo donde el sensado RF es indiferente. Tercero: la discreción, dictar en bibliotecas, oficinas abiertas, trenes. Este es el argumento de consumo masivo, y es real, pero reconozco que es el más débil de los tres, porque es una comodidad social más que un desbloqueo de capacidades.
Mi postura sobre los compromisos: esta tecnología solo justifica su factor de forma si la inferencia es en el dispositivo o, al menos, puede funcionar sin conexión. Un sensor que observa cómo se mueve tu lengua dentro de la boca cerrada, transmitiendo datos brutos a una API en la nube, es una arquitectura de privacidad que nadie debería aceptar; quienes se preocupan por la filtración de señales involuntarias tienen un agravio legítimo, aunque algunos de los temores más especulativos estén exagerados. La buena noticia es que los modelos de decodificación son lo bastante pequeños para ejecutarse localmente; el sector haría bien en tratar el diseño offline-first como requisito básico y no como un nivel premium. Las señales de activación también importan: las gafas necesitan una señal de intención física deliberada (un gesto, un patrón de apretar la mandíbula) antes de escuchar, o habrás construido un wearable que transcribe cada movimiento involuntario de tu boca.
Aquí no puedo resistirme a un eco antiguo. Los telegrafistas de la década de 1870 aprendieron a leer mensajes por el sonido del relé al hacer clic, un canal de entrada que nadie diseñó. La historia de las interfaces está llena de estos canales laterales que se convierten en canales de primera clase en cuanto alguien construye el decodificador. El murmullo muscular subvocal es un canal lateral de la lectura y el pensamiento que los humanos han filtrado desde que tenemos monólogos interiores. Convertirlo en un dispositivo de entrada es menos una invención que un ascenso, y si las curvas de escalado se mantienen, la persona más silenciosa de la biblioteca quizá sea pronto la que más escriba.