Интерфейсы беззвучной речи: почему RF победил электроды
Интерфейсы беззвучной речи распознают слова по сигналам мышц и радиоволн. Почему сенсоры и проблема сигнал-шум отличают их от диктовки.
 James Whitfield
Вы в библиотеке, диктовка запущена, и вы уже четвертый раз беззвучно проговариваете в ноутбук одно и то же письмо, как сумасшедший, потому что вслух говорить — значит поймать косые взгляды всего зала. Интерфейсы беззвучной речи появились именно для таких ситуаций: это системы, которые расшифровывают слова, произнесенные губами, или даже просто намеренно артикулируемые, без единого звука. Новая волна стартапов ставит на то, что недостающее устройство ввода для эпохи ИИ — это не микрофон получше, а вообще его отсутствие.
Идея старше, чем подсказывают нынешние демо. Исследователи NASA экспериментировали с субвокальным распознаванием в середине нулевых, изначально для астронавтов и экипажей, работающих в шумной обстановке или в скафандрах под давлением. Медиалаборатория MIT прославила эту тему в 2018 году с AlterEgo, носимой гарнитурой, которая снимала нервно-мышечные сигналы с челюсти и лица. Что изменилось недавно, так это не сама концепция, а то, что дешевое радиооборудование, более совершенное машинное обучение и массовое внедрение голосового ИИ сошлись вместе и сделали инженерную задачу почти решаемой. Почти. Проблема сигнал-шум здесь по-настоящему жестокая, и то, как команды ее решают, определяет всё, что в итоге попадет к пользователю.
Речь без звука: что такое субвокализация на самом деле
Стоит правильно разобраться в терминологии, потому что в этой области смешивают три разные вещи. Во-первых, есть артикуляция без голоса: полноценное движение губ, языка и челюсти, только без голоса. Во-вторых, есть внутренняя речь: губы сомкнуты, но язык и мягкое небо все равно сознательно двигаются, как будто формируют слова. В-третьих, есть собственно субвокализация, едва заметная непроизвольная активация мышц, которая возникает, когда вы читаете или думаете словами. Последняя — это версия из фантастики, и вне лаборатории ее почти невозможно уловить. Работающие сегодня продукты живут в первых двух категориях. Одна команда, создающая RF-очки, описывает целевое поведение как «артикуляция с закрытыми губами», странный гибрид, к которому пользователи, судя по всему, привыкают за несколько сессий.
Как человек, влюбленный в языки, я нахожу лингвистику здесь восхитительной. Артикуляция — это моторная программа, которую мозг запускает независимо от того, вибрируют ли голосовые связки. Озвончение — лишь один этап речевого производства, та часть, где гортань добавляет акустическую энергию. Уберите ее, и вся предшествующая хореография никуда не денется: положение языка для гласных, округление губ, управление velum для носовых. Задача беззвучного интерфейса по сути в том, чтобы восстановить последовательность фонем по остаточным следам этой хореографии, примерно как угадать мелодию, наблюдая за пальцами пианиста на беззвучном пианино. Это чтение по губам, но изнутри.
Эта рамка важна, потому что она подсказывает, что именно должны измерять сенсоры. Никто не читает ваши мысли. Каждая работающая система опирается на какой-то физический коррелят артикуляции: электрические импульсы, движение тканей или отраженную энергию. А выбор того, какой коррелят преследовать, и есть ключевое инженерное решение.
ЭМГ: очевидный сенсор, который вас подводит
Электромиография — это то, с чего начинают почти все, потому что логика неотразима. Мышцы сокращаются, когда мотонейроны выбрасывают электрические потенциалы через мембраны; приклейте электрод к коже над нужной мышцей, и вы можете наблюдать это напрямую. Поверхностная ЭМГ — зрелая техника: протезы конечностей управляются по остаточным мышечным сигналам уже десятилетиями. Для выходного дня на хакатоне можно буквально прилепить электроды к лицу, подключить их к усилителю и получить нечто, что мерцает в грубом соответствии с беззвучно проговоренными буквами. Несколько прототипов беззвучной речи построили именно так, включая знаменитый AlterEgo из MIT и, по слухам, первую грубую попытку команды, которая сейчас выпускает RF-очки.
Дальше вмешивается реальность, и список провалов предсказуемо удручающий:
- Пот. Проводимость кожи меняется по мере потоотделения, поэтому одно и то же беззвучное слово выглядит по-разному в 9 утра и после обеда. Калибровка устаревает прямо под вами.
- Электрические помехи. Сигналы ЭМГ лица находятся в диапазоне микровольт. Соседние силовые линии, импульсный блок питания ноутбука и даже моргание способны их заглушить.
- Вариативность установки. Смещение электрода на два миллиметра меняет, какие мышечные волокна доминируют в показаниях. Снимите устройство и наденьте снова, и вчерашняя модель будет измерять немного другого человека.
- Косметический стоп-фактор. Никто не станет ходить на людях с гелевыми электродами на лице. Это звучит мелочью, но подход всё равно убило.
Последний пункт заслуживает уважения. Потребительское железо проваливается из-за трения гораздо чаще, чем из-за физики. История носимых устройств — кладбище гаджетов, которые работали в лаборатории и требовали от пользователя на один шаг больше, чем он готов сделать. Костная проводимость в гарнитурах, нагрудные ремни пульсометров, ЭЭГ-повязки: все технически грамотно, и все остаются нишевыми. Если ваш сенсор требует ежедневной подготовки кожи, вы сделали медицинское устройство, а не периферию ввода.
RF-сенсинг: чтение рта изнутри
Подход, который сейчас набирает обороты, заменяет электроды радио. Идея такая: антенны, встроенные в оправу очков, излучают маломощные радиоволны на частотах, близких к Bluetooth, и эти волны проходят сквозь лицо. Пересекая движущиеся ткани, язык, губы, мягкое небо, волны модулируются крошечными, структурированными способами. Приемные антенны фиксируют искаженный сигнал, а нейросеть учится переводить эти искажения обратно в текст. Физика та же, что у жестового сенсинга на основе Wi-Fi и радара, который Google поставил в Pixel 4 для распознавания жестов рук, только цель гораздо тоньше.
Привлекательность RF в том, что он «видит» то, чего не видят камеры и электроды на коже. Язык незаметен снаружи, когда губы сомкнуты, но это большая, богатая водой мышца, с которой радиоволны активно взаимодействуют. Внутренняя речь с закрытыми губами, тот самый незаметный режим, которым люди реально хотят пользоваться на совещании, доступна только через сквозной для тканей канал вроде этого. Вот вся аргументация продукта в одном предложении: ЭМГ и камеры фиксируют внешнюю сторону артикуляции, а RF фиксирует внутреннюю.
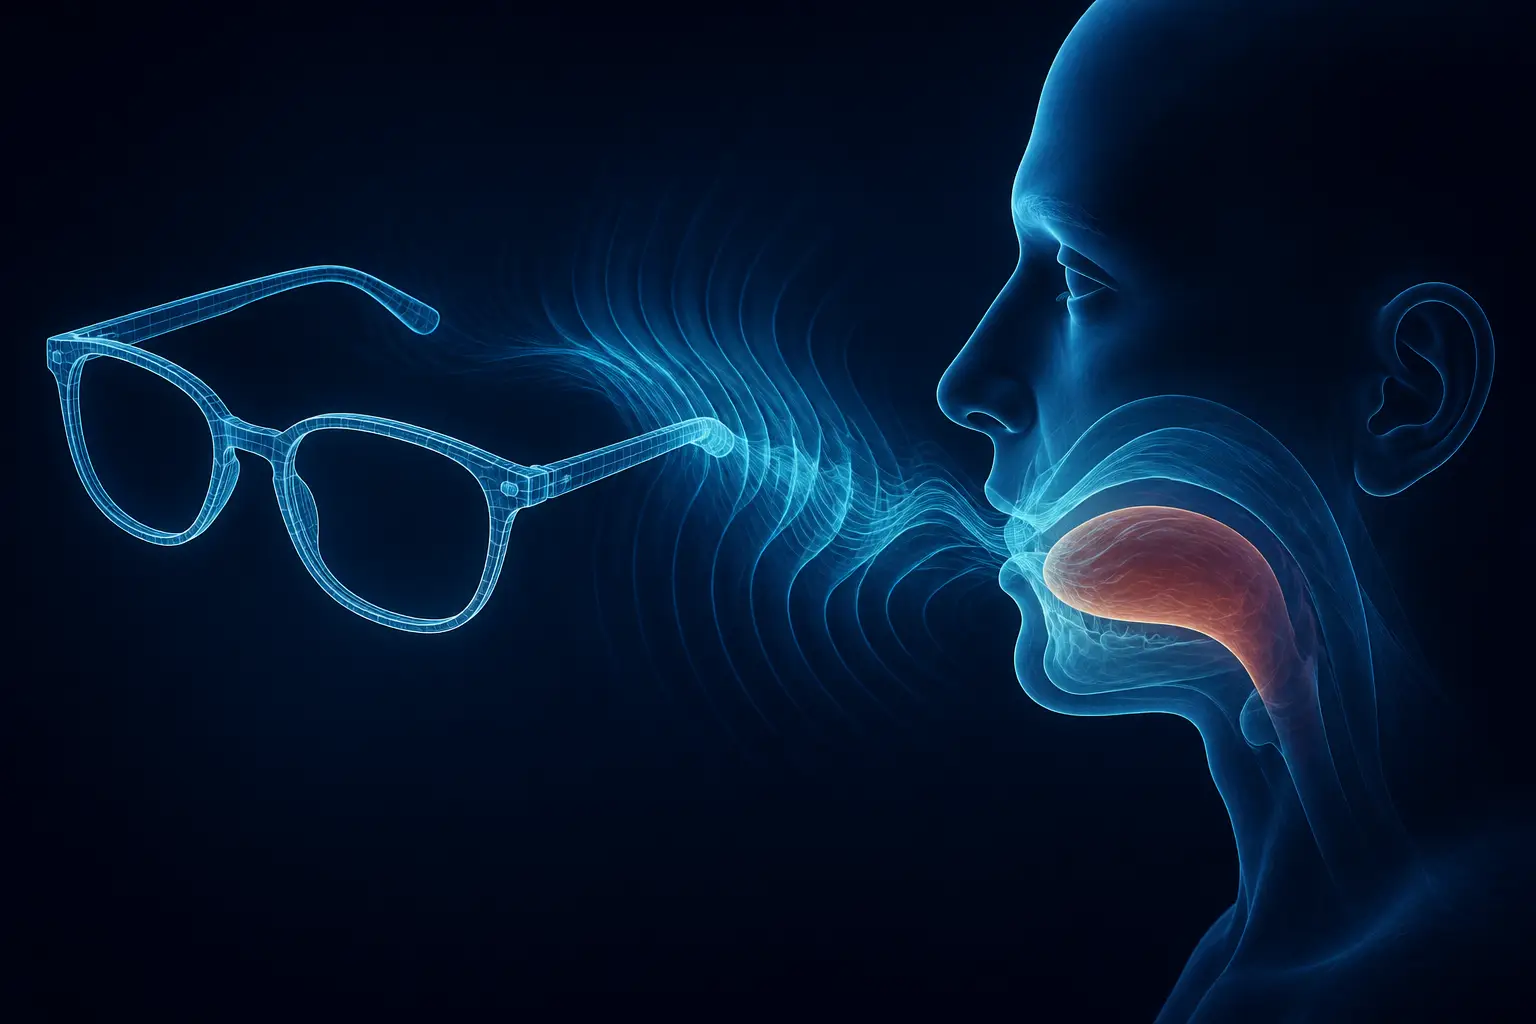
Инженерия, которая ведет к этому, не простая. Сигнал, который вам нужен, — это слабая модуляция поверх несущей, поэтому весь RF-тракт должен быть исключительно малошумным. Расположение антенн — задача оптимизации с острыми зубами: электромагнитные поля должны максимально перекрываться с артикуляторами, а значит, конструкция оправы держится на симуляциях, где миллиметры положения антенны меняют то, что система способна «услышать». Команда, создающая текущий прототип очков, признает, что их первая попытка с интеграцией в очки полностью провалилась; они откатились к антеннам, приклеенным к лицу, затем к жесткому головному креплению, чтобы зафиксировать геометрию, и только потом симуляции помогли довести оправу. Эта последовательность — скотч, стенд, продукт — честная археология железа, которое действительно выходит на рынок.
Камеры и ультразвук: второстепенные варианты с настоящими нишами
Путь с камерой, то есть визуальное чтение по губам, имеет самую глубокую исследовательскую родословную. LipNet еще несколько лет назад продемонстрировал сквозное распознавание предложений по видео, а открытые проекты продолжают воспроизводить этот трюк с помощью веб-камеры и трекера лица. Это самый дешевый сенсор из возможных: три камеры у вас уже есть. Но он наследует жесткое ограничение: видит только внешнюю сторону лица. Внутренняя речь с закрытым ртом по определению невидима, освещение и угол головы постоянно портят входные данные, а целый день направленная на собственное лицо камера несет расходы на приватность и батарею, которые никуда не денутся. Чтение по губам остается отличным дополнением к распознаванию звучащей речи, ведь аудиовизуальные модели действительно обходят чисто аудио в шуме, но как самостоятельный беззвучный интерфейс оно упирается в край спектра «явно шевелю губами».
Ультразвук занимает более странное промежуточное место. Академические системы направляли ультразвуковые датчики на челюсть и восстанавливали движение языка по эхо, а ультразвуковая визуализация языка — стандартный инструмент фонетических исследований, именно так мы десятилетиями наблюдаем за формированием гласных. Сенсинг хороший. Форм-фактор — нет. Никто не придумал, как упаковать ультразвуковой зонд, прижатый к подбородку, во что-то, что вы надели бы на утреннюю планерку, а акустическая связь через воздух теряет энергию и чувствительна к углу. По моему мнению, ультразвук — правильный ответ для клинической логопедии и фонетических лабораторий и неправильный для потребительского ввода.
Если вести счет, таблица компромиссов выглядит примерно так:
- ЭМГ: прямой мышечный сигнал, хорошая полоса — но всё портят пот, дрейф, установка и необходимость клеить электроды на лицо.
- Чтение по губам с камеры: нулевая стоимость железа, зрелые модели — слепо к речи с закрытым ртом, хрупко к освещению, враждебно к приватности.
- Ультразвук: напрямую визуализирует язык — связь и форм-фактор делают его лабораторным прибором.
- RF-сенсинг сквозь лицо: видит внутренние артикуляторы через кожу, встраивается в очки — требует экзотического малошумного RF-стека и горы обучающих данных.
Проблема сигнал-шум — не та же задача, что диктовка
Вот концептуальная ошибка, которую большинство из нас допускает, когда впервые слышит об этих устройствах: мы считаем, что это распознавание речи за вычетом воздуха. Это не так. Аудиодиктовка опирается на сигнал, который природа спроектировала для общения: десятки децибел чистой волны давления, сформированной эволюцией так, чтобы переносить фонемы через комнату. Трудные части ASR — акценты, словарь и подавление шума. Сам сигнал щедр.
У беззвучного сенсинга противоположный профиль. Несущая, будь то микровольты ЭМГ или слабая RF-модуляция, никогда не предназначалась для кодирования языка. Информация о фонемах размазана по каналам сенсора без чистого соответствия, а помехи физиологические, а не акустические. Глотание, сжатие челюсти, поворот головы, прикосновение к лицу: каждое из этих действий вносит переходный процесс, который может превзойти сигнал артикуляции. Там, где ASR борется с шумной комнатой, беззвучная система борется с вашим собственным телом. Вы и есть шумовой фон.
Из этого следуют два последствия. Во-первых, такие системы гораздо сильнее опираются на языковое моделирование, чем диктовка. Когда доказательства с сенсора для фонемы неоднозначны, декодер разрешает неопределенность априорными представлениями о том, что вы, скорее всего, хотели сказать, — тем же приемом, который делает constrained decoding таким эффективным при превращении размытых выходов модели в надежные решения. Ожидайте, что беззвучные системы будут на удивление хороши на предсказуемом тексте (командах, письмах в вашей собственной манере) и заметно хуже на редких словах, именах и идентификаторах в коде, где априорная информация не спасет слабый сигнал. Во-вторых, калибровка — структурная, а не случайная особенность. Аудио-ASR обобщился на разных говорящих еще десятилетия назад, потому что звуковая волна остается звуковой волной. Лицевая RF-сигнатура — нет, и это подводит нас к самой трудной проблеме в этой области.
У каждого лица своя задача для антенны
Обобщение между пользователями — место, где прототипы беззвучной речи умирают. Анатомия лица — длина челюсти, размер языка, плотность тканей, толщина кожи — варьируется очень сильно, и каждая из этих переменных перестраивает сигнал. Модель, обученная на моем лице, может оказаться почти бесполезной на вашем. В ранней литературе по ЭМГ полно систем, демонстрирующих отличную точность «для каждого испытуемого после калибровки», и эта оговорка незаметно хоронит продукт. Устройство, которому нужен часовой персональный тренинг, прежде чем начать работать, — это исследовательская демка, а не периферия.
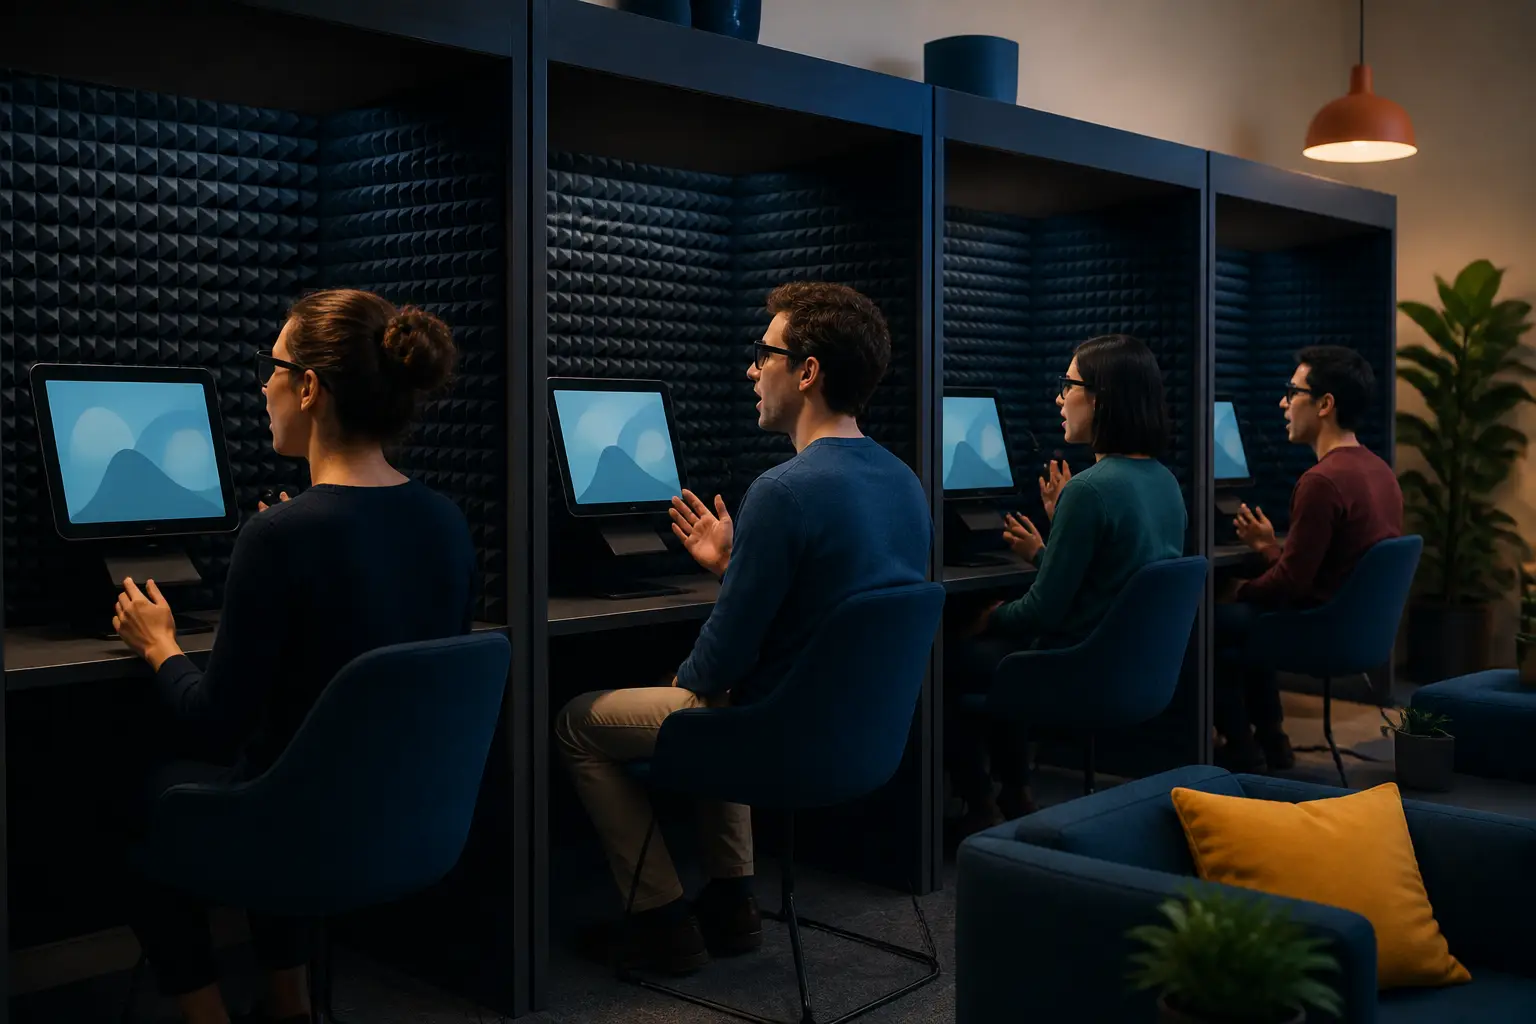
Меня по-настоящему интересует то, что команда, работающая над RF, сначала попробовала умный путь: алгоритмическую доменную адаптацию и трюки с нормализацией сигнала, а затем пришла к выводу, что работает только грубый рычаг — масштаб предобучения. Поэтому они построили записывающие кабинки в своем офисе, платили людям за чтение текстов в очках и наблюдали, как частота ошибок падает по четкой кривой масштабирования по мере роста датасета. Заявленный результат: новому пользователю нужно всего около двадцати калибровочных предложений, чтобы система заработала хорошо. Эта цифра важнее любой заявленной точности. Двадцать предложений — приемлемый онбординг; час считываний — запрос на возврат.
Это тот же урок, который машинное обучение продолжает преподавать снова и снова: когда модель не обобщается, ответ обычно в более разнообразных данных, а не в более хитрой архитектуре. Мы наблюдали это в распознавании речи, в машинном переводе для языков с малыми ресурсами и в каждой области, где входное распределение сдвигается от пользователя к пользователю. У беззвучной речи просто особенно коварный сдвиг, потому что «микрофон» частично состоит из самого пользователя.
Где беззвучная речь действительно выигрывает
Если убрать новизну, сценарии использования выстраиваются в четкую иерархию. На вершине — доступность. Есть целая аудитория разработчиков с синдромом повторяющихся нагрузок, которым предстоит операция по поводу двустороннего синдрома запястного канала, и людей, возвращающихся в открытые офисы, где диктовка социально невозможна. Для них это не гаджет, а разница между работой и отсутствием работы. Пациенты после ларингэктомии и люди с потерей речи, связанной с БАС, — более глубокая и важная версия той же истории. Любая честная оценка этой технологии должна это учитывать.
Второе — шумная среда, и это контринтуитивный пункт. Модальность, которая полностью игнорирует акустику, не замечает ни вашу газонокосилку, ни серверную, ни заводской цех. Голос подводит именно там, где RF-сенсингу все равно. Третье — деликатность: диктовка в библиотеках, открытых офисах, поездах. Это основной потребительский аргумент, и он реален, но я отмечу, что он самый слабый из трех, потому что это функция социального комфорта, а не разблокировка возможностей.
Моя позиция по компромиссам такова: эта технология оправдывает свой форм-фактор, только если вывод работает на устройстве или хотя бы может работать офлайн. Сенсор, который следит за движением языка внутри закрытого рта и передает сырые данные в облачный API, — это архитектура приватности, которую никто не должен принимать. Обеспокоенные комментаторы, опасающиеся утечки непроизвольных сигналов, имеют законное основание для претензий, даже если некоторые более спекулятивные страхи преувеличены. Хорошая новость в том, что модели декодирования достаточно малы, чтобы работать локально; отрасли стоило бы воспринимать офлайн-первый дизайн как обязательную базу, а не премиальную опцию. Аналоги wake-word тоже важны: очкам нужен осознанный физический сигнал намерения (жест, особый паттерн сжатия челюсти), прежде чем они начнут слушать, иначе вы создадите носимое устройство, которое расшифровывает каждое ваше непроизвольное движение рта.
Здесь не могу удержаться от одной старой параллели. Телеграфисты 1870-х годов учились читать сообщения по звуку щелкающего реле, каналу ввода, который никто не проектировал. История интерфейсов полна таких побочных каналов, которые становятся полноценными, как только кто-то строит декодер. Субвокальное мышечное «бормотание» — побочный канал чтения и мышления, который люди «сливают» столько, сколько у нас есть внутренний монолог. Превратить его во входное устройство — скорее не изобретение, а повышение в статусе. И если кривые масштабирования подтвердятся, самый тихий человек в библиотеке может вскоре оказаться тем, кто печатает больше всех.