Ленты без рекомендаций: курирование вместо алгоритмов
Как собрать ленту без рекомендательного алгоритма: ручная курация и простой поиск вместо алгоритмов вовлечения. Уроки из HackerTube.
 Sarah Chen

Одиннадцать вечера в пятницу. Вы устали, открываете YouTube, и главная страница встречает вас стеной кричащих превью, шокированных лиц и теми же тремя темами, которые алгоритм решил, что вам нравятся ещё в 2019 году. Ничего из этого вам не нужно, но вы всё равно листаете, потому что листать — для этого интерфейс и существует. Если вы когда-нибудь чувствовали эту особенную усталость, то уже понимаете, почему ленты без рекомендаций вдруг стали интересными, и почему клон YouTube, собранный из рекомендаций в комментариях Hacker News примерно за два часа с помощью ИИ-агента, недавно получил столько внимания.
Речь идёт о HackerTube: интерфейсе в стиле YouTube поверх примерно 6500 видео, которые рекомендовали в комментариях Hacker News с 2007 года по сегодняшний день. Без аккаунтов, без трекинга, без манипуляций с автовоспроизведением. Состояние хранится в локальном хранилище браузера. Всё это появилось в результате одной субботней сессии с промптами: от извлечения данных до деплоя на VPS. Мне хочется поговорить о том, почему это так хорошо работает, потому что вывод выходит далеко за рамки одного весёлого сайд-проекта. Проект работает потому что в нём нет алгоритма рекомендаций в привычном смысле, и это оказывается свойством, которое можно осознанно заложить в свои продукты.
Почему рекомендательные алгоритмы оптимизируют не то
Несколько лет я работал над системами ранжирования, поэтому скажу прямо то, о чём обычно молчат: целевая функция и есть продукт. Рекомендатель масштаба платформы обучают на прокси вовлечённости: время просмотра, CTR, длительность сессии, иногда время задержки, взвешенное показами рекламы. Ничто из этого не отвечает на вопрос «ушёл ли пользователь довольным». Всё это отвечает на вопрос «остался ли он». Эти величины достаточно коррелируют, чтобы можно было убедить себя, будто вы создаёте что-то хорошее, но расходятся они как раз в важных случаях: возмущение, сенсации и двадцатое видео на тему, которую вы уже исчерпали.
Это закон Гудхарта в плаще. Как только время просмотра становится целью, оно перестаёт что-либо измерять о качестве. Хуже того, петля обратной связи замкнута: алгоритм определяет, что нажимают, клики становятся обучающими данными, и модель всё увереннее смотрит на всё более узкую картину вас. Многие, обсуждая HackerTube, отмечали то, что я и сам чувствовал: неперсонализированная лента видео, отобранных ботанами, попадала в цель чаще, чем глубоко персонализированная лента YouTube. Это не должно удивлять. Персонализация выводит ваш вкус из ваших самых слабых моментов (что вы нажали в одиннадцать вечера, уставшие), а курирование кодирует вкус из самых сильных моментов людей (того, что они потрудились написать в комментарии, рекомендуя другим).
Есть и более тонкий режим отказа: оптимизированные ленты отлично показывают больше того, что вы и так знаете. Но многие люди вообще листают ленты ради расширения горизонтов, то есть чтобы наткнуться на что-то неожиданное, что перестраивает их картину мира. У оптимизации вовлечённости нет градиентного сигнала для неожиданности, которая окупится позже. Она знает только, остались ли вы. Именно поэтому я писал, что ИИ-бенчмарки упускают большую часть реальной работы: измеримый прокси уходит от того, что вам на самом деле нужно, и этот дрейф накапливается.
Человеческая курация как корпус: добыча из комментариев Hacker News
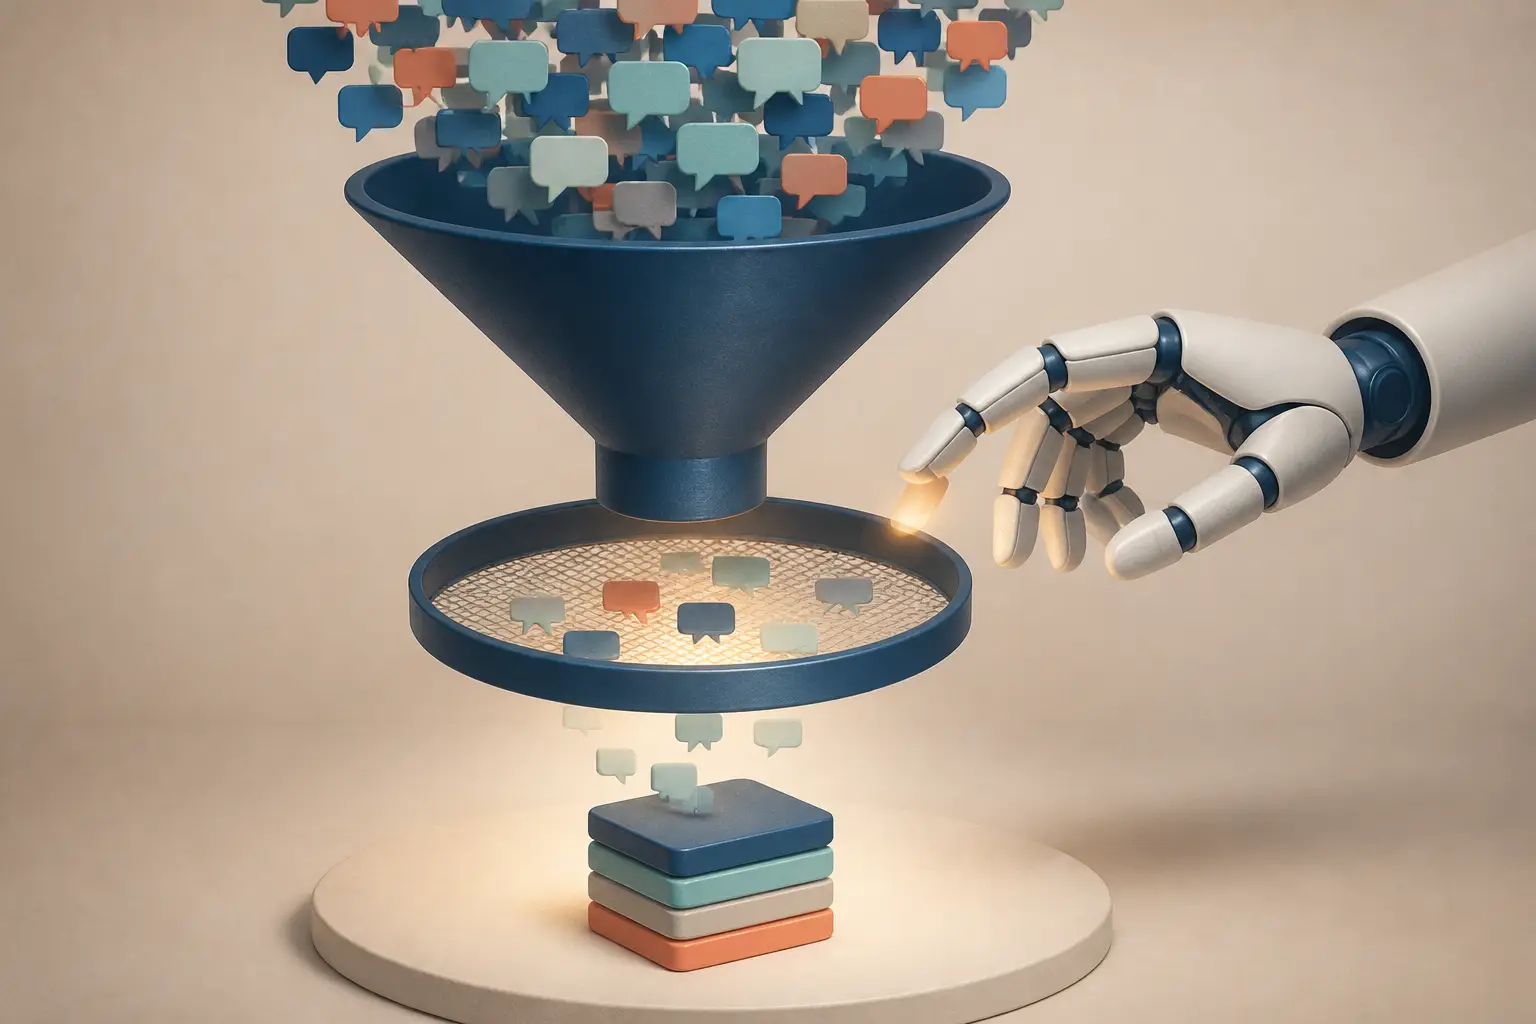
Так откуда лента без рекомендаций берёт материал? Ответ HackerTube изящен, потому что он переиспользует уже существующий качественный сигнал: два десятилетия комментариев Hacker News. Пайплайн описать несложно. Скачиваем все публичные комментарии HN (они доступны через официальный API и открытые датасеты сообщества). Фильтруем комментарии со ссылками на YouTube, их около 40 000. Затем прогоняем каждый комментарий через дешёвую LLM, чтобы ответить на один вопрос: человек действительно рекомендует это видео или это спам, случайная ссылка, либо видео приводится, чтобы его высмеять? Этот проход фильтрации сужает корпус примерно до 6500 видео в 150 тематических кластерах.
Здесь стоит перенять два проектных решения. Во-первых, шаг классификации — ровно тот тип ограниченной задачи суждения, в котором LLM хороши: ответ «да/нет» с коротким обоснованием, применяемый в масштабе за копейки. Это тот же паттерн, что и использование constrained decoding, чтобы превратить LLM в быстрые модели принятия решений: не просите модель генерировать, просите её фильтровать. Во-вторых, у корпуса есть встроенный порог качества. Каждое видео в нём было поручено человеком письменно, перед аудиторией, которая банит чушь. Это механизм фильтрации, который никакая модель вовлечённости не повторит, потому что он опирается на репутацию, а не на клики.
Рекомендация в комментарии — это человек, поставивший на кон свою репутацию. Клик — это рефлекс. Ленты, построенные на первом, ощущаются иначе, потому что они и правда другие.
Есть и важное временное измерение. Эти рекомендации охватывают период с 2007 года по сегодня, поэтому в корпусе преобладает контент с долгим сроком жизни: лекции, глубокие технические доклады, длинные интервью, а не то, что алгоритм продвигает на этой неделе. Людям очень понравилась одна деталь: категория «Longs» для длинных видео. На YouTube часовой доклад — это риск, который рекомендатель берёт с вашей сессией. На HackerTube это достоинство, потому что рядом кто-то написал: «после этого я иначе думаю о компиляторах».
Простой поиск побеждает умное ранжирование
Вот часть, которая покажется ересью, если вы работали в recsys: когда корпус небольшой и качественный, ранжирование почти не важно. Шесть тысяч видео — это ничто. Не нужна модель эмбеддингов с двумя башнями и каскад переранжирования. Нужны теги тем, свежесть и лёгкий проход персонализации, который работает на клиенте. «Для вас» в HackerTube опирается на состояние сессии в локальном хранилище, то есть на то, что вы смотрели и пропускали в этом браузере, без аккаунта и серверного профиля. Это не ограничение. Это архитектурное решение, которое устраняет целый класс дурных стимулов: если вы не храните поведение пользователя, вас не может искушать оптимизация против него.
Если бы вы захотели собрать свою версию такого проекта, то есть ленту статей, докладов, постов в блогах, всего, что рекомендует ваше сообщество, логика ранжирования уместится в пару десятков строк. Вот её форма:
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]
Обратите внимание, чего здесь нет: ни признака времени задержки, ни скорости вовлечения, ни бандита «исследование против эксплуатации», который пытается понять ваш предел. Сигналы персонализации явные (досмотрел или пропустил, выбрано собственным поведением пользователя в этой сессии) и ограниченные (пару баллов каждый, легко перебиваемых членом качества корпуса). Алгоритм может подтолкнуть, но не может поймать в ловушку. Эта асимметрия и есть вся философия, уложенная в одну функцию оценки.
Стоит упомянуть и решение с превью, потому что это отличный пример де-оптимизации интерфейса. Авторы на YouTube до бесконечности A/B-тестируют миниатюры, и сама миниатюра стала враждебным артефактом. HackerTube игнорирует загруженную миниатюру и использует кадр из середины видео, на отметке 50%. Это изменение в одну строку убирает гонку кликбейта целиком: превью показывает, что на самом деле в видео, а не то, что, по мнению автора, заставит вас нажать.
Проектирование лент без аккаунтов и трекинга
Перенос состояния на клиента меняет не только вашу позицию по приватности, но и структуру затрат и юридическую поверхность. Без пользовательских аккаунтов не нужны система авторизации, сброс паролей, механика запросов субъекта данных по GDPR, ответственность за утечку поведенческих профилей. Бэкенд — это статический файловый сервер и, может быть, одно маленькое API. Весь сайт может быть артефактом сборки. Когда архитектура не может накапливать пользовательские данные, большинство тёмных паттернов становятся физически невозможными, а не просто запрещёнными политикой. Такая гарантия внушает мне куда больше доверия, чем любая политика конфиденциальности.
Честный компромисс: локальное состояние эфемерно и привязано к устройству. Очистите данные браузера, и лента обнулится. Непрерывности между устройствами нет. Для лёгкого просмотра «лёжа» это нормально, и я бы даже сказал, что сброс иногда полезен. Там, где пользователи строят долгосрочные коллекции, понадобится механизм экспорта и импорта, и он удачно приводит нас к самому дальновидному решению всего проекта.
Данные как интерфейс: публикация переиспользуемого корпуса
Меня в HackerTube по-настоящему поражает не UI, а то, что весь датасет за сайтом можно скачать zip-архивом, который включает DATA.md, написанный специально для ИИ-агентов. В нём описано, как файлы связаны между собой, подводные камни, примеры записей и как получить свежие метаданные. Задуманный сценарий такой: отдаёте архив своему агенту для написания кода и говорите «сделай мне еженедельную рассылку докладов по моим темам» или «напиши мне терминальный клиент для этого». Продукт — не сайт. Продукт — курированный корпус, а сайт — всего лишь эталонный рендерер.
Думаю, мы будем видеть это всё чаще. Два десятилетия стандартный совет звучал так: «сделайте API». Но API всё равно делает вас привратником для запросов, и он начинает гнить, как только вы перестаёте его поддерживать. Переносимый, понятный агентам датасет меняет отношения: вы публикуете материал один раз, хорошо документированным, и позволяете расцвести тысяче персонализированных фронтендов. Это созвучно духу малого веба, где открытие строится на людях, которые ссылаются на то, что они полюбили, а не на платформах, решающих, что вы увидите. Только теперь этот дух обновлён для мира, где первым потребителем ваших данных может стать языковая модель.
Документация для агентов — это отдельное и быстро развивающееся ремесло. Люди пробегают текст глазами, а агенты читают буквально и целиком, и спотыкаются о неявные допущения, которые человек бы домыслил. Хороший DATA.md сразу описывает единицы измерения, допустимость null, особенности кодировки и режимы отказа. Если вы публикуете датасеты, это теперь обязательный минимум: разница между тем, что агент выдаст рабочий форк за один проход, и тем, что он придумает схему.
Честные ограничения курируемых лент
Я обещал прагматизм вместо хайпа, так что вот острые углы. Во-первых, курируемый корпус наследует предубеждения своих кураторов. Hacker News — это конкретная демография с конкретным вкусом, и результат выходит как «100% чистого контента для ботаников». Это восхитительно, если вы целевая аудитория, и незаметно, если нет. Такой подход не масштабируется на «всех», и он этого и не пытается. Это паб, а не утилита.
- Устаревание: замороженный снимок со временем портится. Нужна регулярная задача, которая перезапускает пайплайн извлечения, иначе лента незаметно превращается в музей.
- Зависимость от платформы: видео по-прежнему живут на YouTube. Удаления, региональные блокировки и изменения условий использования разрушат корпус изнутри. Отслеживайте мёртвые ссылки, иначе потеряете доверие.
- Привязка к аудитории: тот, кто рекомендует, задаёт вкус. Для сообщества это нормально, а если позиционировать такой сайт как нейтральное открытие, это серьёзная проблема предвзятости.
- Потолок свежести: по-настоящему новому отличному контенту пока никто ничего не рекомендовал. Курируемые ленты систематически недообслуживают новое, и именно этот пробел закрывают алгоритмы вовлечения, к лучшему и к худшему.
Этот последний пункт не даёт мне расслабиться в отношении всего подхода. Ленты вовлечения и курируемые ленты не враги: они оптимизированы под разные временны́е горизонты. Курирование говорит, что уже доказало свою ценность. Ранжирование по вовлечению в лучшем случае показывает то, что может стать ценным. Здоровая версия рекомендательной системы YouTube выглядела бы очень похоже на корпус HackerTube с небольшой, чётко подписанной полосой «новое и непроверенное». Трагедия не в том, что рекомендательные алгоритмы существуют, а в том, что бизнес-модель требует, чтобы они были всем интерфейсом.
Когда стоит построить это самому
Два часа сборки — это история внутри истории. Пять лет назад такой проект при этой скорости был невозможен, и не потому, что какой-то отдельный шаг сложен, а потому, что здесь около сорока неприятных шагов: извлечение, фильтрация, обогащение метаданными, UI, деплой, укрепление защиты. Агент, который способен удерживать весь план в контексте, сворачивает это в одну сессию с промптами. Это значит, что порог входа для создания нишевых курируемых альтернатив лентам платформ упал примерно до уровня «один мотивированный человек и одна субботняя перед обедом».
Вот моя позиция, и я на ней настаиваю: если вы ведёте любой продукт с лентой (внутреннюю базу знаний, сообщество, контентный продукт), прототипируйте курируемую версию раньше алгоритмической. Начните с явных рекомендаций людей, отфильтруйте их дешёвым проходом через LLM, ранжируйте функцией оценки, которую можно объяснить на стендапе, и держите состояние на клиенте, пока можете. Вы узнаете, есть ли у вас проблема с инвентарём или с ранжированием, и по моему опыту почти всегда это инвентарь. Лента, оптимизированная под вовлечение, — инструмент максимизации метрики. Курируемая лента — инструмент уважения к человеку. Сначала постройте вторую, а к первой тянитесь только тогда, когда сможете внятно объяснить, почему и для кого она должна существовать.


