Feeds sin recomendaciones: curación frente a algoritmos
Cómo construir un feed sin recomendaciones algorítmicas con curación humana y recuperación simple, con lecciones de HackerTube.
 Sarah Chen

Son las 23:00 de un viernes. Estás cansado, abres YouTube y la portada te recibe con un muro de miniaturas gritonas, caras de sorpresa y los mismos tres temas que decidió que te gustaban en 2019. Nada de lo que hay te interesa, pero haces scroll igual, porque hacer scroll es para lo que está diseñada la interfaz. Si alguna vez has sentido ese agotamiento concreto, ya entiendes por qué los feeds sin recomendaciones están de moda de repente, y por qué un clon de YouTube construido con recomendaciones de comentarios de Hacker News, montado en unas dos horas con un agente de IA, ha llamado tanto la atención hace poco.
El proyecto en cuestión es HackerTube: una interfaz estilo YouTube sobre unos 6.500 videos recomendados en comentarios de Hacker News entre 2007 y la actualidad. Sin cuentas, sin rastreo, sin manipulaciones de reproducción automática. El estado vive en el almacenamiento local de tu navegador. Todo se generó con un prompt en una sesión de un sábado por la mañana, desde la extracción de datos hasta el despliegue en un VPS. Quiero hablar de por qué funciona tan bien, porque la lección va mucho más allá de un proyecto personal divertido. Funciona porque no tiene un algoritmo de recomendación en el sentido convencional, y eso resulta ser una característica que puedes diseñar a propósito en tus propios productos.
Por qué los algoritmos de recomendación optimizan lo equivocado
Pasé unos años trabajando en sistemas de ranking, así que diré en voz alta lo que casi nadie dice: la función objetivo es el producto. Un recomendador a escala de plataforma se entrena con proxies de engagement: tiempo de visualización, tasa de clics, duración de la sesión y, a veces, tiempo de permanencia ponderado por impresiones publicitarias. Ninguna de esas métricas mide «¿el usuario se fue satisfecho?». Miden «¿el usuario se quedó?». Están correlacionadas con suficiente frecuencia como para convencerte de que estás construyendo algo bueno, pero divergen justo en los casos que importan: la indignación, el morbo y el vigésimo video sobre un tema que ya agotaste.
Esto es la ley de Goodhart disfrazada de gabardina. En cuanto el tiempo de visualización se convierte en el objetivo, deja de medir nada sobre la calidad. Peor aún, el bucle de retroalimentación está cerrado: el algoritmo moldea lo que se clica, los clics se convierten en datos de entrenamiento y el modelo se vuelve cada vez más seguro de una imagen cada vez más estrecha de ti. Varias personas que reaccionaron a HackerTube señalaron algo que yo también he sentido: el feed no personalizado de videos validados por frikis tenía una tasa de aciertos mayor que el hiperpersonalizado de YouTube. No debería sorprender. La personalización infiere tu gusto a partir de tus momentos más débiles (lo que clicaste a las 23:00, cansado), mientras que la curación codifica el gusto a partir de los momentos más fuertes de las personas (lo que se molestaron en escribir recomendando a sus colegas).
Hay también un modo de fallo más sutil: los feeds optimizados son excelentes mostrándote más de lo que ya conoces. Pero buena parte de por qué la gente navega es la expansión de horizontes: encontrar algo sorprendente que recalibra tu modelo del mundo. La optimización de engagement no tiene señal de gradiente para la sorpresa que da frutos más tarde. Solo sabe si te quedaste. Es el mismo problema por el que he defendido que los benchmarks de IA no capturan la mayor parte del trabajo real: el proxy medible se aleja de lo que realmente querías, y esa deriva se acumula.
La curación humana como corpus: minería de comentarios de Hacker News
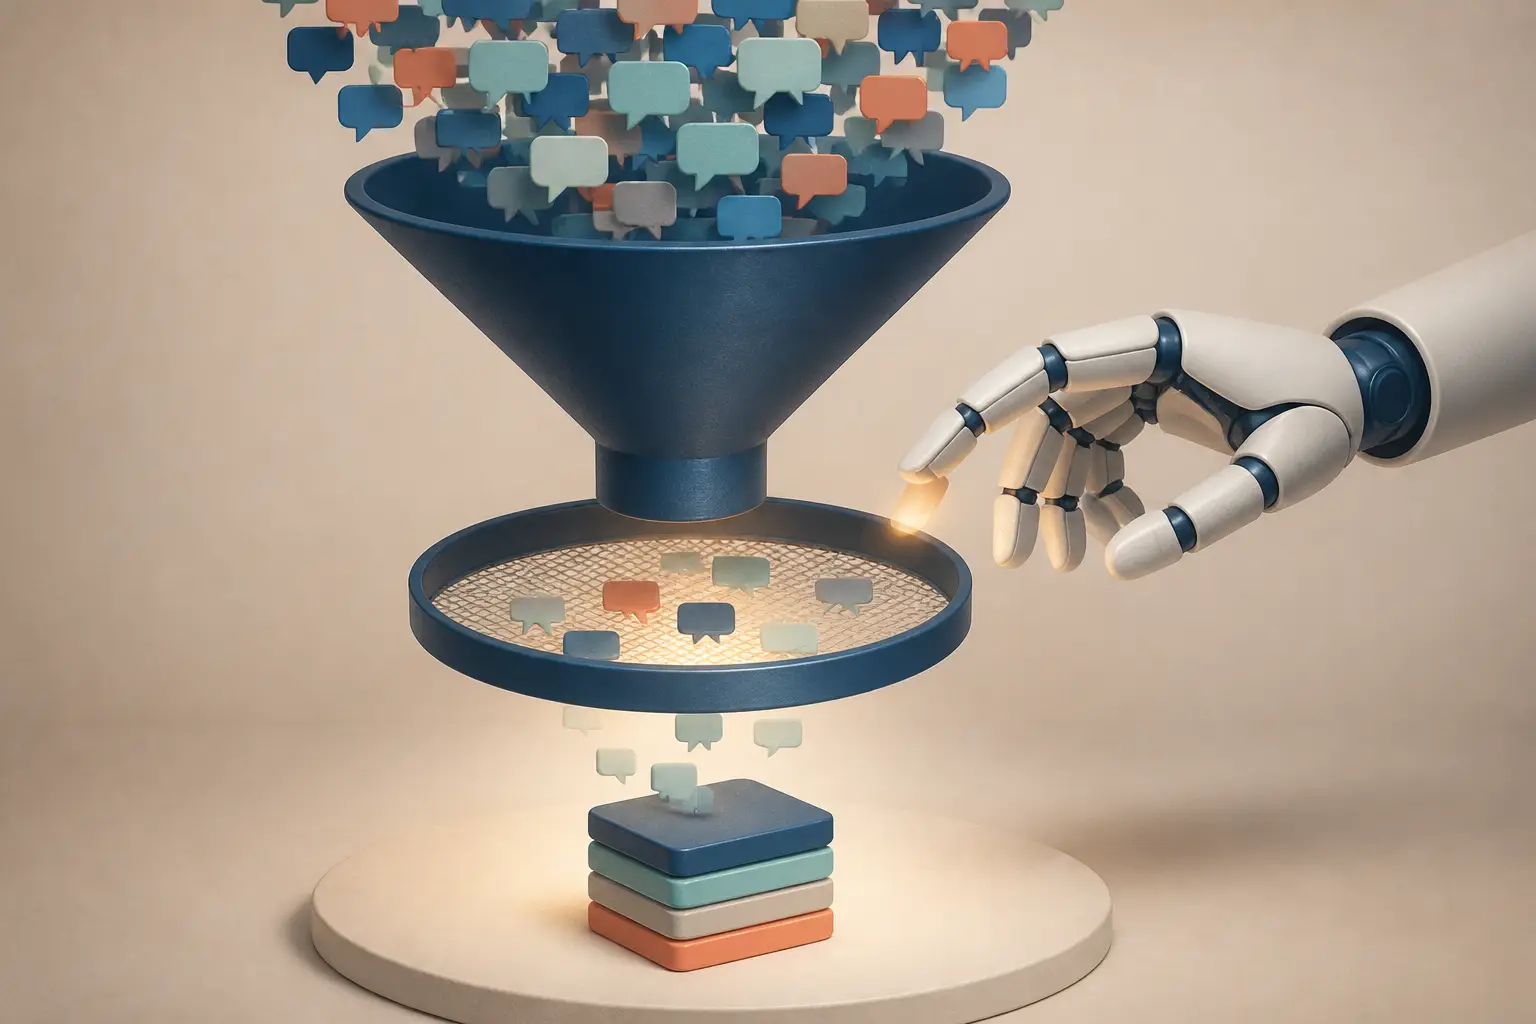
Entonces, ¿de dónde saca un feed sin recomendaciones su inventario? La respuesta de HackerTube es ingeniosa porque reutiliza una señal existente y de alta calidad: dos décadas de comentarios de Hacker News. El proceso es simple de describir. Descargas todos los comentarios públicos de HN (están disponibles a través de la API oficial y de datasets de la comunidad). Filtras los que contienen enlaces a YouTube, unos 40.000. Luego ejecutas un pase con un LLM más barato sobre cada comentario para responder una sola pregunta: ¿esta persona está realmente recomendando este video, o es spam, un enlace de paso o alguien que cita el video para burlarse de él? Ese filtrado reduce el corpus a unos 6.500 videos repartidos en 150 grupos temáticos.
Hay dos decisiones de diseño que merece la pena copiar. Primero, el paso de clasificación es exactamente el tipo de tarea de juicio acotado en la que los LLM sobresalen: un sí/no con una justificación corta, aplicado a escala por unos céntimos. Es el mismo patrón que usar decodificación restringida para convertir LLMs en modelos de decisión rápidos: no le pidas al modelo que genere, pídele que filtre. Segundo, el corpus tiene un suelo de calidad incorporado. Cada video fue avalado por una persona, por escrito, ante una audiencia que vota negativamente las tonterías. Es un mecanismo de filtrado que ningún modelo de engagement puede replicar, porque se basa en la reputación y no en los clics.
Una recomendación escrita en un comentario es una persona jugándose su reputación. Un clic es un reflejo. Los feeds construidos sobre lo primero se sienten distintos porque son distintos.
También importa la dimensión temporal. Estas recomendaciones abarcan de 2007 hasta hoy, así que el corpus está dominado por contenido con vida larga (conferencias, charlas técnicas profundas, entrevistas de formato largo) en lugar de lo que el algoritmo impulsa esta semana. Un detalle que encantó a la gente: una categoría «Longs» para videos largos. En YouTube, una charla de 90 minutos es un riesgo que el recomendador corre con tu sesión. En HackerTube es una virtud, porque alguien escribió «esto cambió mi forma de pensar sobre los compiladores» justo al lado.
La recuperación simple supera al ranking inteligente
Aquí viene la parte que sonará herética si has trabajado en recsys: cuando el corpus es pequeño y bueno, el ranking casi no importa. Seis mil videos no son nada. No necesitas un modelo de embeddings de dos torres ni una cascada de re-ranking; necesitas etiquetas de tema, recencia y una pasada ligera de personalización que se ejecute en el cliente. El «Para ti» de HackerTube funciona con el estado de la sesión en el almacenamiento local (lo que has visto y saltado en este navegador), sin cuenta ni perfil en el servidor. Eso no es una limitación. Es una decisión de arquitectura que elimina toda una clase de incentivos malos: si no guardas el comportamiento del usuario, no puedes sentir la tentación de optimizar contra él.
Si quisieras construir tu propia versión de esto (un feed de artículos, charlas de conferencias, posts de blog, lo que tu comunidad recomiende), la lógica de ranking cabe en unas pocas decenas de líneas. Esta es su forma:
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]
Fíjate en lo que no aparece: ninguna característica de tiempo de permanencia, ninguna velocidad de engagement, ningún bandido de exploración-explotación intentando averiguar tu punto de ruptura. Las señales de personalización son explícitas (finalizaciones y saltos, determinados por el propio comportamiento del usuario en esta sesión) y acotadas (un par de puntos cada una, fácilmente superadas por el término de calidad del corpus). El algoritmo puede empujar; no puede atrapar. Esa asimetría es toda la filosofía en una sola función de puntuación.
La decisión sobre las miniaturas también merece mención, porque es un ejemplo muy limpio de desoptimizar una interfaz. Los creadores de YouTube hacen pruebas A/B de miniaturas hasta la saciedad, así que la miniatura se convirtió en un artefacto adversarial. HackerTube ignora la miniatura subida y usa en su lugar el fotograma del 50 % de la duración del video. Es un cambio de una línea que elimina por completo la carrera armamentística del clickbait: la vista previa te muestra qué es realmente el video, no lo que su creador cree que te hará clicar.
Diseñar feeds sin cuentas ni rastreo
Mover el estado al cliente cambia más que tu postura de privacidad: cambia tu estructura de costes y tu superficie legal. Sin cuentas de usuario no hay sistema de autenticación, ni restablecimiento de contraseñas, ni maquinaria de acceso a datos del RGPD, ni responsabilidad por filtraciones de perfiles de comportamiento. Tu backend es un servidor de archivos estáticos y quizá una pequeña API. Todo el sitio puede ser un artefacto de compilación. Cuando tu arquitectura no puede acumular datos de usuario, la mayoría de los patrones oscuros se vuelven físicamente imposibles en lugar de simplemente contrarios a la política. Me parece una garantía mucho más fiable que cualquier política de privacidad.
La compensación honesta: el estado local es efímero y está ligado al dispositivo. Borra los datos del navegador y tu feed se reinicia. No hay continuidad entre dispositivos. Para un sitio de video de visionado relajado, está bien; incluso diría que el reinicio es a veces saludable. Para cualquier caso en el que los usuarios construyan colecciones a largo plazo, necesitarás una vía de exportación e importación, que, convenientemente, nos lleva a la decisión más orientada al futuro de todo el proyecto.
Los datos como interfaz: publicar un corpus reutilizable
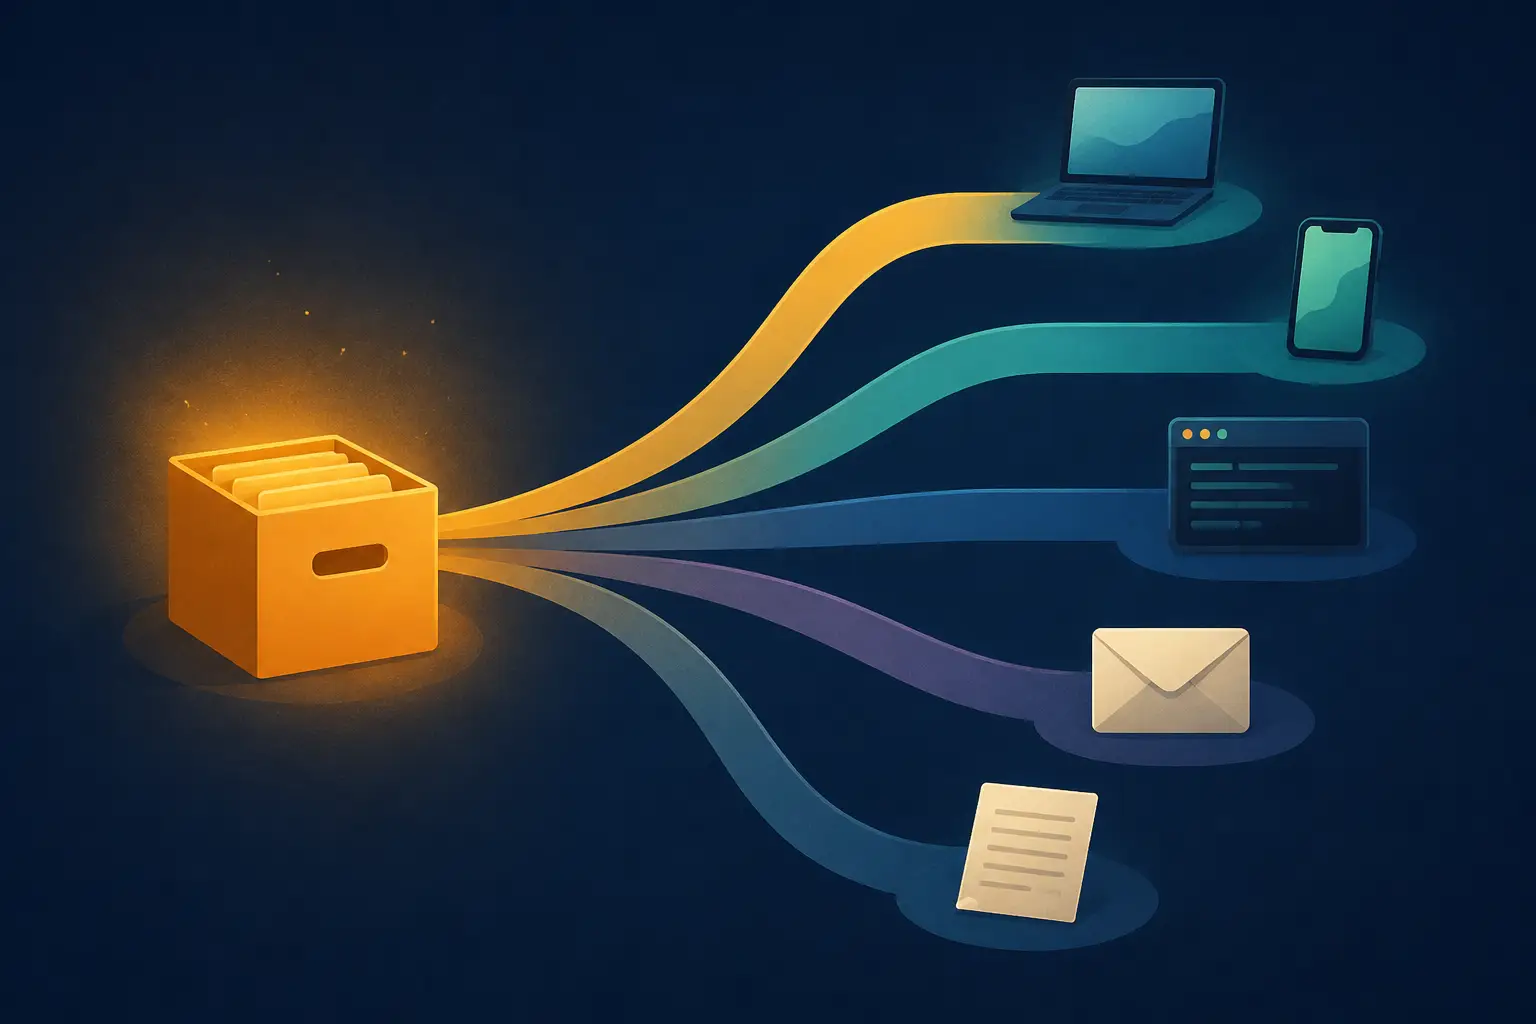
La parte de HackerTube que considero realmente novedosa no es la interfaz, sino que todo el dataset detrás del sitio se puede descargar como un zip que incluye un DATA.md escrito específicamente para agentes de IA. Documenta cómo encajan los archivos, las trampas habituales, registros de ejemplo y cómo obtener metadatos actualizados. El flujo previsto: le das el zip a tu agente de programación y le dices «hazme un email semanal con charlas sobre mis temas» o «constrúyeme un cliente de terminal para esto». El producto no es el sitio web. El producto es el corpus curado, y el sitio es solo el renderizador de referencia.
Creo que veremos mucho más de este patrón. Durante dos décadas, el consejo estándar fue «expón una API». Pero una API sigue haciéndote guardián de las consultas, y se pudre en cuanto dejas de mantenerla. Un dataset portable y legible por agentes invierte la relación: publicas la cosa una vez, bien documentada, y dejas que florezcan mil frontends personalizados. Rima con el espíritu de la web pequeña: descubrimiento basado en personas enlazando cosas que les encantaron, en lugar de plataformas decidiendo lo que ves, actualizado para un mundo donde el primer consumidor de tus datos puede ser un modelo de lenguaje.
Escribir documentación para agentes es un oficio nuevo en desarrollo. Los humanos hojean; los agentes leen de forma literal y completa, y tropiezan con supuestos implícitos que una persona inferiría. Un buen DATA.md declara desde el principio las unidades, la nulabilidad, las peculiaridades de codificación y los modos de fallo. Si publicas datasets, esto ya es lo mínimo imprescindible: la diferencia entre que un agente produzca una copia funcional en una sola pasada o alucine un esquema.
Las limitaciones honestas de los feeds curados
Prometí pragmatismo frente a exageración, así que aquí van los puntos débiles. Primero: un corpus curado hereda los sesgos de sus curadores. Hacker News es un público demográfico concreto con gustos concretos; el resultado es «contenido friki en estado puro», lo cual es un placer si eres el público objetivo e invisible si no lo eres. Este enfoque no escala a «todo el mundo», y tampoco lo intenta. Es una taberna, no un servicio público.
- Obsolescencia: una instantánea congelada se degrada. Necesitas un trabajo programado que vuelva a ejecutar el pipeline de extracción, o el feed se convierte silenciosamente en un museo.
- Dependencia de la plataforma: los videos siguen alojados en YouTube. Borrados, bloqueos por región y cambios en los términos de servicio pudrirán tu corpus desde dentro. Rastrea los enlaces rotos o pierdes la confianza.
- Sesgo demográfico: quien recomienda define el gusto. Está bien para un sitio comunitario, pero es un grave problema de sesgo si alguna vez lo presentas como descubrimiento neutral.
- Techo de frescura: el contenido nuevo y excelente aún no tiene recomendaciones. Los feeds curados infraatienden sistemáticamente lo nuevo, justo el hueco que llenan los algoritmos de engagement, para bien y para mal.
Ese último punto es el que me mantiene honesto con todo este enfoque. Los feeds de engagement y los curados no son enemigos; están optimizados para horizontes temporales distintos. La curación te dice qué resultó valioso. El ranking por engagement, en su mejor versión, muestra lo que podría llegar a ser valioso. La versión sana del recomendador de YouTube se parecería mucho al corpus de HackerTube con un pequeño carril claramente etiquetado de «nuevo y sin probar». La tragedia no es que existan los algoritmos de recomendación, sino que el modelo de negocio exige que sean toda la interfaz.
Cuándo deberías construirlo tú mismo
El tiempo de construcción de dos horas es la historia dentro de la historia. Este proyecto no era viable a esta velocidad hace cinco años, no porque ningún paso sea difícil, sino porque hay cuarenta pasos delicados: extracción, filtrado, enriquecimiento de metadatos, interfaz, despliegue, endurecimiento. Un agente que puede mantener todo el plan en contexto convierte eso en una sesión de prompts. Eso significa que la barrera para construir alternativas de nicho y curadas a los feeds de las plataformas ha bajado a algo como «una persona motivada con una mañana de sábado».
Así que aquí va mi postura, y me comprometo con ella: si gestionas cualquier producto con un feed (una base de conocimiento interna, un foro comunitario, un producto de contenidos), deberías prototipar la versión curada antes que la algorítmica. Empieza con recomendaciones humanas explícitas, filtra con un pase barato de LLM, ordena con una función de puntuación lo bastante simple como para explicarla en un standup y mantén el estado en el cliente todo el tiempo que puedas. Aprenderás si tienes un problema de inventario o de ranking, y en mi experiencia casi siempre es de inventario. El feed optimizado por engagement es una herramienta para maximizar una métrica. El feed curado es una herramienta para respetar a una persona. Construye primero el segundo, y recurre al primero solo cuando puedas articular exactamente por qué, y para quién, merece existir.


