Feeds sans algorithme : la curation contre l'engagement
Construire un feed sans recommandation par la curation humaine et une récupération simple, plutôt que des algorithmes d'engagement : leçons de HackerTube.
 Sarah Chen

Il est 23 h un vendredi. Vous êtes fatigué, vous ouvrez YouTube, et la page d'accueil vous accueille avec un mur de miniatures hurlantes, de visages choqués et les mêmes trois sujets qu'elle a décidé que vous aimiez en 2019. Rien de ce qui s'y trouve ne vous intéresse, mais vous faites défiler quand même, parce que le défilement, c'est précisément à ça que sert l'interface. Si vous avez déjà ressenti ce genre d'épuisement bien particulier, vous comprenez pourquoi les feeds sans recommandation suscitent soudain de l'intérêt, et pourquoi un clone de YouTube construit à partir des recommandations dans les commentaires de Hacker News, assemblé en deux heures environ avec un agent IA, a récemment fait autant parler de lui.
Le projet en question s'appelle HackerTube : une interface façon YouTube qui s'appuie sur environ 6 500 vidéos recommandées dans les commentaires de Hacker News entre 2007 et aujourd'hui. Pas de compte, pas de suivi, pas de manipulation de lecture automatique. L'état est stocké dans le local storage de votre navigateur. Tout a été généré par prompt lors d'une session de samedi matin, de l'extraction des données jusqu'au déploiement sur un VPS. Je veux parler de la raison pour laquelle ça marche si bien, car la leçon dépasse largement ce petit projet. Ça marche parce que il n'y a pas d'algorithme de recommandation au sens classique, et c'est une fonctionnalité qu'on peut concevoir délibérément dans ses propres produits.
Pourquoi les algorithmes de recommandation optimisent la mauvaise chose
J'ai passé quelques années à travailler sur des systèmes de classement, donc laissez-moi dire la chose qu'on ne dit pas tout haut : la fonction objectif, c'est le produit. Un recommandeur à l'échelle d'une plateforme est entraîné sur des indicateurs d'engagement : temps de visionnage, taux de clic, durée de session, parfois temps de présence pondéré par les impressions publicitaires. Aucun de ces indicateurs ne mesure « l'utilisateur est-il reparti satisfait ? ». Ils mesurent « l'utilisateur est-il resté ? ». Ces indicateurs sont suffisamment corrélés pour qu'on se convainque qu'on construit quelque chose de bien, mais ils divergent précisément dans les cas qui comptent : l'indignation, le racolage, et la vingtième vidéo sur un sujet qu'on a déjà épuisé.
C'est la loi de Goodhart déguisée en trench-coat. Dès que le temps de visionnage devient la cible, il cesse de mesurer quoi que ce soit de la qualité. Pire, la boucle de rétroaction est fermée : l'algorithme façonne ce qui est cliqué, les clics deviennent des données d'entraînement, et le modèle gagne en assurance à propos d'une image de plus en plus étroite de vous. Plusieurs personnes ayant réagi à HackerTube ont remarqué ce que j'ai moi-même ressenti : le flux non personnalisé de vidéos validées par des geeks avait un taux de réussite supérieur à celui, hyperpersonnalisé, de YouTube. Ce n'est pas si surprenant. La personnalisation déduit vos goûts de vos moments les plus faibles (ce que vous avez cliqué à 23 h, fatigué), alors que la curation encode le goût à partir des moments les plus forts des gens (ce qu'ils ont pris la peine d'écrire pour recommander à leurs pairs).
Il existe aussi un mode de défaillance plus subtil : les feeds optimisés sont extrêmement doués pour vous montrer davantage de ce que vous connaissez déjà. Or une grande partie des raisons pour lesquelles on navigue, c'est l'élargissement de l'horizon : tomber sur quelque chose de surprenant qui recalibre votre modèle du monde. L'optimisation de l'engagement n'a aucun signal de gradient pour la surprise qui paie plus tard. Elle sait seulement si vous êtes resté. C'est aussi pourquoi j'ai soutenu que les benchmarks de l'IA passent à côté de la majeure partie du travail réel : l'indicateur mesurable dérive loin de ce que vous vouliez vraiment, et la dérive s'accumule.
La curation humaine comme corpus : exploiter les commentaires de Hacker News
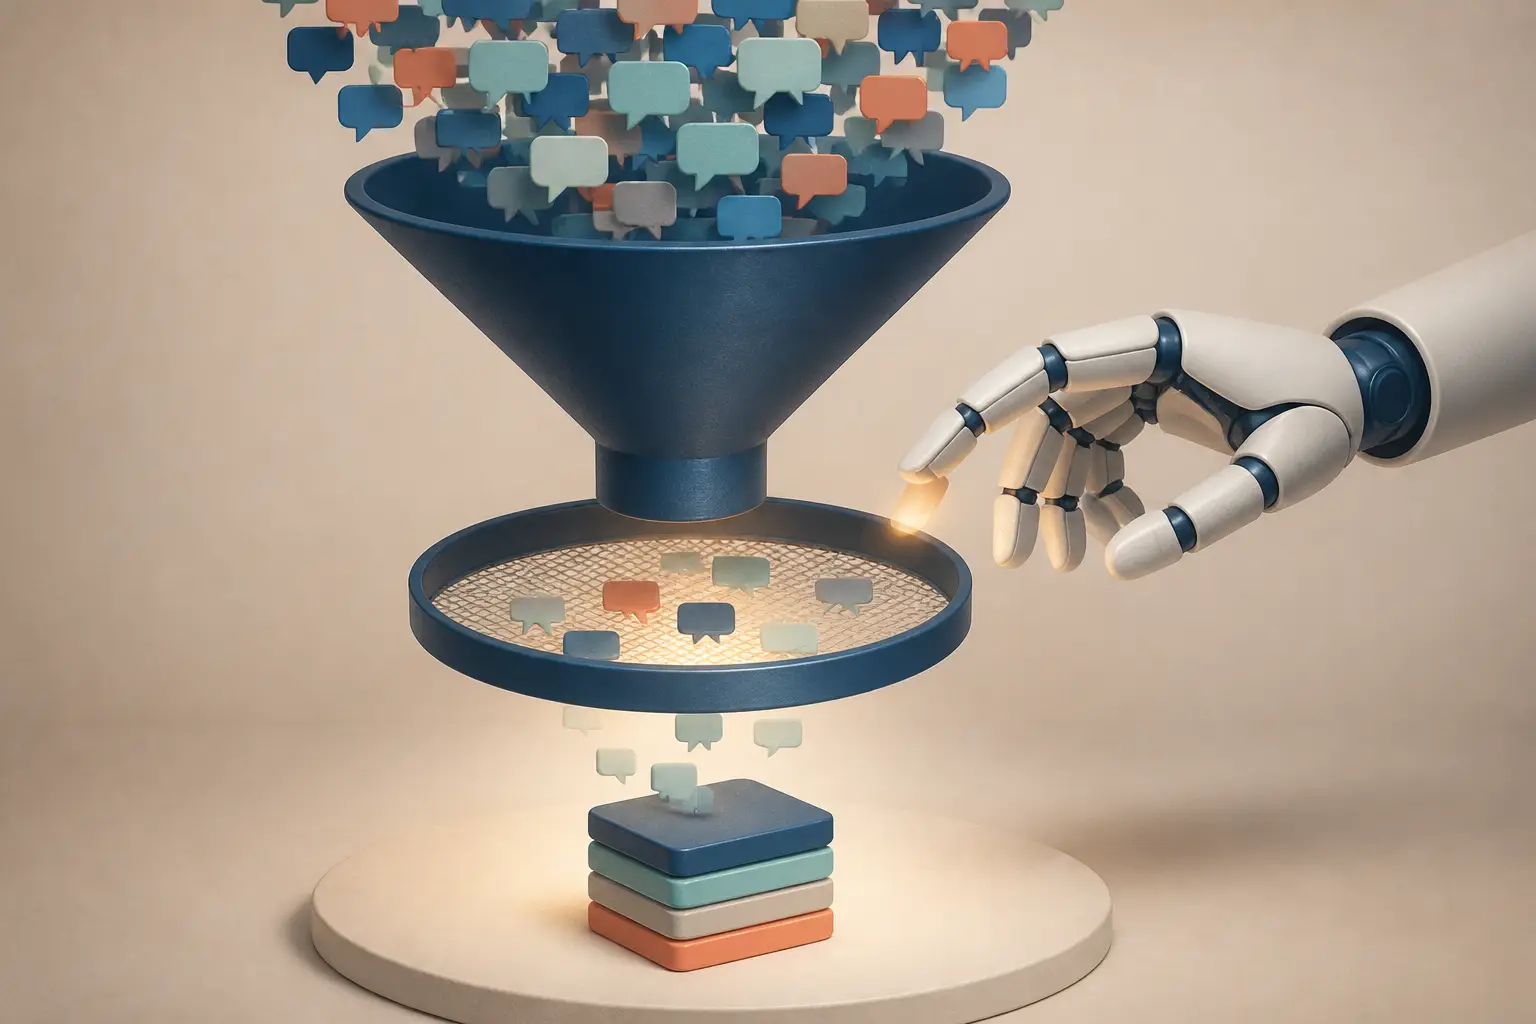
Alors, d'où un feed sans recommandation tire-t-il son contenu ? La réponse de HackerTube est astucieuse, car elle réutilise un signal existant et de grande qualité : deux décennies de commentaires Hacker News. Le pipeline est simple à décrire. On télécharge tous les commentaires publics de HN (disponibles via l'API officielle et des jeux de données communautaires). On filtre ceux qui contiennent des liens YouTube, soit environ 40 000. Puis on fait passer chaque commentaire dans un LLM bon marché pour répondre à une seule question : cette personne recommande-t-elle vraiment cette vidéo, ou s'agit-il de spam, d'un lien en passant, ou de quelqu'un qui cite la vidéo pour s'en moquer ? Cette étape de filtrage réduit le corpus à environ 6 500 vidéos réparties dans 150 clusters thématiques.
Deux choix de conception méritent d'être repris. D'abord, l'étape de classification relève exactement du type de tâche de jugement borné dont les LLM sont très bons : un oui/non accompagné d'une courte justification, appliqué à grande échelle pour quelques centimes. C'est le même principe que le décodage contraint pour transformer les LLM en modèles de décision rapides : ne demandez pas au modèle de générer, demandez-lui de filtrer. Ensuite, le corpus dispose d'un plancher de qualité intégré. Chaque vidéo y a été recommandée par un humain, par écrit, devant un public qui sanctionne les absurdités. C'est un mécanisme de filtrage qu'aucun modèle d'engagement ne peut reproduire, car il repose sur la réputation et non sur les clics.
Une recommandation écrite dans un commentaire, c'est une personne qui engage sa réputation. Un clic, c'est un réflexe. Des feeds construits sur le premier cas se ressentent différemment, parce qu'ils sont différents.
Il y a aussi une dimension temporelle qui compte. Ces recommandations couvrent 2007 à aujourd'hui, ce qui fait que le corpus est dominé par des contenus qui tiennent dans le temps (conférences, présentations techniques approfondies, entretiens longs) plutôt que par ce que l'algorithme pousse cette semaine. Un détail que les gens ont adoré : une catégorie « Longs » pour les vidéos longues. Sur YouTube, une conférence de 90 minutes est un risque que le recommandeur prend avec votre session. Sur HackerTube, c'est un atout, car quelqu'un a écrit « ça a changé ma façon de penser les compilateurs » juste à côté.
La recherche simple bat le classement intelligent
Voici la partie qui paraîtra hérétique si vous avez travaillé en recsys : une fois que votre corpus est petit et bon, le classement compte à peine. Six mille vidéos, c'est peu. Vous n'avez pas besoin d'un modèle d'embeddings à deux tours ni d'une cascade de reclassement ; il vous faut des tags thématiques, de la récence et une légère passe de personnalisation exécutée côté client. Le « Pour vous » de HackerTube fonctionne à partir de l'état de session dans le local storage : ce que vous avez regardé et passé dans ce navigateur, sans compte ni profil côté serveur. Ce n'est pas une limitation. C'est un choix d'architecture qui élimine toute une catégorie de mauvaises incitations : si vous ne stockez pas le comportement des utilisateurs, vous ne pouvez pas être tenté de l'optimiser.
Si vous voulez construire votre propre version de ce concept, un feed d'articles de recherche, de conférences, de billets de blog, bref tout ce que votre communauté recommande, la logique de classement tient en quelques dizaines de lignes. Voici sa forme générale :
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]
Remarquez ce qui est absent : pas de caractéristique de temps de présence, pas de vélocité d'engagement, pas de bandit exploration-exploitation cherchant votre point de rupture. Les signaux de personnalisation sont explicites (terminés et passés, choisis par le comportement de l'utilisateur lui-même dans cette session) et bornés (quelques points chacun, facilement noyés par le terme de qualité du corpus). L'algorithme peut suggérer ; il ne peut pas piéger. Cette asymétrie résume toute la philosophie dans une seule fonction de score.
La décision concernant les miniatures mérite aussi d'être mentionnée, car c'est un exemple très net de désoptimisation d'une interface. Les créateurs de YouTube testent leurs miniatures en A/B jusqu'à l'épuisement, si bien que la miniature elle-même est devenue un artefact adversarial. HackerTube ignore la miniature envoyée et utilise l'image située à 50 % de la vidéo. Un changement d'une ligne qui supprime d'un coup la course au clickbait : l'aperçu vous montre ce que la vidéo est vraiment, et non ce que son créateur pense qui vous fera cliquer.
Concevoir des feeds sans comptes ni suivi
Déplacer l'état côté client change davantage que votre politique de confidentialité : cela modifie votre structure de coûts et votre surface juridique. Pas de compte utilisateur, donc pas de système d'authentification, pas de réinitialisation de mot de passe, pas de mécanique de droit d'accès RGPD, pas de responsabilité en cas de fuite de profils comportementaux. Votre backend est un simple serveur de fichiers statiques, et peut-être une minuscule API. Tout le site peut être un artefact de build. Quand votre architecture ne peut pas accumuler de données utilisateur, la plupart des dark patterns deviennent physiquement impossibles plutôt que simplement interdits par la politique. Ce genre de garantie me paraît bien plus fiable que n'importe quelle politique de confidentialité.
Le compromis honnête : l'état local est éphémère et lié à l'appareil. Effacez les données de votre navigateur et votre feed repart de zéro. Il n'y a aucune continuité entre appareils. Pour un site vidéo de visionnage passif, ça va très bien : je dirais même que la réinitialisation est parfois saine. Pour tout ce qui implique des collections à long terme, vous aurez besoin d'une porte de sortie sous forme d'export/import, ce qui nous amène opportunément à la décision la plus tournée vers l'avenir de tout le projet.
Les données comme interface : livrer un corpus réutilisable
La partie de HackerTube que je trouve vraiment originale n'est pas l'interface, c'est que l'ensemble du jeu de données derrière le site est téléchargeable sous forme d'archive zip, incluant un DATA.md écrit spécifiquement pour les agents IA. Il documente la façon dont les fichiers s'articulent, les pièges, des exemples d'enregistrements et la manière de récupérer des métadonnées à jour. Le flux de travail visé : donner le zip à votre agent de code et lui dire « fais-moi un email hebdomadaire des conférences sur mes sujets » ou « construis-moi un client terminal pour ça ». Le produit n'est pas le site web. Le produit, c'est le corpus sélectionné, et le site n'est que le moteur de rendu de référence.
C'est un motif que je pense voir beaucoup plus souvent. Pendant deux décennies, le conseil standard était « exposez une API ». Mais une API vous laisse toujours comme gardien des requêtes, et elle se dégrade dès que vous cessez de la maintenir. Un jeu de données portable, lisible par un agent, inverse la relation : vous publiez la chose une fois, bien documentée, et laissez mille interfaces personnalisées éclore. Cela rejoint l'esprit de le petit web (la découverte fondée sur des personnes qui créent des liens vers ce qu'elles aiment, plutôt que sur des plateformes qui décident de ce que vous voyez), mis à jour pour un monde où le premier consommateur de vos données pourrait être un modèle de langage.
Écrire de la documentation pour les agents est un savoir-faire en train d'émerger. Les humains parcourent en diagonale ; les agents lisent littéralement et intégralement, et ils trébuchent sur les hypothèses implicites qu'un humain déduirait. Un bon DATA.md énonce dès le départ les unités, la nullabilité, les particularités d'encodage et les modes de défaillance. Si vous publiez des jeux de données, c'est désormais un minimum : la différence entre un agent qui produit un fork fonctionnel en une passe et un agent qui hallucine un schéma.
Les limites honnêtes des feeds sélectionnés
J'ai promis du pragmatisme plutôt que de l'enthousiasme, voici donc les aspérités. D'abord : un corpus sélectionné hérite des biais de ses sélectionneurs. Hacker News est une démographie précise, avec un goût précis : le résultat est « 100 % de contenu pur geek », ce qui est délicieux si vous faites partie du public visé et invisible si vous n'en faites pas partie. Cette approche ne passe pas à l'échelle de « tout le monde », et elle n'essaie pas de le faire. C'est un café de quartier, pas un service public.
- Obsolescence : un instantané figé se dégrade. Il faut une tâche planifiée qui relance le pipeline d'extraction, sinon le feed devient discrètement un musée.
- Dépendance à la plateforme : les vidéos restent hébergées sur YouTube. Suppressions, restrictions géographiques et changements de CGU vont ronger votre corpus par en dessous. Surveillez les liens morts, ou perdez la confiance.
- Enfermement démographique : celui qui recommande définit le goût. C'est acceptable pour un site communautaire, mais un sérieux problème de biais si vous le présentez comme une découverte neutre.
- Plafond de fraîcheur : les excellents contenus tout juste publiés n'ont encore aucune recommandation. Les feeds sélectionnés sous-servent systématiquement le neuf, précisément le vide que comblent les algorithmes d'engagement, pour le meilleur comme pour le pire.
Ce dernier point est celui qui me garde honnête sur toute cette approche. Les feeds d'engagement et les feeds sélectionnés ne sont pas ennemis : ils sont optimisés pour des horizons temporels différents. La curation vous dit ce qui a prouvé sa valeur. Le classement par engagement, au mieux, fait remonter ce qui pourrait devenir valable. La version saine du recommandeur de YouTube ressemblerait beaucoup au corpus de HackerTube, avec une petite voie clairement étiquetée « nouveau et non éprouvé ». La tragédie n'est pas que les algorithmes de recommandation existent, c'est que le modèle économique exige qu'ils soient toute l'interface.
Quand vous devriez construire cela vous-même
Le temps de construction de deux heures est l'histoire dans l'histoire. Ce projet n'était pas réalisable à cette vitesse il y a cinq ans, non pas parce qu'une étape est difficile en soi, mais parce qu'il y a une quarantaine d'étapes délicates : extraction, filtrage, enrichissement des métadonnées, interface, déploiement, durcissement. Un agent capable de garder l'ensemble du plan en contexte réduit tout cela à une session de prompts. La barrière pour construire des alternatives de niche et sélectionnées aux feeds des plateformes est donc tombée à peu près à « une personne motivée avec un samedi matin ».
Voici donc mon avis, et je m'y tiens : si vous gérez un produit avec un feed (une base de connaissances interne, un forum communautaire, un produit éditorial), prototypez la version sélectionnée avant de construire la version algorithmique. Commencez par des recommandations humaines explicites, filtrez-les avec une passe LLM bon marché, classez avec une fonction de score assez simple pour être expliquée lors d'un point quotidien, et gardez l'état côté client aussi longtemps que possible. Vous saurez alors si vous avez un problème d'inventaire ou de classement, et d'après mon expérience, c'est presque toujours l'inventaire. Le feed optimisé pour l'engagement est un outil qui maximise une métrique. Le feed sélectionné est un outil qui respecte une personne. Construisez le second d'abord, et ne sortez le premier que lorsque vous pouvez expliquer précisément pourquoi, et pour qui, il mérite d'exister.


