Empfehlungsfreie Feeds: Kuration statt Algorithmen
Wie du einen empfehlungsfreien Feed mit menschlicher Kuration und einfacher Suche baust statt mit aufmerksamkeitsoptimierenden Algorithmen. Lektionen von HackerTube.
 Sarah Chen

Freitag, 23 Uhr. Du bist müde, öffnest YouTube, und die Startseite begrüßt dich mit einer Wand aus schreienden Vorschaubildern, schockierten Gesichtern und denselben drei Themen, von denen der Dienst 2019 beschlossen hat, dass du sie magst. Nichts davon ist das, was du sehen willst, aber du scrollst trotzdem, denn genau dafür ist die Oberfläche gebaut. Wenn du diese ganz bestimmte Erschöpfung kennst, verstehst du schon, warum empfehlungsfreie Feeds plötzlich wieder spannend sind. Und warum ein YouTube-Klon, der aus Empfehlungen in Hacker-News-Kommentaren besteht und in etwa zwei Stunden mit einem KI-Agenten zusammengebaut wurde, zuletzt so viel Aufmerksamkeit bekommen hat.
Das Projekt heißt HackerTube: eine YouTube-artige Oberfläche über rund 6.500 Videos, die zwischen 2007 und heute in Hacker-News-Kommentaren empfohlen wurden. Keine Accounts, kein Tracking, keine Autoplay-Tricks. Der Zustand liegt im Local Storage deines Browsers. Das Ganze wurde an einem Samstagvormittag per Prompt zusammengebaut, von der Datenextraktion bis zum Deployment auf einem VPS. Ich möchte darüber sprechen, warum es so gut funktioniert, denn die Lektion reicht weit über ein einzelnes Side Project hinaus. Es funktioniert weil es im klassischen Sinne keinen Empfehlungsalgorithmus hat. Und das erweist sich als Feature, das du gezielt in deine eigenen Produkte einbauen kannst.
Warum Empfehlungsalgorithmen das Falsche optimieren
Ich habe ein paar Jahre an Ranking-Systemen gearbeitet, also sage ich den stillen Teil offen: Die Zielfunktion ist das Produkt. Ein Empfehlungssystem in Plattformgröße wird auf Engagement-Proxys trainiert, etwa Watch Time, Klickrate, Sitzungsdauer und manchmal Verweildauer, gewichtet nach Werbeimpressionen. Keine davon misst, ob der Nutzer zufrieden gegangen ist. Gemessen wird, ob er geblieben ist. Diese Größen korrelieren oft genug, dass man sich einreden kann, etwas Gutes zu bauen. Aber sie laufen genau in den Fällen auseinander, die zählen: Empörung, Reiz und das zwanzigste Video zu einem Thema, das du längst durch hast.
Das ist Goodharts Gesetz im Trenchcoat. Sobald Watch Time zum Ziel wird, misst sie nichts Relevantes mehr über Qualität. Schlimmer noch, die Rückkopplungsschleife ist geschlossen: Der Algorithmus formt, was angeklickt wird, die Klicks werden zu Trainingsdaten, und das Modell wird immer sicherer über ein immer engeres Bild von dir. Mehrere Leute haben bei HackerTube angemerkt, was ich selbst schon gespürt habe: Der nicht personalisierte Feed mit von Nerds geprüften Videos hatte eine höhere Trefferquote als YouTubes stark personalisierter. Das sollte nicht überraschen. Personalisierung leitet deinen Geschmack aus deinen schwächsten Momenten ab, was du um 23 Uhr müde angeklickt hast. Kuration dagegen kodiert Geschmack aus den stärksten Momenten anderer Menschen, nämlich dem, wofür sie sich die Mühe gemacht haben, einen Kommentar zu schreiben, um es Kollegen zu empfehlen.
Es gibt auch einen subtileren Fehlermodus. Optimierte Feeds sind hervorragend darin, dir mehr von dem zu zeigen, was du ohnehin schon kennst. Aber ein großer Teil des Grundes, warum Leute überhaupt stöbern, ist Horizonterweiterung: auf etwas Überraschendes zu stoßen, das dein Weltbild neu justiert. Engagement-Optimierung hat kein Gradientensignal für Überraschungen, die sich erst später auszahlen. Sie weiß nur, ob du geblieben bist. Aus demselben Grund habe ich schon argumentiert, dass KI-Benchmarks den größten Teil echter Arbeit verfehlen: Der messbare Proxy driftet von dem weg, was du eigentlich wolltest, und die Drift summiert sich.
Menschliche Kuration als Korpus: Hacker-News-Kommentare auswerten
Woher bekommt also ein empfehlungsfreier Feed seine Inhalte? HackerTubes Antwort ist clever, weil sie ein bestehendes, hochwertiges Signal wiederverwendet: zwei Jahrzehnte Hacker-News-Kommentare. Die Pipeline ist einfach zu beschreiben. Man lädt alle öffentlichen HN-Kommentare herunter (sie sind über die offizielle API und Community-Datensätze verfügbar). Man filtert auf Kommentare mit YouTube-Links, etwa 40.000 Stück. Dann läuft ein günstiges LLM über jeden Kommentar und beantwortet eine Frage: Empfiehlt diese Person das Video tatsächlich, oder handelt es sich um Spam, einen beiläufigen Link oder jemanden, der das Video zitiert, um sich darüber lustig zu machen? Dieser Filterschritt reduziert den Korpus auf rund 6.500 Videos in 150 Themen-Clustern.
Zwei Designentscheidungen sind es wert, übernommen zu werden. Erstens ist der Klassifizierungsschritt genau die Art begrenzter Urteilsaufgabe, in der LLMs stark sind: ein Ja/Nein mit kurzer Begründung, im großen Maßstab für Kleingeld. Es ist dasselbe Muster wie Constrained Decoding, um LLMs in schnelle Entscheidungsmodelle zu verwandeln: Man lässt das Modell nicht generieren, sondern filtern. Zweitens hat der Korpus eine eingebaute Qualitätsschwelle. Jedes Video wurde von einem Menschen schriftlich empfohlen, vor einem Publikum, das Unsinn abstraft. Dieser Filtermechanismus lässt sich mit keinem Engagement-Modell nachbauen, weil er auf Reputation beruht und nicht auf Klicks.
Eine Empfehlung in einem Kommentar ist eine Person, die ihre Reputation aufs Spiel setzt. Ein Klick ist ein Reflex. Feeds, die auf dem Ersten aufbauen, fühlen sich anders an, weil sie tatsächlich anders sind.
Es gibt auch eine zeitliche Dimension, die wichtig ist. Diese Empfehlungen reichen von 2007 bis heute. Deshalb besteht der Korpus überwiegend aus Inhalten mit Langzeitwirkung, also Vorlesungen, tiefe technische Vorträge und ausführliche Interviews, statt aus dem, was der Algorithmus diese Woche pusht. Ein Detail kam besonders gut an: eine Kategorie „Longs“ für lange Videos. Auf YouTube ist ein 90-minütiger Vortrag ein Risiko, das der Empfehlungsalgorithmus mit deiner Sitzung eingeht. Auf HackerTube ist er ein Feature, weil daneben jemand geschrieben hat: „Das hat meine Sicht auf Compiler verändert.“
Einfaches Retrieval schlägt schlaues Ranking
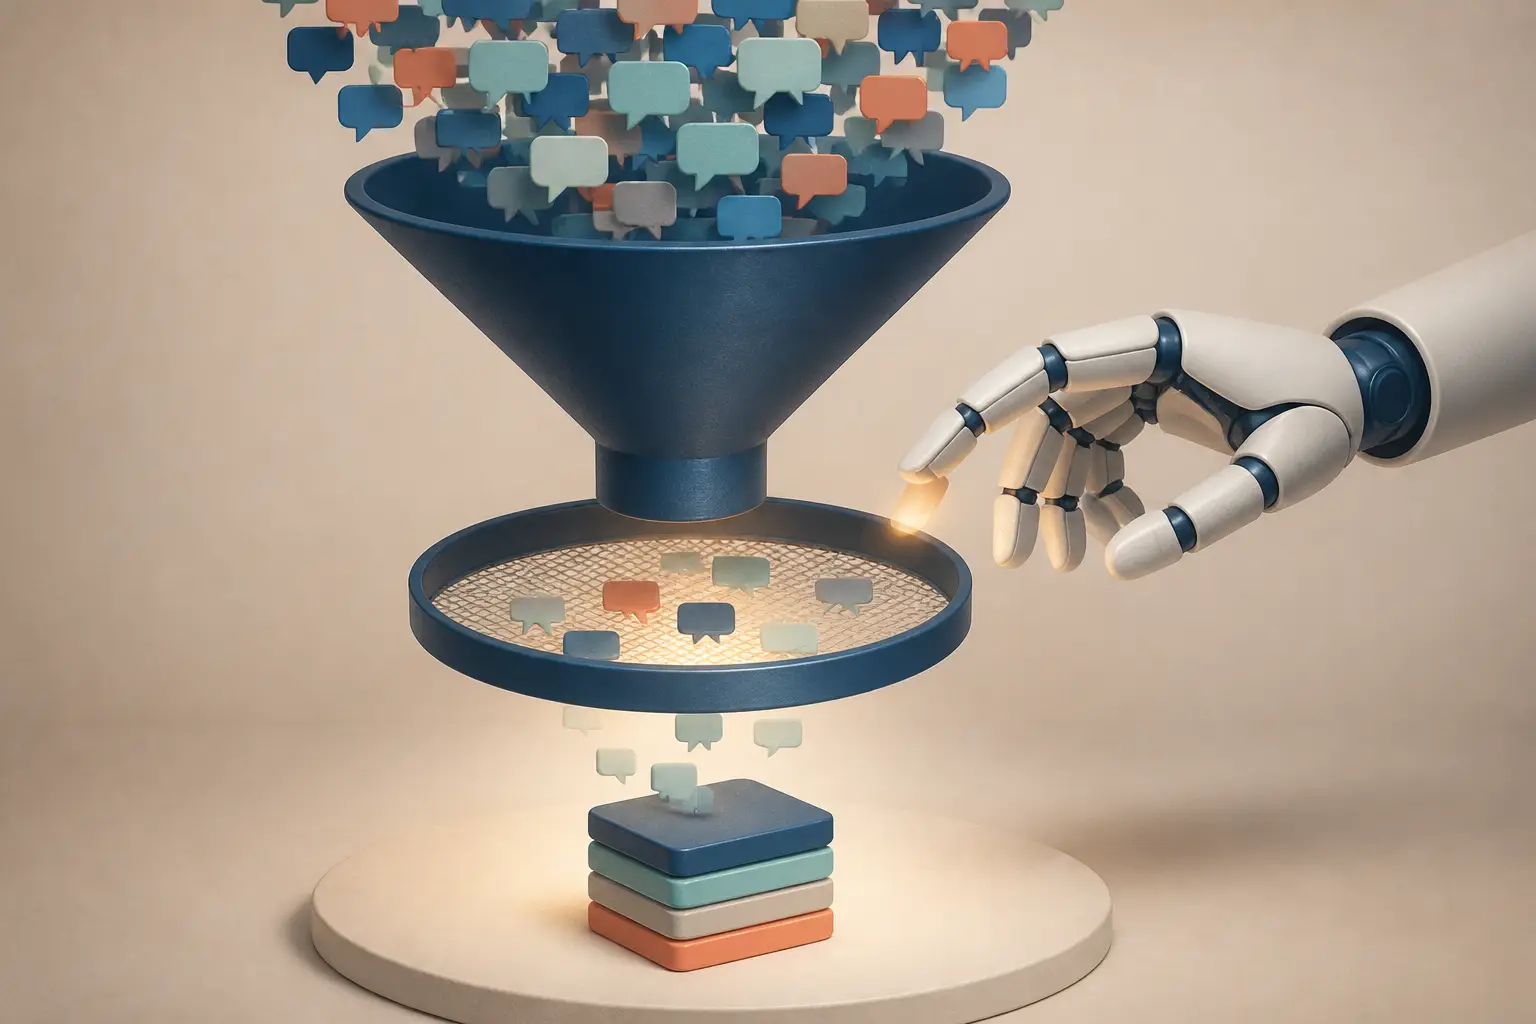
Hier ist der Teil, der sich wie Ketzerei anfühlen wird, wenn du im Recsys-Bereich gearbeitet hast: Sobald dein Korpus klein und gut ist, spielt das Ranking kaum noch eine Rolle. Sechstausend Videos sind nichts. Du brauchst kein Two-Tower-Embedding-Modell und keine Re-Ranking-Kaskade. Du brauchst Themen-Tags, Aktualität und eine leichte Personalisierung, die client-seitig läuft. HackerTubes „For You“ arbeitet mit dem Sitzungszustand im Local Storage, also mit dem, was du in diesem Browser angesehen und übersprungen hast, ohne Account und ohne serverseitiges Profil. Das ist keine Einschränkung. Es ist eine Architekturentscheidung, die eine ganze Klasse schlechter Anreize eliminiert: Wenn du kein Nutzerverhalten speicherst, kannst du auch nicht versucht sein, dagegen zu optimieren.
Wenn du eine eigene Version davon bauen willst, etwa einen Feed mit Papers, Konferenzvorträgen, Blogposts oder was deine Community eben empfiehlt, passt die Ranking-Logik in ein paar Dutzend Zeilen. So sieht die Grundform aus:
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]
Auffällig ist, was fehlt: kein Verweildauer-Feature, keine Engagement-Geschwindigkeit, kein Explore-Exploit-Bandit, der deinen Kipppunkt herausfinden will. Die Personalisierungssignale sind explizit (Fertig gesehen und Übersprungen, bestimmt durch dein eigenes Verhalten in dieser Sitzung) und begrenzt (ein paar Punkte jeweils, leicht überstimmt vom Qualitätsterm des Korpus). Der Algorithmus kann anstupsen, aber er kann dich nicht einsperren. Diese Asymmetrie ist in einer Scoring-Funktion die ganze Philosophie.
Auch die Entscheidung bei den Vorschaubildern verdient Erwähnung, weil sie ein sauberes Beispiel dafür ist, eine Oberfläche bewusst zu de-optimieren. YouTube-Creator testen Thumbnails per A/B-Test bis zur Erschöpfung, sodass das Thumbnail selbst zu einem adversarialen Artefakt wurde. HackerTube ignoriert das hochgeladene Thumbnail und nimmt stattdessen das Bild bei 50 % der Videolänge. Das ist eine Änderung von einer Zeile, die das Clickbait-Wettrüsten komplett beseitigt. Die Vorschau zeigt dir, was das Video tatsächlich ist, und nicht, was der Creator glaubt, dass dich zum Klicken bringt.
Feeds ohne Accounts und Tracking gestalten
Den Zustand auf den Client zu verlagern, ändert mehr als deine Datenschutzhaltung. Es ändert deine Kostenstruktur und deine rechtliche Angriffsfläche. Ohne Nutzerkonten gibt es kein Auth-System, keine Passwort-Resets, keine DSGVO-Auskunftsmechanik und keine Haftung bei Datenlecks mit Verhaltensprofilen. Dein Backend ist ein statischer Dateiserver und vielleicht eine winzige API. Die ganze Seite kann ein Build-Artefakt sein. Wenn deine Architektur gar keine Nutzerdaten ansammeln kann, werden die meisten Dark Patterns physisch unmöglich, statt nur durch Richtlinien verboten zu sein. Diese Art von Garantie halte ich für weit vertrauenswürdiger als jede Datenschutzerklärung.
Der ehrliche Kompromiss: Lokaler Zustand ist flüchtig und an das Gerät gebunden. Löschst du deine Browserdaten, wird dein Feed zurückgesetzt. Eine geräteübergreifende Kontinuität gibt es nicht. Für eine entspannte Video-Seite ist das in Ordnung. Ich würde sogar argumentieren, dass der Reset gelegentlich gesund ist. Für alles, wo Nutzer langfristige Sammlungen aufbauen, brauchst du eine Export- und Import-Funktion als Notausgang. Und genau dabei landen wir bei der zukunftsweisendsten Entscheidung im ganzen Projekt.
Daten als Oberfläche: einen forkbaren Korpus ausliefern
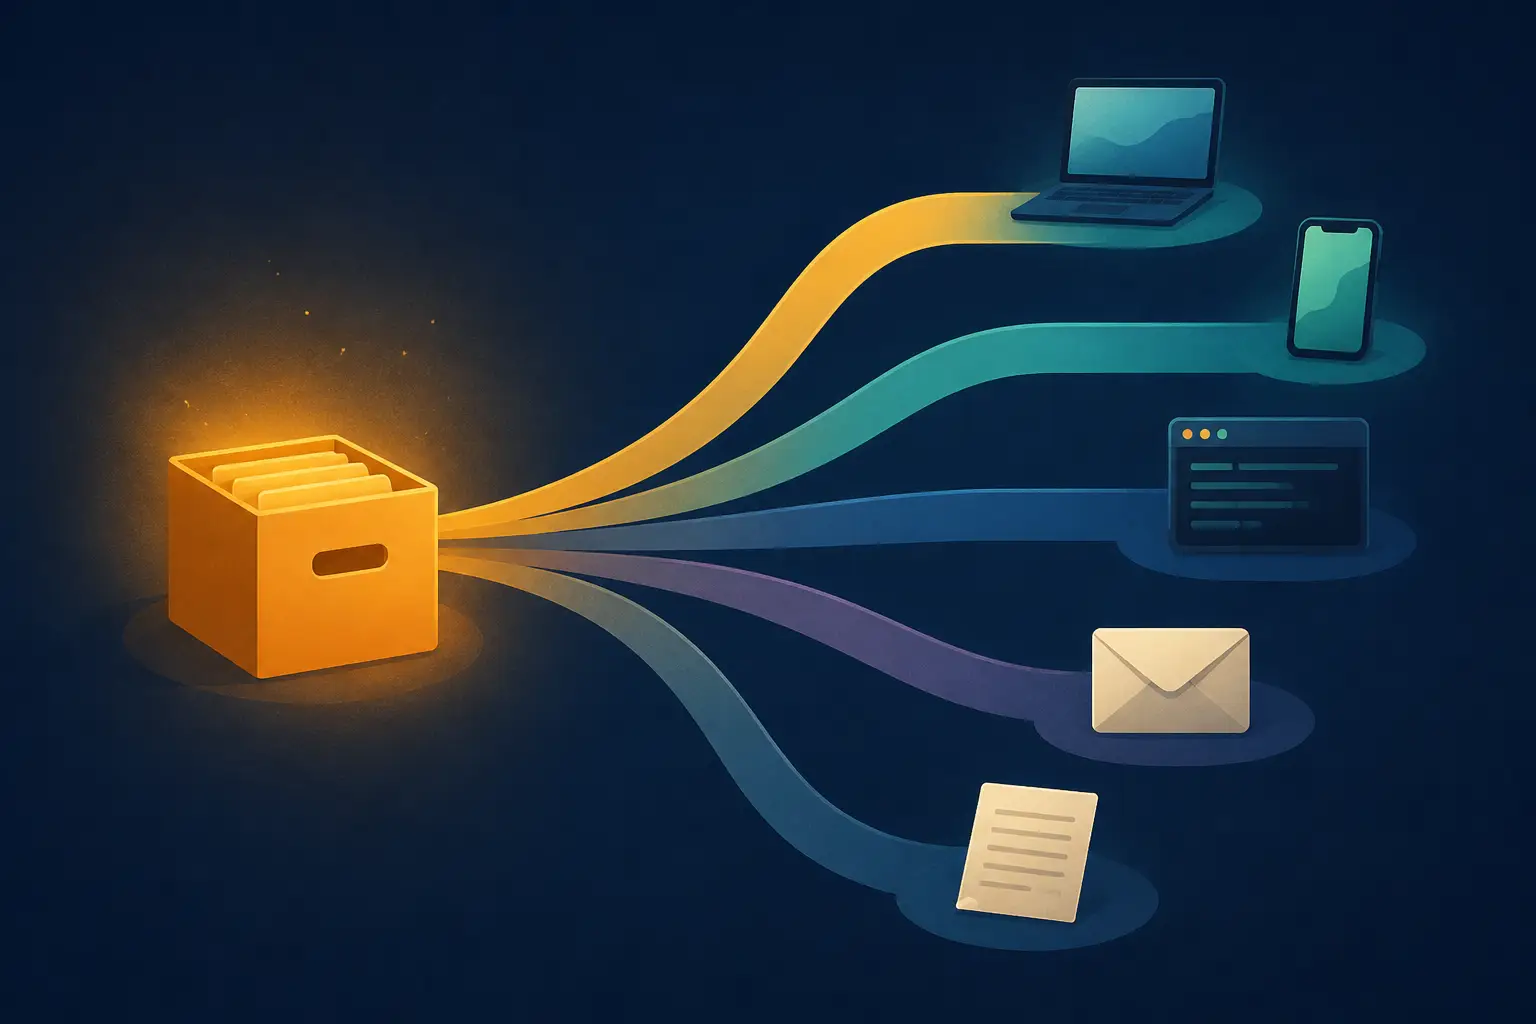
Der Teil von HackerTube, den ich wirklich neuartig finde, ist nicht die UI. Es ist, dass der gesamte Datensatz hinter der Seite als ZIP-Datei herunterladbar ist, inklusive einer DATA.md, die ausdrücklich für KI-Agenten geschrieben wurde. Sie dokumentiert, wie die Dateien zusammenpassen, nennt die Stolpersteine, enthält Beispieldatensätze und erklärt, wie man frische Metadaten abruft. Der vorgesehene Workflow: Du gibst das ZIP deinem Coding-Agenten und sagst „Bau mir einen wöchentlichen E-Mail-Newsletter mit Vorträgen zu meinen Themen“ oder „Bau mir einen Terminal-Client dafür“. Das Produkt ist nicht die Website. Das Produkt ist der kuratierte Korpus, und die Website ist nur der Referenz-Renderer.
Das ist ein Muster, von dem ich glaube, dass wir es weitaus häufiger sehen werden. Zwei Jahrzehnte lang lautete der Standardrat: „Stell eine API bereit.“ Aber eine API macht dich weiterhin zum Torwächter aller Abfragen, und sie verrottet, sobald du aufhörst, sie zu pflegen. Ein portabler, für Agenten lesbarer Datensatz dreht das Verhältnis um: Du veröffentlichst die Sache einmal, gut dokumentiert, und lässt tausend personalisierte Frontends entstehen. Das passt zum Geist des Small Web, bei dem Entdeckung auf Menschen beruht, die auf Dinge verlinken, die sie gut finden, statt auf Plattformen, die entscheiden, was du siehst. Nur eben angepasst an eine Welt, in der der erste Konsument deiner Daten ein Sprachmodell sein könnte.
Dokumentation für Agenten zu schreiben, ist ein eigenes, gerade entstehendes Handwerk. Menschen überfliegen Texte, Agenten lesen wörtlich und vollständig und stolpern über implizite Annahmen, die ein Mensch erschließen würde. Eine gute DATA.md nennt Einheiten, Null-Werte, Kodierungseigenheiten und Fehlermodi gleich zu Beginn. Wenn du Datensätze veröffentlichst, ist das inzwischen Grundausstattung. Es ist der Unterschied, ob ein Agent in einem Durchgang einen funktionierenden Fork erzeugt oder ein Schema halluziniert.
Die ehrlichen Grenzen kuratierter Feeds
Ich habe dir Pragmatismus statt Hype versprochen, also hier die scharfen Kanten. Erstens: Ein kuratierter Korpus erbt die Verzerrungen seiner Kuratoren. Hacker News ist eine bestimmte Zielgruppe mit eigenem Geschmack. Das Ergebnis ist „100 % reiner Nerd-Content“, was großartig ist, wenn du zur Zielgruppe gehörst, und unsichtbar, wenn nicht. Dieser Ansatz skaliert nicht auf „alle“, und er versucht es auch nicht. Er ist eine Kneipe, kein Versorgungsbetrieb.
- Veralten: Ein eingefrorener Snapshot verfällt. Du brauchst einen geplanten Job, der die Extraktions-Pipeline erneut laufen lässt, sonst wird der Feed leise zum Museum.
- Plattformabhängigkeit: Die Videos liegen weiterhin auf YouTube. Löschungen, Regionssperren und ToS-Änderungen lassen deinen Korpus von unten verrotten. Verfolge tote Links, sonst verlierst du Vertrauen.
- Zielgruppen-Bindung: Wer empfiehlt, legt den Geschmack fest. Für eine Community-Seite ist das in Ordnung. Wenn du es aber als neutrale Entdeckung verkaufst, wird es zu einem ernsten Verzerrungsproblem.
- Obergrenze bei Frische: Brandneue, großartige Inhalte haben noch keine Empfehlungen. Kuratierte Feeds vernachlässigen systematisch das Neue, und genau diese Lücke füllen Engagement-Algorithmen, zum Guten wie zum Schlechten.
Dieser letzte Punkt ist der, der mich bei diesem ganzen Ansatz ehrlich hält. Engagement-Feeds und kuratierte Feeds sind keine Feinde. Sie sind auf unterschiedliche Zeithorizonte optimiert. Kuration zeigt dir, was sich bewährt hat. Engagement-Ranking zeigt im besten Fall, was wertvoll werden könnte. Die gesunde Version von YouTubes Empfehlungssystem würde stark nach dem Korpus von HackerTube aussehen, mit einer kleinen, klar gekennzeichneten Spur für „neu und noch unbewiesen“. Die Tragödie ist nicht, dass es Empfehlungsalgorithmen gibt. Die Tragödie ist, dass das Geschäftsmodell verlangt, sie zur gesamten Oberfläche zu machen.
Wann du das selbst bauen solltest
Die Bauzeit von zwei Stunden ist die Geschichte in der Geschichte. Dieses Projekt wäre vor fünf Jahren in diesem Tempo nicht machbar gewesen. Nicht weil ein einzelner Schritt schwer wäre, sondern weil es rund vierzig fummelige Schritte gibt: Extraktion, Filterung, Anreicherung der Metadaten, UI, Deployment, Härtung. Ein Agent, der den ganzen Plan im Kontext halten kann, verdichtet das zu einer Prompt-Session. Damit ist die Hürde, nischige, kuratierte Alternativen zu Plattform-Feeds zu bauen, auf ungefähr „eine motivierte Person mit einem Samstagvormittag“ gesunken.
Also hier meine Meinung, und ich stehe dazu: Wenn du ein Produkt mit einem Feed betreibst, etwa eine interne Wissensdatenbank, ein Community-Forum oder ein Content-Produkt, dann solltest du die kuratierte Version prototypen, bevor du die algorithmische baust. Fang mit expliziten menschlichen Empfehlungen an, filtere sie mit einem günstigen LLM-Durchlauf, ranke mit einer Scoring-Funktion, die einfach genug ist, um sie im Stand-up zu erklären, und halte den Zustand so lange wie möglich client-seitig. So erfährst du, ob du wirklich ein Inventarproblem oder ein Ranking-Problem hast, und nach meiner Erfahrung ist es fast immer das Inventar. Der engagement-optimierte Feed ist ein Werkzeug, um eine Kennzahl zu maximieren. Der kuratierte Feed ist ein Werkzeug, um einen Menschen zu respektieren. Bau zuerst den zweiten, und greif nur dann zum ersten, wenn du genau benennen kannst, warum und für wen er existieren sollte.


