Feeds sem Algoritmo de Recomendação: Curadoria Humana
Como montar um feed sem recomendação algorítmica usando curadoria humana e busca simples, em vez de algoritmos de engajamento. Lições do HackerTube.
 Sarah Chen

São 23h de uma sexta-feira. Você está cansado, abre o YouTube, e a página inicial recebe você com uma parede de miniaturas gritantes, rostos chocados e os mesmos três temas que ele decidiu que você gostava em 2019. Nada ali é o que você quer, mas você rola a tela mesmo assim, porque rolar é justamente para o que a interface foi feita. Se você já sentiu esse tipo específico de exaustão, já entende por que feeds sem recomendação voltaram a chamar atenção — e por que um clone do YouTube montado a partir de recomendações nos comentários do Hacker News, feito em cerca de duas horas com um agente de IA, ganhou tanta atenção recentemente.
O projeto em questão é o HackerTube: uma interface no estilo YouTube sobre cerca de 6.500 vídeos que foram recomendados em comentários do Hacker News entre 2007 e hoje. Sem contas, sem rastreamento, sem manipulações de autoplay. O estado fica no local storage do navegador. Tudo isso foi gerado por prompt em uma sessão de sábado de manhã, da extração de dados até o deploy em uma VPS. Quero falar sobre por que ele funciona tão bem, porque a lição vai muito além de um projeto paralelo divertido. Ele funciona porque não tem um algoritmo de recomendação no sentido convencional — e isso acaba sendo uma característica que você pode projetar de propósito nos seus próprios produtos.
Por que os algoritmos de recomendação otimizam a coisa errada
Passei alguns anos trabalhando com sistemas de ranqueamento, então vou falar claramente o que ninguém diz: a função objetivo é o produto. Um recomendador em escala de plataforma é treinado com proxies de engajamento — tempo assistido, taxa de cliques, duração da sessão, às vezes tempo de permanência ponderado por impressões de anúncios. Nenhum deles mede “o usuário saiu satisfeito?”. Eles medem “o usuário ficou?”. Essas métricas se correlacionam com frequência suficiente para você se convencer de que está construindo algo bom, mas divergem exatamente nos casos que importam: indignação, apelo sensacionalista e o vigésimo vídeo sobre um assunto que você já esgotou.
Isso é a lei de Goodhart de sobretudo. Quando o tempo assistido vira a meta, ele deixa de medir qualquer coisa sobre qualidade. Pior: o ciclo de feedback é fechado. O algoritmo molda o que é clicado, os cliques viram dados de treinamento, e o modelo fica cada vez mais confiante sobre um retrato cada vez mais estreito de você. Várias pessoas que reagiram ao HackerTube comentaram algo que eu também já senti: o feed não personalizado de vídeos selecionados por nerds tinha uma taxa de acerto maior que o do YouTube, altamente personalizado. Isso não deveria surpreender. A personalização infere seu gosto a partir dos seus momentos mais fracos (o que você clicou às 23h, cansado), enquanto a curadoria codifica o gosto a partir dos momentos mais fortes das pessoas (quando elas se deram ao trabalho de escrever um comentário recomendando algo para os colegas).
Há também um modo de falha mais sutil: feeds otimizados são extremamente bons em mostrar mais do que você já conhece. Mas uma boa parte do motivo para as pessoas navegarem é a expansão de horizonte — encontrar algo surpreendente que recalibra o seu modelo de mundo. A otimização de engajamento não tem sinal de gradiente para surpresas que compensam depois. Ela só sabe se você ficou. É o mesmo motivo pelo qual já argumentei que os benchmarks de IA deixam de fora a maior parte do trabalho real: o proxy mensurável se afasta daquilo que você realmente queria, e o desvio se acumula.
Curadoria humana como corpus: mineração de comentários do Hacker News
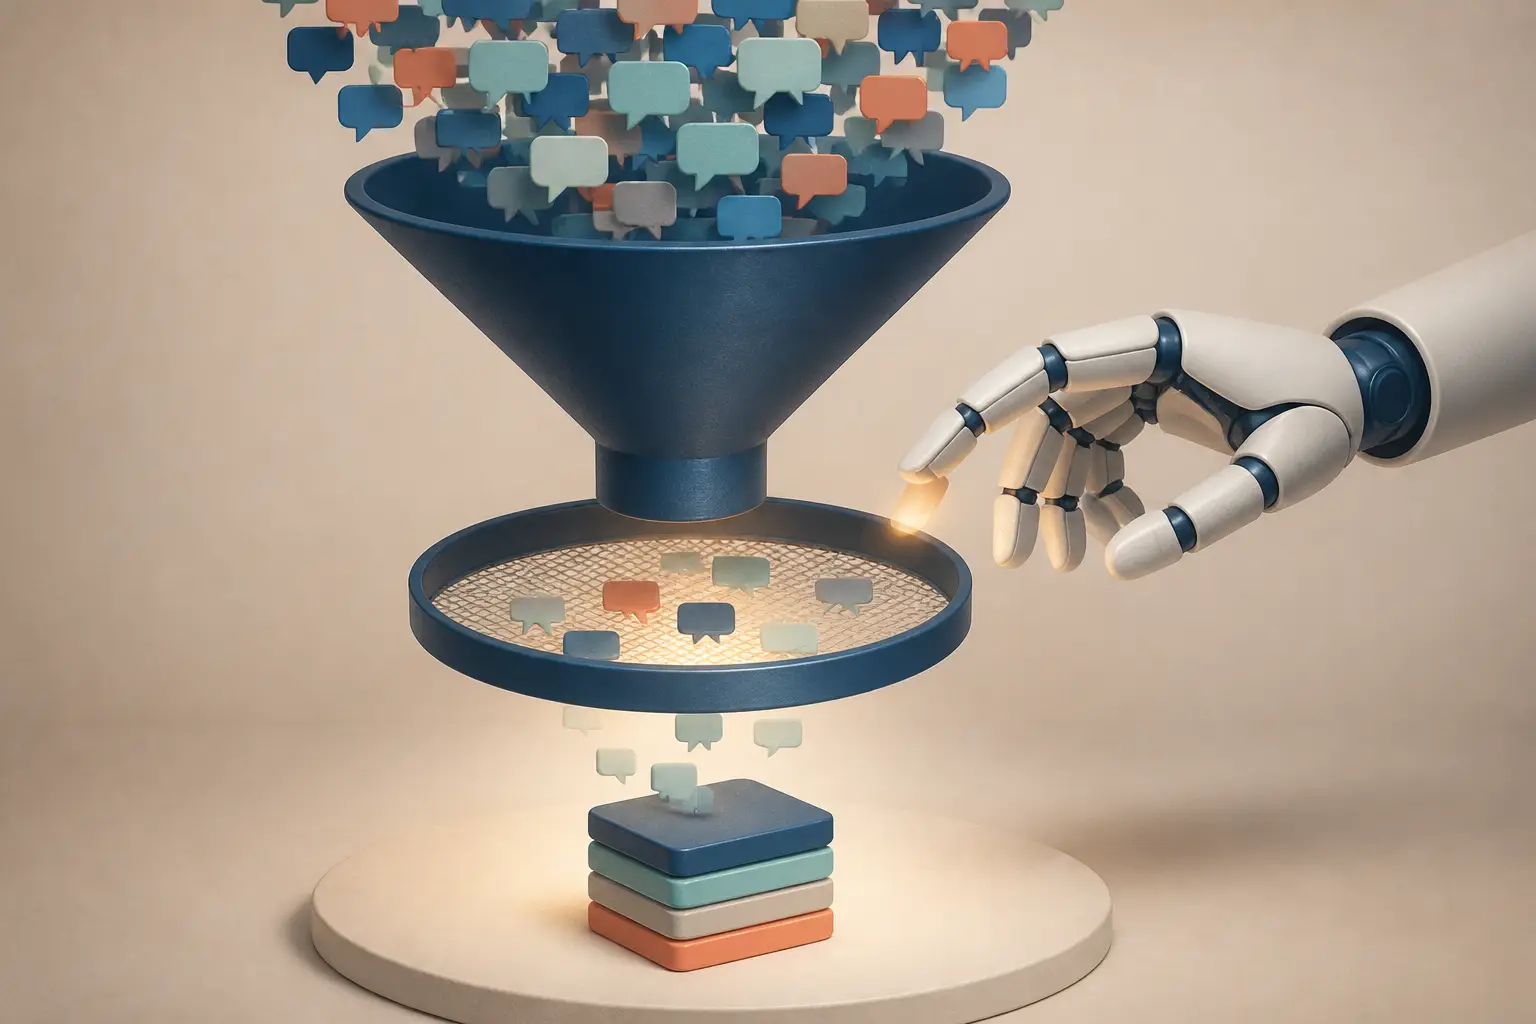
Então, de onde um feed sem recomendação tira seu inventário? A resposta do HackerTube é esperta porque reaproveita um sinal existente e de alta qualidade: duas décadas de comentários do Hacker News. O pipeline é simples de descrever. Baixe todos os comentários públicos do HN (estão disponíveis pela API oficial e por datasets da comunidade). Filtre os comentários que contêm links do YouTube — cerca de 40.000. Depois, rode uma passagem com um LLM mais barato em cada comentário para responder a uma pergunta: a pessoa está de fato recomendando esse vídeo, ou é spam, um link de passagem, ou alguém citando o vídeo para zombar dele? Essa etapa de filtragem reduz o corpus a cerca de 6.500 vídeos distribuídos em 150 clusters temáticos.
Duas decisões de design merecem ser copiadas. Primeiro, a etapa de classificação é exatamente o tipo de tarefa de julgamento delimitado em que LLMs são excelentes — um sim/não com uma justificativa curta, aplicado em escala por centavos. É o mesmo padrão de usar decodificação restrita para transformar LLMs em modelos de decisão rápidos: não peça ao modelo para gerar, peça para filtrar. Segundo, o corpus tem um piso de qualidade embutido. Cada vídeo foi validado por um humano, por escrito, diante de uma audiência que derruba besteira com downvote. É um mecanismo de filtragem que nenhum modelo de engajamento consegue replicar, porque se apoia em reputação, não em cliques.
Uma recomendação escrita em um comentário é uma pessoa apostando a própria reputação. Um clique é um reflexo. Feeds construídos sobre o primeiro se sentem diferentes porque são diferentes.
Também existe uma dimensão de tempo que importa. Essas recomendações vão de 2007 até hoje, o que significa que o corpus é dominado por conteúdo com fôlego duradouro — palestras, talks técnicos profundos, entrevistas longas — em vez do que o algoritmo está impulsionando nesta semana. Um detalhe que as pessoas adoraram: uma categoria “Longs” para vídeos longos. No YouTube, uma palestra de 90 minutos é um risco que o recomendador assume com a sua sessão. No HackerTube, isso é um recurso, porque alguém escreveu “isso mudou a forma como penso sobre compiladores” logo ao lado.
Recuperação simples vence ranqueamento inteligente
Aqui está a parte que vai soar herética se você já trabalhou com recsys: quando o corpus é pequeno e bom, o ranqueamento quase não importa. Seis mil vídeos é pouco. Você não precisa de um modelo de embeddings two-tower nem de uma cascata de re-ranqueamento; precisa de tags de tópico, recência e uma passagem leve de personalização rodando no cliente. O “Para Você” do HackerTube funciona com base no estado da sessão no local storage — o que você assistiu e pulou neste navegador — sem conta e sem perfil no servidor. Isso não é uma limitação. É uma decisão de arquitetura que elimina toda uma classe de incentivos ruins: se você não armazena o comportamento do usuário, não pode ser tentado a otimizar em cima dele.
Se você quiser construir sua própria versão disso — um feed de artigos, palestras de conferências, posts de blog, o que a sua comunidade recomendar —, a lógica de ranqueamento cabe em algumas dezenas de linhas. Esta é a forma geral:
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]
Repare no que não está lá: nenhuma feature de tempo de permanência, nenhuma velocidade de engajamento, nenhum bandit de exploração-exploração tentando descobrir o seu ponto de ruptura. Os sinais de personalização são explícitos (vídeos terminados e pulados, escolhidos pelo próprio comportamento do usuário nesta sessão) e limitados (uns poucos pontos cada, facilmente superados pelo termo de qualidade do corpus). O algoritmo pode empurrar; não pode prender. Essa assimetria é toda a filosofia em uma única função de pontuação.
A decisão sobre a miniatura também merece menção, porque é um exemplo limpo de desotimizar uma interface. Criadores do YouTube fazem testes A/B de miniaturas até a exaustão, então a miniatura em si virou um artefato adversarial. O HackerTube ignora a miniatura enviada e usa o quadro aos 50% do vídeo. É uma mudança de uma linha que elimina por completo a corrida armamentista do clickbait — a prévia mostra o que o vídeo realmente é, e não o que o criador acha que vai fazer você clicar.
Projetando feeds sem contas nem rastreamento
Mover o estado para o cliente muda mais do que a sua postura de privacidade — muda a sua estrutura de custos e a sua superfície jurídica. Sem contas de usuário não existe sistema de autenticação, nem redefinição de senha, nem a burocracia de acesso a dados da LGPD/GDPR, nem responsabilidade por vazamento de perfis comportamentais. Seu backend é um servidor de arquivos estáticos e talvez uma API minúscula. O site inteiro pode ser um artefato de build. Quando a arquitetura não consegue acumular dados de usuários, a maioria dos dark patterns se torna fisicamente impossível, e não apenas proibida por política. Acho esse tipo de garantia muito mais confiável do que qualquer política de privacidade.
O trade-off honesto: o estado local é efêmero e preso ao dispositivo. Limpe os dados do navegador e seu feed reseta. Não há continuidade entre dispositivos. Para um site de vídeo para assistir relaxado, tudo bem — eu diria que o reset é, às vezes, até saudável. Para qualquer coisa em que os usuários montem coleções de longo prazo, você vai querer uma saída de exportação/importação, que convenientemente nos leva à decisão mais voltada para o futuro de todo o projeto.
Dados como interface: distribuindo um corpus que pode ser feito fork
A parte do HackerTube que considero genuinamente nova não é a UI — é que todo o dataset por trás do site pode ser baixado como um zip que inclui um DATA.md escrito especificamente para agentes de IA. Ele documenta como os arquivos se encaixam, as armadilhas, registros de exemplo e como buscar metadados atualizados. O fluxo pretendido: entregue o zip ao seu agente de programação e diga “monte um e-mail semanal com palestras sobre os meus temas” ou “crie um cliente de terminal para isso”. O produto não é o site. O produto é o corpus curado, e o site é só o renderizador de referência.
Este é um padrão que acho que vamos ver muito mais. Por duas décadas, o conselho padrão era “exponha uma API”. Mas uma API ainda faz de você o porteiro das consultas, e apodrece no momento em que você para de mantê-la. Um dataset portátil e legível por agentes inverte a relação: você publica a coisa uma vez, bem documentada, e deixa mil frontends personalizados florescerem. Isso combina com a ética da pequena web — descoberta construída sobre pessoas linkando coisas que amaram, e não sobre plataformas decidindo o que você vê — atualizada para um mundo em que o primeiro consumidor dos seus dados pode ser um modelo de linguagem.
Escrever documentação para agentes é um ofício novo em formação. Humanos dão uma olhada por cima; agentes leem de forma literal e completa, e tropeçam em suposições implícitas que um humano inferiria. Um bom DATA.md declara unidades, nulabilidade, peculiaridades de codificação e modos de falha logo no início. Se você publica datasets, isso agora é requisito mínimo — a diferença entre um agente que produz um fork funcional em uma única passada e um que alucina um schema.
As limitações honestas dos feeds curados
Prometi pragmatismo em vez de hype, então aqui estão as arestas cortantes. Primeiro: um corpus curado herda os vieses de seus curadores. O Hacker News é um público demográfico específico com um gosto específico — o resultado é “conteúdo nerd 100% puro”, delicioso se você é o público-alvo e invisível se não for. Essa abordagem não escala para “todo mundo”, e nem tenta. É um bar, não uma utilidade pública.
- Obsolescência: um snapshot congelado apodrece. Você precisa de um job agendado rodando o pipeline de extração de novo, ou o feed vira discretamente um museu.
- Dependência de plataforma: os vídeos continuam hospedados no YouTube. Exclusões, bloqueios regionais e mudanças nos termos de uso vão apodrecer o seu corpus por baixo. Monitore links mortos ou perca a confiança.
- Aprisionamento demográfico: quem faz as recomendações define o gosto. Tudo bem para um site de comunidade; um sério problema de viés se você apresentá-lo como descoberta neutra.
- Teto de frescor: conteúdo novo e ótimo ainda não tem recomendações. Feeds curados deixam sistematicamente o novo de lado, justamente a lacuna que os algoritmos de engajamento preenchem — para o bem e para o mal.
Esse último ponto é o que me mantém honesto sobre essa abordagem toda. Feeds de engajamento e feeds curados não são inimigos; eles são otimizados para horizontes de tempo diferentes. A curadoria mostra o que se provou valioso. O ranqueamento por engajamento, na melhor das hipóteses, mostra o que pode vir a ser valioso. A versão saudável do recomendador do YouTube se pareceria muito com o corpus do HackerTube, com uma faixa pequena e claramente rotulada de “novo e não testado”. A tragédia não é que algoritmos de recomendação existam — é que o modelo de negócio exige que eles sejam a interface inteira.
Quando você deve construir isso sozinho
O tempo de duas horas de build é a história dentro da história. Este projeto não era viável nessa velocidade cinco anos atrás — não porque qualquer etapa isolada seja difícil, mas porque há quarenta passos chatos: extração, filtragem, enriquecimento de metadados, UI, deploy, endurecimento de segurança. Um agente capaz de manter o plano inteiro no contexto transforma tudo isso em uma sessão de prompts. Isso significa que a barreira para construir alternativas nichadas e curadas aos feeds das plataformas caiu para algo como “uma pessoa motivada com uma manhã de sábado”.
Então aqui está a minha posição, e vou me comprometer com ela: se você mantém qualquer produto com feed — uma base de conhecimento interna, um fórum de comunidade, um produto de conteúdo —, deveria prototipar a versão curada antes de construir a algorítmica. Comece com recomendações humanas explícitas, filtre com uma passagem barata de LLM, ranqueie com uma função de pontuação simples o bastante para explicar numa daily, e mantenha o estado no cliente enquanto puder. Você vai descobrir se tem um problema de inventário ou de ranqueamento, e na minha experiência quase sempre é inventário. O feed otimizado para engajamento é uma ferramenta para maximizar uma métrica. O feed curado é uma ferramenta para respeitar uma pessoa. Construa o segundo primeiro, e só recorra ao primeiro quando conseguir articular exatamente por que — e para quem — ele merece existir.


