रिकमेंडेशन-फ्री फ़ीड: एल्गोरिदम से बेहतर क्यूरेशन
एंगेजमेंट एल्गोरिदम की जगह इंसानी क्यूरेशन और सरल रिट्रीवल से रिकमेंडेशन-फ्री फ़ीड कैसे बनाएँ, HackerTube के अनुभव से सीखें।
 Sarah Chen

शुक्रवार रात के 11 बजे हैं। आप थके हुए हैं, YouTube खोलते हैं, और होमपेज पर चीखते थंबनेल, हैरान चेहरों की भीड़ और वही तीन विषय दिखते हैं जिन्हें उसने 2019 में आपकी पसंद मान लिया था। इनमें से कुछ भी आप देखना नहीं चाहते, फिर भी आप स्क्रॉल करते रहते हैं, क्योंकि इंटरफ़ेस बनाया ही इसलिए गया है। अगर आपने कभी यह खास किस्म की थकान महसूस की है, तो आप समझ सकते हैं कि रिकमेंडेशन-फ्री फ़ीड अचानक इतनी दिलचस्प क्यों लगने लगी हैं। और यही वजह है कि Hacker News की कमेंट्स में सुझाए गए वीडियो से बना एक YouTube-जैसा क्लोन, जिसे एक AI एजेंट की मदद से लगभग दो घंटे में खड़ा किया गया, हाल में इतना चर्चा में आया।
यह प्रोजेक्ट HackerTube है: एक YouTube-जैसा इंटरफ़ेस, जिसके पीछे लगभग 6,500 वीडियो हैं जिन्हें 2007 से अब तक Hacker News के कमेंट्स में सुझाया गया था। इसमें कोई अकाउंट नहीं, कोई ट्रैकिंग नहीं, और ऑटोप्ले के कोई चालाकी भरे तरीके नहीं हैं। स्टेट आपके ब्राउज़र के लोकल स्टोरेज में रहती है। पूरी चीज़ एक शनिवार सुबह की प्रॉम्प्टिंग सेशन में बनी, डेटा निकालने से लेकर VPS पर डिप्लॉयमेंट तक। मैं इस पर बात करना चाहता हूँ कि यह इतनी अच्छी तरह काम क्यों करता है, क्योंकि इसका सबक एक मज़ेदार साइड प्रोजेक्ट से कहीं आगे तक लागू होता है। यह इसलिए काम करता है क्योंकि इसमें पारंपरिक अर्थ में कोई रिकमेंडेशन एल्गोरिदम नहीं है, और यह एक ऐसी खूबी है जिसे आप अपने प्रोडक्ट्स में जानबूझकर डिज़ाइन कर सकते हैं।
रिकमेंडेशन एल्गोरिदम गलत चीज़ को ऑप्टिमाइज़ क्यों करते हैं
मैंने कुछ साल रैंकिंग सिस्टम पर काम किया है, इसलिए वह बात साफ़ कहता हूँ जिसे लोग अक्सर दबा जाते हैं: प्रोडक्ट का असली उद्देश्य ही ऑब्जेक्टिव फ़ंक्शन है। प्लेटफ़ॉर्म-स्केल रिकमेंडर एंगेजमेंट प्रॉक्सी पर ट्रेन होता है, जैसे वॉच टाइम, क्लिक-थ्रू रेट, सेशन की लंबाई, और कभी-कभी विज्ञापन इंप्रेशन से भारित डवेल टाइम। इनमें से कोई भी “क्या यूज़र संतुष्ट होकर गया?” को नहीं मापता। वे सिर्फ़ यह मापते हैं कि “यूज़र रुका या नहीं।” ये मेट्रिक्स अक्सर इतने आपस में जुड़े होते हैं कि आपको लगने लगता है आप कुछ अच्छा बना रहे हैं, लेकिन ये ठीक उन्हीं मामलों में अलग हो जाते हैं जो सबसे ज़रूरी हैं: गुस्सा, सनसनी, और किसी विषय पर बीसवाँ वीडियो जिसे आप पहले ही खत्म कर चुके हैं।
यह Goodhart’s law है, बस ट्रेंच कोट पहने हुए। एक बार वॉच टाइम टारगेट बन जाए, तो वह क्वालिटी के बारे में कुछ भी मापना बंद कर देता है। इससे भी बुरी बात यह है कि फ़ीडबैक लूप बंद हो जाता है: एल्गोरिदम तय करता है कि क्या क्लिक होगा, क्लिक ट्रेनिंग डेटा बन जाते हैं, और मॉडल आपकी एक धीरे-धीरे संकरी होती तस्वीर को लेकर ज़्यादा से ज़्यादा आश्वस्त होता जाता है। HackerTube पर कई लोगों ने वही बात नोटिस की जो मैंने खुद महसूस की है: नर्ड्स द्वारा जाँचे गए, बिना पर्सनलाइज़ेशन वाले वीडियो की फ़ीड में YouTube की गहराई से पर्सनलाइज़्ड फ़ीड से ज़्यादा हिट रेट था। इसमें हैरानी नहीं होनी चाहिए। पर्सनलाइज़ेशन आपकी पसंद आपके सबसे कमज़ोर पलों से निकालता है (जैसे थके हुए 11 बजे आपने क्या क्लिक किया), जबकि क्यूरेशन लोगों के सबसे मज़बूत पलों से पसंद दर्ज करता है, यानी वह जिसे उन्होंने दूसरों को सुझाने लायक समझकर लिखने की ज़हमत उठाई।
एक और सूक्ष्म विफलता भी है: ऑप्टिमाइज़्ड फ़ीड वही चीज़ें बार-बार दिखाने में बेहद माहिर हैं जो आप पहले से जानते हैं। लेकिन लोग ब्राउज़ क्यों करते हैं, इसकी एक बड़ी वजह होरिज़ॉन का विस्तार है, यानी कुछ अप्रत्याशित देख लेना जो दुनिया को देखने के आपके नज़रिए को फिर से ठीक कर दे। एंगेजमेंट ऑप्टिमाइज़ेशन के पास “बाद में फल देने वाले आश्चर्य” का कोई ग्रेडिएंट सिग्नल नहीं होता। उसे बस इतना पता होता है कि आप रुके या नहीं। यही वजह है कि मैंने यह भी तर्क दिया है कि AI बेंचमार्क असली काम का ज़्यादातर हिस्सा क्यों छूट जाते हैं: मापी जाने वाली प्रॉक्सी उस चीज़ से दूर चली जाती है जो आप असल में चाहते थे, और यह दूरी लगातार बढ़ती जाती है।
क्यूरेशन को कॉर्पस की तरह इस्तेमाल करना: Hacker News कमेंट्स की खुदाई
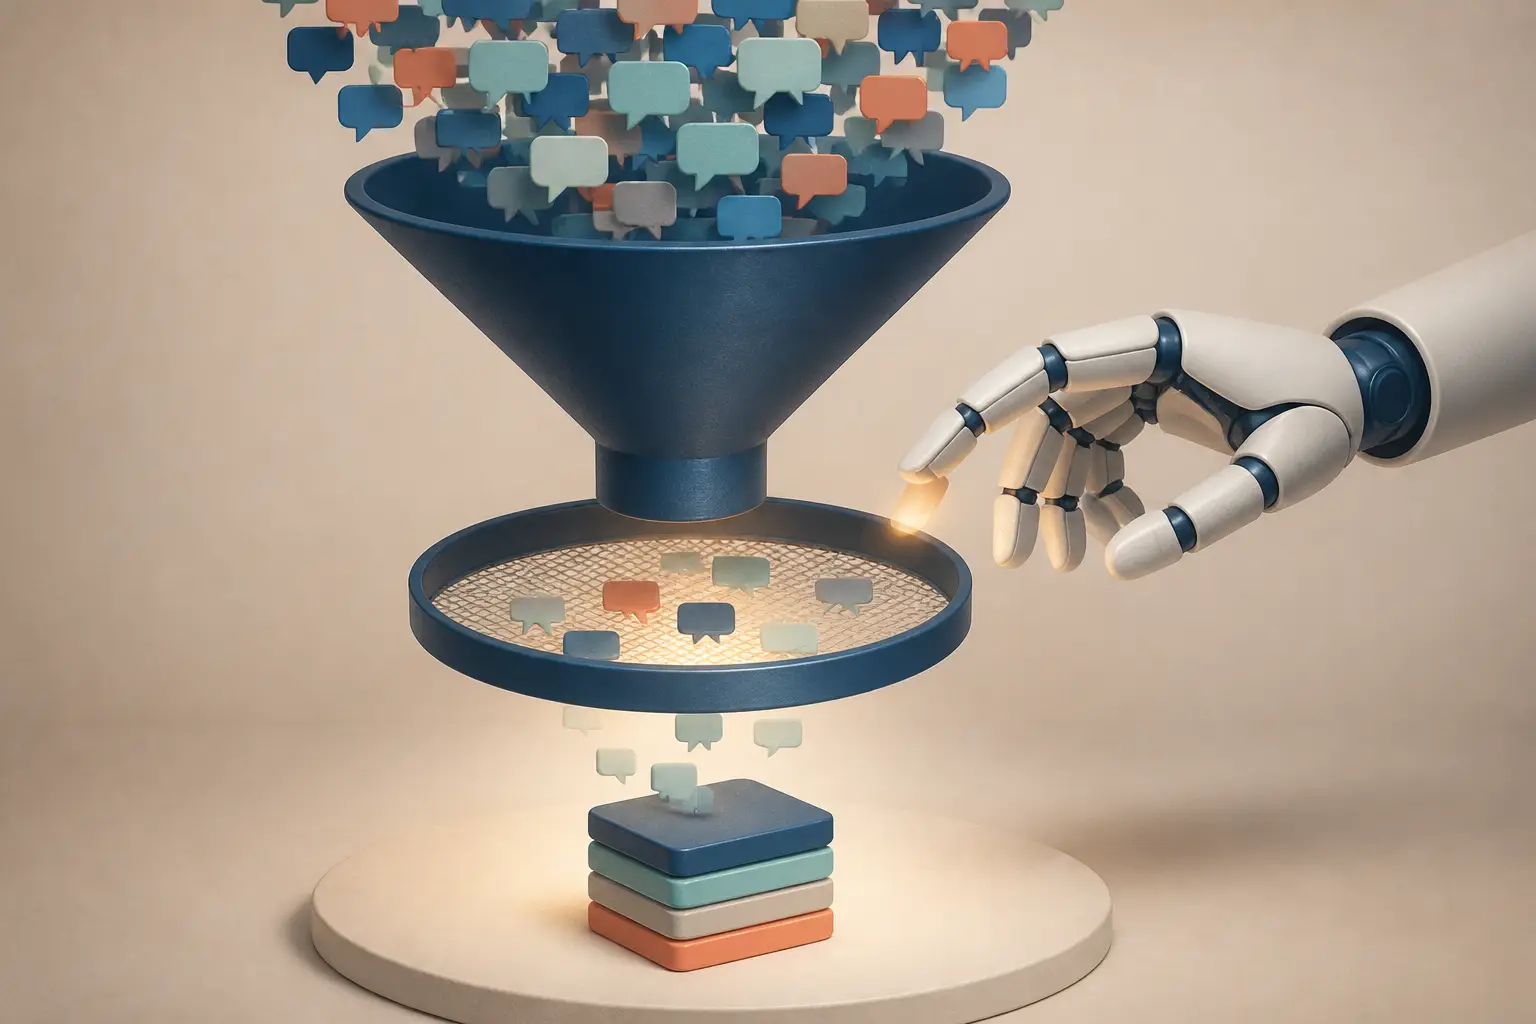
तो रिकमेंडेशन-फ्री फ़ीड अपना कंटेंट कहाँ से लाती है? HackerTube का जवाब चतुर है, क्योंकि वह एक मौजूदा, उच्च-गुणवत्ता वाले सिग्नल का दोबारा इस्तेमाल करता है: दो दशकों के Hacker News कमेंट्स। पाइपलाइन समझाना आसान है। Hacker News के सभी सार्वजनिक कमेंट्स डाउनलोड करें (वे आधिकारिक API और कम्युनिटी डेटासेट से मिल जाते हैं)। उन कमेंट्स को छाँटें जिनमें YouTube लिंक हैं, जो लगभग 40,000 हैं। फिर हर कमेंट पर एक सस्ते LLM पास से एक ही सवाल पूछें: क्या यह व्यक्ति वाकई इस वीडियो की सिफ़ारिश कर रहा है, या यह स्पैम है, बस एक राह चलते का लिंक है, या किसी ने वीडियो का मज़ाक उड़ाने के लिए उसे उद्धृत किया है? यह फ़िल्टरिंग पास कॉर्पस को लगभग 150 टॉपिक क्लस्टर में फैले लगभग 6,500 वीडियो तक सीमित कर देता है।
यहाँ दो डिज़ाइन फ़ैसले अपनाने लायक हैं। पहला, वर्गीकरण का चरण ठीक उसी तरह का सीमित निर्णय है जिसमें LLM उत्कृष्ट हैं: छोटे कारण के साथ हाँ या ना, जिसे बड़े पैमाने पर मामूली खर्च में लागू किया जा सके। यह वही पैटर्न है जैसा constrained decoding से LLM को तेज़ डिसीज़न मॉडल में बदलने में दिखता है: मॉडल से जनरेट करवाने के बजाय उससे फ़िल्टर करवाएँ। दूसरा, कॉर्पस में गुणवत्ता की एक अंतर्निहित न्यूनतम सीमा है। उसमें हर वीडियो को किसी इंसान ने लिखित रूप में, ऐसे दर्शकों के सामने सिफ़ारिश किया है जो बकवास पर डाउनवोट करते हैं। यह एक ऐसी फ़िल्टरिंग व्यवस्था है जिसे कोई एंगेजमेंट मॉडल दोहरा नहीं सकता, क्योंकि यह क्लिक्स की जगह प्रतिष्ठा पर टिकी है।
कमेंट में लिखी सिफ़ारिश एक व्यक्ति का अपनी प्रतिष्ठा दाँव पर लगाना है। क्लिक एक प्रतिक्रिया भर है। पहले पर बनी फ़ीड अलग महसूस होती है, क्योंकि वे सचमुच अलग हैं।
एक समय का आयाम भी मायने रखता है। ये सिफ़ारिशें 2007 से आज तक फैली हैं, यानी कॉर्पस पर ऐसी सामग्री हावी है जिसमें टिकाऊपन है: लेक्चर, गहरे तकनीकी टॉक, और लंबे इंटरव्यू। वह नहीं जो एल्गोरिदम इस हफ़्ते बढ़ा रहा है। लोगों को एक खास बात बहुत पसंद आई: लंबे वीडियो के लिए “Longs” कैटेगरी। YouTube पर 90 मिनट का टॉक एक जोखिम है जो रिकमेंडर आपके सेशन पर लेता है। HackerTube पर वही फ़ीचर है, क्योंकि किसी ने उसके साथ लिखा है कि “इसने मेरे कंपाइलरों के बारे में सोचने का तरीका बदल दिया”।
सरल रिट्रीवल स्मार्ट रैंकिंग को हरा देता है
यह हिस्सा अगर आप रिकसिस (recsys) में काम कर चुके हैं तो धार्मिक विधर्म जैसा लगेगा: जब आपका कॉर्पस छोटा और अच्छा हो, तो रैंकिंग लगभग मायने ही नहीं रखती। छह हज़ार वीडियो कुछ भी नहीं हैं। आपको दो-टावर एम्बेडिंग मॉडल या री-रैंकिंग कैस्केड की ज़रूरत नहीं है; आपको टॉपिक टैग, ताज़गी, और एक हल्का क्लाइंट-साइड पर्सनलाइज़ेशन पास चाहिए। HackerTube का “For You” लोकल स्टोरेज में मौजूद सेशन स्टेट पर चलता है, यानी इस ब्राउज़र में आपने क्या देखा और क्या छोड़ा, बिना अकाउंट और बिना सर्वर-साइड प्रोफ़ाइल के। यह कोई सीमा नहीं है। यह एक आर्किटेक्चर का फ़ैसला है, जो बुरे प्रोत्साहनों की पूरी श्रेणी को खत्म कर देता है: अगर आप यूज़र के व्यवहार को स्टोर ही नहीं करते, तो उसे ऑप्टिमाइज़ करने का लालच भी नहीं होगा।
अगर आप इसका अपना संस्करण बनाना चाहते हैं, यानी पेपर, कॉन्फ़्रेंस टॉक, ब्लॉग पोस्ट, या जो भी आपका समुदाय सिफ़ारिश करे उसकी फ़ीड, तो रैंकिंग लॉजिक कुछ दर्जन पंक्तियों में आ जाता है। इसका ढाँचा यह है:
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]
ध्यान दें कि इसमें क्या नहीं है: कोई डवेल-टाइम फ़ीचर नहीं, कोई एंगेजमेंट वेलोसिटी नहीं, और कोई एक्सप्लोरेशन-एक्सप्लॉइटेशन बैंडिट नहीं जो आपकी सहनशीलता की सीमा खोजने में लगा हो। पर्सनलाइज़ेशन सिग्नल स्पष्ट हैं (फ़िनिश और स्किप, जो इस सेशन में यूज़र के अपने व्यवहार से तय होते हैं) और सीमित हैं (हर एक का वज़न कुछ अंकों का है, जिन्हें कॉर्पस-गुणवत्ता वाला टर्म आसानी से दबा दे)। एल्गोरिदम धक्का दे सकता है, लेकिन फँसा नहीं सकता। यही असंतुलन इस एक स्कोरिंग फ़ंक्शन में पूरी फ़िलॉसफ़ी है।
थंबनेल वाले फ़ैसले का भी ज़िक्र ज़रूरी है, क्योंकि यह इंटरफ़ेस को डी-ऑप्टिमाइज़ करने का बहुत साफ़ उदाहरण है। YouTube के क्रिएटर थंबनेल को A/B टेस्ट कर-करके इतना घिसते हैं कि थंबनेल खुद एक प्रतिकूल आर्टिफ़ैक्ट बन गया है। HackerTube अपलोड किया गया थंबनेल नज़रअंदाज़ करता है और उसकी जगह वीडियो के 50% मार्क वाला फ़्रेम इस्तेमाल करता है। यह एक लाइन का बदलाव है जो क्लिकबेट की होड़ को पूरी तरह खत्म कर देता है: प्रीव्यू आपको दिखाता है कि वीडियो असल में क्या है, न कि क्रिएटर को क्या लगता है कि आपको क्लिक करने पर मजबूर करेगा।
बिना अकाउंट और ट्रैकिंग के फ़ीड डिज़ाइन करना
स्टेट को क्लाइंट पर ले जाना सिर्फ़ आपकी प्राइवेसी पॉश्चर नहीं बदलता, वह आपकी लागत संरचना और कानूनी जोखिम का दायरा भी बदल देता है। यूज़र अकाउंट न होने का मतलब है कोई ऑथ सिस्टम नहीं, कोई पासवर्ड रीसेट नहीं, GDPR के सब्जेक्ट-एक्सेस की झंझट नहीं, और व्यवहार-प्रोफ़ाइल के लीक होने की कोई ज़िम्मेदारी नहीं। आपका बैकएंड एक स्टैटिक फ़ाइल सर्वर और शायद एक छोटा सा API है। पूरी साइट एक बिल्ड आर्टिफ़ैक्ट हो सकती है। जब आपका आर्किटेक्चर यूज़र डेटा जमा ही नहीं कर सकता, तो ज़्यादातर डार्क पैटर्न सिर्फ़ नीति के उल्लंघन नहीं, बल्कि व्यवहार में असंभव हो जाते हैं। मुझे इस तरह की गारंटी किसी भी प्राइवेसी पॉलिसी से कहीं ज़्यादा भरोसेमंद लगती है।
ईमानदार ट्रेड-ऑफ़ यह है: लोकल स्टेट अस्थायी है और डिवाइस से बंधी है। ब्राउज़र डेटा साफ़ करेंगे तो फ़ीड रीसेट हो जाएगी। डिवाइसों के बीच कोई निरंतरता नहीं है। एक लीन-बैक वीडियो साइट के लिए यह ठीक है। मैं तो कहूँगा कि कभी-कभार यह रीसेट स्वस्थ भी है। जिन चीज़ों में यूज़र लंबे समय के संग्रह बनाते हैं, उनके लिए एक्सपोर्ट/इंपोर्ट का रास्ता ज़रूरी होगा, और यही बात इस पूरे प्रोजेक्ट के सबसे आगे देखने वाले फ़ैसले तक ले जाती है।
डेटा ही इंटरफ़ेस है: एक फ़ोर्क होने लायक कॉर्पस जारी करना
HackerTube का जो हिस्सा मुझे सचमुच नया लगता है, वह UI नहीं है, बल्कि यह है कि साइट के पीछे का पूरा डेटासेट एक ज़िप फ़ाइल के रूप में डाउनलोड हो सकता है, जिसमें एक DATA.md है, जो खास तौर पर AI एजेंट्स के लिए लिखा गया है। यह बताता है कि फ़ाइलें आपस में कैसे जुड़ती हैं, कौन सी गड़बड़ियाँ आम हैं, उदाहरण रिकॉर्ड क्या हैं, और ताज़ा मेटाडेटा कैसे लाया जाए। इसका इच्छित वर्कफ़्लो यह है: ज़िप अपने कोडिंग एजेंट को दें और कहें “मेरे विषयों पर साप्ताहिक ईमेल बनाओ” या “इसके लिए एक टर्मिनल क्लाइंट बनाओ।” प्रोडक्ट वेबसाइट नहीं है। प्रोडक्ट क्यूरेट किया हुआ कॉर्पस है, और वेबसाइट बस उसका एक संदर्भ रेंडरर है।
मुझे लगता है हम इस पैटर्न को और बहुत देखेंगे। दो दशकों तक मानक सलाह थी, “एक API दो।” लेकिन API आपको क्वेरी का द्वारपाल बनाए रखता है, और जैसे ही आप उसे मेंटेन करना बंद करते हैं, वह सड़ने लगता है। एक पोर्टेबल, एजेंट-पठनीय डेटासेट इस रिश्ते को उलट देता है: आप चीज़ को एक बार, अच्छी तरह दस्तावेज़ित करके प्रकाशित करते हैं, और हज़ारों पर्सनलाइज़्ड फ़्रंटएंड खुद-ब-खुद उग आते हैं। यह स्मॉल वेब की भावना से मेल खाता है, जहाँ खोज इस पर टिकी होती है कि लोग अपने पसंदीदा चीज़ों के लिंक दूसरों को भेजते हैं, न कि प्लेटफ़ॉर्म तय करते हैं कि आपको क्या दिखे। बस यह उस दुनिया के लिए अपडेट हुआ है जहाँ आपके डेटा का पहला उपभोक्ता शायद एक भाषा मॉडल हो।
एजेंट्स के लिए दस्तावेज़ लिखना अपने आप में एक उभरता हुआ शिल्प है। इंसान स्किम करते हैं, जबकि एजेंट्स शाब्दिक और पूरी तरह पढ़ते हैं, और वे उन निहित मान्यताओं में लड़खड़ाते हैं जिन्हें इंसान आसानी से समझ लेता है। एक अच्छे DATA.md में इकाइयाँ, नल-मान के नियम, एन्कोडिंग की खासियतें, और विफलता के तरीके शुरू में ही बताए जाते हैं। अगर आप डेटासेट प्रकाशित करते हैं, तो अब यह बुनियादी ज़रूरत है। यही फ़र्क है कि एजेंट एक ही बार में काम करने वाला फ़ोर्क बनाता है या किसी स्कीमा की कल्पना करने लगता है।
क्यूरेटेड फ़ीड की ईमानदार सीमाएँ
मैंने हाइप की जगह व्यावहारिकता का वादा किया था, तो यहाँ तीखे किनारे भी हैं। पहला: क्यूरेट किया गया कॉर्पस अपने क्यूरेटरों के पूर्वाग्रह भी ले आता है। Hacker News एक खास जनसांख्यिकी और खास रुचि वाला समूह है। नतीजा “100% शुद्ध नर्ड कंटेंट” है, जो उन दर्शकों के लिए आनंददायक है जो इसका लक्ष्य हैं, और बाकी लोगों के लिए लगभग अदृश्य। यह तरीका “सबके लिए” तक नहीं फैलता, और वह कोशिश भी नहीं करता। यह एक पब है, कोई यूटिलिटी नहीं।
- बासीपन: एक जमा हुआ स्नैपशॉट सड़ता है। आपको एक शेड्यूल्ड जॉब चाहिए जो एक्सट्रैक्शन पाइपलाइन दोबारा चलाए, वरना फ़ीड चुपचाप एक संग्रहालय बन जाएगी।
- प्लेटफ़ॉर्म पर निर्भरता: वीडियो अब भी YouTube पर ही रहते हैं। डिलीशन, क्षेत्रीय प्रतिबंध, और ToS में बदलाव आपके कॉर्पस को नीचे से सड़ा सकते हैं। मरे हुए लिंक ट्रैक करें, वरना भरोसा खो देंगे।
- जनसांख्यिकीय बंधन: जो सिफ़ारिश करता है, वही तय करता है कि स्वाद क्या है। एक सामुदायिक साइट के लिए ठीक है; अगर आप इसे निष्पक्ष खोज बताकर पेश करें तो यह गंभीर पूर्वाग्रह की समस्या है।
- नई सामग्री की सीमा: बिल्कुल नए बेहतरीन कंटेंट के पास अभी कोई सिफ़ारिशें नहीं होतीं। क्यूरेटेड फ़ीड नए कंटेंट को व्यवस्थित रूप से कम दिखाती हैं, और यही वह खाई है जिसे एंगेजमेंट एल्गोरिदम भरते हैं, अच्छाई और बुराई दोनों के साथ।
यही आखिरी बात मुझे इस पूरे तरीके के बारे में ईमानदार रखती है। एंगेजमेंट फ़ीड और क्यूरेटेड फ़ीड दुश्मन नहीं हैं; वे अलग-अलग समय-सीमाओं के लिए ऑप्टिमाइज़ हैं। क्यूरेशन बताता है कि क्या सचमुच मूल्यवान साबित हुआ। एंगेजमेंट रैंकिंग अपने सबसे अच्छे रूप में वह दिखाती है जो आगे चलकर मूल्यवान बन सकता है। YouTube के रिकमेंडर का स्वस्थ संस्करण कुछ-कुछ HackerTube के कॉर्पस जैसा होगा, जिसके साथ एक छोटी, साफ़ तौर पर लेबल की गई “नया और अप्रमाणित” पट्टी भी होगी। त्रासदी यह नहीं है कि रिकमेंडेशन एल्गोरिदम मौजूद हैं। त्रासदी यह है कि बिज़नेस मॉडल माँग करता है कि वही पूरा इंटरफ़ेस बन जाएँ।
कब खुद यह बनाना चाहिए
दो घंटे का बिल्ड टाइम इस कहानी के भीतर की कहानी है। यह प्रोजेक्ट पाँच साल पहले इस रफ़्तार से संभव नहीं था, और इसकी वजह कोई एक कदम कठिन होना नहीं था, बल्कि चालीस झंझट भरे कदम थे: एक्सट्रैक्शन, फ़िल्टरिंग, मेटाडेटा समृद्धि, UI, डिप्लॉयमेंट, और सख़्ती। एक ऐसा एजेंट जो पूरी योजना को संदर्भ में थाम सके, इसे एक प्रॉम्प्टिंग सेशन में समेट देता है। इसका मतलब है कि प्लेटफ़ॉर्म फ़ीड के विशिष्ट, क्यूरेट किए गए विकल्प बनाने की बाधा अब लगभग इतनी रह गई है कि “एक प्रेरित व्यक्ति, एक शनिवार सुबह।”
तो मेरी राय यह है, और मैं इस पर कायम रहूँगा: अगर आप किसी भी ऐसे प्रोडक्ट को चलाते हैं जिसमें फ़ीड है, जैसे आंतरिक नॉलेज बेस, कम्युनिटी फ़ोरम, या कंटेंट प्रोडक्ट, तो एल्गोरिदमिक संस्करण बनाने से पहले क्यूरेटेड संस्करण का प्रोटोटाइप बनाएँ। स्पष्ट मानवीय सिफ़ारिशों से शुरुआत करें, उन्हें एक सस्ते LLM पास से छानें, और ऐसे सरल स्कोरिंग फ़ंक्शन से रैंक करें जिसे स्टैंडअप में समझाया जा सके, और जितना हो सके स्टेट क्लाइंट-साइड रखें। आप जल्दी जान जाएँगे कि आपकी असली समस्या इन्वेंटरी की है या रैंकिंग की, और मेरे अनुभव में लगभग हमेशा इन्वेंटरी ही निकलती है। एंगेजमेंट-ऑप्टिमाइज़्ड फ़ीड एक मेट्रिक को अधिकतम करने का औज़ार है। क्यूरेटेड फ़ीड एक इंसान का सम्मान करने का औज़ार है। पहले दूसरा बनाइए, और पहले वाले तक तभी पहुँचिए जब आप सटीक रूप से बता सकें कि वह क्यों, और किसके लिए, अस्तित्व में आना चाहिए।


