Feed senza raccomandazioni: curation oltre gli algoritmi
Come creare un feed senza raccomandazioni con curation umana e recupero semplice, senza algoritmi che inseguono l'engagement. Lezioni da HackerTube.
 Sarah Chen

È le 23 di venerdì. Sei stanco, apri YouTube e la homepage ti accoglie con un muro di miniature urlanti, facce sconvolte e gli stessi tre argomenti che ha deciso ti piacessero nel 2019. Niente di quello che cerchi, ma scorri comunque, perché lo scorrimento è ciò per cui è progettata l'interfaccia. Se hai mai provato quel tipo specifico di stanchezza, capisci già perché i feed senza raccomandazioni stiano diventando improvvisamente interessanti, e perché un clone di YouTube costruito con i consigli dei commenti di Hacker News, assemblato in circa due ore con un agente AI, abbia ricevuto così tanta attenzione di recente.
Il progetto in questione è HackerTube: un'interfaccia in stile YouTube costruita su circa 6.500 video raccomandati nei commenti di Hacker News tra il 2007 e oggi. Niente account, niente tracciamento, niente trucchi con la riproduzione automatica. Lo stato vive nel local storage del browser. L'intera cosa è stata generata con un prompt in una sessione di sabato mattina, dall'estrazione dei dati fino al deployment su un VPS. Voglio parlarti del perché funziona così bene, perché la lezione va ben oltre un singolo progetto divertente. Funziona perché non ha un algoritmo di raccomandazione in senso convenzionale, e questo si rivela una caratteristica che puoi progettare deliberatamente nei tuoi prodotti.
Perché gli algoritmi di raccomandazione ottimizzano la cosa sbagliata
Ho passato qualche anno a lavorare su sistemi di ranking, quindi lo dico apertamente: la funzione obiettivo è il prodotto. Un recommender su scala di piattaforma viene addestrato su proxy di engagement: tempo di visione, click-through rate, durata della sessione e, a volte, il tempo di permanenza ponderato sulle impression pubblicitarie. Nessuno di questi misura «l'utente se n'è andato soddisfatto?». Misurano «l'utente è rimasto?». Sono correlati abbastanza spesso da farti credere di costruire qualcosa di buono, ma divergono proprio nei casi che contano: indignazione, provocazione e il ventesimo video su un argomento che hai già esaurito.
Questa è la legge di Goodhart travestita da trench. Una volta che il tempo di visione diventa l'obiettivo, smette di misurare qualsiasi cosa legata alla qualità. Peggio ancora, il ciclo di feedback è chiuso: l'algoritmo influenza cosa viene cliccato, i click diventano dati di addestramento e il modello diventa sempre più sicuro di un'immagine di te sempre più ristretta. Diverse persone che hanno commentato HackerTube hanno notato qualcosa che ho provato anch'io: il feed non personalizzato di video selezionati dai nerd aveva un tasso di successo più alto di quello, fortemente personalizzato, di YouTube. Non dovrebbe sorprendere. La personalizzazione deduce i tuoi gusti dai tuoi momenti più deboli (cosa hai cliccato alle 23, stanco), mentre la curation codifica i gusti dai momenti migliori delle persone (quando si sono prese la briga di scrivere un commento per consigliare qualcosa ai colleghi).
C'è anche una modalità di fallimento più sottile: i feed ottimizzati sono straordinariamente bravi a mostrarti più di ciò che già conosci. Però gran parte del motivo per cui la gente naviga è l'ampliamento dell'orizzonte, incontrare qualcosa di sorprendente che ricalibra il proprio modello del mondo. L'ottimizzazione dell'engagement non ha alcun segnale di gradiente per la sorpresa che ripaga più tardi. Sa solo se sei rimasto. È la stessa ragione per cui ho sostenuto che i benchmark dell'AI non colgono la maggior parte del lavoro reale: il proxy misurabile si allontana da ciò che volevi davvero, e la deriva si accumula.
La curation umana come corpus: estrarre dati dai commenti di Hacker News
Allora da dove prende l'inventario un feed senza raccomandazioni? La risposta di HackerTube è intelligente perché riutilizza un segnale di alta qualità già esistente: due decenni di commenti su Hacker News. La pipeline è semplice da descrivere. Si scaricano tutti i commenti pubblici di HN (sono disponibili tramite l'API ufficiale e dataset della community). Si filtrano i commenti che contengono link a YouTube, circa 40.000. Poi si passa ogni commento a un LLM più economico con una sola domanda: questa persona sta davvero consigliando questo video, oppure è spam, un link buttato lì o qualcuno che cita il video per prenderlo in giro? Quella fase di filtraggio riduce il corpus a circa 6.500 video distribuiti in 150 cluster tematici.
Due scelte di design meritano di essere copiate. Primo, il passaggio di classificazione è esattamente il tipo di giudizio limitato in cui gli LLM eccellono: un sì/no con una breve motivazione, applicato su larga scala a costo minimo. È lo stesso schema di usare il constrained decoding per trasformare gli LLM in modelli decisionali veloci: non chiedere al modello di generare, chiedigli di filtrare. Secondo, il corpus ha una soglia minima di qualità già integrata. Ogni video è stato garantito da una persona, per iscritto, davanti a un pubblico che boccia le sciocchezze. È un meccanismo di filtraggio che nessun modello di engagement può replicare, perché si basa sulla reputazione e non sui click.
Una raccomandazione scritta in un commento è una persona che mette in gioco la propria reputazione. Un click è un riflesso. I feed costruiti sul primo sono diversi perché sono diversi.
C'è anche una dimensione temporale che conta. Queste raccomandazioni coprono dal 2007 a oggi, quindi il corpus è dominato da contenuti con una lunga durata nel tempo (lezioni, talk tecnici approfonditi, interviste lunghe) piuttosto che da qualunque cosa l'algoritmo stia spingendo questa settimana. Un dettaglio che è piaciuto molto è la categoria «Longs» per i video lunghi. Su YouTube, un talk di 90 minuti è un rischio che il recommender si assume con la tua sessione. Su HackerTube è una caratteristica, perché qualcuno ha scritto «questo ha cambiato il mio modo di pensare ai compilatori» accanto al link.
Un recupero semplice batte il ranking sofisticato
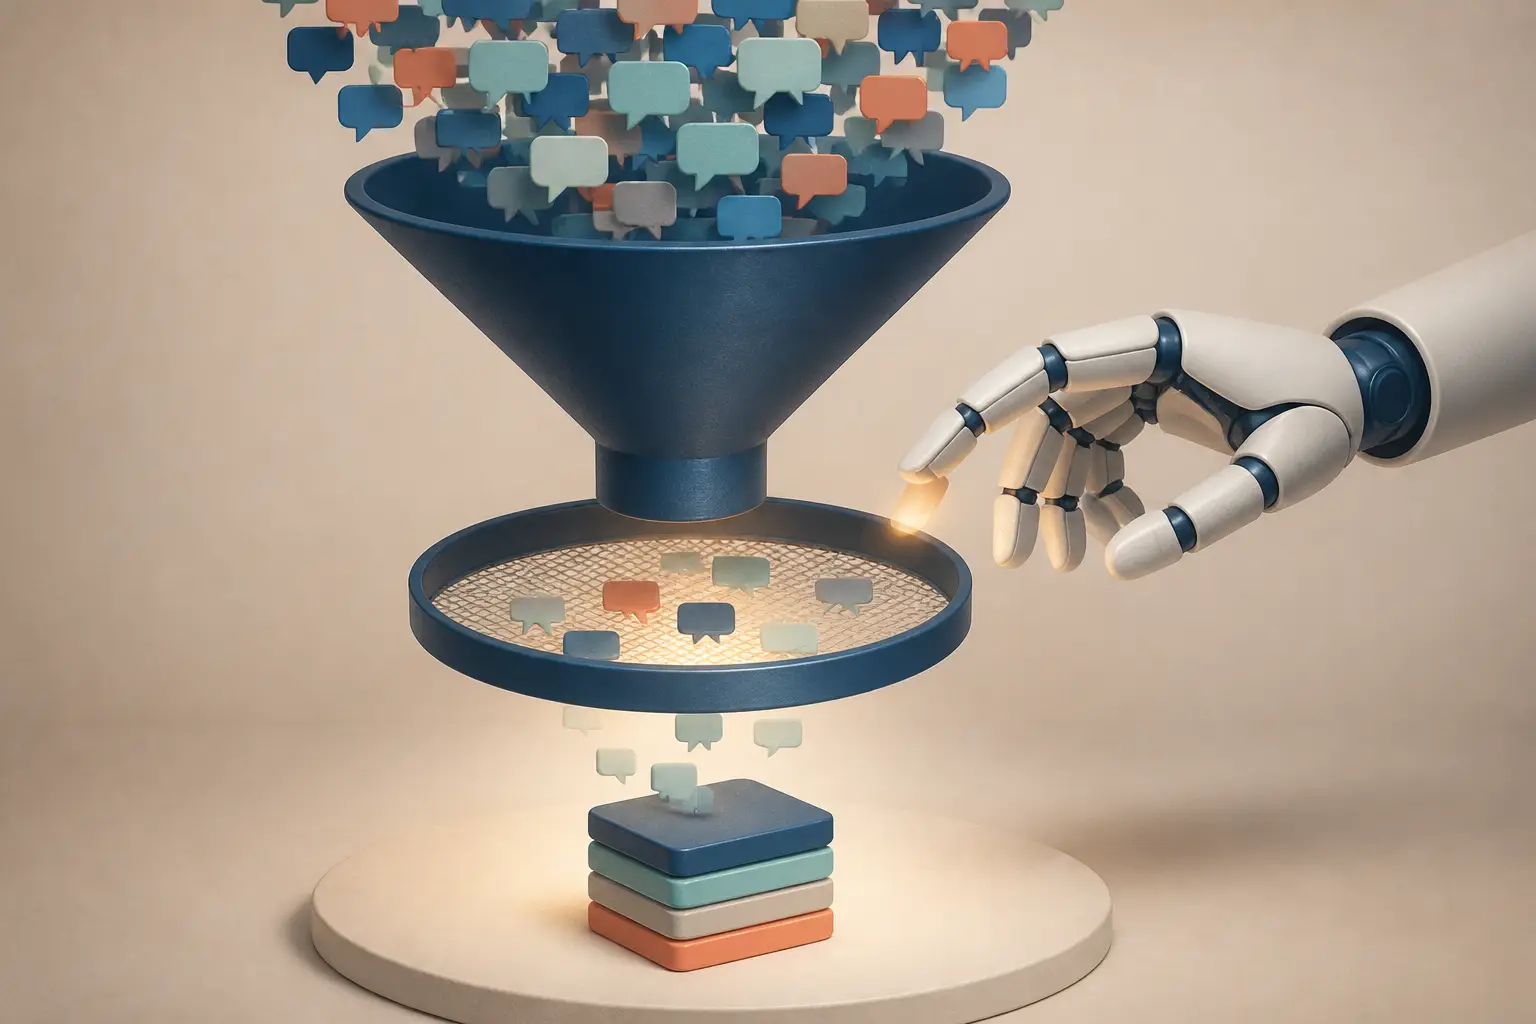
Ecco la parte che suonerà eretica se hai lavorato nei sistemi di raccomandazione: quando il corpus è piccolo e buono, il ranking conta poco. Seimila video sono niente. Non ti servono un modello di embedding a due torri e una cascata di re-ranking; ti servono tag tematici, recency e una leggera personalizzazione eseguita lato client. Il «For You» di HackerTube lavora sullo stato della sessione nel local storage (cosa hai guardato e saltato in questo browser), senza account e senza profilo lato server. Questo non è un limite. È una decisione architetturale che elimina un'intera classe di incentivi sbagliati: se non memorizzi il comportamento degli utenti, non puoi essere tentato di ottimizzarci contro.
Se volessi costruire una tua versione di questo, un feed di paper, talk di conferenze, post del blog o qualsiasi cosa consigli la tua community, la logica di ranking sta in qualche decina di righe. Ecco la forma generale:
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]
Nota cosa manca: nessuna feature di tempo di permanenza, nessuna velocità di engagement, nessun bandit esplorazione-sfruttamento che cerca di capire il tuo punto di rottura. I segnali di personalizzazione sono espliciti (completamenti e salti, scelti dal comportamento dell'utente in questa sessione) e limitati (un paio di punti ciascuno, facilmente sovrastati dal termine di qualità del corpus). L'algoritmo può spingere leggermente; non può intrappolarti. Questa asimmetria è l'intera filosofia in una sola funzione di scoring.
Vale la pena menzionare anche la scelta sulle miniature, perché è un esempio pulito di de-ottimizzazione dell'interfaccia. I creator di YouTube fanno test A/B sulle miniature fino allo sfinimento, quindi la miniatura stessa è diventata un artefatto avversariale. HackerTube ignora la miniatura caricata e usa il fotogramma al 50% della durata del video. È una modifica di una riga che elimina del tutto la corsa al clickbait: l'anteprima ti mostra cos'è davvero il video, non cosa l'autore pensa ti farà cliccare.
Progettare feed senza account né tracciamento
Spostare lo stato sul client cambia più della tua postura sulla privacy: cambia la struttura dei costi e la superficie legale. Niente account utente significa niente sistema di autenticazione, niente reset delle password, niente macchinario per le richieste di accesso GDPR, niente responsabilità in caso di violazione per profili comportamentali. Il backend è un file server statico e forse una piccola API. L'intero sito può essere un artefatto di build. Quando un'architettura non può accumulare dati utente, la maggior parte dei dark pattern diventa fisicamente impossibile, invece che semplicemente vietata dalle policy. Trovo questo tipo di garanzia molto più affidabile di qualsiasi informativa sulla privacy.
Il compromesso onesto: lo stato locale è effimero e legato al dispositivo. Se cancelli i dati del browser, il tuo feed si azzera. Non c'è continuità tra dispositivi. Per un sito video da divano va bene, anzi sostengo che il reset a volte sia persino salutare. Per tutto ciò in cui gli utenti costruiscono collezioni a lungo termine, ti servirà una via di uscita con export e import, che ci porta comodamente alla decisione più lungimirante dell'intero progetto.
I dati come interfaccia: distribuire un corpus da fare fork
La parte di HackerTube che trovo davvero innovativa non è la UI: è che l'intero dataset alla base del sito è scaricabile come zip, che include un DATA.md scritto espressamente per gli agenti AI. Documenta come i file si incastrano, le insidie, esempi di record e come recuperare metadati aggiornati. Il flusso previsto è questo: passi lo zip al tuo coding agent e gli dici «fammi una email settimanale con i talk sui miei argomenti» oppure «costruisci un client da terminale per questo». Il prodotto non è il sito web. Il prodotto è il corpus curato, e il sito è solo il renderer di riferimento.
È un pattern che credo vedremo sempre più spesso. Per due decenni il consiglio standard è stato «esponi un'API». Ma un'API ti rende ancora il gatekeeper delle query, e marcisce nel momento in cui smetti di mantenerla. Un dataset portabile e leggibile dagli agenti inverte la relazione: pubblichi la cosa una volta, ben documentata, e lasci fiorire mille frontend personalizzati. Ricorda lo spirito di il piccolo web, cioè una scoperta costruita su persone che linkano ciò che hanno amato, anziché su piattaforme che decidono cosa vedi, aggiornato a un mondo in cui il primo consumatore dei tuoi dati potrebbe essere un modello linguistico.
Scrivere documentazione per gli agenti è un mestiere emergente a sé. Gli esseri umani scorrono velocemente; gli agenti leggono in modo letterale e completo, e vanno in crisi sulle assunzioni implicite che una persona dedurrebbe. Un buon DATA.md dichiara subito unità di misura, nullabilità, particolarità di codifica e modalità di errore. Se pubblichi dataset, questo è ormai il minimo indispensabile: la differenza tra un agente che produce un fork funzionante in un solo passaggio e uno che allucina uno schema.
I limiti onesti dei feed curati
Ti avevo promesso pragmatismo al posto dell'hype, quindi ecco i punti critici. Primo: un corpus curato eredita i pregiudizi dei suoi curatori. Hacker News è un pubblico specifico con gusti specifici; il risultato è «contenuto nerd al 100%», che è delizioso se fai parte del target e invisibile se non ne fai parte. Questo approccio non scala a «tutti», e non ci prova nemmeno. È un pub, non un'utility.
- Obsolescenza: uno snapshot congelato invecchia. Ti serve un job schedulato che rilanci la pipeline di estrazione, altrimenti il feed diventa silenziosamente un museo.
- Dipendenza dalla piattaforma: i video vivono ancora su YouTube. Cancellazioni, blocchi regionali e cambi nei ToS faranno marcire il corpus dal basso. Monitora i link morti o perdi la fiducia.
- Blocco demografico: chi fa le raccomandazioni definisce il gusto. Va bene per un sito di community; è un serio problema di bias se lo presenti come scoperta neutrale.
- Limite di freschezza: i contenuti nuovissimi e belli non hanno ancora raccomandazioni. I feed curati sottoservono sistematicamente il nuovo, ed è esattamente il vuoto che gli algoritmi di engagement riempiono, nel bene e nel male.
Quest'ultimo punto è quello che mi tiene onesto su tutto questo approccio. Feed di engagement e feed curati non sono nemici: sono ottimizzati per orizzonti temporali diversi. La curation ti dice cosa si è dimostrato utile. Il ranking basato sull'engagement, nella sua versione migliore, fa emergere ciò che potrebbe diventare utile. La versione sana del recommender di YouTube assomiglierebbe molto al corpus di HackerTube, con una piccola corsia chiaramente etichettata di «nuovo e non ancora provato». La tragedia non è che gli algoritmi di raccomandazione esistano: è che il modello di business esige che diventino l'intera interfaccia.
Quando conviene costruirlo da soli
Le due ore di build sono la storia dentro la storia. Questo progetto non sarebbe stato fattibile a questa velocità cinque anni fa, non perché un singolo passaggio sia difficile, ma perché ci sono quaranta passaggi noiosi: estrazione, filtraggio, arricchimento dei metadati, UI, deployment, hardening. Un agente capace di tenere in contesto l'intero piano trasforma tutto questo in una sessione di prompting. Ciò significa che la barriera per costruire alternative di nicchia e curate ai feed delle piattaforme è scesa più o meno a «una persona motivata con un sabato mattina».
Quindi ecco la mia posizione, e mi impegno su questa: se gestisci un prodotto con un feed, una knowledge base interna, un forum di community o un prodotto editoriale, dovresti prototipare la versione curata prima di costruire quella algoritmica. Parti da raccomandazioni umane esplicite, filtrale con un passaggio economico di LLM, ordina con una funzione di scoring abbastanza semplice da spiegare in una daily standup e tieni lo stato lato client finché puoi. Capirai se hai davvero un problema di inventario o di ranking, e nella mia esperienza è quasi sempre di inventario. Il feed ottimizzato per l'engagement è uno strumento per massimizzare una metrica. Il feed curato è uno strumento per rispettare una persona. Costruisci prima il secondo e ricorri al primo solo quando sai spiegare esattamente perché, e per chi, merita di esistere.


