无推荐信息流:策展胜过算法
如何用人工策展和简单检索替代互动优化算法,构建无推荐的信息流,并分享 HackerTube 的实践经验。
 Sarah Chen

周五晚上11点。你很累,打开 YouTube,首页迎面而来的是一堵尖叫式缩略图墙、震惊的表情,还有系统在2019年就认定你喜欢的那三个话题。上面没有一个是你想看的,但你还是会往下刷,因为界面就是为“刷”而设计的。如果你有过这种特别的疲惫感,就能明白为什么无推荐信息流最近突然火了起来,也能明白为什么一个用 Hacker News 评论推荐构建的 YouTube 克隆版(借助 AI 智能体大约两小时搭出来)最近引起了那么多关注。
这个项目叫 HackerTube:一个 YouTube 风格的界面,背后是大约 6,500 个视频,它们是 2007 年至今在 Hacker News 评论中被推荐的内容。没有账号,没有追踪,也没有自动播放之类的套路。状态保存在浏览器的 local storage 里。整个东西是在一个周六上午的会话中通过提示词“生成”出来的,从数据抓取一直到部署到 VPS。我想聊聊它为什么效果这么好,因为这个有趣的边角项目所体现的道理远不止于此。它之所以好,恰恰是因为它没有传统意义上的推荐算法,而这一点完全可以被你有意识地设计进自己的产品里。
为什么推荐算法优化了错误的东西
我花过几年时间做排序系统,所以我直说那个不太好听的实话:目标函数就是产品本身。平台规模的推荐系统是用互动代理指标训练的,比如观看时长、点击率、会话时长,有时还包括按广告曝光加权的停留时间。这些指标都不是在衡量“用户是否满意地离开”,而是“用户有没有留下来”。二者往往足够相关,让你误以为自己做的是好东西,但在真正重要的场景里它们会分道扬镳:煽动情绪、刺激感官,还有你已经看腻了某个话题却仍被推送的第二十个视频。
这就是披着风衣的古德哈特定律。一旦观看时长成了目标,它就不再衡量任何关于质量的东西。更糟的是,反馈回路是闭合的:算法塑造了什么会被点击,点击又变成训练数据,模型对你这个越来越窄的画像就越来越有把握。有不少人在谈论 HackerTube 时都提到了我自己也有过的感受:那个没有个性化、由技术宅们筛选出来的视频列表,命中率反而比 YouTube 那套深度个性化的推荐高。这其实不奇怪。个性化是从你最虚弱的时刻(比如半夜11点、累得要命时点的那些)推断你的口味,而策展则是从人们最有精神的时刻(他们愿意花力气在评论里向同行推荐某个视频)中提取品味。
还有一个更隐蔽的问题:被优化过的信息流非常擅长给你看更多你已经熟悉的东西。但人们刷信息流的一个很大原因,是拓展视野,遇到一些令人惊讶的东西,从而修正自己对世界的认知。互动优化对“后来会证明很有价值的意外”没有任何梯度信号,它只知道你有没有留下来。这也是我之前说过AI 基准测试漏掉了大部分真实工作的原因:可测量的代理指标会逐渐偏离你真正想要的东西,而这种偏移是会累积的。
把人工策展当作语料库:挖掘 Hacker News 评论
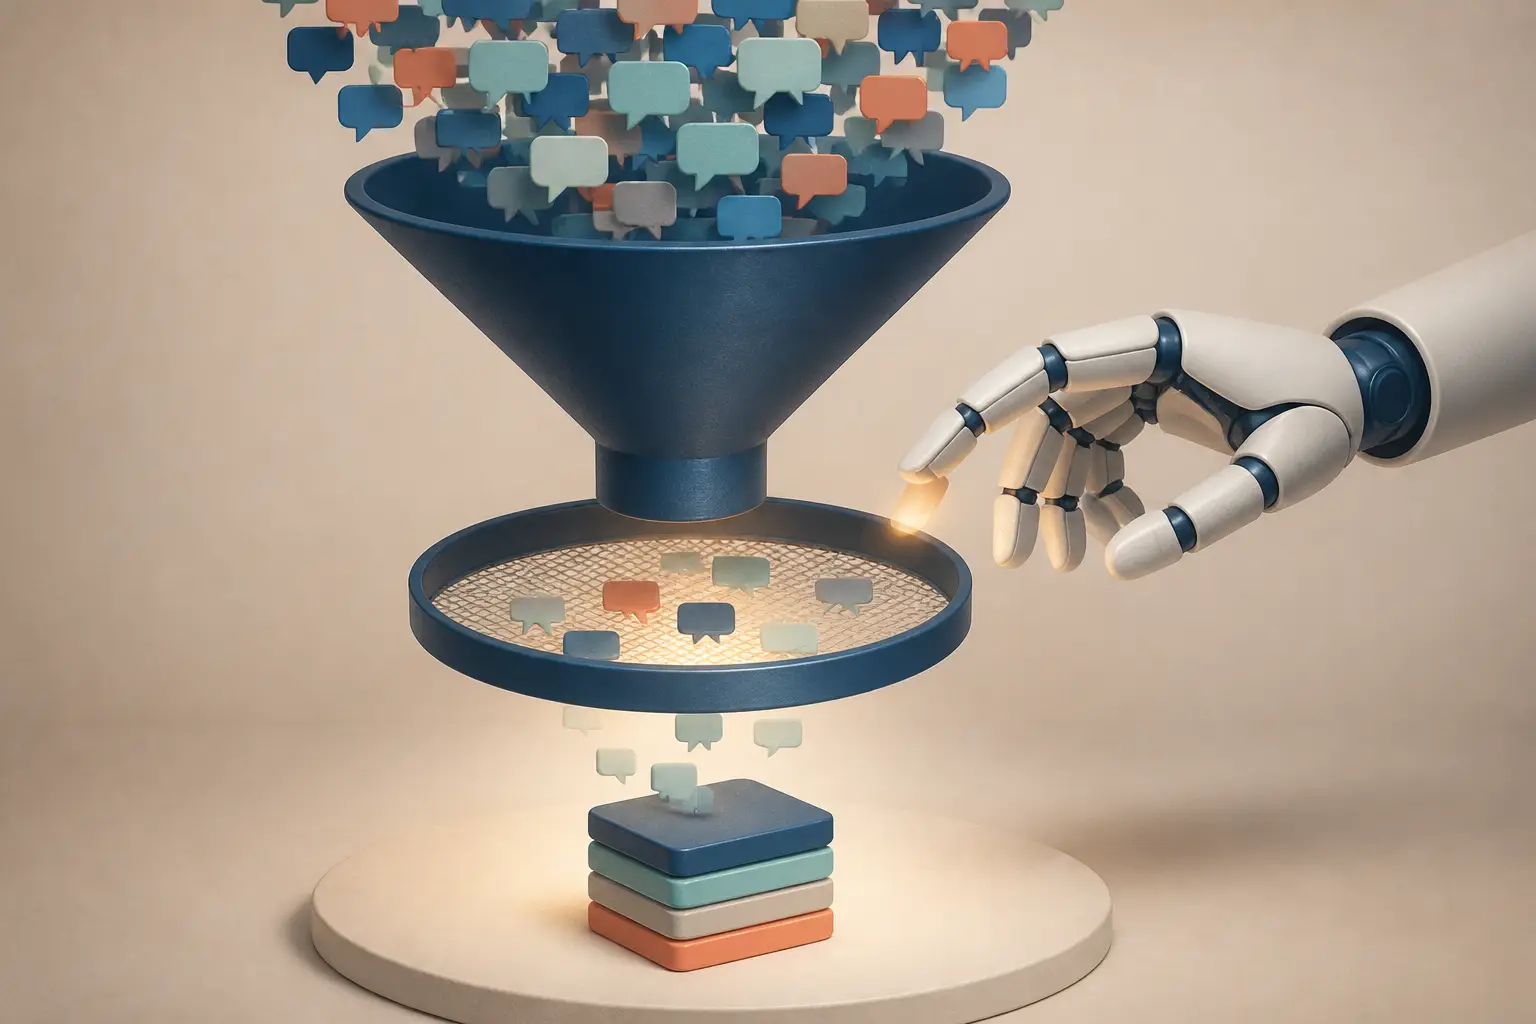
那么,无推荐信息流的内容从哪儿来?HackerTube 的答案很巧妙,因为它复用了一个现成的高质量信号:二十年来的 Hacker News 评论。流程描述起来很简单:下载所有公开的 HN 评论(可以通过官方 API 和社区数据集获取),筛出包含 YouTube 链接的评论,大约 4 万条。然后用一个较便宜的 LLM 对每条评论做一遍处理,只回答一个问题:这个人是在真心推荐这个视频,还是在发垃圾信息、随手甩一个链接,或者是引用视频来嘲讽它?这一轮过滤把语料缩减到大约 6,500 个视频,分布在 150 个主题聚类中。
这里有两个设计选择值得借鉴。第一,分类这一步恰好是 LLM 最擅长的那种有界判断任务:是或否加一句简短理由,大规模执行也花不了多少钱。这和用约束解码把 LLM 变成快速决策模型是同一种模式:不要让模型生成,而是让它过滤。第二,语料本身有内建的质量下限。里面每个视频都是由一个人白纸黑字、当着一群会踩烂内容的观众面前背书的。这种过滤机制是任何互动模型都复制不了的,因为它锚定在声誉上,而不是点击上。
在评论里做推荐,是一个人在拿自己的声誉打赌;点击则只是一种反射。建立在前者之上的信息流,感觉自然不同,因为它们本来就不一样。
时间维度也很重要。这些推荐横跨 2007 年至今,这意味着语料里主要是那些经得起时间考验的内容,比如讲座、深度技术演讲、长篇访谈,而不是算法这周正在推的东西。大家特别喜欢的一个细节是“Longs”分类,专门收录时长较长的视频。在 YouTube 上,一个 90 分钟的演讲对推荐系统来说是拿你的会话去冒的一次风险;而在 HackerTube 上,它是一个卖点,因为有人在它旁边写下了“这改变了我对编译器的看法”。
简单检索胜过精巧排序
如果你在推荐系统领域待过,下面这句话可能会让你觉得是异端邪说:一旦语料又小又好,排序其实几乎无关紧要。六千个视频根本不算多。你不需要双塔嵌入模型,也不需要重排级联,只需要主题标签、时效性,以及一个在客户端运行的轻量个性化过程。HackerTube 的“For You”基于 local storage 里的会话状态工作,也就是你在这个浏览器里看过和跳过的内容,没有账号,也没有服务端的用户画像。这不是什么局限,而是一个架构决策,它消除了整整一类糟糕的激励:如果你根本不存储用户行为,就无法被诱惑去针对它做优化。
如果你想做一个自己的版本,比如汇集论文、会议演讲、博客文章的信息流,内容由你的社区推荐,排序逻辑只需要几十行代码。大致是这样的结构:
import math
import time
def score(video, session, now=None):
now = now or time.time()
s = 0.0
# Corpus quality signal: how many distinct humans vouched for it
s += math.log1p(video["recommenders"])
# Gentle recency so the feed isn't frozen in 2014
age_days = max((now - video["recommended_at"]) / 86400, 1)
s += 0.5 / math.log1p(age_days)
# Session-level taste: topics the user finished vs. skipped,
# stored in localStorage — never leaves the browser
for topic in video["topics"]:
s += 1.5 * session["finished"].get(topic, 0)
s -= 1.0 * session["skipped"].get(topic, 0)
# Already watched? Push it down hard, don't hide it
if video["id"] in session["seen"]:
s -= 5.0
return s
def for_you_feed(videos, session, limit=24):
return sorted(videos, key=lambda v: score(v, session), reverse=True)[:limit]注意其中缺了什么:没有停留时长特征,没有互动速度,也没有试图摸清你底线的探索-利用多臂老虎机。个性化信号是显式的(看完和跳过,由用户在本次会话中的行为决定),而且是有界的(每项只加几分,很容易被语料质量项压过)。算法可以轻推你,但不能把你困住。这种不对称性,就是浓缩在一个评分函数里的全部理念。
缩略图的决定也值得一提,因为它是去优化界面的一个非常干净的例子。YouTube 的创作者会把缩略图 A/B 测试到没完没了,于是缩略图本身变成了一种对抗性产物。HackerTube 忽略上传的缩略图,改用视频 50% 位置的那一帧。这只是一行代码的改动,却直接消除了点击诱饵的军备竞赛。预览展示的是视频真正是什么,而不是创作者认为什么能让你点进来。
设计没有账号和追踪的信息流
把状态迁移到客户端,改变的不只是你的隐私姿态,还有你的成本结构和法律风险面。没有用户账号,就不需要认证系统、密码重置,也不需要 GDPR 的主体访问请求流程,更不用为行为画像的泄露承担责任。你的后端就是一台静态文件服务器,或者再加一个很小的 API。整个站点可以就是一个构建产物。当你的架构根本无法积累用户数据时,大多数暗黑模式就不是“违反政策”,而是在物理上变得不可能。我对这种保证的信任程度,远高于任何隐私政策。
诚实地说,这里的取舍是:本地状态是短暂的,并且绑定设备。清空浏览器数据,你的信息流就会重置,也无法跨设备延续。对于一个“躺着看”的视频网站来说,这没什么问题,我甚至认为偶尔的重置是有益的。但对于需要长期积累收藏的场景,你需要提供导出/导入的逃生口,而这恰好引出了整个项目中最具前瞻性的一个决定。
数据即界面:发布一个可分叉的语料库
在我看来,HackerTube 真正新颖的地方不是 UI,而是背后的全部数据集可以作为一个压缩包下载,里面包含一个专门为 AI 智能体编写的 DATA.md。它说明了文件之间如何配合、常见的坑、示例记录,以及如何获取最新的元数据。预期的工作流是:把压缩包交给你的编程智能体,然后说“帮我做一个关于我感兴趣话题的每周邮件推送”,或者“给我做一个这个数据的终端客户端”。产品不是那个网站,产品是这份策展过的语料库,而网站只是它的参考渲染器。
这是一种我认为今后会越来越常见的模式。二十年来,标准建议一直是“暴露一个 API”。但 API 依然让你充当查询的守门人,而且一旦你不再维护它,它就会腐烂。一个可移植的、智能体可读的数据集则颠倒了这种关系:你只需一次性把文档写好并发布出来,然后让一千个个性化前端自由生长。它与小网络的精神相呼应:发现依赖于人们链接到自己喜爱的东西,而不是平台替你决定看什么。只不过这次要面向一个新世界,在那里,你数据的第一个消费者可能是一个语言模型。
为智能体撰写文档正在形成一门新的手艺。人类会快速浏览,而智能体会逐字逐句完整阅读,并且会在人类能自行推断的隐含假设上栽跟头。一份好的 DATA.md 会预先说明单位、可空性、编码的怪癖以及失败模式。如果你要发布数据集,这已经是基本要求了,它决定了智能体能否一次就做出一个可用的分叉版本,还是开始幻觉出一个错误的 schema。
策展信息流的诚实局限
我承诺过要务实而非炒作,所以这里列出它的锋利边缘。首先:一个策展语料库会继承其策展人的偏见。Hacker News 有着特定的人群和特定的品味,结果就是“100% 纯技术宅内容”,对于正好是目标受众的人来说非常美妙,对于不是的人则完全隐形。这种方法无法扩展到“所有人”,而它也并不打算这么做。它更像一家酒馆,而不是一项公共服务。
- 陈旧化:冻结的快照会逐渐失效。你需要一个定时任务重新运行抽取流程,否则信息流会悄悄变成一座博物馆。
- 平台依赖:视频仍然托管在 YouTube 上。删除、地区限制和服务条款的变化会从底层侵蚀你的语料库。记得追踪失效链接,否则就会失去信任。
- 人群锁定:谁来推荐,谁就定义了品味。对社区网站来说没问题;但如果你把它宣传成中立的发现工具,就会是严重的偏见问题。
- 新鲜度天花板:刚发布的好内容还没有任何推荐。策展信息流系统性地对新内容服务不足,而这恰恰是互动算法所填补的空白,有好有坏。
最后这一点,是让我对整个思路保持清醒的关键。互动型信息流和策展型信息流并非敌人,它们优化的是不同的时间尺度。策展告诉你什么已经被证明有价值;互动排序在最好的情况下,能发现什么可能会变得有价值。YouTube 推荐系统的健康版本,应该很像 HackerTube 的语料库,再加上一条小小的、标注清楚的“新内容与未经验证”通道。悲剧不在于推荐算法存在,而在于商业模式要求它们必须成为整个界面。
什么时候应该自己动手做
两小时的构建时间是故事中的故事。五年前,这个项目不可能以这样的速度完成,不是因为任何单一步骤有多难,而是因为有大约四十个繁琐的步骤:抽取、过滤、元数据补充、UI、部署、加固。一个能把整个计划装进上下文的智能体,把这些压缩成了一次提示词会话。这意味着,构建小众的、策展式的平台信息流替代品,门槛已经降到大约“一个有动力的人、一个周六上午”。
所以我的观点很明确:如果你运营的任何产品带有信息流,比如内部知识库、社区论坛、内容产品,你应该先原型化策展版本,再去构建算法版本。从明确的人工推荐开始,用廉价的 LLM 过滤一遍,用一个简单到能在站会上解释清楚的评分函数来排序,并尽可能把状态保留在客户端。你会弄清楚自己到底是库存问题还是排序问题,而根据我的经验,几乎总是库存问题。互动优化的信息流是为了最大化某个指标的工具;策展的信息流则是为了尊重一个人的工具。先做第二种;只有当你能说清楚究竟为什么、并且为了谁,它才值得存在时,再去动第一种。


