딥시크 추론 엔진의 5가지 통념, 직접 검증해 보다
딥시크가 공개한 프로덕션 LLM 추론 엔진 DeepInfer로 추론 엔진에 대한 흔한 믿음 5가지를 검증해 봤습니다.
 Sarah Chen

딥시크가 프로덕션용 LLM 추론 엔진을 Apache 2.0 라이선스로 GitHub에 공개하자 저장소는 몇 시간 만에 스타가 수천 개 달렸습니다. 놀랍지는 않아요. 진짜 놀라운 건 그 안에 무엇이 들어 있는가입니다. DeepInfer는 연구용 장난감이나 기능을 덜어낸 데모가 아닙니다. 딥시크 발표에 따르면 이 엔진은 DeepSeek-V4.1-Flash를 클러스터당 하루 155조 토큰 규모로 서비스하고, 오프피크 가격 기준으로 GPU 시간당 약 38달러의 매출을 낸다고 합니다. 이 수치들이 대략이라도 맞다면, 업계 대부분이 그저 노하우로만 여기는 엔지니어링 결정들이 여기서 나온 겁니다. 그래서 새로 공개된 프로덕션 시스템을 볼 때 늘 하던 대로 해보려 합니다. README를 회의적인 눈으로 읽고, 추론 엔진에 대한 흔한 믿음들을 그 내용에 비춰 검증해 보겠습니다.
통념 1: 추론 엔진은 그냥 빠른 포워드 패스일 뿐이다
흔히 떠올리는 모델은 이렇습니다. 모델은 모델이고, 엔진은 커널을 호출하는 얇은 래퍼이며, 성능은 더 빠른 GPU를 사면 나온다는 거죠. 그런데 DeepInfer의 기능 목록을 보면 이 생각이 무너집니다. 출시할 가치가 있다고 판단한 기능들을 보세요. “오버헤드 제로 배치 스케줄러”를 내세운 비동기 스케줄링, 신뢰도 기반 검증을 쓰는 추측 디코딩, 슬라이딩 윈도우 어텐션의 경계가 있는 리플레이, 배치 불변 추론, 결정론적 샘플링, 정규식이나 JSON 스키마, EBNF 문법으로 제약하는 구조화된 출력까지 있습니다. 스케줄러, 메모리 관리자, 검증 시스템, 제약 컴파일러가 들어 있는 셈이고, 커널은 목록에서 거의 덤처럼 보입니다.
현장 엔지니어들이 계속 다시 배우는 내용과 맞아떨어집니다. 포워드 패스는 쉬운 부분이에요. FlashAttention과 좋은 GEMM 라이브러리가 나온 뒤로 사실상 해결된 문제죠. 어려운 건 GPU를 계속 바쁘게 돌리는 일입니다. CPU가 어떤 요청을 받을지, 어떤 KV 블록을 내보낼지, 어떤 드래프트 토큰을 검증할지 결정하는 동안 SM이 놀고 있으면 그 순간마다 돈이 증발합니다. DeepInfer의 비동기 스케줄러는 바로 이 CPU 스케줄링을 디바이스 실행과 겹쳐서, GPU가 파이썬을 기다리지 않도록 하려고 존재합니다. 아직도 동기식으로 스케줄링하고 있다면, 그 한 가지를 바꾸는 것만으로 여러분이 계획하던 어떤 커널 교체보다 더 큰 효과가 날 가능성이 높습니다.
README에는 흥미로운 고백도 있습니다. 완전한 추론 서비스를 만들려면 KV 캐시 시스템, 프리필/디코드 분리, 데이터 병렬 레플리카 간 로드 밸런싱도 필요한데, 이 중 어느 것도 포함되어 있지 않다는 거죠. 즉 엔진 자체도 실제 시스템의 한 계층일 뿐입니다. 프로덕션 추론은 머신러닝 옷을 입은 분산 시스템 문제입니다. 이건 LLM 에이전트가 분산 시스템과 꽤 닮았다는 이야기에서 우리가 이미 했던 말인데, 스택을 한 층 아래로 내려와도 똑같이 적용됩니다.
통념 2: 배치는 클수록 항상 좋다
연속 배칭, 즉 다른 요청이 끝나는 대로 전체 배치를 기다리지 않고 새 요청을 배치에 바로 넣는 방식은 이제 기본 옵션입니다. DeepInfer도 당연히 이걸 하죠. 하지만 검증해 볼 만한 건 더 막연한 믿음입니다. “처리량은 배치 크기에 비례하니까 배치를 최대한 키우자”는 생각이요. DeepInfer에는 바로 이 생각이 틀렸기 때문에 존재하는 기능이 두 가지 있습니다.
첫 번째는 배치 불변 추론(DEEPINFER_BATCH_INVARIANT=1)입니다. 보통은 커널의 리덕션 순서가 배치 구성에 따라 바뀌고, 부동소수점 덧셈은 결합법칙이 성립하지 않기 때문에 같은 요청이라도 배치에 무엇이 함께 들어가느냐에 따라 출력이 달라질 수 있습니다. 딥시크는 배치 구성과 상관없이 결과가 동일하도록 만드는 데 엔지니어링 비용을 들일 가치가 있다고 봤습니다. 왜일까요? 규모가 커지면 같은 프롬프트가 날마다 다른 토큰을 내놓는 걸 고객과 평가 파이프라인이 반드시 알아채기 때문입니다. 배치를 키우려면 비결정성을 감수해야 한다면, 딥시크는 처리량을 일부 포기해서 결정성을 되사는 쪽을 택한 겁니다. 즉 진짜 최적화 목표는 날것의 초당 토큰 수가 아니라 믿을 수 있는 초당 토큰 수라는 뜻이죠.
두 번째는 추측 디코딩의 신뢰도 기반 검증 스케줄링입니다. 엔진은 토큰을 드래프트하고(기본 최대 드래프트 길이는 5), 신뢰도 추정치를 이용해 검증 작업을 얼마나 스케줄할지 정합니다. 단순한 방식은 매 스텝마다 고정 길이 드래프트를 검증하지만, 똑똑한 방식은 최적의 추측 작업량이 요청마다, 스텝마다 다르다는 걸 인정합니다. 신뢰도가 정당화하는 양보다 많이 배치하면 버릴 토큰에 연산을 낭비하게 되고, 적게 배치하면 속도 향상을 놓칩니다. 스케줄러는 요청을 그냥 욱여넣는 게 아니라, 스텝마다 최적화 문제를 푸는 셈입니다.
- 배치 크기는 처리량을 올리지만 지연 시간도 올린다 — 프리필 배치가 커지면 첫 토큰까지 걸리는 시간이 늘어납니다.
- 배치 구성은 수치 결과를 바꾼다 — 배치 불변 커널에 비용을 들이지 않는 한 출력은 흔들립니다.
- 추측 작업에는 수확 체감이 있다 — 드래프트 길이가 길어질수록 수락률이 떨어져서, 고정 스케줄은 FLOP을 낭비합니다.
- KV 캐시가 진짜 천장이다 — 배치는 메모리에 들어갈 수 있는 양을 넘을 수 없으니, 배치 정책보다 메모리 레이아웃이 더 중요합니다.
통념 3: KV 캐시 관리는 이미 해결된 문제다
PagedAttention은 OS식 접근법을 대중화했습니다. KV 캐시를 고정 크기 페이지로 나눠 가상 메모리처럼 할당하고, 단편화를 없애는 방식이죠. vLLM이 이게 통한다는 걸 증명했고, DeepInfer도 스스로 밝힌 대로 원래 주로 vLLM 위에서 만들어졌습니다. 그러니 페이지드 KV 캐시는 끝난 얘기 아니냐고 생각하기 쉽죠. 그렇지 않습니다. DeepInfer의 README는 훨씬 공격적인 내용을 슬쩍 언급합니다. 프로덕션 시스템의 설계 목표 중 하나가 72시간 넘게 KV 캐시를 보존하는 것이라는 겁니다.
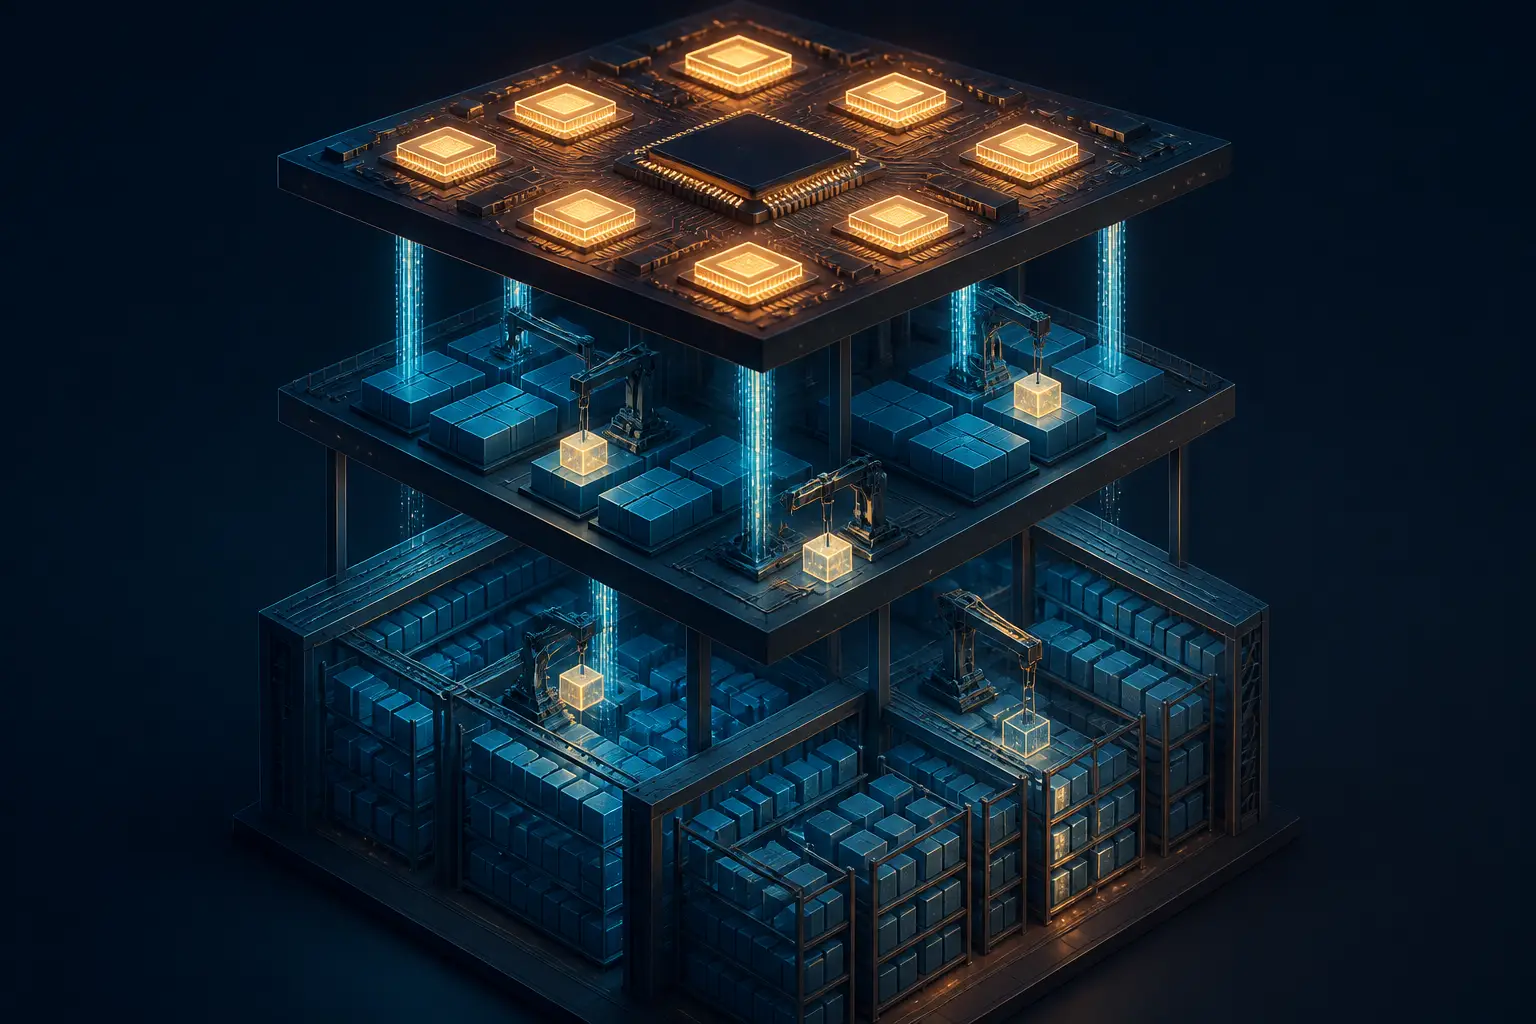
이게 무엇을 의미하는지 생각해 보세요. 가장 큰 GPU의 HBM도 용량이 수백 기가바이트 단위입니다. 바쁜 클러스터 전체에서 72시간 동안 캐시를 유지하면 상태 데이터가 페타바이트 규모가 됩니다. 이걸 디바이스 안에 다 담을 수는 없습니다. HBM, 호스트 DRAM, NVMe, 어쩌면 원격 스토리지까지 아우르는 계층형 KV 시스템이 필요하고, 오래된 프리픽스를 다시 끌어올 때도 지연 시간 SLO가 깨지지 않도록 똑똑한 축출 및 프리페치 정책이 있어야 합니다. README가 릴리스에 포함되지 않은 것으로 “KV 캐시 시스템”을 꼽은 이유도 여기에 있습니다. 별도의 본격적인 인프라이기 때문이죠. KV 캐시를 여전히 GPU 안의 페이징 문제로 본다면, 이제 최전선은 이를 스토리지 시스템으로 다루는 쪽으로 옮겨갔습니다. 더 작은 규모의 이 고민은 GPU VRAM이 부족할 때 어떻게 할지에서 다뤘는데, 이건 그 문제를 데이터센터 규모로 키운 버전입니다.
훔쳐 쓸 만한 더 미묘한 KV 기법도 있습니다. 바로 SWA 경계 리플레이입니다. 디코더의 슬라이딩 윈도우 어텐션 레이어에서는 프리필 중에 프롬프트 전체를 다시 재생할 필요가 없습니다. 어텐션 윈도우와 최대 역추적 길이를 덮는 제한된 접미사만 있으면 됩니다(기본값은 140 토큰 유지). 긴 컨텍스트에서 프리필 연산량을 직접 줄여주고, 프리필 FLOP이 실제로 어디에 쓰이는지 프로파일링해야만 발견할 수 있는 종류의 최적화입니다. 범용 엔진은 이걸 안전하게 하기 어렵고, 모델의 어텐션 구조를 속속들이 알아야 합니다. 여기서도 모델 전용 엔진이 이깁니다.
통념 4: 추측 디코딩은 공짜 처리량이다
추측 디코딩은 거의 마법 같은 소개 문구를 가지고 있습니다. 저렴한 드래프트로 포워드 패스 한 번에 여러 토큰을 생성하고, 병렬로 검증해서 맞는 것만 남긴다는 거죠. 벤치마크에서는 늘 좋아 보입니다. 하지만 DeepInfer가 실제로 이걸 어떻게 배포하는지 읽어 보면 “공짜”라는 믿음은 바로 깨집니다. 플래그가 이야기를 들려줍니다. 켜려면 DEEPINFER_ENABLE_MTP_VARLEN=1, 드래프트 길이를 제한하려면 DEEPINFER_USE_NEXTN_DECODE, 그 위에 별도의 신뢰도 스케줄링 계층까지 있습니다. 정말 공짜였다면 이런 것들이 전혀 필요 없었을 겁니다. 그냥 항상 드래프트하면 됐을 테니까요.
경제성은 이렇게 작동합니다. 드래프트와 검증에는 매 스텝마다 추가 FLOP이 듭니다. 수락률이 충분히 높아서 스텝당 토큰 이득이 그 오버헤드를 넘어야만 이득이 생깁니다. 수락률은 드래프트 방식, 도메인(코드는 잘 드래프트되지만 두서없는 산문은 덜 그렇습니다), 그리고 결정적으로 배치 부하에 따라 달라집니다. 배치 크기가 커지면 GPU는 이미 연산 바운드 상태라서, 추가 검증 FLOP이 실제 작업을 그대로 밀어냅니다. 추측 디코딩은 지연 시간 바운드 구간에서 빛나고, 처리량 바운드 구간에서는 오히려 해가 될 수 있습니다. 두 구간을 모두 서비스하는 프로덕션 엔진은 이를 적응적으로 스케줄해야 하는데, 바로 신뢰도 기반 검증 스케줄링이 하는 일입니다.
추측 디코딩을 서빙 스택에 붙이는 팀들을 지켜보면서 드는 제 의견은 이렇습니다. 이걸 처리량 기능이 아니라 지연 시간 기능으로 다루세요. 병목이 높은 가동률에서의 달러당 토큰 수라면, 먼저 스케줄러와 KV 레이아웃을 고치세요. 병목이 중간 부하에서 대화형 사용자의 p99 지연 시간이라면, 추측 디코딩은 쓸 수 있는 가장 좋은 도구 중 하나입니다. 그리고 DeepInfer는 이것을 어떻게 제어할지에 대한 검증된 참고 자료를 제공합니다.
통념 5: 대규모로 서비스하려면 NVIDIA의 승인만 있으면 된다
DeepInfer가 지원하는 하드웨어는 정확히 두 가지입니다. NVIDIA SM100 GPU와 Huawei Ascend 950 NPU죠. 플랫폼별로 요구사항 파일을 따로 두고(requirements-nvidia.txt, requirements-ascend.txt), 그에 맞춰 기능을 제한합니다. 예를 들어 배치 불변 추론은 NVIDIA 전용입니다. 조용하지만 중요한 선언입니다. 최상위 프로덕션 엔진이 비 NVIDIA 가속기를 일급 시민으로 대우하고, 같은 모델과 같은 스케줄러, 같은 서빙 아키텍처를 공유하는 겁니다.
이것이 무엇을 의미하고 무엇을 의미하지 않는지 분명히 해야겠습니다. Ascend 경로가 성숙했다는 뜻은 아니고, CUDA의 해자가 하룻밤 사이에 사라진다는 뜻도 아닙니다. 같은 README에 있는 CUDA 전용 기능들이 생태계 격차가 여전히 실재한다는 증거니까요. 의미하는 바는 추론 이식성에서 가장 어려운 소프트웨어 문제, 즉 엔진, 스케줄러, 병렬화 전략이 이제 Apache 라이선스로 공개되어 있고 처음부터 듀얼 타깃으로 설계되었다는 점입니다. 규모가 작은 연구실과 하드웨어 벤더에게 이것은 복제해야 할 벽이 아니라 올라설 수 있는 기반입니다. 플래시 티어 모델 시장의 경제성이 이 문제에 얼마나 달려 있는지 아는 사람이라면, 우리가 이전에 플래시 티어 모델이 진짜 추론 효율의 이야기라고 주장했던 것을 떠올릴 겁니다. 하드웨어가 다양해지면 그 효과도 커집니다.
병렬화 설계도 짚고 넘어갈 가치가 있습니다. 어텐션은 균형 잡힌 컨텍스트 병렬과 결합된 데이터 병렬을 쓰고, MoE 레이어에는 전문가 병렬과 전문가 병렬 로드 밸런서를 씁니다. 이 조합은 딥시크가 설명한 배포 형태, 즉 프리필에 소수의 GPU와 디코드에 수십 개의 GPU를 분리해 쓰는 구성에 맞춰 튜닝되어 있습니다. 디코드 중심 분리 구조는 대규모 서빙 팀의 기본 아키텍처가 되어 가고 있는데, 이유는 단순한 산술입니다. 프리필은 연산 바운드이고 디코드는 메모리 대역폭 바운드라서, 둘을 같은 장비에 묶으면 어느 쪽에도 최적이 아닌 하드웨어를 사야 합니다.
통념 6: 그냥 가져다 바로 돌리면 된다
마지막으로 짚고 넘어갈 믿음은, 이 주말에 스택에 연결해 보겠다며 저장소에 별을 누른 모두를 겨냥합니다. DeepInfer는 현재 정확히 하나의 모델 패밀리, DeepSeek-V4.1-Flash만 서비스합니다. Linux, GCC 13 이상, Python 3.12, CUDA 13, SM100 하드웨어가 필요하고, SM100은 대부분의 우리가 손에 쥐고 있지 않은 Blackwell 세대입니다. 벤치마크는 하나의 scale-up 도메인 안에서 프리필에 GPU 4개, 디코드에 GPU 64개를 써서 측정했습니다. 실제 서비스에 필요한 세 가지, 즉 KV 캐시 시스템, 분리 배포 배관, 레플리카 로드 밸런싱은 명시적으로 범위 밖입니다. 이건 엔진이지, 완성된 차가 아닙니다.
하지만 쓸모없다고 치부하면 핵심을 놓칩니다. 여기서는 의견을 분명히 하겠습니다. 이 릴리스의 가치는 배포해서 쓰는 소프트웨어라기보다 프로덕션급이 실제로 무엇을 뜻하는지에 대한 명세에 있습니다. 배치 불변 추론을 일급 플래그로 둔 것, 재현성을 위해 고정된 seq_seed로 결정론적 샘플링을 제공하는 것, 재시도로 덧붙이지 않고 샘플러에 컴파일해 넣은 구조화된 출력, 신뢰도 기반 추측, 실험이 아닌 기본값으로 둔 비동기 스케줄링. 추론 스택을 만들거나 사려고 한다면 이 README는 체크리스트입니다. 대형 모델을 직접 돌린다면 — 작은 쪽은 자신의 하드웨어에서 LLM을 돌리는 실전 가이드에서 다뤘습니다 — 같은 우선순위가 적용되고, 규모만 다를 뿐입니다. 스케줄러가 첫째, 메모리 레이아웃이 둘째, 커널은 셋째입니다.
포워드 패스는 쉬운 부분입니다. 프로덕션 추론은 커널을 호출하는 스케줄러, 메모리 관리자, 검증 시스템입니다.
공개 시점도 주목할 만합니다. 미국 연방 제외 명령이 내려진 직후 몇 시간 만에 나왔고, 댓글에서는 이를 선물이라 부르기도 하고 사보타주라 부르기도 하는 등 말이 많습니다. 헤드라인을 장식하겠죠. 좋습니다. 하지만 드라마를 걷어내면 엔진 관점의 결론은 그대로 서 있습니다. 추론 엔진에 대해 우리가 믿어 온 것 대부분이 한 세대 뒤처진 이야기였다는 겁니다. 흥미로운 작업은 이제 커널 안에 있지 않고, 커널을 둘러싼 모든 것에 있습니다.


