Движок инференса DeepSeek: 5 мифов под проверкой
DeepSeek открыл исходники продакшн-движка для инференса LLM. Проверяем пять распространённых убеждений об inference-движках на примере DeepInfer.
 Sarah Chen

Когда DeepSeek выложил свой продакшн-движок инференса LLM на GitHub под лицензией Apache 2.0, репозиторий набрал тысячи звёзд за несколько часов. Это не удивительно. Удивительно то, что внутри. DeepInfer — не исследовательская игрушка и не урезанное демо. По словам самой DeepSeek, это движок, который обслуживает DeepSeek-V4.1-Flash в заявленном масштабе 155 триллионов токенов в сутки на кластер, при выручке около $38 за GPU-час по внепиковым тарифам. Если эти цифры хотя бы примерно верны, они основаны на инженерных решениях, которые большая часть индустрии считает фольклором. Поэтому сделаем то, что я делаю с любой свежеоткрытой продакшн-системой: прочитаем README с позиции скептика и проверим распространённые убеждения об inference-движках.
Миф 1: инференс-движок — это просто быстрый прямой проход
Наивная модель мышления такая: модель есть модель, движок — тонкая обёртка, которая вызывает ядра, а производительность берётся из покупки более быстрых GPU. Собственный список возможностей DeepInfer опровергает это. Посмотрите, что авторы сочли нужным выпустить: асинхронное планирование с «планировщиком батчей с нулевыми накладными расходами», спекулятивное декодирование с верификацией по оценке уверенности, ограниченное повторное воспроизведение для sliding-window attention, батч-инвариантный инференс, детерминированное сэмплирование и структурированный вывод, ограниченный регулярными выражениями, JSON-схемами или грамматиками EBNF. Это планировщик, менеджер памяти, система верификации и компилятор ограничений. Ядра в этом списке почти что на втором плане.
Это совпадает с тем, что практики раз за разом переоткрывают заново. Прямой проход — простая часть. Её по сути решили ещё со времён FlashAttention и хороших библиотек GEMM. Сложная часть — постоянно загружать GPU работой. Каждая миллисекунда простоя SM, пока CPU решает, какие запросы допустить, какие KV-блоки вытеснить или какие черновые токены верифицировать, — это деньги на ветер. Асинхронный планировщик DeepInfer как раз и существует для того, чтобы совмещать планирование на CPU с выполнением на устройстве, чтобы GPU никогда не ждал Python. Если ваш стек до сих пор планирует синхронно, одно это изменение, скорее всего, даст больше, чем любая замена ядра, которую вы планировали.
В README есть и показательное признание: полноценному сервису инференса дополнительно нужны система KV-кэша, разделение prefill и decode на разные узлы и балансировка нагрузки между репликами с data parallelism. Ничего этого в релизе нет. Иными словами, даже сам движок — лишь один слой настоящей системы. Продакшн-инференс — это задача распределённых систем, которая носит костюм машинного обучения. Мы уже писали о том, что LLM-агенты во многом похожи на распределённые системы, и это точно так же применимо на один уровень ниже в стеке.
Миф 2: чем больше батч, тем лучше
Continuous batching, то есть добавление новых запросов в батч сразу, как только освобождаются другие, а не ожидание завершения всего батча, сегодня уже обязательный минимум, и DeepInfer, разумеется, это умеет. Но более интересное убеждение для проверки — упрощённая версия: «пропускная способность растёт с размером батча, значит, максимизируй батч». DeepInfer содержит два механизма, которые существуют именно потому, что это неверно.
Во-первых, батч-инвариантный инференс (DEEPINFER_BATCH_INVARIANT=1). Обычно результат запроса может немного меняться в зависимости от того, что ещё попало в его батч, потому что порядок редукций в ядрах зависит от состава батча, а сложение с плавающей точкой не ассоциативно. DeepSeek сочла нужным потратить инженерные усилия на то, чтобы результаты совпадали при любом составе батча. Почему? Потому что при масштабе вы быстро замечаете: клиенты и пайплайны оценки видят, когда один и тот же промпт в разные дни возвращает разные токены. Если максимизация батча означала принятие недетерминизма, DeepSeek предпочла потратить пропускную способность на то, чтобы вернуть детерминизм. Это говорит о том, что реальная целевая функция — не сырые токены в секунду, а токены в секунду, которым можно доверять.
Во-вторых, верификация с планированием по уверенности для спекулятивного декодирования. Движок генерирует черновые токены (по умолчанию максимальная длина черновика 5) и использует оценки уверенности, чтобы решить, сколько работы по верификации запланировать. Наивный подход верифицирует черновик фиксированной длины на каждом шаге; умный признаёт, что оптимальный объём спекулятивной работы зависит от запроса и от шага. Если батчить больше спекулятивной работы, чем позволяет уверенность, вы тратите вычисления на токены, которые всё равно выбросите. Если батчить меньше, упускаете ускорение. Планировщик решает задачу оптимизации на каждом шаге, а не просто впихивает запросы в батч.
- Размер батча повышает пропускную способность, но и задержку: время до первого токена растёт вместе с батчами prefill.
- Состав батча меняет численные результаты: если не платить за батч-инвариантные ядра, выводы будут дрейфовать.
- Спекулятивная работа даёт убывающую отдачу: доля принятых черновых токенов падает с ростом длины черновика, так что фиксированные расписания тратят FLOPs впустую.
- KV-кэш — настоящий потолок: батч не может расти дальше того, что помещается в память, поэтому раскладка памяти важнее политики батчинга.
Миф 3: управление KV-кэшем — уже решённая задача
PagedAttention популяризировал подход в духе ОС: выделять KV-кэш страницами фиксированного размера, раздавать их как виртуальную память и перестать фрагментировать. vLLM доказал, что это работает, а DeepInfer, по собственным упоминаниям авторов, изначально строился в основном на vLLM. Значит, страничный KV-кэш — дело решённое, верно? Не совсем. В README DeepInfer вскользь упоминается нечто куда более агрессивное: одной из целей проектирования продакшн-системы было хранение KV-кэша дольше 72 часов.
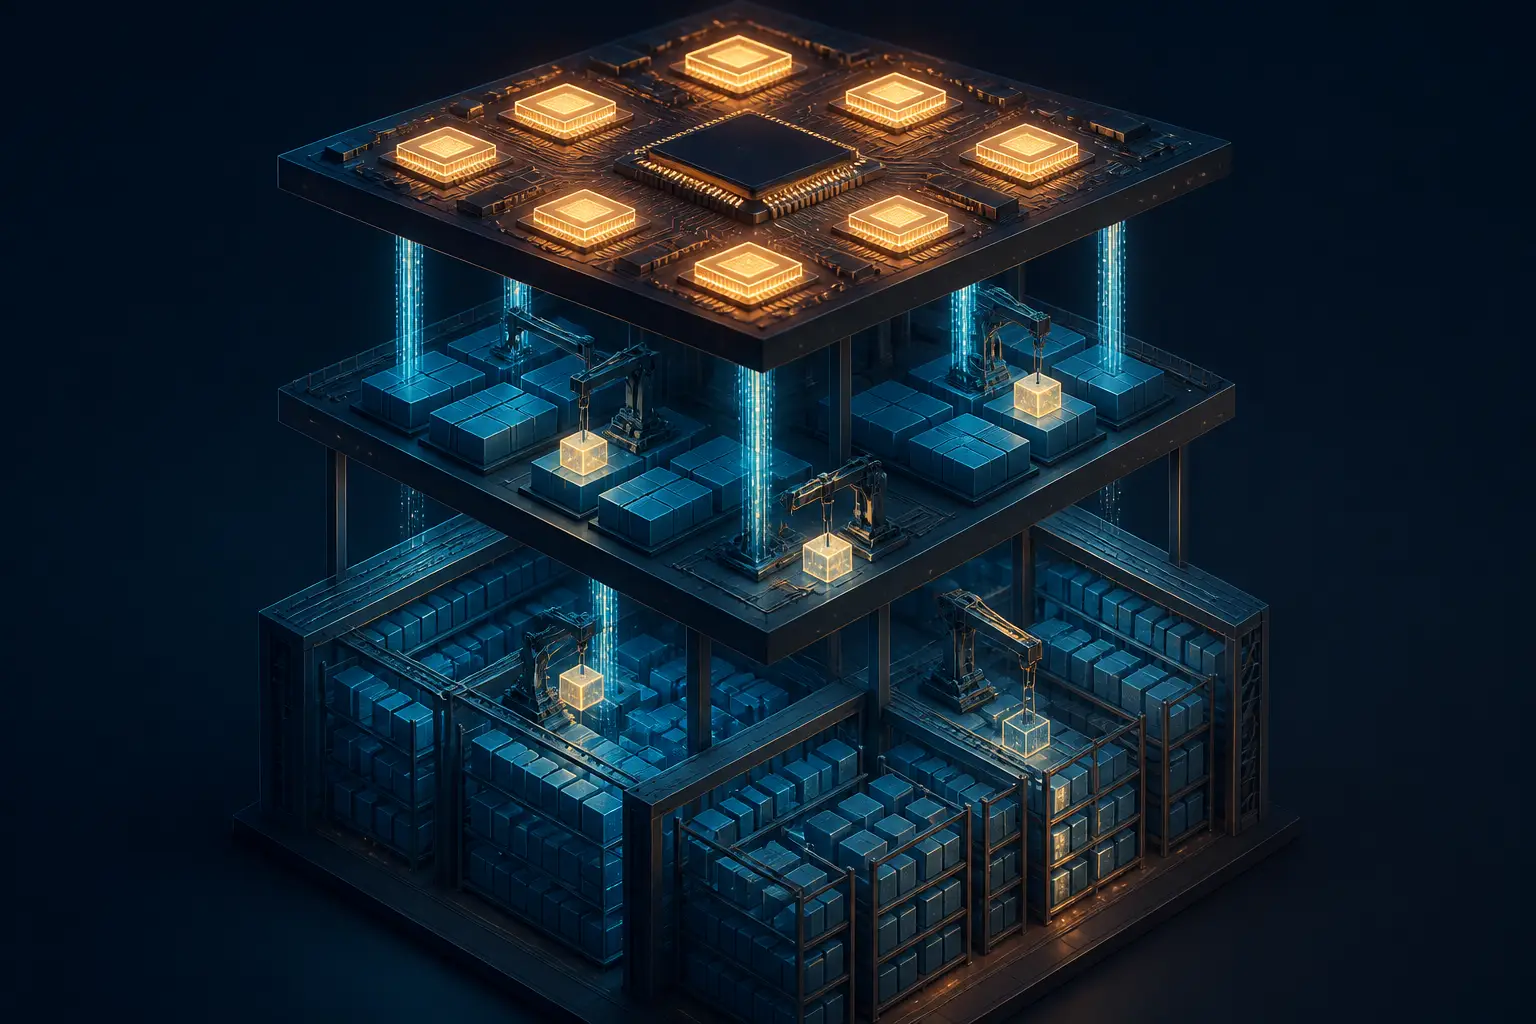
Подумайте, что это значит. HBM даже на самых больших GPU измеряется сотнями гигабайт, а 72-часовой кэш на загруженном кластере — это петабайты состояния. Удержать такое на устройстве невозможно. Нужна многоуровневая KV-система: HBM, оперативная память хоста, NVMe, возможно удалённое хранилище, с политиками вытеснения и предвыборки достаточно умными, чтобы возврат устаревшего префикса не сломал ваш латентный SLO. Поэтому README и перечисляет «систему KV-кэша» среди того, что не входит в релиз: это отдельная, серьёзная инфраструктура. Если вы до сих пор считаете KV-кэш задачей страничного управления внутри GPU, передовая линия сместилась: теперь это задача систем хранения. Мы разбирали уменьшенную версию этой проблемы в тексте о том, что делать, когда в GPU кончается VRAM, но здесь та же проблема в масштабе дата-центра.
Есть и более тонкий приём с KV, который стоит перенять: ограниченное повторное воспроизведение для SWA. Для слоёв декодера со sliding-window attention не нужно заново прогонять весь промпт на prefill, достаточно ограниченного суффикса, который покрывает окно внимания плюс максимальную длину отката (по умолчанию сохраняется 140 токенов). Это прямое сокращение вычислений prefill для длинных контекстов, и такую оптимизацию находишь, только когда профилируешь, куда реально уходят FLOPs prefill. Универсальные движки не могут делать это безопасно: нужно очень хорошо знать архитектуру внимания модели. Движки, заточенные под конкретную модель, снова выигрывают.
Миф 4: спекулятивное декодирование даёт пропускную способность бесплатно
У спекулятивного декодирования почти магическая подача: генерировать несколько токенов за один прямой проход с помощью дешёвого черновика, проверить их параллельно и оставить совпавшие. Бенчмарки его обожают. Но убеждение, что это «бесплатно», рассыпается, как только читаешь, как DeepInfer на самом деле его разворачивает. Флаги говорят сами за себя: DEEPINFER_ENABLE_MTP_VARLEN=1 включает его, DEEPINFER_USE_NEXTN_DECODE ограничивает длину черновика, а сверху есть отдельный слой планирования по уверенности. Будь это бесплатно, ничего из этого не понадобилось бы: просто всегда писали бы черновики.
Экономика устроена так. Составление и проверка черновика стоят дополнительных FLOPs на каждом шаге. Выигрыш появляется, только если доля принятых токенов достаточно высока, чтобы прирост токенов на шаг перекрыл накладные расходы. Доля принятых зависит от механизма черновика, от предметной области (код на черновики ложится отлично, а сбивчивая проза — не очень) и, что критично, от нагрузки на батч. При больших батчах GPU уже упёрт в вычисления, и дополнительные FLOPs верификации напрямую вытесняют полезную работу. Спекулятивное декодирование хорошо работает в режиме, ограниченном латентностью, и может реально навредить в режиме, ограниченном пропускной способностью. Продакшн-движку, который обслуживает оба режима, нужно планировать его адаптивно, и именно это и делает верификация с планированием по уверенности.
Моё мнение после того, как я наблюдал, как команды прикручивают спекулятивное декодирование к стекам обслуживания: относитесь к нему как к функции для латентности, а не для пропускной способности. Если узкое место — токены на доллар при высокой утилизации, сначала почините планировщик и раскладку KV. Если узкое место — p99-латентность для интерактивных пользователей при умеренной нагрузке, спекулятивное декодирование — один из лучших доступных инструментов, а DeepInfer даёт проверенный на практике эталон того, как его включать с умом.
Миф 5: чтобы обслуживать в масштабе, нужно благословение NVIDIA (и ничего больше)
DeepInfer поддерживает ровно две аппаратные платформы: GPU NVIDIA SM100 и NPU Huawei Ascend 950. Для каждой платформы ведутся отдельные файлы требований (requirements-nvidia.txt, requirements-ascend.txt), и функции соответственно ограничены: например, батч-инвариантный инференс работает только на NVIDIA. Это тихое, но важное заявление. Продакшн-движок высшего уровня относится к ускорителю не от NVIDIA как к полноправному варианту, с той же моделью, тем же планировщиком и той же архитектурой обслуживания.
Чтобы не было недопонимания: это не значит, что путь через Ascend зрелый, и не значит, что монополия CUDA исчезнет за ночь. Функции, работающие только на CUDA, в том же README — доказательство того, что разрыв в экосистеме реален. Но это значит, что самая сложная программная задача переносимости инференса (движок, планировщик, стратегия параллелизма) теперь открыта, распространяется под Apache и с самого начала спроектирована для двух целевых платформ. Для небольших лабораторий и производителей железа это основа, на которой можно строить, а не стена, которую нужно копировать. Всем, кто следит за сегментом быстрых моделей, известно, насколько экономика зависит от этого; мы уже писали о том, что модели быстрого класса — настоящая история эффективности инференса, а разнообразие железа её только усиливает.
Стоит упомянуть и дизайн параллелизма: data parallelism для внимания со сбалансированным context parallelism, плюс expert parallelism для слоёв MoE с балансировщиком нагрузки по экспертам. Эта комбинация настроена именно под тот сценарий развёртывания, который описывает DeepSeek: несколько GPU для prefill и десятки для decode, разнесённые по разным узлам. Разделение decode на отдельные узлы становится стандартной архитектурой для больших парков обслуживания, и причина проста арифметика: prefill упирается в вычисления, а decode — в пропускную способность памяти, поэтому совместное размещение заставляет покупать железо, оптимальное ни для одного из них.
Миф 6: можно просто взять и запустить
Последнее убеждение, которое стоит развенчать, адресовано всем, кто поставил репозиторию звезду и собирается подключить его к своему стеку на этих выходных. Сейчас DeepInfer обслуживает ровно одно семейство моделей: DeepSeek-V4.1-Flash. Ему нужны Linux, GCC 13+, Python 3.12, CUDA 13 и железо SM100, то есть поколение Blackwell, которого у большинства из нас нет под рукой. Бенчмарки измерялись на 4 GPU для prefill и 64 для decode внутри одного домена масштабирования вверх. А три вещи, без которых не обойтись в реальном сервисе, — система KV-кэша, инфраструктура разделения узлов и балансировка между репликами — явно вне рамок проекта. Это движок, а не автомобиль.
Но списывать его как непригодный значит упускать главное, и тут я буду категоричен. Ценность релиза не столько в программе для развёртывания, сколько в описании того, что на самом деле значит продакшн-уровень. Батч-инвариантный инференс как флаг первого класса. Детерминированное сэмплирование с фиксированным seq_seed для воспроизводимости. Структурированный вывод, скомпилированный в сэмплер, а не прикрученный сверху с повторными попытками. Спекуляция с планированием по уверенности. Асинхронное планирование по умолчанию, а не эксперимент. Если вы строите или покупаете стек инференса, этот README — чек-лист. Если вы сами запускаете большие модели (а для малых масштабов у нас есть практическое руководство по запуску LLM на своём железе), те же приоритеты действуют, просто в другом масштабе: сначала планировщик, второе место — раскладка памяти, третье — ядра.
Прямой проход — простая часть. Продакшн-инференс — это планировщик, менеджер памяти и система верификации, которые заодно вызывают ядра.
Геополитическое время выхода, за считаные часы до федерального приказа США об исключении, и комментарии, которые называют релиз чем угодно от подарка до диверсии, неизбежно затмят заголовки. Ладно. Но если убрать драму, инженерный вывод стоит на собственных ногах: большая часть того, что мы считали правдой об inference-движках, отстала на целое поколение. Интересная работа теперь не в ядрах. Она во всём, что их окружает.


