DeepSeek का LLM इनफरेंस इंजन: 5 मिथक की जाँच
DeepSeek ने अपना प्रोडक्शन LLM इनफरेंस इंजन ओपन-सोर्स किया। DeepInfer के असली संकेतों से इनफरेंस इंजन के पाँच आम विश्वासों की जाँच।
 Sarah Chen

जब DeepSeek ने अपना प्रोडक्शन LLM इनफरेंस इंजन Apache 2.0 लाइसेंस के तहत GitHub पर डाला, तो रेपो कुछ ही घंटों में हज़ारों स्टार पर पहुँच गया। इसमें हैरानी की बात नहीं है, लेकिन हैरान करने वाली बात यह है कि इसके अंदर असल में क्या है। DeepInfer कोई रिसर्च का खिलौना या छोटा-सा डेमो नहीं है। DeepSeek के अपने दावे के मुताबिक, यही वह इंजन है जो DeepSeek-V4.1-Flash को प्रति क्लस्टर 155 ट्रिलियन टोकन प्रतिदिन के दावा किए गए पैमाने पर सर्व करता है, और ऑफ-पीक प्राइसिंग पर लगभग $38 प्रति GPU-hour की कमाई होती है। ये आँकड़े अगर मोटे तौर पर भी सही हैं, तो ये उन इंजीनियरिंग फ़ैसलों से आते हैं जिन्हें इंडस्ट्री का बड़ा हिस्सा अब तक लोककथा मानता रहा है। तो चलिए वही करते हैं जो मैं किसी भी नए ओपन-सोर्स प्रोडक्शन सिस्टम के साथ करता हूँ: README को एक संदेहवादी की नज़र से पढ़ना और इनफरेंस इंजन के बारे में आम मान्यताओं को उसके सामने परखना।
मिथक 1: इनफरेंस इंजन बस एक तेज़ फ़ॉरवर्ड पास है
आम तौर पर सोच यह होती है: मॉडल ही मॉडल है, इंजन बस कर्नेल्स को कॉल करने वाला एक पतला रैपर है, और परफ़ॉर्मेंस तेज़ GPU खरीदने से आती है। DeepInfer की अपनी फ़ीचर लिस्ट इस सोच को ध्वस्त कर देती है। देखिए कि वह किन चीज़ों को भेजने लायक समझता है: “zero-overhead batch scheduler” वाली असिंक्रोनस शेड्यूलिंग, confidence-scheduled verification वाली speculative decoding, sliding-window-attention bounded replay, batch-invariant inference, deterministic sampling, और regex, JSON schema या EBNF grammar तक सीमित structured outputs। यह एक शेड्यूलर, एक मेमोरी मैनेजर, एक verification सिस्टम और एक constraint compiler है। इस सूची में कर्नेल्स लगभग एक बाद का ख़्याल लगते हैं।
यही बात वे व्यावहारिक लोग बार-बार दोबारा सीखते हैं। फ़ॉरवर्ड पास आसान हिस्सा है; FlashAttention और अच्छी GEMM लाइब्रेरी के बाद से यह लगभग हल हो चुका है। असली मुश्किल GPU को भूखा न रहने देना है। हर मिलीसेकंड जिसमें SMs खाली बैठे हैं, जबकि CPU तय कर रहा है कि कौन सी रिक्वेस्ट लेनी है, कौन से KV blocks हटाने हैं, या कौन से draft tokens verify करने हैं, वह पैसा बर्बाद होने जैसा है। DeepInfer का async scheduler ठीक इसी के लिए है: CPU शेड्यूलिंग को डिवाइस एक्ज़िक्यूशन के साथ ओवरलैप करना, ताकि GPU कभी Python का इंतज़ार न करे। अगर आपका सर्विंग स्टैक अब भी सिंक्रोनस तरीके से शेड्यूल करता है, तो यह अकेला बदलाव शायद उस किसी भी kernel swap से ज़्यादा फ़ायदेमंद होगा जिसकी आप योजना बना रहे थे।
README में एक खुलासा करने वाली बात भी है: पूरी इनफरेंस सर्विस को अतिरिक्त रूप से KV cache system, prefill/decode disaggregation, और data-parallel replicas पर load balancing चाहिए, और इनमें से कुछ भी शामिल नहीं है। यानी इंजन खुद असली सिस्टम की सिर्फ़ एक परत है। प्रोडक्शन इनफरेंस एक distributed-systems समस्या है जिसने machine-learning का चोला पहना हुआ है। यह बात हम पहले भी LLM एजेंट्स के distributed systems जैसे दिखने के बारे में कह चुके हैं, और यह स्टैक की एक परत नीचे भी उतनी ही लागू होती है।
मिथक 2: बड़े बैच हमेशा बेहतर होते हैं
Continuous batching, यानी बाकी रिक्वेस्ट्स खत्म होते ही नई रिक्वेस्ट्स को बैच में डाल देना, पूरे बैच के खत्म होने का इंतज़ार किए बिना, अब बुनियादी ज़रूरत बन चुकी है, और DeepInfer यह ज़ाहिर तौर पर करता है। लेकिन परखने लायक ज़्यादा दिलचस्प मान्यता वह ढीली-ढाली वर्शन है: “throughput बैच साइज़ के साथ बढ़ता है, इसलिए बैच को अधिकतम करो।” DeepInfer में दो फ़ीचर हैं जो ठीक इसलिए मौजूद हैं क्योंकि यह बात गलत है।
पहला, batch-invariant inference (DEEPINFER_BATCH_INVARIANT=1)। आम तौर पर किसी रिक्वेस्ट का आउटपुट इस पर निर्भर करके बदल सकता है कि उसके बैच में और क्या है, क्योंकि कर्नेल्स में reduction का क्रम बैच की संरचना के साथ बदलता है, और floating-point जोड़ associative नहीं होता। DeepSeek ने इंजीनियरिंग की मेहनत इस बात पर लगाना ज़रूरी समझा कि बैच की संरचना चाहे जैसी हो, नतीजे एक जैसे रहें। क्यों? क्योंकि बड़े पैमाने पर सर्व करते हुए आप पाते हैं कि ग्राहक और eval pipelines तब ध्यान देते हैं जब वही prompt अलग-अलग दिनों में अलग tokens लौटाता है। अगर बैच साइज़ अधिकतम करने का मतलब नॉन-डिटरमिनिज़्म स्वीकार करना होता, तो DeepSeek ने थ्रूपुट खर्च करके डिटरमिनिज़्म वापस खरीदना चुना। इससे पता चलता है कि असली objective function कच्चे tokens per second नहीं है, बल्कि भरोसेमंद tokens per second है।
दूसरा, speculative decoding के लिए confidence-scheduled verification। इंजन tokens draft करता है (डिफ़ॉल्ट max draft length 5) और यह तय करने के लिए confidence estimates का इस्तेमाल करता है कि verification का कितना काम शेड्यूल करना है। सीधा तरीका हर स्टेप पर एक तय लंबाई का draft verify करता है; स्मार्ट तरीका मानता है कि speculative काम की सही मात्रा हर रिक्वेस्ट और हर स्टेप पर अलग होती है। confidence से ज़्यादा speculative काम बैच करने पर उन tokens पर compute बर्बाद होता है जिन्हें आप फेंक देंगे। कम बैच करने पर speedup छूट जाता है। शेड्यूलर हर स्टेप पर एक optimization problem हल कर रहा है, न कि बस रिक्वेस्ट्स को ठूँस रहा है।
- बैच साइज़ throughput बढ़ाता है, पर latency भी। बड़े prefill बैच में time-to-first-token बिगड़ता है।
- बैच की संरचना numerics बदलती है। जब तक batch-invariant kernels के लिए कीमत न चुकाएँ, आउटपुट बदलते हैं।
- Speculative काम के घटते फ़ायदे हैं। draft लंबाई बढ़ने पर acceptance rate गिरता है, इसलिए तय शेड्यूल FLOPs बर्बाद करता है।
- KV cache असली सीमा है। बैच उससे आगे नहीं बढ़ सकता जितना मेमोरी रख सके, इसीलिए memory layout बैच नीति से ज़्यादा मायने रखता है।
मिथक 3: KV cache प्रबंधन एक हल हो चुकी समस्या है
PagedAttention ने OS-शैली का तरीका लोकप्रिय किया: KV cache को निश्चित आकार के pages में आवंटित करो, उन्हें virtual memory की तरह बाँटो, और fragmentation बंद करो। vLLM ने साबित किया कि यह काम करता है, और DeepInfer खुद अपनी स्वीकृतियों के अनुसार मूल रूप से मुख्य रूप से vLLM पर बना था। तो paged KV cache तो हल हो गया होगा, है न? पूरी तरह नहीं। DeepInfer के README में एक और ज़्यादा आक्रामक बात लापरवाही से लिखी है: प्रोडक्शन सिस्टम का एक डिज़ाइन लक्ष्य था KV cache को 72 घंटे से ज़्यादा तक रखना।
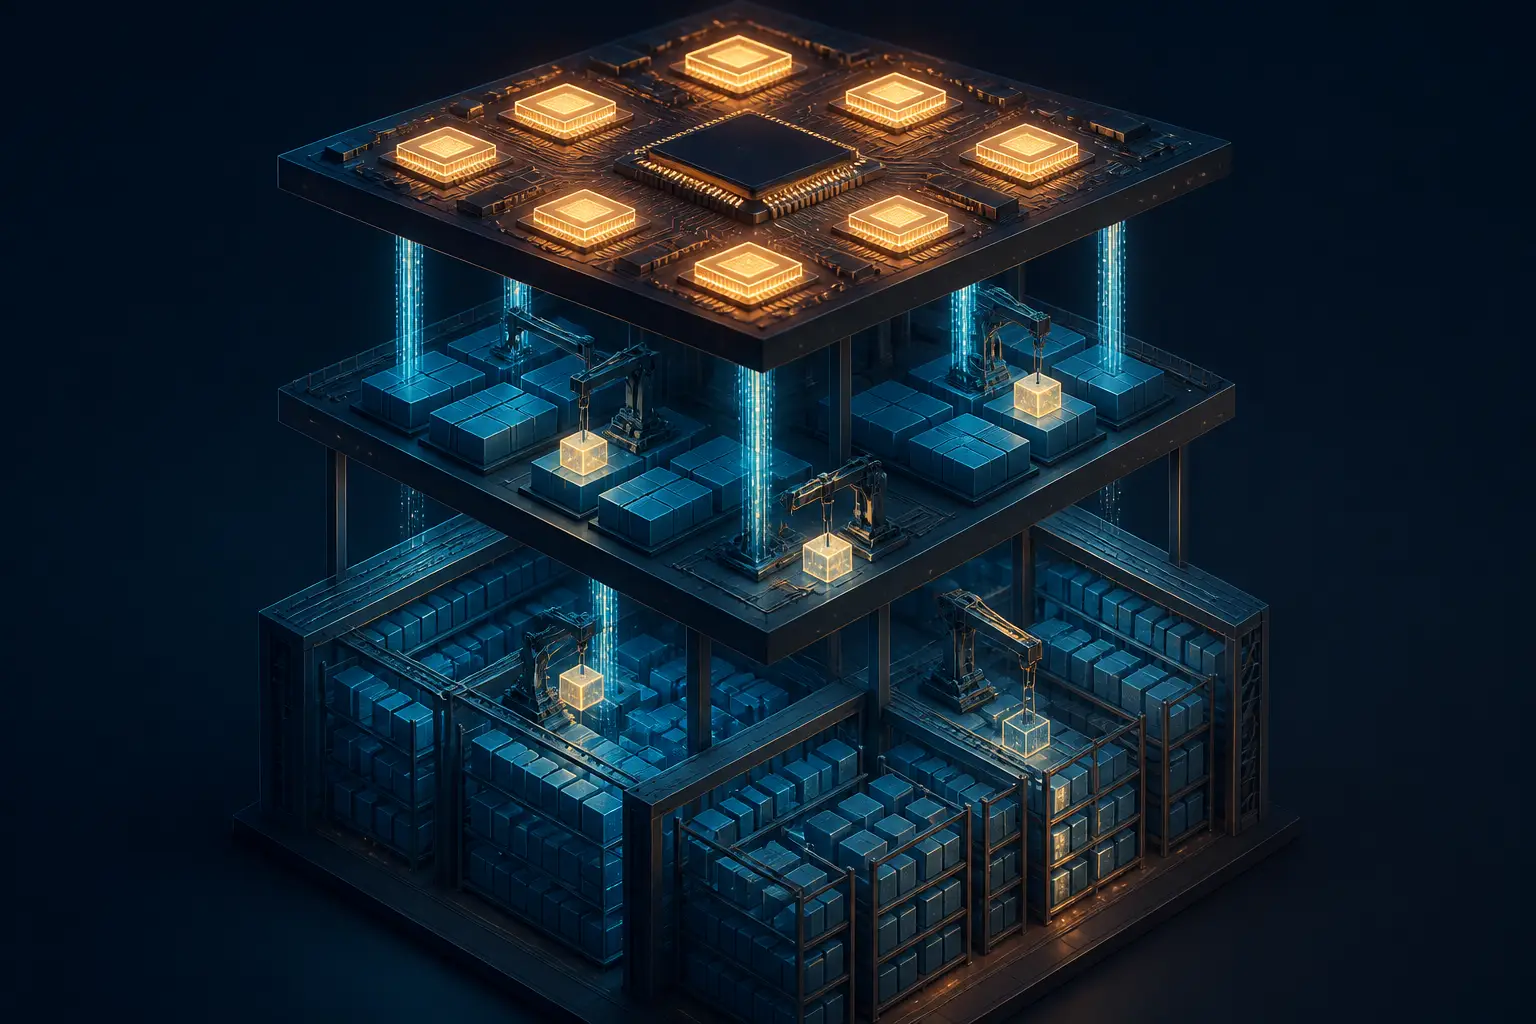
सोचिए इसका मतलब क्या है। सबसे बड़े GPU पर भी HBM सैकड़ों gigabytes में मापी जाती है; एक व्यस्त क्लस्टर पर 72 घंटे का cache petabytes का state है। इसे डिवाइस पर नहीं रखा जा सकता। आपको tiered KV सिस्टम चाहिए: HBM, host DRAM, NVMe, शायद remote storage, और eviction व prefetch नीतियाँ इतनी स्मार्ट हों कि किसी पुराने prefix को वापस लाने से आपका latency SLO न बिगड़े। इसीलिए README “a KV cache system” को रिलीज़ में शामिल नहीं बताता: यह एक अलग, गंभीर infrastructure है। अगर आप KV cache को अब तक GPU के अंदर की paging समस्या मानते रहे हैं, तो मोर्चा अब उसे storage system मानने की ओर चला गया है। इस दर्द के छोटे पैमाने वाले रूप पर हमने जब आपका GPU VRAM से बाहर निकल जाए तो क्या करें में बात की थी, लेकिन यह वही समस्या डेटासेंटर के पैमाने पर है।
एक सूक्ष्म KV तरकीब भी है जिसे उधार लेने लायक है: SWA bounded replay। decoder की sliding-window attention layers के लिए prefill के दौरान पूरा prompt दोबारा चलाने की ज़रूरत नहीं है, सिर्फ़ एक सीमित suffix चाहिए जो attention window और अधिकतम backtracking length को कवर करे (डिफ़ॉल्ट: 140 tokens रखो)। इससे लंबे contexts पर prefill compute सीधा घटता है, और यह वह अनुकूलन है जो आप तभी खोजते हैं जब profile करते हैं कि prefill FLOPs असल में कहाँ जाते हैं। सामान्य इंजन इसे सुरक्षित रूप से नहीं कर सकते; इसके लिए मॉडल की attention architecture की गहरी जानकारी चाहिए। मॉडल-विशिष्ट इंजन फिर से जीतते हैं।
मिथक 4: Speculative decoding मुफ़्त throughput है
Speculative decoding का एक लगभग जादुई वादा है: एक सस्ते draft से हर forward pass में कई tokens generate करो, उन्हें समानांतर verify करो, जो मेल खाए उसे रख लो। Benchmarks इसे पसंद करते हैं। लेकिन इसे “मुफ़्त” मानने की मान्यता तब टूट जाती है जब आप पढ़ते हैं कि DeepInfer इसे असल में कैसे deploy करता है। flags कहानी कहते हैं: इसे चालू करने के लिए DEEPINFER_ENABLE_MTP_VARLEN=1, draft length सीमित करने के लिए DEEPINFER_USE_NEXTN_DECODE, और ऊपर एक अलग confidence-scheduling layer। अगर यह मुफ़्त होता, तो इन सबकी ज़रूरत नहीं पड़ती। आप बस हमेशा draft करते।
अर्थशास्त्र ऐसे काम करता है। Draft और verify करने में हर स्टेप पर अतिरिक्त FLOPs लगते हैं। आपको तभी फ़ायदा होता है जब acceptance rate इतना ऊँचा हो कि tokens-per-step का लाभ overhead से ज़्यादा हो। Acceptance rate draft तंत्र, domain (code बढ़िया draft होता है; बिखरा हुआ गद्य कम), और, सबसे अहम, batch load पर निर्भर करता है। ऊँचे बैच साइज़ पर GPU पहले ही compute-bound होता है, इसलिए अतिरिक्त verification FLOPs असली काम को सीधे बाहर धकेल देते हैं। Speculative decoding latency-bound स्थिति में चमकता है और throughput-bound स्थिति में असल में नुकसान कर सकता है। जो प्रोडक्शन इंजन दोनों स्थितियों की सेवा करता है, उसे इसे adaptively शेड्यूल करना पड़ता है, और confidence-scheduled verification ठीक यही करता है।
मेरी राय, उन टीमों को देखने के बाद जिन्होंने सर्विंग स्टैक में speculative decoding जोड़ा: इसे throughput फ़ीचर नहीं, latency फ़ीचर मानिए। अगर आपकी रुकावट ऊँचे utilization पर tokens per dollar है, तो पहले अपना शेड्यूलर और KV layout ठीक कीजिए। अगर आपकी रुकावट मध्यम लोड पर interactive users के लिए p99 latency है, तो speculative decoding उपलब्ध सबसे अच्छे औज़ारों में से एक है, और DeepInfer इसे gate करने का परखा हुआ reference देता है।
मिथक 5: बड़े पैमाने पर सर्व करने के लिए आपको सिर्फ़ NVIDIA की मंज़ूरी (और कुछ नहीं) चाहिए
DeepInfer ठीक दो hardware targets को सपोर्ट करता है: NVIDIA SM100 GPUs और Huawei Ascend 950 NPUs। यह हर प्लेटफ़ॉर्म के लिए अलग requirement files रखता है (requirements-nvidia.txt, requirements-ascend.txt) और उसी के हिसाब से फ़ीचर्स को gate करता है; उदाहरण के लिए batch-invariant inference सिर्फ़ NVIDIA पर है। यह एक चुपचाप लेकिन अहम बयान है। एक शीर्ष स्तर का प्रोडक्शन इंजन गैर-NVIDIA accelerator को पहली श्रेणी के नागरिक की तरह देखता है, उसी मॉडल, उसी शेड्यूलर और उसी सर्विंग architecture के साथ।
यह क्या करता है और क्या नहीं, इसे साफ़ कर दूँ: इसका मतलब यह नहीं कि Ascend रास्ता परिपक्व है, और न ही यह कि CUDA का किला रातों-रात खत्म हो गया। उसी README के CUDA-only फ़ीचर्स साबित करते हैं कि इकोसिस्टम का अंतर असली है। इसका मतलब यह है कि inference portability की सबसे कठिन software समस्या (इंजन, शेड्यूलर, parallelism रणनीति) अब खुली, Apache-लाइसेंस वाली है और शुरू से dual-target के लिए बनी है। छोटी labs और hardware vendors के लिए यह एक नींव है जिस पर निर्माण किया जा सकता है, न कि ऐसी दीवार जिसकी नकल करनी पड़े। Flash-tier सेगमेंट पर नज़र रखने वाले जानते हैं कि अर्थशास्त्र इस पर कितना निर्भर है; हम पहले भी कह चुके हैं कि flash-tier मॉडल ही असली inference efficiency की कहानी हैं, और hardware की विविधता उसे और बढ़ाती है।
Parallelism डिज़ाइन का भी ज़िक्र ज़रूरी है: attention के लिए balanced context-parallel के साथ data-parallel, और MoE layers के लिए expert-parallel के साथ expert-parallel load balancer। यह संयोजन ठीक उसी deployment के लिए ट्यून है जो DeepSeek बताता है: prefill के लिए कुछ GPUs और decode के लिए दर्जनों, disaggregated। Decode-heavy disaggregation बड़े सर्विंग फ़्लीट्स के लिए डिफ़ॉल्ट architecture बनता जा रहा है, और इसका कारण सीधा गणित है: prefill compute-bound है और decode memory-bandwidth-bound, इसलिए इन्हें एक साथ रखने पर आपको ऐसा hardware खरीदना पड़ता है जो किसी के लिए भी आदर्श न हो।
मिथक 6: आप इसे उठाकर बस चला सकते हैं
आख़िरी मान्यता, उन सबके लिए जिन्होंने यह repo स्टार किया और इस वीकेंड अपने स्टैक में जोड़ने की योजना बना रहे हैं। DeepInfer अभी ठीक एक model family सर्व करता है: DeepSeek-V4.1-Flash। इसे Linux, GCC 13+, Python 3.12, CUDA 13 और SM100 hardware चाहिए, यानी Blackwell-पीढ़ी, जो हम में से ज़्यादातर के पास नहीं पड़ा होता। Benchmarks एक scale-up domain में prefill के लिए 4 GPUs और decode के लिए 64 GPUs पर मापे गए। और एक असली सर्विस के लिए ज़रूरी तीन चीज़ें, यानी KV cache system, disaggregation plumbing, और replica load balancing, साफ़ तौर पर दायरे से बाहर हैं। यह इंजन है, गाड़ी नहीं।
लेकिन इसे बेकार कह देना असली बात चूक जाना है, और यहीं मैं अपनी राय खुलकर रखूँगा। यह रिलीज़ उतनी डिप्लॉय करने लायक software के रूप में कीमती नहीं है, जितनी इस बात की specification के रूप में कि प्रोडक्शन-ग्रेड का असली मतलब क्या है। Batch-invariant inference एक पहली श्रेणी का flag है। Reproducibility के लिए fixed seq_seed के साथ deterministic sampling है। Structured outputs retries से जोड़े जाने के बजाय sampler में compile होते हैं। Confidence-scheduled speculation है। Async scheduling डिफ़ॉल्ट है, प्रयोग नहीं। अगर आप इनफरेंस स्टैक बना रहे हैं या खरीद रहे हैं, तो यह README एक checklist है। अगर आप खुद बड़े मॉडल चला रहे हैं, और छोटे सिरे के लिए हमारे पास अपने हार्डवेयर पर LLM चलाने की व्यावहारिक गाइड है, तो वही प्राथमिकताएँ लागू होती हैं, बस अलग पैमाने पर: पहले शेड्यूलर, दूसरे memory layout, तीसरे kernels।
Forward pass आसान हिस्सा है। प्रोडक्शन इनफरेंस एक शेड्यूलर, एक memory manager और एक verification सिस्टम है, जो संयोग से kernels को कॉल करता है।
भू-राजनीतिक समय, यानी U.S. federal exclusion order के कुछ घंटों बाद आना, जिस पर टिप्पणियों में इसे उपहार से लेकर तोड़फोड़ तक सब कहा जा रहा है, सुर्ख़ियों पर हावी रहेगा। ठीक है। लेकिन नाटक हटा दें, तो इंजीनियरिंग का फ़ैसला अपने आप खड़ा रहता है: इनफरेंस इंजन के बारे में हम जो मानते थे, उसका ज़्यादातर हिस्सा एक पीढ़ी पुराना था। अब दिलचस्प काम kernels में नहीं है। वह उनके आसपास की हर चीज़ में है।


