Il motore di inferenza di DeepSeek: 5 miti, testati
DeepSeek ha rilasciato open source il suo motore di inferenza LLM. Testiamo cinque convinzioni comuni sugli inference engine alla luce di DeepInfer.
 Sarah Chen

Quando DeepSeek ha pubblicato su GitHub il suo motore di inferenza LLM in produzione con licenza Apache 2.0, il repository ha raggiunto migliaia di stelle in poche ore. Non sorprende: ciò che è sorprendente è quello che c'è davvero dentro. DeepInfer non è un giocattolo di ricerca né una demo semplificata. È il motore che, stando al resoconto dello stesso DeepSeek, serve DeepSeek-V4.1-Flash con una scala dichiarata di 155 trilioni di token al giorno per cluster, con ricavi intorno ai 38 dollari per ora-GPU a tariffe fuori picco. Questi numeri, anche solo approssimativamente corretti, derivano da scelte ingegneristiche che gran parte del settore considera folklore. Quindi facciamo quello che farei con qualsiasi sistema di produzione appena rilasciato open source: leggiamo il README con occhio scettico e verifichiamo le convinzioni comuni sugli inference engine alla luce di quello che contiene.
Mito 1: un inference engine è solo un forward pass veloce
Il modello mentale ingenuo è questo: il modello è il modello, il motore è un wrapper sottile che chiama i kernel, e le prestazioni arrivano dall'acquisto di GPU più veloci. La lista delle funzionalità di DeepInfer demolisce questa idea. Guardate cosa ritiene degno di essere distribuito: scheduling asincrono con un «batch scheduler a overhead zero», speculative decoding con verifica pianificata in base alla confidenza, sliding-window attention con replay limitato, inferenza batch-invariant, campionamento deterministico e output strutturati vincolati a regex, schemi JSON o grammatiche EBNF. Questo è uno scheduler, un gestore di memoria, un sistema di verifica e un compilatore di vincoli: i kernel, nella lista, sono quasi un ripensamento.
È quello che i professionisti continuano a riscoprire. Il forward pass è la parte facile; è sostanzialmente risolto dai tempi di FlashAttention e delle buone librerie GEMM. La parte difficile è tenere la GPU alimentata. Ogni millisecondo in cui gli SM restano inattivi mentre la CPU decide quali richieste ammettere, quali blocchi KV evacuare o quali token di bozza verificare è denaro che evapora. Lo scheduler asincrono di DeepInfer esiste proprio per sovrapporre lo scheduling su CPU all'esecuzione sul dispositivo, così la GPU non aspetta mai Python. Se il tuo stack di serving schedula ancora in modo sincrono, quella singola modifica probabilmente vale più di qualsiasi sostituzione di kernel che avevi in programma.
Il README contiene anche un'ammissione rivelatrice: un servizio di inferenza completo richiede inoltre un sistema di KV cache, la disaggregazione prefill/decode e il bilanciamento del carico tra repliche data-parallel, e nessuno di questi è incluso. In altre parole, anche il motore è solo uno strato del sistema reale. L'inferenza in produzione è un problema di sistemi distribuiti travestito da machine learning. È un punto che abbiamo già sollevato parlando di agenti LLM che assomigliano molto a sistemi distribuiti, e vale altrettanto un livello più in basso nello stack.
Mito 2: batch più grandi sono sempre meglio
Il continuous batching (ammettere nuove richieste nel batch appena altre sono terminate, anziché aspettare l'intero batch) è ormai lo standard minimo, e DeepInfer lo fa senza dubbio. Ma la convinzione più interessante da verificare è la versione approssimativa: «il throughput scala con la dimensione del batch, quindi massimizza il batch». DeepInfer include due funzionalità che esistono proprio perché questa idea è sbagliata.
Primo, inferenza batch-invariant (DEEPINFER_BATCH_INVARIANT=1). Normalmente l'output di una richiesta può variare in base a ciò che si trova nello stesso batch, perché l'ordine delle riduzioni nei kernel cambia con la composizione del batch e la somma in virgola mobile non è associativa. DeepSeek ha ritenuto che valesse la pena di investire ingegneria per rendere i risultati identici indipendentemente dalla composizione del batch. Perché? Perché una volta che si serve su larga scala, si scopre che clienti e pipeline di valutazione se ne accorgono quando lo stesso prompt restituisce token diversi in giorni diversi. Se massimizzare la dimensione del batch volesse dire accettare la non determinicità, DeepSeek ha scelto di spendere throughput per riguadagnare il determinismo. Questo ti dice che la vera funzione obiettivo non sono i token al secondo grezzi: sono i token al secondo affidabili.
Secondo, verifica pianificata in base alla confidenza per lo speculative decoding. Il motore produce bozze di token (lunghezza massima di default 5) e usa stime di confidenza per decidere quanto lavoro di verifica pianificare. L'approccio ingenuo verifica una bozza di lunghezza fissa a ogni passo; quello intelligente riconosce che la quantità ottimale di lavoro speculativo varia per richiesta e per passo. Mettere nel batch più lavoro speculativo di quanto la confidenza giustifichi spreca calcolo su token che verranno scartati. Metterne meno lascia velocità sul tavolo. Lo scheduler risolve un problema di ottimizzazione a ogni passo, non si limita a stipare richieste nel batch.
- La dimensione del batch aumenta il throughput ma anche la latenza: il time-to-first-token peggiora man mano che crescono i batch di prefill.
- La composizione del batch cambia la numerica: a meno di pagare per kernel batch-invariant, gli output divergono.
- Il lavoro speculativo ha rendimenti decrescenti: i tassi di accettazione delle bozze calano con la lunghezza della bozza, quindi i programmi fissi sprecano FLOP.
- La KV cache è il vero limite: il batch non può crescere oltre ciò che la memoria può contenere, ed è per questo che la disposizione della memoria conta più della politica di batch.
Mito 3: la gestione della KV cache è un problema risolto
PagedAttention ha reso popolare l'approccio in stile sistema operativo: allocare la KV cache in pagine di dimensione fissa, distribuirle come la memoria virtuale e smettere di frammentare. vLLM ha dimostrato che funziona, e DeepInfer, stando alle sue stesse dichiarazioni, era originariamente costruito in gran parte su vLLM. Quindi la KV cache paginata dovrebbe essere a posto, giusto? Non proprio. Il README di DeepInfer menziona con nonchalance qualcosa di molto più aggressivo: tra gli obiettivi di progetto del sistema di produzione c'era il mantenimento della KV cache per oltre 72 ore.
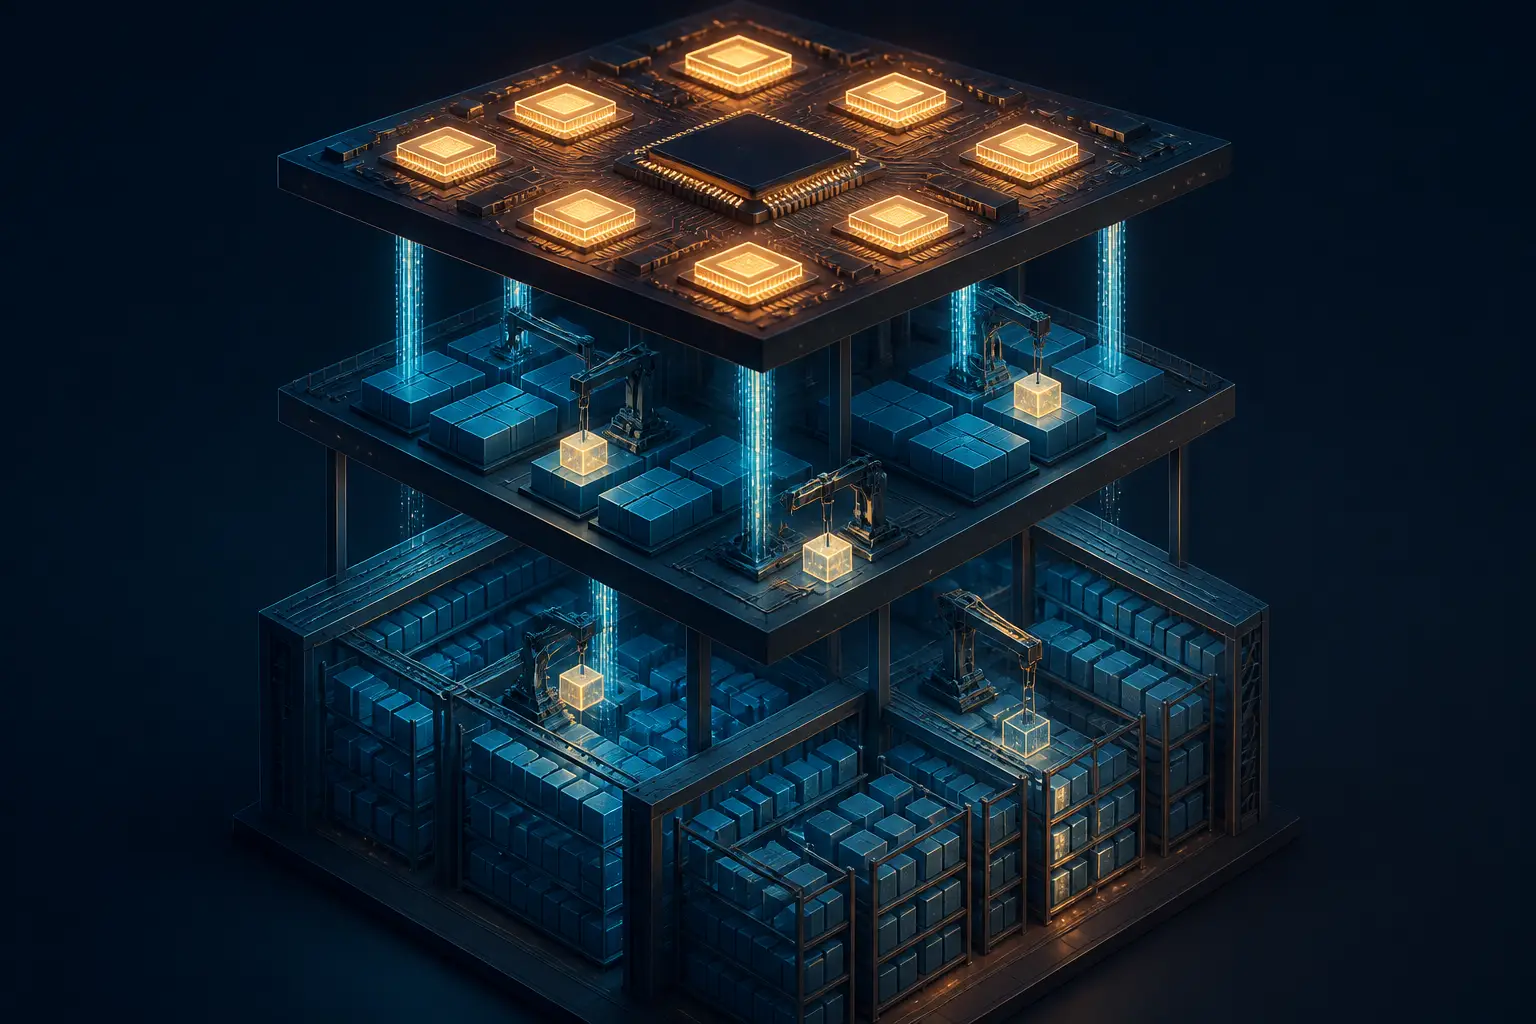
Pensateci. La HBM anche delle GPU più grandi si misura in centinaia di gigabyte; una cache di 72 ore su un cluster trafficato significa petabyte di stato. Non puoi tenerla sul dispositivo. Serve un sistema KV a livelli (HBM, DRAM dell'host, NVMe, eventualmente storage remoto) con politiche di evacuazione e prefetch abbastanza intelligenti da far sì che riportare indietro un prefisso obsoleto non comprometta il tuo SLO di latenza. Ecco perché il README elenca «un sistema di KV cache» tra le cose non incluse nel rilascio: è un'infrastruttura separata e seria. Se hai trattato la KV cache come un problema di paginazione nella GPU, la frontiera si è spostata verso il trattarla come un sistema di storage. Abbiamo già trattato la versione su scala minore di questo problema in cosa fare quando la GPU esaurisce la VRAM, ma questo è quel problema su scala datacenter.
C'è anche un trucco sulla KV più sottile che vale la pena copiare: replay limitato SWA. Per i livelli di sliding-window attention del decoder, non serve rieseguire l'intero prompt durante il prefill: basta un suffisso limitato che copra la finestra di attenzione più la lunghezza massima di backtracking (default: mantenere 140 token). È una riduzione diretta del calcolo di prefill per contesti lunghi, ed è il tipo di ottimizzazione che si scopre solo profilando dove finiscono davvero i FLOP del prefill. I motori generici non possono farlo in sicurezza; richiede di conoscere a fondo l'architettura di attenzione del modello. Ancora una volta, i motori specifici per modello vincono.
Mito 4: lo speculative decoding è throughput gratis
Lo speculative decoding ha una promessa quasi magica: generare più token per forward pass usando una bozza economica, verificarli in parallelo e tenere quelli che corrispondono. I benchmark lo adorano. Ma la convinzione che sia «gratis» crolla appena si legge come DeepInfer lo distribuisce davvero. I flag raccontano la storia: DEEPINFER_ENABLE_MTP_VARLEN=1 per attivarlo, DEEPINFER_USE_NEXTN_DECODE per limitare la lunghezza della bozza, e uno strato separato di scheduling della confidenza sopra. Se fosse gratis, non servirebbe niente di tutto questo: basterebbe bozzare sempre.
L'economia funziona così. Bozzare e verificare costa FLOP extra a ogni passo. Ci guadagni solo quando il tasso di accettazione è abbastanza alto da far sì che il guadagno in token per passo superi il sovraccarico. I tassi di accettazione dipendono dal meccanismo di bozza, dal dominio (il codice si bozza benissimo; la prosa divagante meno) e, in modo cruciale, dal carico del batch. A dimensioni di batch elevate la GPU è già limitata dal calcolo, quindi i FLOP extra di verifica tolgono direttamente spazio al lavoro reale. Lo speculative decoding brilla nel regime limitato dalla latenza e può addirittura far male in quello limitato dal throughput. Un motore di produzione che serve entrambi i regimi deve pianificarlo in modo adattivo, ed è esattamente ciò che fa la verifica pianificata in base alla confidenza.
La mia opinione, dopo aver visto dei team innestare lo speculative decoding sugli stack di serving: trattalo come una funzione di latenza, non di throughput. Se il tuo collo di bottiglia sono i token per dollaro con alta utilizzazione, sistema prima lo scheduler e la disposizione della KV. Se il tuo collo di bottiglia è la latenza p99 per utenti interattivi con carico moderato, lo speculative decoding è uno dei migliori strumenti disponibili, e DeepInfer offre un riferimento collaudato su come regolarlo.
Mito 5: serve il benestare di NVIDIA (e nient'altro) per servire su larga scala
DeepInfer supporta esattamente due target hardware: GPU NVIDIA SM100 e NPU Huawei Ascend 950. Mantiene file di requisiti separati per piattaforma (requirements-nvidia.txt, requirements-ascend.txt) e gestisce le funzionalità di conseguenza: l'inferenza batch-invariant, ad esempio, è solo per NVIDIA. È un'affermazione silenziosa ma significativa. Un motore di produzione di alto livello tratta un acceleratore non NVIDIA come cittadino di prima classe, con lo stesso modello, lo stesso scheduler e la stessa architettura di serving.
Per essere chiari su cosa significa e cosa non significa: non vuol dire che il percorso Ascend sia maturo, e non vuol dire che il fossato di CUDA svanisca dall'oggi al domani, perché le funzionalità solo CUDA nello stesso README dimostrano che il divario di ecosistema è reale. Vuol dire che il problema software più difficile della portabilità dell'inferenza (il motore, lo scheduler, la strategia di parallelismo) è ora aperto, con licenza Apache e architettato per due target fin dall'inizio. Per i laboratori più piccoli e i produttori di hardware, è una base su cui costruire invece di un muro da clonare. Chiunque segua il segmento dei modelli flash sa quanto l'economia dipenda da questo; abbiamo già sostenuto che i modelli flash sono la vera storia dell'efficienza dell'inferenza, e la pluralità hardware la amplifica.
Va menzionato anche il design del parallelismo: attention data-parallel con context-parallel bilanciato, più expert-parallel per i livelli MoE con un bilanciatore di carico expert-parallel. Questa combinazione è calibrata proprio per il deployment descritto da DeepSeek: un manipolo di GPU per il prefill e decine per il decode, disaggregati. La disaggregazione orientata al decode sta diventando l'architettura predefinita per le grandi flotte di serving, e la ragione è un'aritmetica semplice: il prefill è limitato dal calcolo e il decode dalla banda di memoria, quindi colocarli ti costringe a comprare hardware ottimale per nessuno dei due.
Mito 6: puoi semplicemente prenderlo e farlo girare
Un'ultima convinzione da sgonfiare, rivolta a chiunque abbia messo una stella al repository con l'idea di integrarlo nel proprio stack questo weekend. DeepInfer serve al momento esattamente una famiglia di modelli: DeepSeek-V4.1-Flash. Richiede Linux, GCC 13+, Python 3.12, CUDA 13 e hardware SM100, ovvero la generazione Blackwell, che la maggior parte di noi non ha in giro. I benchmark sono stati misurati su 4 GPU per il prefill e 64 per il decode all'interno di un unico dominio di scale-up. E le tre cose necessarie per un servizio vero (il sistema di KV cache, la plumbing della disaggregazione e il bilanciamento del carico tra repliche) sono esplicitamente fuori dallo scopo. Questo è il motore, non l'auto.
Ma liquidarlo come inutilizzabile fa perdere il punto, ed è qui che sarò di parte. Il rilascio vale meno come software da distribuire e più come una specifica di cosa significhi davvero la qualità di produzione. L'inferenza batch-invariant come flag di primo piano. Il campionamento deterministico con un seq_seed fisso per la riproducibilità. Gli output strutturati compilati nel sampler invece di aggiunti a posteriori con dei retry. Speculazione pianificata in base alla confidenza. Lo scheduling asincrono come default, non come esperimento. Se stai costruendo o acquistando uno stack di inferenza, questo README è una checklist. Se gestisci modelli grandi da solo, e abbiamo una guida pratica a far girare LLM sul proprio hardware per la fascia piccola, valgono le stesse priorità, solo a scala diversa: prima lo scheduler, poi la disposizione della memoria, infine i kernel.
Il forward pass è la parte facile. L'inferenza in produzione è uno scheduler, un gestore di memoria e un sistema di verifica che per caso chiamano dei kernel.
La tempistica geopolitica (uscito a poche ore da un ordine di esclusione del governo federale statunitense, con commenti che lo definiscono di tutto, da regalo a sabotaggio) dominerà i titoli. Va bene. Ma togliendo il dramma, il verdetto ingegneristico regge da solo: gran parte di ciò che credevamo sui motori di inferenza era di una generazione indietro. Il lavoro interessante non sta più nei kernel. Sta in tutto ciò che li circonda.


