DeepSeeks Inference-Engine: 5 Mythen im Test
DeepSeek hat seine Produktions-Inference-Engine als Open Source veröffentlicht. Wir testen fünf gängige Annahmen über Inference-Engines an DeepInfer.
 Sarah Chen

Als DeepSeek seine Produktions-LLM-Inference-Engine unter Apache-2.0-Lizenz auf GitHub veröffentlichte, sammelte das Repo innerhalb weniger Stunden Tausende Sterne. Das überrascht nicht – überraschend ist, was tatsächlich drinsteckt. DeepInfer ist keine Forschungsspielerei und keine abgespeckte Demo. Laut DeepSeeks eigener Aussage betreibt die Engine DeepSeek-V4.1-Flash mit einer angegebenen Leistung von 155 Billionen Tokens pro Tag und Cluster, bei einem Umsatz von rund 38 US-Dollar pro GPU-Stunde zu Nebenzeiten. Diese Zahlen stammen, sofern sie auch nur ungefähr stimmen, aus Engineering-Entscheidungen, die die Branche größtenteils für Folklore hält. Also machen wir, was ich mit jedem frisch veröffentlichten Produktivsystem machen würde: das README mit skeptischem Blick lesen und die gängigen Annahmen über Inference-Engines daran testen.
Mythos 1: Eine Inference-Engine ist nur ein schneller Forward-Pass
Das naive Modell sieht so aus: Das Modell ist das Modell, die Engine ist ein dünner Wrapper, der die Kernels aufruft, und Performance kommt von schnelleren GPUs. Die eigene Feature-Liste von DeepInfer widerlegt das deutlich. Schau dir an, was es für auslieferungswürdig hält: asynchrones Scheduling mit einem „zero-overhead batch scheduler“, Speculative Decoding mit konfidenzgesteuerter Verifikation, Replay mit begrenztem Sliding-Window-Attention-Bereich, batch-invariante Inferenz, deterministisches Sampling und strukturierte Ausgaben, die auf Regex, JSON-Schemas oder EBNF-Grammatiken beschränkt sind. Das sind ein Scheduler, ein Speichermanager, ein Verifikationssystem und ein Constraint-Compiler – die Kernels sind in dieser Liste fast nur ein Nachgedanke.
Das deckt sich mit dem, was Praktiker immer wieder neu lernen. Der Forward-Pass ist der einfache Teil; seit FlashAttention und guten GEMM-Bibliotheken ist er im Grunde gelöst. Der schwierige Teil ist, die GPU satt zu halten. Jede Millisekunde, in der die SMs im Leerlauf stehen, während die CPU entscheidet, welche Requests aufgenommen, welche KV-Blöcke verdrängt oder welche Draft-Tokens verifiziert werden, ist verbranntes Geld. Der asynchrone Scheduler von DeepInfer existiert genau dafür: CPU-Scheduling und Geräteausführung zu überlappen, damit die GPU nie auf Python warten muss. Wenn dein Serving-Stack noch synchron plant, ist diese eine Änderung wahrscheinlich mehr wert als jeder Kernel-Tausch, den du dir vorgenommen hattest.
Das README enthält außerdem ein aufschlussreiches Eingeständnis: Ein vollständiger Inference-Service braucht zusätzlich ein KV-Cache-System, Prefill/Decode-Disaggregation und Load Balancing über Data-Parallel-Replikate – nichts davon ist enthalten. Anders gesagt: Auch die Engine selbst ist nur eine Schicht des echten Systems. Produktive Inferenz ist ein verteiltes Systemproblem im Machine-Learning-Kostüm. Das haben wir schon einmal angemerkt, als es um LLM-Agenten ging, die verteilten Systemen sehr ähnlich sehen, und es gilt genauso eine Ebene tiefer im Stack.
Mythos 2: Größere Batches sind immer besser
Continuous Batching – neue Requests in den Batch aufnehmen, sobald andere fertig sind, statt auf den ganzen Batch zu warten – gehört inzwischen zum Standard, und DeepInfer beherrscht es selbstverständlich. Interessanter ist die schlampige Variante der Annahme, die es zu prüfen gilt: „Der Durchsatz skaliert mit der Batch-Größe, also maximiere den Batch.“ DeepInfer liefert zwei Features, die genau deshalb existieren, weil dieser Schluss falsch ist.
Erstens batch-invariante Inferenz (DEEPINFER_BATCH_INVARIANT=1). Normalerweise kann die Ausgabe eines Requests je nach Zusammensetzung des Batches abweichen, weil sich die Reihenfolge der Reduktionen in den Kernels mit der Batch-Zusammensetzung ändert und Gleitkomma-Addition nicht assoziativ ist. DeepSeek hielt es für den Aufwand wert, Ergebnisse über alle Batch-Zusammensetzungen hinweg identisch zu machen. Warum? Weil man im großen Maßstab feststellt, dass Kunden und Evaluierungspipelines bemerken, wenn derselbe Prompt an verschiedenen Tagen unterschiedliche Tokens liefert. Hätte die Maximierung der Batch-Größe bedeutet, Nichtdeterminismus in Kauf zu nehmen, hat DeepSeek entschieden, Durchsatz einzusetzen, um Determinismus zurückzukaufen. Das zeigt: Die eigentliche Zielfunktion ist nicht rohe Tokens pro Sekunde, sondern vertrauenswürdige Tokens pro Sekunde.
Zweitens konfidenzgesteuerte Verifikation für Speculative Decoding. Die Engine entwirft Tokens (Standard-Maximallänge des Entwurfs: 5) und nutzt Konfidenzschätzungen, um zu entscheiden, wie viel Verifikationsarbeit eingeplant wird. Der naive Ansatz verifiziert in jedem Schritt einen festen Entwurf; der clevere erkennt, dass die optimale Menge an spekulativer Arbeit pro Request und pro Schritt variiert. Mehr spekulative Arbeit, als die Konfidenz rechtfertigt, verschwendet Rechenleistung für Tokens, die man wegwirft. Weniger zu batchen lässt Beschleunigung liegen. Der Scheduler löst also in jedem Schritt ein Optimierungsproblem, statt Requests einfach zusammenzustopfen.
- Die Batch-Größe erhöht den Durchsatz, aber auch die Latenz – die Zeit bis zum ersten Token verschlechtert sich, wenn Prefill-Batches wachsen.
- Die Batch-Zusammensetzung verändert die Numerik – ohne batch-invariante Kernels, für die man bezahlt, driften die Ausgaben.
- Spekulative Arbeit hat abnehmenden Ertrag – die Akzeptanzrate von Drafts sinkt mit der Draft-Länge, feste Pläne verschwenden also FLOPs.
- Der KV-Cache ist die eigentliche Obergrenze – der Batch kann nicht über das wachsen, was der Speicher fassen kann, deshalb zählt das Speicherlayout mehr als die Batch-Strategie.
Mythos 3: KV-Cache-Verwaltung ist ein gelöstes Problem
PagedAttention hat den an Betriebssysteme angelehnten Ansatz populär gemacht: den KV-Cache in Seiten fester Größe zuweisen, sie wie virtuellen Speicher vergeben und Fragmentierung vermeiden. vLLM hat bewiesen, dass es funktioniert, und DeepInfer basiert laut eigenen Angaben ursprünglich hauptsächlich auf vLLM. Also ist der Paged-KV-Cache doch erledigt, oder? Nicht ganz. Das README von DeepInfer erwähnt beiläufig etwas viel Aggressiveres: Ein Designziel des Produktivsystems war, den KV-Cache über 72 Stunden hinaus zu behalten.
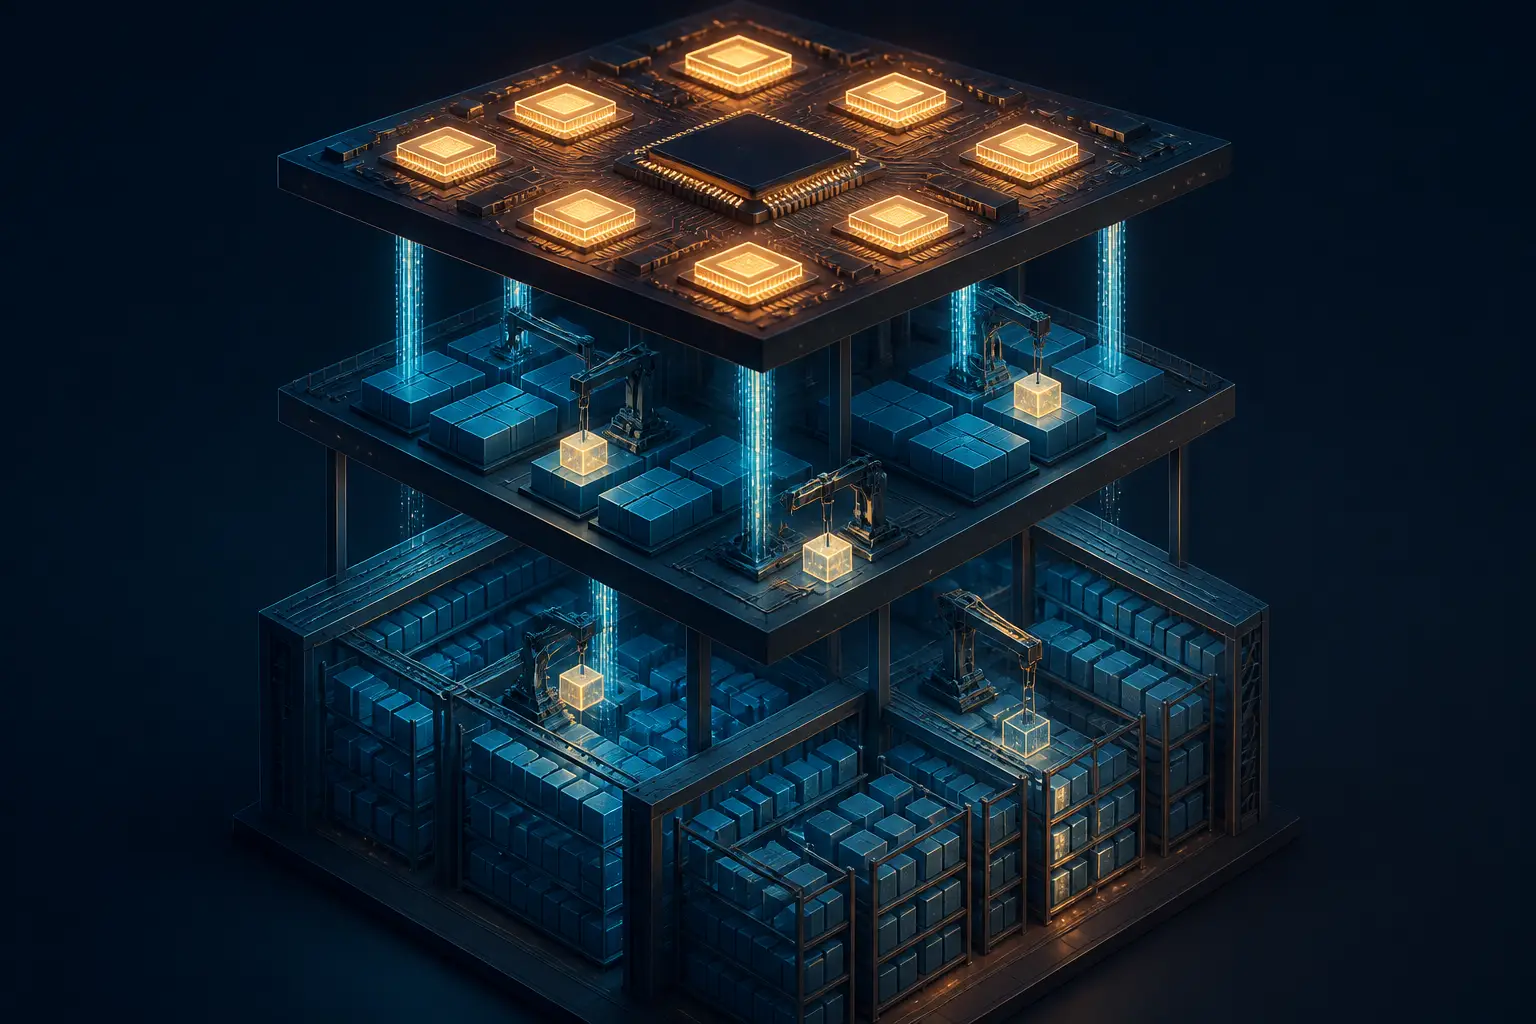
Man denke darüber nach, was das impliziert. HBM auf selbst den größten GPUs misst sich in Hunderten Gigabyte; ein 72-Stunden-Cache über einen ausgelasteten Cluster sind Petabyte an Zustand. Das lässt sich nicht auf dem Gerät halten. Man braucht ein gestuftes KV-System – HBM, Host-DRAM, NVMe, womöglich entfernten Speicher – mit Verdrängungs- und Prefetch-Strategien, die clever genug sind, dass das Zurückholen eines veralteten Präfixes das Latenz-SLO nicht ruiniert. Deshalb führt das README „ein KV-Cache-System“ als etwas auf, das nicht enthalten ist: Es ist eine eigenständige, ernsthafte Infrastrukturkomponente. Wer KV-Cache bisher als Paging-Problem innerhalb der GPU betrachtet hat, sollte wissen: Die Front hat sich verschoben, hin zur Behandlung als Storage-System. Die kleinere Variante dieses Schmerzes haben wir in was man tun kann, wenn der VRAM der GPU ausgeht behandelt, hier geht es um dieses Problem in Rechenzentrumsdimensionen.
Außerdem gibt es einen subtileren KV-Trick, den man übernehmen sollte: SWA-begrenztes Replay. Für die Sliding-Window-Attention-Schichten des Decoders muss man beim Prefill nicht den gesamten Prompt erneut durchlaufen – nur ein begrenztes Suffix, das das Attention-Fenster plus die maximale Rücksprunglänge abdeckt (Standard: 140 Tokens werden behalten). Das reduziert die Prefill-Rechenleistung bei langen Kontexten direkt, und es ist die Art Optimierung, die man nur entdeckt, wenn man profiliert, wo die Prefill-FLOPs tatsächlich anfallen. Generische Engines können das nicht sicher, dafür muss man die Attention-Architektur des Modells in- und auswendig kennen. Modellspezifische Engines gewinnen wieder.
Mythos 4: Speculative Decoding ist kostenloser Durchsatz
Speculative Decoding hat ein fast magisches Versprechen: mit einem günstigen Entwurf mehrere Tokens pro Forward-Pass erzeugen, sie parallel verifizieren und behalten, was passt. Benchmarks lieben das. Aber die Annahme, es sei „kostenlos“, bricht zusammen, sobald man liest, wie DeepInfer es tatsächlich einsetzt. Die Flags erzählen die Geschichte: DEEPINFER_ENABLE_MTP_VARLEN=1 zum Einschalten, DEEPINFER_USE_NEXTN_DECODE zum Begrenzen der Entwurfslänge und eine separate Konfidenz-Scheduling-Schicht obendrauf. Wäre es kostenlos, bräuchte man nichts davon – man würde einfach immer entwerfen.
Die Wirtschaftlichkeit funktioniert so: Entwerfen und Verifizieren kostet bei jedem Schritt zusätzliche FLOPs. Profitabel ist es nur, wenn die Akzeptanzrate hoch genug ist, dass der Gewinn an Tokens pro Schritt den Overhead übersteigt. Die Akzeptanzraten hängen vom Entwurfsmechanismus ab, von der Domäne (Code lässt sich hervorragend entwerfen, ausschweifende Prosa weniger gut) und – entscheidend – von der Batch-Last. Bei hoher Batch-Größe ist die GPU ohnehin rechengebunden, und die zusätzlichen Verifikations-FLOPs verdrängen direkt echte Arbeit. Speculative Decoding glänzt im latenzgebundenen Bereich und kann im durchsatzgebundenen Bereich sogar schaden. Eine Produktions-Engine, die beide Bereiche bedient, muss es adaptiv einplanen – genau das leistet die konfidenzgesteuerte Verifikation.
Meine Meinung, nachdem ich zugesehen habe, wie Teams Speculative Decoding an bestehende Serving-Stacks angeflanscht haben: Behandle es als Latenz-Feature, nicht als Durchsatz-Feature. Wenn dein Engpass Tokens pro Euro bei hoher Auslastung sind, optimiere zuerst Scheduler und KV-Layout. Wenn dein Engpass die p99-Latenz für interaktive Nutzer bei moderater Last ist, ist Speculative Decoding eines der besten verfügbaren Werkzeuge – und DeepInfer liefert eine praxiserprobte Referenz dafür, wie man es steuert.
Mythos 5: Man braucht den Segen von NVIDIA (und sonst nichts), um im großen Maßstab zu betreiben
DeepInfer unterstützt genau zwei Hardware-Ziele: NVIDIA-SM100-GPUs und Huawei-Ascend-950-NPUs. Es pflegt separate Anforderungsdateien pro Plattform (requirements-nvidia.txt, requirements-ascend.txt) und schaltet Features entsprechend frei – batch-invariante Inferenz ist zum Beispiel nur für NVIDIA verfügbar. Das ist eine leise, aber bedeutende Aussage. Eine Produktions-Engine der Spitzenklasse behandelt einen Nicht-NVIDIA-Beschleuniger als vollwertigen Bürger, mit demselben Modell, demselben Scheduler und derselben Serving-Architektur.
Um klar zu sein, was das bedeutet und was nicht: Es heißt nicht, dass der Ascend-Pfad ausgereift ist, und es heißt nicht, dass der CUDA-Graben über Nacht verschwindet – die CUDA-exklusiven Features im selben README belegen, dass die Lücke im Ökosystem real ist. Es bedeutet, dass das schwierigste Softwareproblem bei der Portabilität von Inferenz (die Engine, der Scheduler, die Parallelisierungsstrategie) jetzt offen, Apache-lizenziert und von Anfang an für zwei Zielplattformen ausgelegt ist. Für kleinere Labore und Hardware-Hersteller ist das eine Grundlage zum Aufbauen statt eine Mauer zum Nachbauen. Wer das Flash-Segment des Marktes beobachtet, weiß, wie sehr die Wirtschaftlichkeit davon abhängt; wir haben schon argumentiert, dass Flash-Klasse-Modelle die eigentliche Geschichte der Inferenz-Effizienz sind, und Hardware-Vielfalt verstärkt das.
Auch das Parallelisierungsdesign verdient hier eine Erwähnung: Attention-Data-Parallelität mit ausgeglichener Context-Parallelität, dazu Expert-Parallelität für die MoE-Schichten mit einem Expert-Parallel-Load-Balancer. Diese Kombination ist genau auf das Deployment abgestimmt, das DeepSeek beschreibt – eine Handvoll GPUs für Prefill und Dutzende für Decode, disaggregiert. Decode-lastige Disaggregation wird zum Standard-Architekturmuster für große Serving-Flotten, und der Grund ist einfache Arithmetik: Prefill ist rechengebunden, Decode speicherbandbreitengebunden. Werden beide kolokalisiert, muss man Hardware kaufen, die für keines von beiden optimal ist.
Mythos 6: Man kann es einfach übernehmen und loslaufen lassen
Eine letzte Annahme, die ich entzaubern will – gerichtet an alle, die das Repo mit Stern versehen haben und es dieses Wochenende in ihren Stack einbauen wollen. DeepInfer bedient derzeit genau eine Modellfamilie: DeepSeek-V4.1-Flash. Es benötigt Linux, GCC 13+, Python 3.12, CUDA 13 und SM100-Hardware – also Blackwell-Generation, die die meisten von uns nicht einfach so herumliegen haben. Die Benchmarks wurden mit 4 GPUs für Prefill und 64 für Decode innerhalb einer Scale-up-Domäne gemessen. Und die drei Dinge, die man für einen echten Service braucht – das KV-Cache-System, die Disaggregations-Infrastruktur und das Load Balancing über Replikate – sind ausdrücklich nicht im Umfang enthalten. Das ist der Motor, nicht das ganze Auto.
Aber es als unbrauchbar abzutun, verfehlt den Punkt, und hier werde ich meinen Standpunkt deutlich machen. Das Release ist weniger als Software zum Ausrollen wertvoll, sondern eher als Spezifikation dessen, was Produktionsreife wirklich bedeutet. Batch-invariante Inferenz als Flag erster Klasse. Deterministisches Sampling mit festem seq_seed für Reproduzierbarkeit. Strukturierte Ausgaben, die direkt in den Sampler kompiliert werden, statt mit Wiederholungsversuchen angeflanscht zu werden. Konfidenzgesteuerte Speculation. Asynchrones Scheduling als Standard, nicht als Experiment. Wer einen Inferenz-Stack baut oder kauft, kann dieses README als Checkliste nutzen. Und wer große Modelle selbst betreibt – wir haben für den kleinen Maßstab einen praktischen Leitfaden, wie man LLMs auf eigener Hardware betreibt – für den gelten dieselben Prioritäten, nur in anderer Größenordnung: erst der Scheduler, dann das Speicherlayout, zuletzt die Kernels.
Der Forward-Pass ist der einfache Teil. Produktive Inferenz ist ein Scheduler, ein Speichermanager und ein Verifikationssystem, die zufällig Kernels aufrufen.
Das geopolitische Timing – nur wenige Stunden nach einer Ausschlussverfügung der US-Bundesregierung, und Kommentare, die es als alles von Geschenk bis Sabotage bezeichnen – wird die Schlagzeilen dominieren. Gut. Aber ohne das Drama bleibt das technische Urteil für sich stehen: Vieles von dem, was wir über Inference-Engines glaubten, war eine Generation veraltet. Die spannende Arbeit steckt nicht mehr in den Kernels. Sie steckt in allem drumherum.


