El motor de inferencia de DeepSeek: 5 mitos, probados
DeepSeek publicó en código abierto su motor de inferencia LLM en producción. Probamos cinco creencias comunes sobre inferencia frente a lo que revela DeepInfer.
 Sarah Chen

Cuando DeepSeek subió a GitHub su motor de inferencia LLM en producción bajo licencia Apache 2.0, el repositorio acumuló miles de estrellas en cuestión de horas. Eso no sorprende. Lo que sí sorprende es lo que hay dentro. DeepInfer no es un juguete de investigación ni una demo simplificada. Es el motor que, según la propia DeepSeek, sirve a DeepSeek-V4.1-Flash con una escala declarada de 155 billones de tokens por día y por clúster, con unos ingresos de alrededor de 38 dólares por hora de GPU en tarifas de horario valle. Si esas cifras son aunque sea aproximadamente correctas, vienen de decisiones de ingeniería que la mayoría de la industria trata como folclore. Así que hagamos lo que haría con cualquier sistema de producción recién publicado en código abierto: leer el README con escepticismo y poner a prueba contra él las creencias habituales sobre los motores de inferencia.
Mito 1: un motor de inferencia es solo un forward pass rápido
El modelo mental ingenuo va así: el modelo es el modelo, el motor es un envoltorio fino que llama a los kernels, y el rendimiento sale de comprar GPU más rápidas. La lista de funcionalidades de DeepInfer desmonta esta idea. Fíjate en lo que considera merecedor de salir en producción: planificación asíncrona con un "planificador de lotes de sobrecarga cero", decodificación especulativa con verificación programada por confianza, replay acotado de atención con ventana deslizante, inferencia invariante al lote, muestreo determinista y salidas estructuradas restringidas a expresiones regulares, esquemas JSON o gramáticas EBNF. Eso es un planificador, un gestor de memoria, un sistema de verificación y un compilador de restricciones; los kernels son casi un detalle en la lista.
Esto coincide con lo que los profesionales siguen redescubriendo. El forward pass es la parte fácil: está prácticamente resuelto desde FlashAttention y las buenas librerías de GEMM. La parte difícil es mantener la GPU alimentada. Cada milisegundo en que los SM están ociosos mientras la CPU decide qué peticiones admitir, qué bloques de KV desalojar o qué tokens borrador verificar es dinero que se esfuma. El planificador asíncrono de DeepInfer existe precisamente para solapar la planificación en CPU con la ejecución en el dispositivo, de modo que la GPU nunca espere a Python. Si tu pila de servicio todavía planifica de forma síncrona, ese único cambio probablemente vale más que cualquier cambio de kernel que tuvieras previsto.
El README también contiene una admisión reveladora: un servicio de inferencia completo necesita además un sistema de caché KV, desagregación entre prefill y decode, y balanceo de carga entre réplicas de paralelismo de datos, y nada de eso está incluido. Dicho de otra forma, incluso el motor es solo una capa del sistema real. La inferencia en producción es un problema de sistemas distribuidos disfrazado de aprendizaje automático. Es un punto que ya tratamos al hablar de cómo los agentes LLM se parecen mucho a los sistemas distribuidos, y aplica igual de bien una capa más abajo en la pila.
Mito 2: los lotes más grandes siempre son mejores
El batching continuo (admitir nuevas peticiones en el lote en cuanto terminan otras, en lugar de esperar a que termine el lote entero) es hoy un requisito básico, y DeepInfer, como es lógico, lo implementa. Pero la creencia más interesante que conviene poner a prueba es la versión descuidada: "el rendimiento escala con el tamaño del lote, así que maximiza el lote". DeepInfer incluye dos funcionalidades que existen precisamente porque eso es falso.
Primero, inferencia invariante al lote (DEEPINFER_BATCH_INVARIANT=1). Normalmente, la salida de una petición puede variar según lo que haya en su lote, porque el orden de reducción en los kernels cambia con la composición del lote y la suma en coma flotante no es asociativa. DeepSeek consideró que merecía el esfuerzo de ingeniería hacer que los resultados sean idénticos independientemente de la composición del lote. ¿Por qué? Porque, cuando sirves a escala, descubres que los clientes y los pipelines de evaluación notan cuando el mismo prompt devuelve tokens distintos en días distintos. Si maximizar el tamaño del lote significaba aceptar no determinismo, DeepSeek decidió sacrificar rendimiento para recuperar el determinismo. Eso dice cuál es la función objetivo real: no los tokens por segundo en bruto, sino los tokens por segundo fiables.
Segundo, verificación programada por confianza para la decodificación especulativa. El motor genera tokens borrador (la longitud máxima de borrador por defecto es 5) y usa estimaciones de confianza para decidir cuánto trabajo de verificación programar. El enfoque ingenuo verifica un borrador de longitud fija en cada paso; el enfoque inteligente reconoce que la cantidad óptima de trabajo especulativo varía por petición y por paso. Meter más trabajo especulativo del que la confianza justifica desperdicia cómputo en tokens que vas a descartar. Meter menos deja velocidad sobre la mesa. El planificador resuelve un problema de optimización en cada paso, no se limita a apilar peticiones.
- El tamaño del lote aumenta el rendimiento, pero también la latencia: el tiempo hasta el primer token empeora a medida que crecen los lotes de prefill.
- La composición del lote cambia la numérica: a menos que pagues por kernels invariantes al lote, las salidas derivan.
- El trabajo especulativo tiene rendimientos decrecientes: la tasa de aceptación de borradores baja con la longitud del borrador, así que los calendarios fijos desperdician FLOPs.
- La caché KV es el verdadero techo: el lote no puede crecer más allá de lo que cabe en memoria, por eso la disposición de la memoria importa más que la política de lotes.
Mito 3: la gestión de la caché KV es un problema resuelto
PagedAttention popularizó el enfoque al estilo de sistema operativo: reservar la caché KV en páginas de tamaño fijo, repartirlas como si fuera memoria virtual y dejar de fragmentar. vLLM demostró que funciona, y DeepInfer, según sus propios agradecimientos, se construyó originalmente sobre vLLM. Entonces la caché KV paginada ya está resuelta, ¿no? No del todo. El README de DeepInfer menciona de pasada algo mucho más agresivo: un objetivo de diseño del sistema de producción era retener la caché KV durante más de 72 horas.
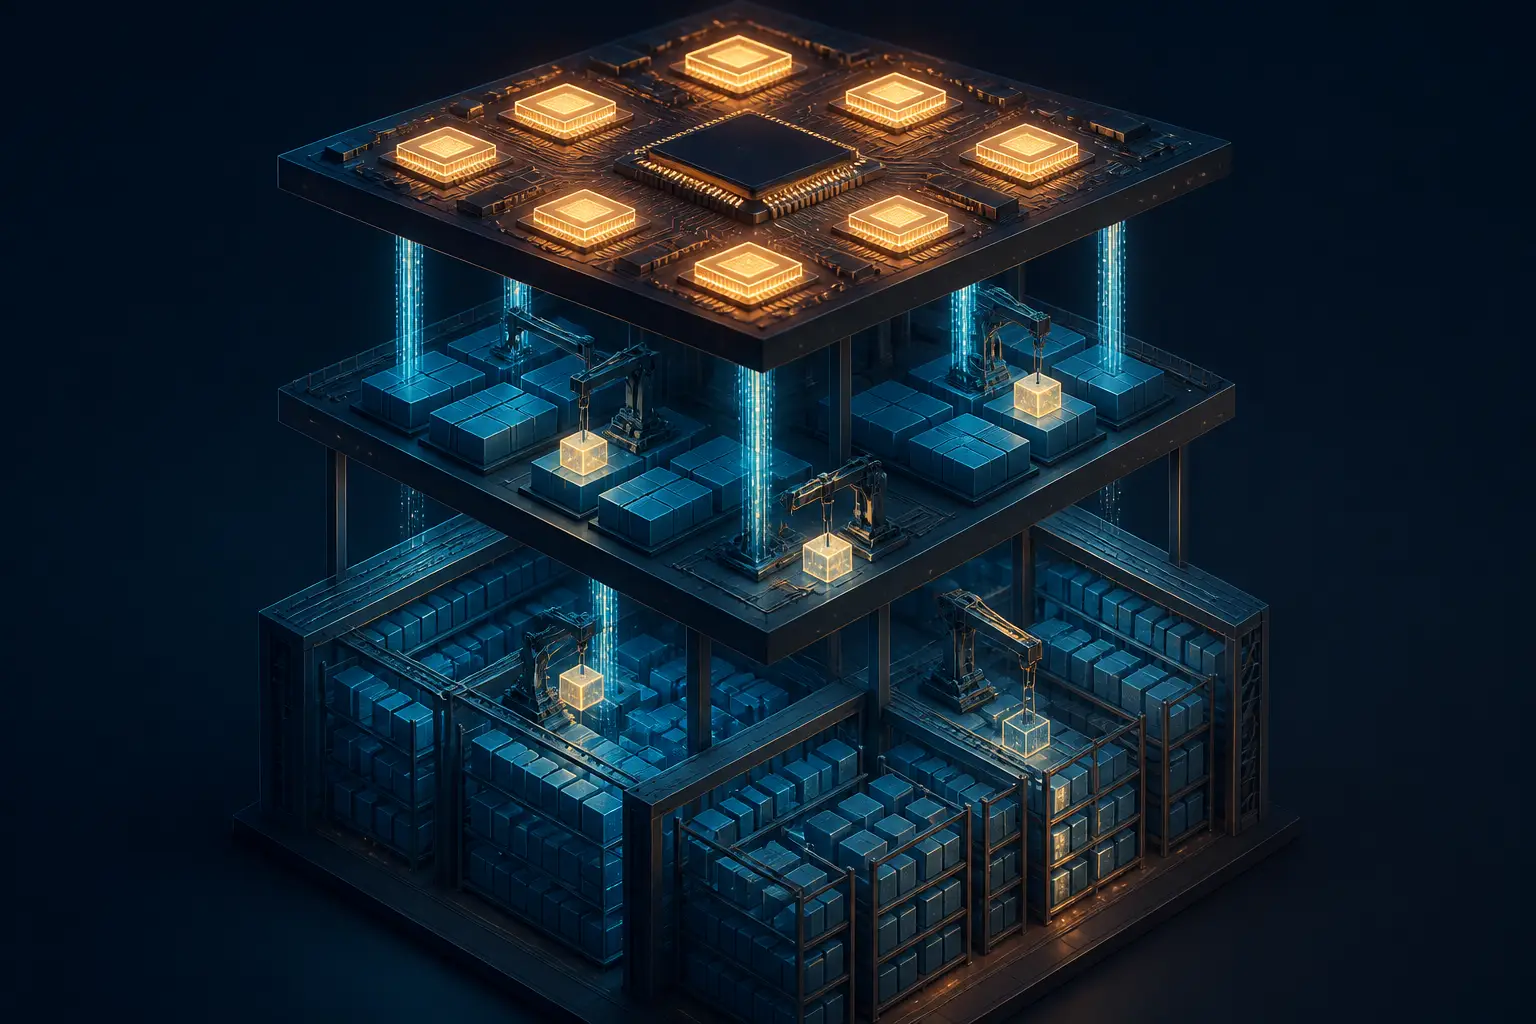
Piensa en lo que implica. La HBM de incluso las GPU más grandes se mide en cientos de gigabytes; una caché de 72 horas en un clúster muy usado son petabytes de estado. Eso no cabe en el dispositivo. Necesitas un sistema KV escalonado (HBM, DRAM del host, NVMe, quizá almacenamiento remoto) con políticas de desalojo y precarga lo bastante inteligentes como para que recuperar un prefijo viejo no arruine tu SLO de latencia. Por eso el README lista "un sistema de caché KV" entre lo no incluido en la publicación: es una pieza de infraestructura aparte y muy seria. Si has tratado la caché KV como un problema de paginación dentro de la GPU, la frontera ya se ha desplazado a tratarla como un sistema de almacenamiento. Ya cubrimos la versión a menor escala de este dolor en qué hacer cuando tu GPU se queda sin VRAM, pero esto es ese problema a escala de centro de datos.
También hay un truco de caché KV más sutil que vale la pena copiar: replay acotado SWA. Para las capas de atención con ventana deslizante del decodificador, no hace falta repetir todo el prompt durante el prefill, solo un sufijo acotado que cubra la ventana de atención más la longitud máxima de retroceso (por defecto, se conservan 140 tokens). Eso reduce directamente el cómputo de prefill en contextos largos, y es el tipo de optimización que solo descubres cuando perfilas dónde se van realmente los FLOPs del prefill. Los motores genéricos no pueden hacerlo de forma segura; requiere conocer en profundidad la arquitectura de atención del modelo. Los motores específicos de modelo vuelven a ganar.
Mito 4: la decodificación especulativa es rendimiento gratis
La decodificación especulativa tiene un argumento casi mágico: generar varios tokens por forward pass usando un borrador barato, verificarlos en paralelo y quedarse con los que coinciden. Los benchmarks la adoran. Pero la idea de que es "gratis" se derrumba en cuanto lees cómo la despliega DeepInfer. Los flags lo cuentan: DEEPINFER_ENABLE_MTP_VARLEN=1 para activarla, DEEPINFER_USE_NEXTN_DECODE para limitar la longitud del borrador, y una capa separada de programación por confianza encima. Si fuera gratis, no necesitarías nada de eso: bastaría con generar siempre borradores.
La economía funciona así. Generar y verificar borradores cuesta FLOPs extra en cada paso. Solo sales ganando si la tasa de aceptación es lo bastante alta como para que la ganancia de tokens por paso supere la sobrecarga. Las tasas de aceptación dependen del mecanismo de borrador, del dominio (el código se presta muy bien a los borradores; la prosa divagante, menos) y, sobre todo, de la carga del lote. Con tamaños de lote grandes, la GPU ya está limitada por cómputo, así que los FLOPs extra de verificación desplazan directamente trabajo real. La decodificación especulativa brilla en el régimen limitado por latencia y puede perjudicar en el régimen limitado por rendimiento. Un motor de producción que sirve ambos regímenes necesita programarla de forma adaptativa, que es exactamente lo que hace la verificación programada por confianza.
Mi opinión, tras ver a equipos acoplar decodificación especulativa a sus pilas de servicio: trátala como una funcionalidad de latencia, no de rendimiento. Si tu cuello de botella es el número de tokens por dólar con alta utilización, primero arregla el planificador y la disposición de la caché KV. Si tu cuello de botella es la latencia p99 para usuarios interactivos con carga moderada, la decodificación especulativa es una de las mejores herramientas disponibles, y DeepInfer te ofrece una referencia probada en producción sobre cómo activarla con control.
Mito 5: necesitas la bendición de NVIDIA (y nada más) para servir a escala
DeepInfer soporta exactamente dos objetivos de hardware: GPU NVIDIA SM100 y NPU Huawei Ascend 950. Mantiene archivos de requisitos separados por plataforma (requirements-nvidia.txt, requirements-ascend.txt) y activa las funcionalidades según corresponda; la inferencia invariante al lote, por ejemplo, es solo para NVIDIA. Es una declaración silenciosa pero significativa. Un motor de producción de primer nivel trata un acelerador no NVIDIA como ciudadano de primera clase, con el mismo modelo, el mismo planificador y la misma arquitectura de servicio.
Para ser claros sobre lo que esto significa y lo que no: no quiere decir que la ruta de Ascend esté madura, ni que el foso de CUDA vaya a desaparecer de la noche a la mañana; las funcionalidades exclusivas de CUDA del mismo README son prueba de que la brecha del ecosistema es real. Lo que sí significa es que el problema de software más difícil en la portabilidad de la inferencia (el motor, el planificador, la estrategia de paralelismo) ahora es abierto, tiene licencia Apache y está diseñado para dos objetivos desde el principio. Para laboratorios más pequeños y fabricantes de hardware, eso es una base sobre la que construir y no un muro que clonar. Quien siga el segmento de modelos flash sabe lo mucho que la economía depende de esto; ya defendimos que los modelos de nivel flash son la verdadera historia de la eficiencia en inferencia, y la pluralidad de hardware la amplifica.
El diseño de paralelismo también merece mención: paralelismo de datos de atención con paralelismo de contexto equilibrado, más paralelismo de expertos para las capas MoE con un balanceador de carga de expertos. Esa combinación está afinada para exactamente el despliegue que describe DeepSeek: unas pocas GPU para prefill y decenas para decode, desagregados. La desagregación orientada a decode se está convirtiendo en la arquitectura por defecto para flotas de servicio grandes, y la razón es una aritmética sencilla: el prefill está limitado por cómputo y el decode por ancho de banda de memoria, así que colocarlos juntos te obliga a comprar hardware que no es óptimo para ninguno de los dos.
Mito 6: puedes coger esto y ejecutarlo sin más
Una última creencia que desinflar, dirigida a todos los que dieron estrella al repositorio planeando integrarlo en su pila este fin de semana. DeepInfer sirve ahora mismo exactamente una familia de modelos: DeepSeek-V4.1-Flash. Requiere Linux, GCC 13+, Python 3.12, CUDA 13 y hardware SM100, es decir, de generación Blackwell, que la mayoría no tenemos por casa. Los benchmarks se midieron con 4 GPU para prefill y 64 para decode dentro de un mismo dominio de scale-up. Y las tres cosas que necesitas para un servicio real (el sistema de caché KV, la maquinaria de desagregación y el balanceo de carga entre réplicas) quedan explícitamente fuera del alcance. Esto es el motor, no el coche.
Pero descartarlo como inutilizable pasa por alto el punto, y aquí me voy a mojar. La publicación vale menos como software para desplegar y más como una especificación de lo que significa realmente calidad de producción. La inferencia invariante al lote como flag de primera clase. El muestreo determinista con un seq_seed fijo para la reproducibilidad. Las salidas estructuradas compiladas dentro del muestreador en lugar de añadidas a base de reintentos. La especulación con programación por confianza. La planificación asíncrona como opción por defecto, no como experimento. Si estás construyendo o comprando una pila de inferencia, este README es una lista de verificación. Si ejecutas tú modelos grandes (y tenemos una guía práctica para ejecutar LLM en tu propio hardware para el extremo pequeño), las mismas prioridades aplican, solo que a otra escala: primero el planificador, después la disposición de memoria y por último los kernels.
El forward pass es la parte fácil. La inferencia en producción es un planificador, un gestor de memoria y un sistema de verificación que, casualmente, llaman a kernels.
El momento geopolítico (aterrizar a horas de una orden federal de exclusión de EE. UU., con comentarios que van desde un regalo hasta un sabotaje) acaparará los titulares. Vale. Pero, quitando el drama, el veredicto de ingeniería se sostiene por sí solo: gran parte de lo que creíamos sobre los motores de inferencia iba una generación por detrás. Lo interesante ya no está en los kernels. Está en todo lo que los rodea.


