DeepSeek推理引擎:测试五个常见误区
DeepSeek开源了其生产级LLM推理引擎。我们将关于推理引擎的五个常见观点,与DeepInfer的实际表现逐一对照测试。
 Sarah Chen

DeepSeek将其生产级LLM推理引擎以Apache 2.0许可证推送到GitHub后,仓库几个小时内就收获了数千颗星。这并不意外,真正令人意外的是里面到底是什么。DeepInfer不是研究玩具,也不是阉割版演示。按照DeepSeek自己的说法,它支撑着DeepSeek-V4.1-Flash的服务,每个集群日处理量宣称达155万亿token,在非高峰定价下每GPU小时收入约38美元。这些数字即便只是大致准确,背后也是业界大多视为行规的工程决策。所以,我会像对待任何刚开源的生产系统那样:像怀疑论者一样读README,然后用它来检验关于推理引擎的常见观点。
误区一:推理引擎就是一次快速的前向计算
常见的思维模式是:模型就是模型,引擎只是调用内核的薄封装,性能靠买更快的GPU。DeepInfer自己的功能列表直接推翻了这种看法。看看它认为值得交付的东西:带有“零开销批调度器”的异步调度、基于置信度调度验证的投机解码、滑动窗口注意力的有界回放、批不变推理、确定性采样,以及受正则表达式、JSON Schema或EBNF文法约束的结构化输出。这里面有调度器、内存管理器、验证系统和约束编译器,内核在列表里几乎只是附带的。
这与从业者反复重新学到的经验相吻合。前向计算是简单的部分,自FlashAttention和成熟的GEMM库出现以来,它基本已经解决。难点在于让GPU持续有活干。每当SM因为CPU在决定准入哪些请求、驱逐哪些KV块、验证哪些草稿token而空转一毫秒,钱就白白烧掉了。DeepInfer的异步调度器正是为了让CPU调度与设备执行重叠,使GPU不必等待Python。如果你的服务栈仍在同步调度,这一项改动的价值很可能超过你原本计划的任何内核替换。
README里还有一处很有意思的坦白:一个完整的推理服务还需要KV缓存系统、prefill/decode分离,以及数据并行副本之间的负载均衡,而这些都不在发布范围内。换句话说,即便是引擎本身,也只是真实系统的一层。生产环境下的推理,是披着机器学习外衣的分布式系统问题。我们之前讨论过LLM智能体与分布式系统的相似之处,这一点同样适用于再往下一层的技术栈。
误区二:批次越大越好
连续批处理(在其他请求完成后立即接纳新请求,而不是等整个批次结束)如今已是基本配置,DeepInfer自然也支持。但更值得检验的是一种粗糙的说法:“吞吐量随批次大小增长,所以把批次拉满就行。”DeepInfer有两个功能,正是因为这种说法是错的而存在。
第一,批不变推理(DEEPINFER_BATCH_INVARIANT=1)。通常情况下,一个请求的输出可能会因同批次中的其他请求而漂移,因为内核中的归约顺序会随批次组成变化,而浮点加法并不满足结合律。DeepSeek认为值得投入工程精力,让结果不受批次组成影响。原因何在?因为规模化服务之后你会发现,同一个提示词在不同日子返回不同token,客户和评测流水线都会察觉。如果最大化批次大小意味着接受不确定性,DeepSeek选择牺牲吞吐量来换回确定性。这说明真正的优化目标不是原始的每秒token数,而是可信的每秒token数。
第二,投机解码中的基于置信度调度的验证。引擎先生成草稿token(默认最大草稿长度为5),再利用置信度估计来决定要调度多少验证工作。朴素的做法是每一步都验证固定长度的草稿;聪明的做法则承认,最优的投机工作量因请求和步骤而异。超出置信度所能支撑的投机批处理,会在最终会被丢弃的token上浪费算力;投机不足,又会白白放弃加速空间。调度器解决的是逐步的优化问题,而不只是把请求硬塞到一起。
- 批次大小提升吞吐,但也会拉高延迟:随着prefill批次变大,首token时间会变差。
- 批次组成会影响数值结果:除非为批不变内核付出代价,否则输出会漂移。
- 投机工作的收益递减:草稿接受率随草稿长度下降,固定的调度方案会浪费FLOPs。
- KV缓存才是真正的上限:批次大小不能超过显存所能容纳的范围,因此内存布局比批次策略更重要。
误区三:KV缓存管理已经是个解决了的问题
PagedAttention推广了一种操作系统式的思路:把KV缓存分配成固定大小的页,像虚拟内存一样按需分发,从而避免碎片化。vLLM证明了这条路可行,而DeepInfer按其自己的致谢,最初主要基于vLLM构建。那么分页KV缓存应该已经完事了吧?并非如此。DeepInfer的README顺带提到了一个激进得多的设计目标:生产系统的一项设计目标是将KV缓存保留超过72小时。
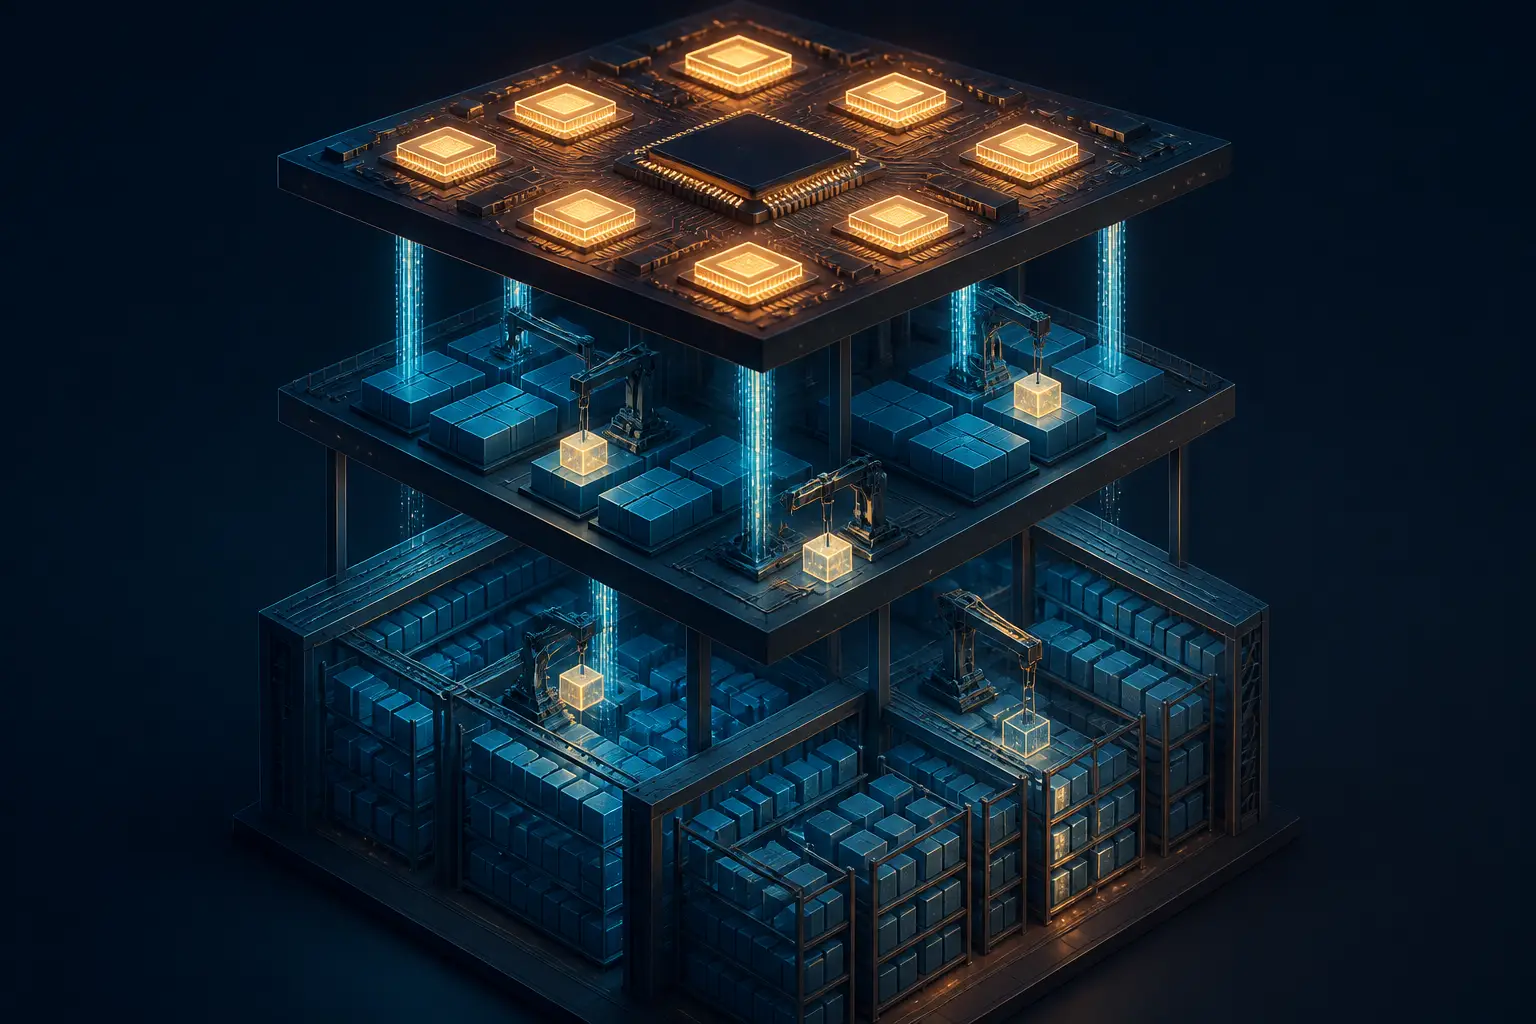
想想这意味着什么。即便是最大的GPU,HBM也只有几百GB;而一个忙碌集群上保留72小时的缓存,状态量达到PB级。这不可能全部留在设备上。你需要一套分层KV系统(HBM、主机DRAM、NVMe,甚至可能是远程存储),并配以足够聪明的驱逐与预取策略,确保把陈旧前缀拉回来时不会打爆你的延迟SLO。这就是为什么README把“KV缓存系统”列为不包含在发布中的部分:它是一套独立且相当重型的基础设施。如果你还把KV缓存当作GPU内的分页问题,那前沿已经转向把它当作存储系统来对待了。我们在GPU显存不足时该怎么办一文中谈过这个痛点的小规模版本,而这里是它在数据中心规模下的样子。
还有一个值得借鉴的更微妙的KV技巧:SWA有界回放。对于解码器中的滑动窗口注意力层,prefill时不必回放整个提示词,只需回放一段有界的后缀,覆盖注意力窗口加上最大回溯长度(默认保留140个token)。这直接减少了长上下文下的prefill计算量,而这类优化通常只有在剖析prefill的FLOPs究竟花在哪里时才会被发现。通用引擎无法安全地做到这一点,它需要深入了解模型的注意力架构。又一次证明,针对特定模型的引擎更有优势。
误区四:投机解码是免费的吞吐量
投机解码有一个近乎神奇的卖点:用廉价的草稿在一次前向计算中生成多个token,再并行验证,保留匹配的部分。基准测试对它爱不释手。但一旦你读到DeepInfer实际如何部署它,“免费”这个说法就站不住了。这些参数说明了问题:启用它需要DEEPINFER_ENABLE_MTP_VARLEN=1,限制草稿长度需要DEEPINFER_USE_NEXTN_DECODE,此外还有一层单独的置信度调度。如果它真的是免费的,你就用不着这些,直接一直起草就行了。
经济账是这样算的:草稿与验证每一步都要额外消耗FLOPs。只有当接受率足够高、使每步多产出的token超过额外开销时,才算赚到。接受率取决于草稿机制、领域(代码的草稿质量很好,散漫的散文就差些),以及最关键的批次负载。在大批次下,GPU本身已经受计算限制,额外的验证FLOPs会直接挤占真正的工作。投机解码在延迟受限的场景中表现出色,但在吞吐受限的场景中反而可能拖慢速度。同时服务两种场景的生产引擎,需要自适应地调度它,而基于置信度调度的验证正是为此而设计的。
我的看法是,在见过不少团队把投机解码硬塞进服务栈之后:应当把它当作延迟特性,而不是吞吐特性。如果你的瓶颈是高利用率下的每美元token数,先修好调度器和KV布局。如果你的瓶颈是中等负载下交互式用户的p99延迟,那么投机解码就是现有最好的工具之一,而DeepInfer为如何控制它的启用提供了一个经过实战检验的参考。
误区五:要大规模服务,只需要NVIDIA的认可(别的都不用管)
DeepInfer只支持两种硬件目标:NVIDIA SM100 GPU和华为昇腾950 NPU。它为每个平台分别维护依赖文件(requirements-nvidia.txt、requirements-ascend.txt),并据此控制功能开关,例如批不变推理仅限NVIDIA。这是一个不动声色却意义重大的表态。顶级的生产引擎把非NVIDIA加速器当作一等公民对待,使用相同的模型、相同的调度器,以及相同的服务架构。
需要说清楚这意味着什么、不意味着什么:它并不意味着昇腾路线已经成熟,也不意味着CUDA的护城河一夜之间就消失了,同一份README里那些仅限CUDA的功能,恰恰证明了生态差距真实存在。它的意义在于:推理可移植性中最难的软件问题(引擎、调度器、并行策略)现在变成了开源、Apache许可、从一开始就按双目标架构设计的项目。对于中小实验室和硬件厂商来说,这是可以在上面搭建的基础,而不是需要去克隆的围墙。关注旗舰级以下市场的人都清楚,经济性在多大程度上取决于此;我们之前也论证过小型快速档模型才是真正的推理效率故事,而硬件多元化会放大这一点。
并行设计也值得一提:注意力采用数据并行加均衡的上下文并行,MoE层采用专家并行,并配有专家并行负载均衡器。这套组合正是为DeepSeek所描述的部署方式量身调校的:prefill用少量GPU,decode用数十块GPU,并且两者分离。decode密集型的分离架构正在成为大型服务集群的默认设计,原因很简单:prefill受计算限制,decode受显存带宽限制,把它们放在一起,就会迫使你购买对两者都不算最优的硬件。
误区六:拿来就能直接跑
最后要破除的一个误区,针对的是那些点了星、周末就想把它接入技术栈的人。DeepInfer目前只支持一个模型系列:DeepSeek-V4.1-Flash。它需要Linux、GCC 13+、Python 3.12、CUDA 13和SM100硬件,也就是Blackwell架构一代的GPU,而大多数人手边并没有这些卡。基准测试是在一个scale-up域内用4块GPU做prefill、64块GPU做decode完成的。而真正搭建服务所需的三样东西(KV缓存系统、分离架构的管道,以及副本级负载均衡)都明确不在范围之内。这是引擎,不是整车。
但若因此就认为它无法使用,就错过了重点。我在这里要直言:这次发布的价值与其说是可以部署的软件,不如说是对“生产级”究竟意味着什么的一份规范。批不变推理作为一等开关。配合固定seq_seed实现可复现性的确定性采样。直接编译进采样器的结构化输出,而不是靠重试来打补丁。基于置信度的投机执行。异步调度作为默认配置,而非实验性功能。如果你正在构建或采购推理服务栈,这份README就是一份检查清单。如果你自己运行大模型(我们也有一篇在本地硬件上运行LLM的实用指南,适用于小规模场景),那么同样的优先级依然适用,只是规模不同:调度器优先,内存布局其次,内核最后。
前向计算是简单的部分。生产环境下的推理,是一个调度器、一个内存管理器和一个验证系统,它们恰好会调用内核。
这次发布的时间点颇为微妙:就在美国联邦排除令发布后几小时,评论区有人把它说成从礼物到破坏的各种解读,这些都会主导头条。好吧。但抛开戏剧性不谈,工程层面的结论依然站得住:我们过去对推理引擎的大多数认知,已经落后了一代。真正有意思的工作不再在内核里,而是在内核周围的一切之中。


