محرك الاستدلال من DeepSeek: 5 خرافات تحت الاختبار
فتحت DeepSeek مصدر محرك الاستدلال الإنتاجي لنماذج LLM. نختبر خمس معتقدات شائعة عن محركات الاستدلال مقابل ما يكشفه DeepInfer فعلاً.
 Sarah Chen

عندما دفعت DeepSeek محرك الاستدلال الإنتاجي الخاص بنماذج LLM إلى GitHub برخصة Apache 2.0، تجاوز المستودع آلاف النجوم خلال ساعات. هذا ليس مفاجئاً، المفاجئ حقاً هو ما يوجد داخله فعلاً. DeepInfer ليس لعبة بحثية ولا عرضاً مبسطاً. وهو المحرك الذي، بحسب DeepSeek نفسها، يخدم DeepSeek-V4.1-Flash بحجم معلن يبلغ 155 تريليون توكن يومياً لكل عنقود، بإيراد يقارب 38 دولاراً لكل ساعة GPU بتسعير خارج أوقات الذروة. هذه الأرقام، إن كانت دقيقة ولو تقريباً، تأتي من قرارات هندسية يعدّها معظم القطاع من المسلّمات. لذا دعونا نفعل ما كنت سأفعله مع أي نظام إنتاجي مفتوح المصدر حديثاً: نقرأ ملف README بعين المشكّك، ونختبر المعتقدات الشائعة عن محركات الاستدلال في ضوئه.
الخرافة 1: محرك الاستدلال مجرد تمريرة أمامية سريعة
النموذج الذهني الساذج يقول: النموذج هو النموذج، والمحرك غلاف رفيع يستدعي النوى، والأداء يأتي من شراء بطاقات GPU أسرع. قائمة ميزات DeepInfer نفسها تهدم هذا التصور. انظر إلى ما يستحق الشحن برأيه: جدولة غير متزامنة مع «جدولة دفعات بلا عبء إضافي»، وفك ترميز تخميني مع تحقق مجدول بناءً على الثقة، وإعادة تشغيل محدودة بنافذة الانتباه المنزلق، واستدلال ثابت للدفعات، وأخذ عينات حتمي، ومخرجات منظمة مقيّدة بتعبيرات منتظمة أو مخططات JSON أو قواعد EBNF. هذا مجدول، ومدير ذاكرة، ونظام تحقق، ومُترجم قيود، والنوى تكاد تكون فكرة لاحقة في القائمة.
هذا يتطابق مع ما يعيد الممارسون تعلمه باستمرار. التمريرة الأمامية هي الجزء السهل؛ فقد حُلّت إلى حد كبير منذ FlashAttention ومكتبات GEMM الجيدة. الجزء الصعب هو إبقاء وحدة GPU مشغولة. كل ميلي ثانية تبقى فيها وحدات SM خاملة بينما يقرر المعالج أي الطلبات يقبل، وأي كتل KV يُخلي، أو أي توكنات مسودة يتحقق منها، هي مال يتبخر. تُوجد الجدولة غير المتزامنة في DeepInfer تحديداً لتتداخل جدولة المعالج مع تنفيذ الجهاز، فلا تنتظر GPU أبداً بايثون. إذا كان مكدس الخدمة لديك لا يزال يجدول بشكل متزامن، فهذا التغيير الواحد يستحق على الأرجح أكثر من أي تبديل للنواة كنت تخطط له.
وهناك اعتراف لافت في ملف README: الخدمة الكاملة للاستدلال تحتاج أيضاً إلى نظام ذاكرة KV، وفصل مرحلتي prefill وdecode، وموازنة حمل عبر نسخ data-parallel المتماثلة، ولا شيء من ذلك مضمّن. بعبارة أخرى، حتى المحرك نفسه ليس سوى طبقة واحدة من النظام الحقيقي. الاستدلال الإنتاجي مشكلة أنظمة موزعة ترتدي زي تعلم الآلة. هذه نقطة سبق أن تناولناها عن وكلاء LLM الذين يشبهون الأنظمة الموزعة كثيراً، وتنطبق بالقدر نفسه على طبقة أسفل المكدس.
الخرافة 2: الدفعات الأكبر أفضل دائماً
أصبح التجميع المستمر، أي إدخال طلبات جديدة إلى الدفعة فور انتهاء غيرها بدلاً من انتظار الدفعة كاملة، من الأساسيات الآن، ومن الواضح أن DeepInfer يطبقه. لكن المعتقد الأكثر إثارة للاختبار هو نسخته المتسرعة: «الإنتاجية تتناسب مع حجم الدفعة، إذن كبّر الدفعة إلى أقصى حد». يشحن DeepInfer ميزتين وُجدتا تحديداً لأن هذا خاطئ.
أولاً، الاستدلال الثابت للدفعات (DEEPINFER_BATCH_INVARIANT=1). عادةً، قد تنحرف مخرجات الطلب بحسب ما يوجد معه في الدفعة، لأن ترتيب الاختزال في النوى يتغير مع تكوين الدفعة، وجمع الفاصلة العائمة ليس تجميعياً. رأت DeepSeek أن جعل النتائج متطابقة عبر تركيبات الدفعات يستحق الجهد الهندسي. لماذا؟ لأنك بمجرد الخدمة على نطاق واسع تكتشف أن العملاء وخطوط تقييم النماذج يلاحظون عندما تعيد الموجهة نفسها توكنات مختلفة في أيام مختلفة. إذا كان تعظيم حجم الدفعة يعني قبول اللاحتمية، فقد اختارت DeepSeek إنفاق جزء من الإنتاجية لاستعادة الحتمية. وهذا يدل على أن دالة الهدف الحقيقية ليست التوكنات الخام في الثانية، بل التوكنات الجديرة بالثقة في الثانية.
ثانياً، التحقق المجدول بناءً على الثقة في فك الترميز التخميني. يُنشئ المحرك مسودات من التوكنات (الحد الأقصى الافتراضي لطول المسودة 5) ويستخدم تقديرات الثقة لتقرير حجم عمل التحقق الذي يُجدول. النهج الساذج يتحقق من مسودة بطول ثابت في كل خطوة، والنهج الذكي يُدرك أن الكمية المثلى من العمل التخميني تختلف لكل طلب ولكل خطوة. تجميع عمل تخميني أكثر مما تبرره الثقة يُهدر حوسبة على توكنات ستتخلص منها، وتجميع أقل يترك التسارع على الطاولة. الجدولة تحل مسألة تحسين في كل خطوة، لا مجرد حشر الطلبات معاً.
- حجم الدفعة يرفع الإنتاجية لكنه يرفع زمن الاستجابة أيضاً، إذ يتدهور زمن الوصول إلى أول توكن كلما كبرت دفعات prefill.
- تركيب الدفعة يغيّر الحسابات العددية، فما لم تدفع مقابل نوى ثابتة للدفعات، ستنحرف المخرجات.
- للعمل التخميني عوائد متناقصة، إذ تنخفض معدلات قبول المسودات مع طول المسودة، لذا الجداول الثابتة تهدر عمليات الفاصلة العائمة.
- ذاكرة KV هي السقف الحقيقي، فلا يمكن للدفعة أن تنمو فوق ما تستطيع الذاكرة استيعابه، ولهذا يهم تخطيط الذاكرة أكثر من سياسة الدفعات.
الخرافة 3: إدارة ذاكرة KV مشكلة محسومة
شاع PagedAttention النهج المستوحى من أنظمة التشغيل: تخصيص ذاكرة KV في صفحات ثابتة الحجم، وتوزيعها كما تُوزَّع الذاكرة الافتراضية، والتوقف عن التجزؤ. أثبت vLLM أن الفكرة تعمل، وDeepInfer، بحسب إقراراته، بُني في الأصل بشكل أساسي فوق vLLM. إذن ذاكرة KV المقسّمة إلى صفحات يجب أن تكون منتهية، أليس كذلك؟ ليس تماماً. يذكر ملف README لدى DeepInfer بعبارة عابرة شيئاً أشد جرأة: من أهداف التصميم في النظام الإنتاجي الاحتفاظ بذاكرة KV لأكثر من 72 ساعة.
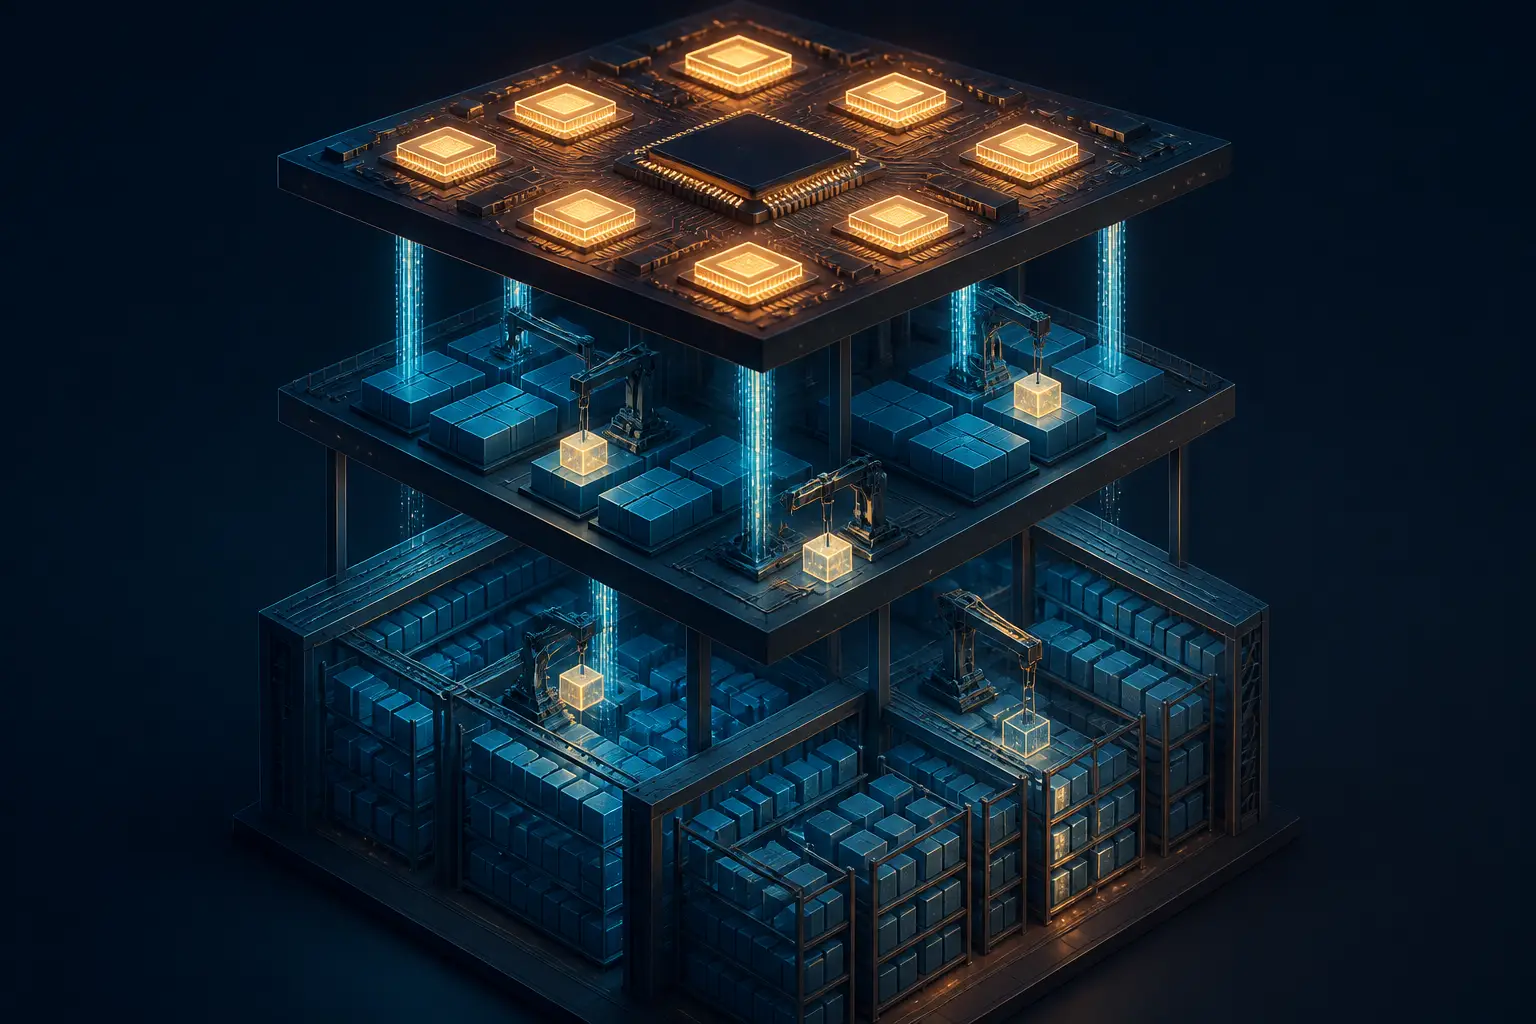
فكّر فيما يعنيه هذا. ذاكرة HBM حتى على أكبر بطاقات GPU تُقاس بمئات الغيغابايت، وذاكرة تخزين مؤقت لمدة 72 ساعة عبر عنقود مزدحم تعني بيتابايتات من الحالة. لا يمكنك إبقاء ذلك على الجهاز. تحتاج إلى نظام KV متدرج، فيه HBM وDRAM للمضيف وNVMe وربما تخزين بعيد، مع سياسات إخلاء وجلب مسبق ذكية بما يكفي كي لا يؤدي استرجاع بادئة قديمة إلى تدمير اتفاقية مستوى الخدمة للزمن. لهذا يذكر ملف README «نظام ذاكرة KV» ضمن ما ليس مضمّناً في الإصدار: إنها بنية تحتية منفصلة وجادة. إذا كنت تتعامل مع ذاكرة KV كمشكلة تقسيم صفحات داخل GPU، فقد انتقلت الحدود إلى معاملتها كنظام تخزين. تناولنا النسخة الأصغر من هذا الألم في ما تفعله حين تنفد ذاكرة VRAM في بطاقة GPU لديك، لكن هذا هو الأمر نفسه بحجم مراكز البيانات.
هناك حيلة أدق في KV تستحق السرقة: إعادة التشغيل المحدودة لـ SWA. بالنسبة لطبقات الانتباه ذات النافذة المنزلقة في المفكِّك، لا تحتاج إلى إعادة تشغيل المطالبة كاملة أثناء prefill، بل فقط لاحقة محدودة تغطي نافذة الانتباه بالإضافة إلى أقصى طول للتراجع (الافتراضي: الاحتفاظ بـ 140 توكناً). هذا تخفيض مباشر لحوسبة prefill مع السياقات الطويلة، وهو نوع التحسين الذي لا تكتشفه إلا حين تقيس أين تذهب عمليات الفاصلة العائمة في prefill فعلاً. المحركات العامة لا تستطيع فعل هذا بأمان، فهو يتطلب معرفة عميقة ببنية الانتباه في النموذج. المحركات الخاصة بنموذج معين تفوز مرة أخرى.
الخرافة 4: فك الترميز التخميني إنتاجية مجانية
يملك فك الترميز التخميني وعداً شبه سحري: توليد عدة توكنات في تمريرة أمامية واحدة باستخدام مسودة رخيصة، والتحقق منها بالتوازي، والاحتفاظ بما يطابق. تحب المعايير هذه الفكرة. لكن الاعتقاد بأنها «مجانية» ينهار حين تقرأ كيف ينشرها DeepInfer فعلاً. تحكي الأعلام القصة: DEEPINFER_ENABLE_MTP_VARLEN=1 لتفعيلها، وDEEPINFER_USE_NEXTN_DECODE لتحديد سقف طول المسودة، وطبقة جدولة ثقة منفصلة فوقها. لو كانت مجانية لما احتجت أياً من ذلك، بل كنت ستخمّن دائماً ببساطة.
الاقتصاد يعمل هكذا. التخمين والتحقق يكلفان عمليات فاصلة عائمة إضافية في كل خطوة. لا تربح إلا عندما يكون معدل القبول مرتفعاً بما يكفي لتتجاوز زيادة التوكنات لكل خطوة التكلفة الإضافية. ومعدلات القبول تعتمد على آلية المسودة، والمجال (الشيفرة البرمجية تُخمَّن بشكل جميل، والنثر المتشعب أقل من ذلك)، والأهم من ذلك، حمل الدفعة. عند أحجام الدفعات الكبيرة، تكون وحدة GPU مقيدة أصلاً بالحوسبة، فعمليات التحقق الإضافية تزاحم العمل الحقيقي بشكل مباشر. يتألق فك الترميز التخميني في النظام المقيّد بزمن الاستجابة، وقد يضر فعلاً في النظام المقيّد بالإنتاجية. المحرك الإنتاجي الذي يخدم النظامين يحتاج إلى جدولته بشكل تكيفي، وهذا بالضبط ما يفعله التحقق المجدول بناءً على الثقة.
رأيي، بعد أن راقبت فرقاً تُلحق فك الترميز التخميني بمكدسات الخدمة: عامله كميزة زمن استجابة، لا ميزة إنتاجية. إذا كان عنق الزجاجة لديك هو عدد التوكنات لكل دولار عند استخدام مرتفع، فأصلح الجدولة وتخطيط KV أولاً. وإذا كان عنق الزجاجة هو زمن p99 للمستخدمين التفاعليين عند حمل متوسط، فإن فك الترميز التخميني من أفضل الأدوات المتاحة، وDeepInfer يمنحك مرجعاً مُجرَّباً لكيفية ضبط بوابته.
الخرافة 5: تحتاج إلى موافقة NVIDIA (ولا شيء غيرها) كي تخدم على نطاق واسع
يدعم DeepInfer بالضبط هدفين للعتاد: وحدات NVIDIA SM100 ووحدات Huawei Ascend 950 NPU. يحتفظ بملفات متطلبات منفصلة لكل منصة (requirements-nvidia.txt، requirements-ascend.txt) ويُقيّد الميزات وفقاً لذلك، فالاستدلال الثابت للدفعات مثلاً خاص بـ NVIDIA فقط. هذا بيان هادئ لكنه مهم. محرك إنتاجي من الطراز الأول يعامل مسرّعاً غير تابع لـ NVIDIA كمواطن من الدرجة الأولى، بالنموذج نفسه والجدولة نفسها وبنية الخدمة نفسها.
لنكن واضحين فيما يعنيه هذا وما لا يعنيه: لا يعني أن مسار Ascend ناضج، ولا يعني أن خندق CUDA يتبخر بين ليلة وضحاها، فميزات CUDA الحصرية في ملف README نفسه دليل على أن فجوة المنظومة حقيقية. ما يعنيه أن أصعب مشكلة برمجية في نقل الاستدلال بين العتاد (المحرك والمجدول واستراتيجية التوازي) أصبحت مفتوحة ومرخصة بـ Apache ومصممة لتعمل على الهدفين منذ البداية. بالنسبة للمختبرات الأصغر ولبائعي العتاد، هذه أرضية للبناء عليها لا جدار لاستنساخه. ومن يتابع طرف الفئة الخفيفة من السوق يعرف مقدار ارتكاز الاقتصاد على هذا؛ وقد جادلنا من قبل بأن نماذج الفئة الخفيفة هي القصة الحقيقية لكفاءة الاستدلال، وتعدد العتاد يضاعف أثرها.
يستحق تصميم التوازي ذكراً هنا أيضاً: توازي البيانات للانتباه مع توازي السياق المتوازن، إضافةً إلى توازي الخبراء لطبقات MoE مع موازن أحمال لتوازي الخبراء. هذا المزيج مضبوط لنشر تصفه DeepSeek بالضبط، أي حفنة من بطاقات GPU لـ prefill وعشرات لـ decode، مفصولة. أصبح الفصل الثقيل لمرحلة decode البنية الافتراضية لأساطيل الخدمة الكبيرة، والسبب حساب بسيط: prefill مقيد بالحوسبة وdecode مقيد بعرض نطاق الذاكرة، فدمجهما يجبرك على شراء عتاد غير مثالي لأي منهما.
الخرافة 6: يمكنك أن تأخذه وتشغّله فوراً
معتقد أخير يجب دحضه، موجه إلى كل من وضع نجمة للمستودع ويخطط لدمجه في مكدسه هذا الأسبوع. يخدم DeepInfer حالياً عائلة نماذج واحدة فقط: DeepSeek-V4.1-Flash. يتطلب Linux وGCC 13 فما فوق وPython 3.12 وCUDA 13 ووحدات SM100، وهي من جيل Blackwell، وهو عتاد لا يملكه معظمنا جاهزاً. قيست المعايير على 4 بطاقات GPU لـ prefill و64 لـ decode داخل نطاق توسّع واحد. والأشياء الثلاثة التي تحتاجها لخدمة فعلية، أي نظام ذاكرة KV، وأنابيب الفصل، وموازنة الأحمال بين النسخ، خارج النطاق صراحةً. هذا هو المحرك، لا السيارة كاملة.
لكن رفضه باعتباره غير قابل للاستخدام يفوّت المغزى، وهنا سأكون صريحاً في رأيي. الإصدار قيّم ليس كبرنامج تنشره بقدر ما هو توصيف لمعنى الجودة الإنتاجية الحقيقية. الاستدلال الثابت للدفعات كعلم من الدرجة الأولى. أخذ عينات حتمية مع seq_seed ثابت لإمكانية إعادة الإنتاج. مخرجات منظمة تُترجم داخل أداة أخذ العينات بدلاً من إلحاقها عبر إعادة المحاولة. التخمين المجدول بناءً على الثقة. الجدولة غير المتزامنة كخيار افتراضي لا كتجربة. إذا كنت تبني مكدس استدلال أو تشتريه، فهذا الملف هو قائمة مراجعة. وإذا كنت تشغّل نماذج كبيرة بنفسك، ولدينا دليل عملي لتشغيل نماذج LLM على عتادك الخاص للطرف الصغير منها، تنطبق الأولويات نفسها بحجم مختلف: الجدولة أولاً، ثم تخطيط الذاكرة، ثم النوى.
التمريرة الأمامية هي الجزء السهل. الاستدلال الإنتاجي هو جدولة ومدير ذاكرة ونظام تحقق، يستدعي النوى صدفةً.
التوقيت الجيوسياسي، أي الصدور بعد ساعات من أمر استبعاد فيدرالي أمريكي، مع تعليقات تصفه بكل شيء من هدية إلى تخريب، سيهيمن على العناوين. حسناً. لكن إذا نزعنا الدراما، يبقى الحكم الهندسي قائماً بذاته: معظم ما اعتقدناه عن محركات الاستدلال كان متأخراً جيلاً كاملاً. العمل المثير لم يعد في النوى. إنه في كل ما يحيط بها.


