نماذج الكلام Full-Duplex: 5 خرافات عن الذكاء الصوتي مختبرة
نماذج Full-Duplex للكلام مثل Dessa تكشف لماذا لا تبدو خطوط ASR وLLM وTTS طبيعية. نختبر خمس خرافات عن الذكاء الصوتي للمحادثة.
 Sarah Chen
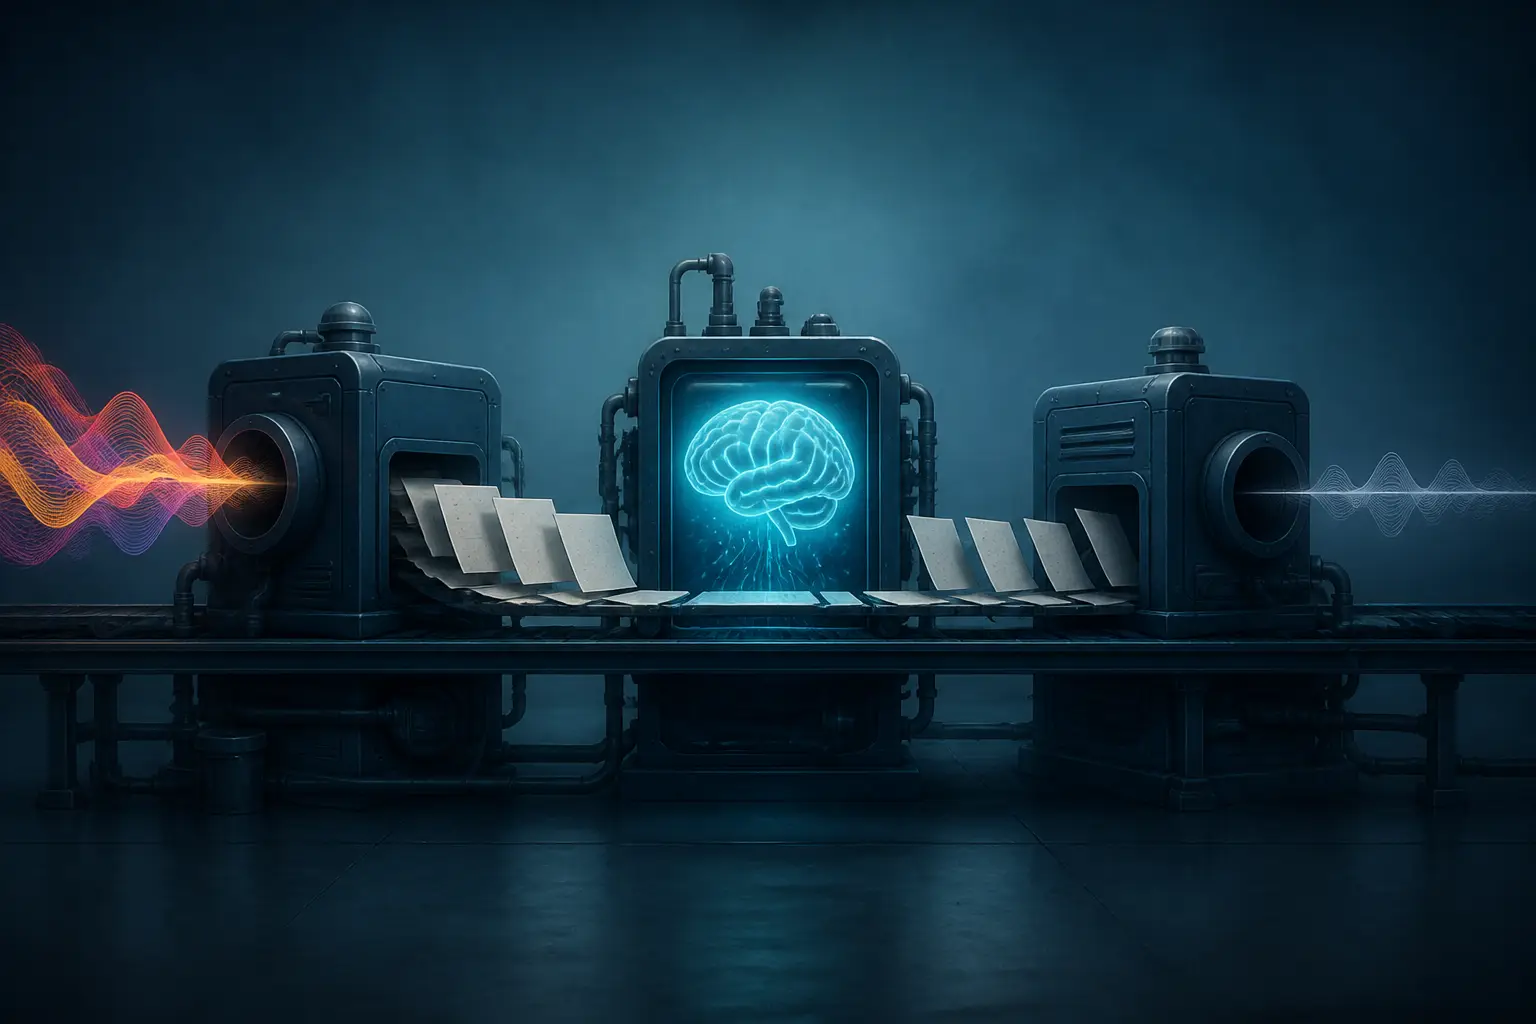
قضيت سنتين أبني مساعدات صوتية على التركيبة الكلاسيكية: تحويل الكلام إلى نص في البداية، ونموذج لغوي في الوسط، وتحويل النص إلى كلام في النهاية. كل تحسين للزمن الكامن شحنّاه جعل النظام أسرع، لكنه بطريقة ما أسوأ. موجة نماذج الكلام ثنائية الاتجاه (full-duplex) الأخيرة، مثل Dessa، وهي نسخة معاينة بحثية من مختبر صغير تابع لشركة Block، دُرِّبت من الصفر على محادثات بشرية خام فقط، وضّحت أخيرًا السبب. المشكلة لم تكن السرعة أبدًا، بل المعمارية. وكمية الأساطير المتداولة حول كيف «يُفترض» أن يعمل الذكاء الاصطناعي الصوتي مذهلة. لذا دعونا نفعل ما فعلناه مع خرافات محرك الاستدلال لدى DeepSeek: نأخذ المعتقدات الشائعة حول الذكاء الاصطناعي الصوتي للمحادثة ونختبرها فعليًا مقابل ما تُظهره هذه النماذج الجديدة.
الخرافة 1: خطوط المعالجة المتتالية تحتاج فقط إلى زمن كامن أقل
هذا هو الاعتقاد الذي تمسكت به أطول مدة، وهو الأكثر خطأً. المعمارية القياسية، أي التعرف التلقائي على الكلام (ASR) الذي يغذي نموذجًا لغويًا كبيرًا (LLM) الذي يغذي تحويل النص إلى كلام (TTS)، لها عيب قاتل لا يمكن لأي قدر من الهندسة إصلاحه: المرحلة الأولى تحذف الإشارة التي تقوم عليها المحادثة.
عندما تُحوِّل الكلام إلى نص، فإنك تحتفظ بالكلمات وتتخلص من كل ما عداها. التردد. السخرية. التنهيدة قبل كلمة «بخير». الشرخ في الصوت الذي يخبرك أن أحدهم على وشك البكاء. مرحلة ASR لديك تحوّل كل ذلك إلى سلسلة مثل «أنا بخير»، والنموذج اللغوي اللاحق ليس لديه أي طريقة حرفية ليعرف أن المستخدم مستاء. يمكنك إضافة مصنّف مشاعر منفصل، صحيح، فتصبح لديك الآن نموذج رابع، وزمن كامن إضافي بمقدار 100 ملي ثانية، وتسمية مثل sadness: 0.73 يعاملها النموذج اللغوي كرمز وليس كشعور. إنه ضغط مع فقدان للبيانات مطبَّق على الجزء من القناة الذي يحمل أكبر قدر من المعنى.
هناك مشكلة ثانية أدق: الزمن الكامن في خط المعالجة تراكمي ومتسلسل. لا يستطيع ASR إنهاء عمله حتى تتوقف عن الكلام (أو يخمّن نقطة النهاية)، ولا يستطيع النموذج اللغوي البدء حتى ينتهي ASR، ولا يستطيع TTS البدء حتى يُصدر النموذج اللغوي رموزه. البشر لا يعملون هكذا. نبدأ في صياغة ردّنا بينما الطرف الآخر ما زال في منتصف جملته، ولهذا يبلغ متوسط الفاصل بين الأدوار في المحادثة الطبيعية نحو 200 ملي ثانية، وهو أسرع مما تستطيع معظم الأنظمة المتتالية حتى إنهاء مرحلة ASR. نموذج ثنائي الاتجاه يعالج الصوت الداخل والخارج بشكل مستمر في شبكة واحدة يتجاوز الطابور كله. الفرق كالفرق بين سباق التتابع وشخصين يتحدثان ببساطة.
الحكم: خرافة مدحوضة. ضبط الزمن الكامن في خط معالجة متتالٍ يعني تحسين المتغير الخاطئ. المعمارية نفسها هي الاختناق.
الخرافة 2: النص يلتقط كل ما يهم في المحادثة
جرّب هذه التجربة، التي استعرتها من كتابة فريق Dessa لأنها أوضح مثال رأيته: قل هذه الجملة بصوت عالٍ سبع مرات: «لم أقل إنها سرقت كود CUDA الخاص بي»، مع تشديد كلمة مختلفة في كل مرة. سبع سلاسل نصية متطابقة. سبعة معانٍ مختلفة تمامًا: نفي للاتهام، وإيحاء بأن شخصًا آخر هو السارق، وجدال حول الفعل. أي نظام نصي يرى مدخلًا واحدًا. أما النموذج الأصلي للكلام فيرى سبعة.
النبرة الصوتية، أي التشديد والنغمة والإيقاع والسرعة، ليست زينة فوق اللغة. في المحادثة المنطوقة هي جزء كبير منها. الضحك في منتصف الجملة يدل على شيء مختلف عن الضحك بعدها. إشارات المتابعة («آه»، «ممم»، «فهمت») لا تحمل أي محتوى معجمي، ومع ذلك فإن محادثة خالية منها تشعر وكأنك تتحدث إلى جدار. إذا كان التمثيل الداخلي لنظامك نصيًا، فقد خسرت بالفعل. المعلومات لا تدخل النموذج أصلًا، لذا لا يمكن لأي ذكاء لاحق أن يستعيدها. إنها نظرية نايكويست مطبقة على تجربة المستخدم: إذا أخذت عينات بأقل من عرض نطاق الإشارة، فالتشويه الناتج دائم.
لهذا بُعد أمان حقيقي أيضًا، وهو الحجة التي أجدها الأكثر إقناعًا. مساعد صوتي يسمع «أنا أعاني ألمًا شديدًا» بنبرة باردة لا يدرك الإلحاح في الوسيلة نفسها التي يعيش فيها الإلحاح. يوضح فريق Dessa ذلك صراحةً: مع ازدياد استقلالية أنظمة الذكاء الاصطناعي، فإن العمى عن المحتوى العاطفي للكلام البشري ليس مجرد فجوة في تجربة المستخدم، بل خطر. سواء اقتنعت بنموذجهم كحل أم لا، فالتشخيص صحيح.
الحكم: خرافة مدحوضة، ولم تكن قريبة من الصواب أصلًا. النص إسقاط للكلام، وكأي إسقاط يفقد بُعدًا.
الخرافة 3: تبادل الأدوار مجرد مشكلة كشف نشاط الصوت
اسأل معظم المهندسين كيف يعرف المساعد الصوتي متى يتكلم، وسيقولون «تحديد النهاية» (endpointing): وحدة VAD تنتظر N ملي ثانية من الصمت ثم تسلّم الكلام. لهذا السبب كل مساعد صوتي استخدمته يقاطعك في منتصف فكرتك، أو يبقى صامتًا بشكل مزعج بعد أن تنتهي. الصمت وكيل سيئ لفكرة «دوري الآن». البشر يتوقفون في منتصف الجملة ليفكروا، ويتركون الكلام معلقًا بدعوة، ويسرّعون عندما يريدون الاحتفاظ بالكلام، ويبطئون عندما يتنازلون عنه. تبادل الأدوار يُتفاوض عليه باستمرار عبر النبرة والنحو والسياق، فهو يُتنبأ به لا يُكتشف.
نماذج الاتجاهين تتعامل مع هذا كمشكلة نمذجة من الدرجة الأولى. لأنها تستمع وتتكلم في الوقت نفسه، يمكنها تعلّم التوزيع الفعلي لتوقيت المحادثة البشرية: متى تُصدر إشارات المتابعة، ومتى تقفز لإكمال جملة شخص متعثرة (في أحد عروض Dessa يوفّر عنوان فيلم يتعذر على الإنسان تذكّره)، ومتى تصمت. المقاطعة ليست حالة خطأ يجب قمعها، بل إشارة يجب نمذجتها. هذه إعادة الصياغة هي الإسهام الحقيقي هنا، أكثر من أي عرض منفرد.
لكن هنا سأعترض على الضجيج، لأن معلّقي Hacker News على حق في نقطة مشروعة: يبدو العديد من هذه العروض متحمسًا أكثر من اللازم. عندما يضحك النموذج قبل أن ينتهي الإنسان من جملته، أو يندفع إلى مونولوج، يبدو كنموذج تعلّم أن «المقاطعة = الطبيعية» بإتقان زائد. التنبؤ بتبادل الأدوار عندما يُنفَّذ بإتقان تام يكون غير مرئي. ولكن إذا نُفِّذ بنسبة 80%، فهو أكثر إزعاجًا من تأخير مهذب لنصف ثانية، لأن المقاطعة السيئة تبدو وقحة بطريقة لا تبدو بها الاستجابة البطيئة. وادي الغرابة (uncanny valley) في توقيت المحادثة حقيقي، ولم يعبره أحد بالكامل بعد.
الحكم: مدحوضة جزئيًا. تبادل الأدوار مشكلة تعلّم حقيقية، لا مشكلة عتبات، لكن النماذج الحالية تثبت أن المنهج صحيح أكثر مما تثبت أن المشكلة محلولة.
الخرافة 4: تحتاج إلى بيانات نصية بحجم الإنترنت لتتعلم اللغة
يبدو هذا بديهيًا: نماذج LLM تستهلك تريليونات الرموز، إذن اللغة تحتاج تريليونات الرموز، حتى تتذكر أن كل إنسان تعلّم الكلام من بضع سنوات من التعرض للصوت دون أي نص. الرضّع هم الدليل على أن متطلبات البيانات أقل بكثير مما تفترضه كتب اللعب الخاصة بـ LLM. Dessa هي النسخة الآلية لهذه التجربة: دُرِّبت من الصفر، دون أوزان مدرَّبة مسبقًا، ودون أي نص إطلاقًا، وفقط على محادثات بشرية مسجلة. ووفقًا لادعاءات الفريق، تعلمت اللغة من مئات المرات أقل من الكلمات مقارنةً بمجموعة نصوص نموذج LLM نموذجية.
قبل أن نتوج الصوت بأنه إشارة التدريب الأفضل، هناك تحفظات صريحة. أولًا، الكلمة المنطوقة تكلف آلاف الأضعاف من البايتات مقارنةً بشكلها النصي، والكلام لا يتكرر أبدًا، فالجملة نفسها إذا قيلت مرتين تُعد بيانات مختلفة. لذا «كلمات أقل» لا تعني «بايتات أقل»؛ بل تعني كلمات أقل، وهذا ادعاء عن كمية المعلومات التي يحملها الكلام لكل وحدة معجمية، وليس عن كفاءة البيانات بمعنى التخزين. ثانيًا، مجموعات نصوص LLM ليست لغة فقط، بل أكواد ورياضيات وLaTeX، والسجل المكتوب بأكمله للمعرفة البشرية. نموذج الكلام فقط يعرف الكثير بشكل مدهش بالنسبة لنظامه التدريبي، لكن لن يطلب منه أحد مراجعة طلب الدمج (pull request) الخاص بك. يرتبط هذا بنمط أوسع سبق أن تناولناه: الاختبارات المعيارية والعروض التجريبية تلتقط شريحة ضئيلة مما يتطلبه العمل الحقيقي، والسحر الحواري قدرة مختلفة تمامًا عن عمق الاستدلال.
ما تثبته النتيجة فعلًا مثير للاهتمام بحثيًا: بنية اللغة قابلة للتعلم من الصوت وحده، وهذا يخبرنا بشيء حقيقي عن مقدار «اللغة» الذي يعيش في الأعراف النصية مقابل ما يعيش في الكلام نفسه. كما تفتح أسئلة عملية: هل تستطيع النماذج الأصلية للكلام التقاط اللغات قليلة الموارد حيث يتوفر الصوت دون نص مفرّغ؟ هذا خيط يستحق السحب، خاصة مع مدى معاناة أعمال الترجمة للغات قليلة الموارد من نقص مجموعات النصوص.
الحكم: مدحوضة في الغالب بالنسبة للغة المنطوقة، مع استثناء بحجم مركز بيانات. التعلم من الكلام وحده يعمل، لكنه يحسّن لشيء مختلف عن التعلم من النص وحده.
الخرافة 5: الصوت الواقعي يعني نظامًا ذكيًا، أو آمنًا
هذه هي الخرافة التي يجب أن تقلقك، وقد لاحظها قسم التعليقات فورًا: «انتحال الشخصية، هذا هو الغرض منه». قاسية، لكنها صحيحة في الاتجاه. الطلاقة والذكاء متعامدان، والطلاقة الكلامية هي الأكثر إقناعًا بينهما. نموذج يلهث «يا إلهي» على قصة ذكرى زواجك بتوقيت مؤثر مثالي يفعل شيئًا رائعًا تقنيًا، لكن لا شيء في ذلك يعني أنه يستدل جيدًا أو يعرف الحقائق بموثوقية أو لن يختلق أشياء بثقة بصوت دافئ ومتعاطف. بل إن الإلقاء المعبّر يُخفي الاستدلال السطحي، فنحن مبرمجون لنثق بالمتحدثين الواثقين والمتفاعلين عاطفيًا. هذا هو أساس الاحتيال.
نموذج التهديد يكتب نفسه: استنساخ الصوت مع قدرة المحادثة ثنائية الاتجاه مع انتحال معرّف المتصل هو مجموعة احتيال تتجاوز الغريزة التي يعتمد عليها معظم الناس: «كنت سأعرف إذا لم يكن هو». أحد المعلقين اقترح تخفيفًا يستحق التبني: سؤال تحدٍّ عن ذاكرة مشتركة لأي اتصال مشبوه من شخص تعرفه. يبدو الأمر مبالغًا فيه، لكنه سيصبح ممارسة قياسية. وللفريق الفضل في أنهم يدعون صراحةً باحثي السلامة إلى اختبار النموذج قبل إصدار أوسع، وهذا أكثر مما تفعله معظم المختبرات. لكن التقنية نفسها ذات استخدام مزدوج بأوضح معنى للكلمة، ولا يغيّر أي قدر من التأطير ذلك.
هناك أيضًا قصة تكلفة مدفونة هنا تسير في الاتجاه المعاكس، وبطريقة جيدة. الادعاء أن الاستدلال يعمل أسرع من الزمن الحقيقي على MacBook Pro بشريحة M4 Max، وأن التدريب تم على نظام NVIDIA GB200 NVL72 واحد. إذا صمدت هذه الأرقام، فهذا مذهل: ذكاء اصطناعي محادثاتي بإحساس متقدم غير محصور خلف مجموعة حوسبة ضخمة. الاستدلال المحلي مهم للخصوصية (صوتك لا يغادر الجهاز)، وللزمن الكامن (لا قفزة شبكية في منتصف تدفق ثنائي)، ولمن يُتاح له البناء على هذه التقنية. اتجاه الكفاءة في النماذج الصغيرة القادرة سبق أن أشرنا إليه مع نماذج LLM من فئة Flash، فالمجال المثير في الاستدلال يتجه أكثر فأكثر نحو طرف «يعمل على عتادك أنت» من الطيف.
الحكم: مدحوضة، وهي الأخطر في القائمة. تعامل مع الواقعية الصوتية كخاصية واجهة مستخدم، لا كإشارة قدرة أو ثقة، وحدّث عاداتك الأمنية الشخصية وفقًا لذلك.
ما الذي يغيّره هذا فعليًا
إذا تجاوزنا تسويق «الأكثر أصالة الذي صُنع على الإطلاق» (وقد أُشرف على العنوان في Hacker News لسبب ما)، فما يتبقى لا يزال مهمًا: نموذج الكلام الشامل شيء مختلف جوهريًا عن خط المعالجة، والفروق تتراكم. تبقى العاطفة ضمن الحلقة. يصبح التوقيت سلوكًا متعلّمًا بدلًا من عتبة مضبوطة يدويًا. وتصبح المقاطعات بيانات. لا شيء من ذلك ممكن بمجرد جعل ASR أسرع بـ50 ملي ثانية.
رأيي العملي، كمن شحن المعمارية القديمة: خطوط المعالجة المتتالية ليست ميتة. بالنسبة لواجهات الصوت المعاملاتية، مثل التحقق من رصيد، أو حجز موعد، أو التحكم في جهاز، فهي كافية، وقابلة للتصحيح، وكل مرحلة قابلة للاستبدال بشكل مستقل. كما أن النصوص الوسيطة تمنحك التسجيل والتنقيح وفرض السياسات مجانًا، وهذا مهم جدًا في بيئة الإنتاج. لكن لأي شيء تكون فيه المحادثة هي المنتج، مثل التدريس والرفقة وأدوات إمكانية الوصول وتدريب التفاوض، يصبح خط المعالجة طريقًا مسدودًا، والصوت الشامل هو المعمارية الوحيدة التي يمكن أن تبدو طبيعية. اختر بناءً على ما إذا كان مستخدموك يتحدثون إلى الآلة أم من خلالها.
الأسئلة المفتوحة هي الممتعة. ما مدى جودة التعلم في السياق عندما يكون السياق صوتيًا؟ هل تستطيع هذه النماذج الاحتفاظ بحالة محادثة طويلة دون عكاز النص المفرّغ؟ هل تجعل الطلاقة العاطفية الأخطاء أكثر ضررًا لأن المستخدمين يثقون بالإلقاء؟ والسؤال المحرج: عندما تعمل هذه الجودة من الانتحال محليًا على حاسوب محمول، كيف سيبدو التحقق من هوية الإنسان أصلًا؟ المختبرات التي ستجيب عن هذه الأسئلة بصدق ستكون أهم من تلك التي تملك أكثر عروض الفيديو لمعانًا.
الصوت هو أقدم واجهة يملكها البشر. أمضينا أربعين عامًا نجبره على المرور عبر فتحة بشكل النص، ثم نتساءل لماذا بدا خاطئًا. اتضح أن الفتحة هي المشكلة.


