फुल-डुप्लेक्स स्पीच मॉडल: वॉइस AI के 5 मिथक, परखे गए
Dessa जैसे फुल-डुप्लेक्स स्पीच मॉडल बताते हैं कि ASR-LLM-TTS पाइपलाइन स्वाभाविक क्यों नहीं लग सकतीं। कन्वर्सेशनल वॉइस AI के पाँच मिथकों की जाँच।
 Sarah Chen
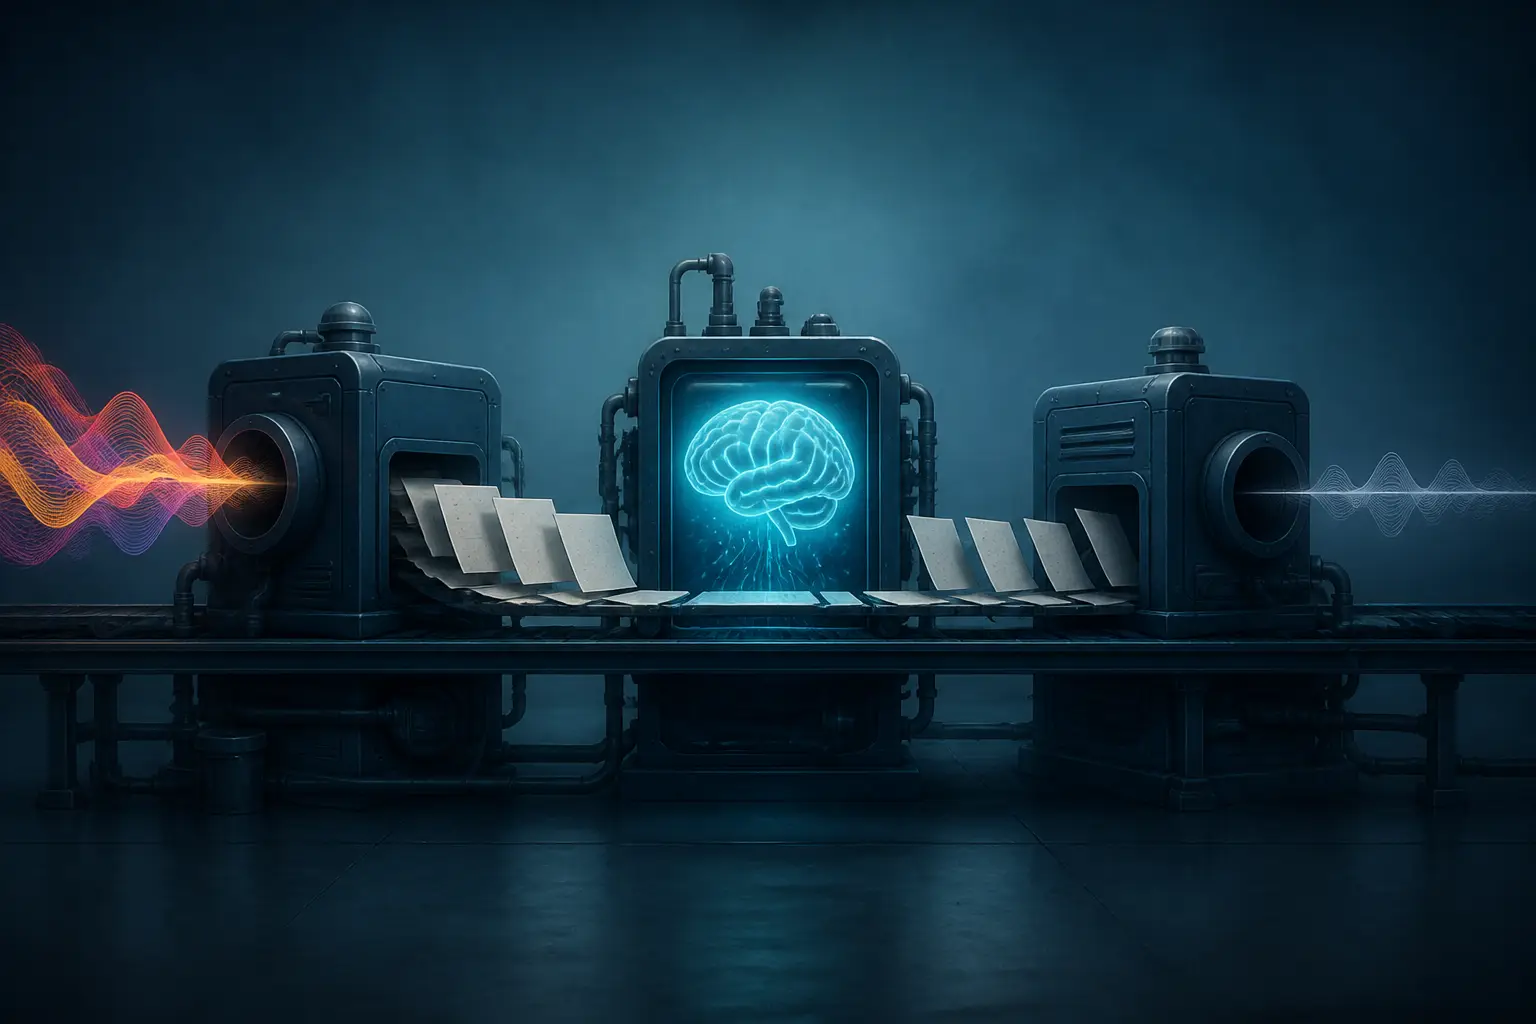
मैंने दो साल क्लासिक स्टैक पर वॉइस असिस्टेंट बनाने में लगाए: स्पीच-टू-टेक्स्ट इनपुट, बीच में लैंग्वेज मॉडल, और टेक्स्ट-टू-स्पीच आउटपुट। हर लेटेंसी ऑप्टिमाइज़ेशन जो हमने भेजा, उससे सिस्टम तेज़ तो हुआ, पर किसी तरह और बुरा लगने लगा। फुल-डुप्लेक्स स्पीच मॉडल की हालिया लहर, जैसे Dessa, जो Block की एक छोटी लैब का रिसर्च प्रीव्यू है और जिसे बिल्कुल शुरुआत से सिर्फ़ कच्ची इंसानी बातचीत पर ट्रेन किया गया, आखिरकार यह समझाती है कि ऐसा क्यों होता था। समस्या कभी स्पीड की नहीं थी। समस्या आर्किटेक्चर की थी। और वॉइस AI को "कैसे काम करना चाहिए" इसको लेकर जो किस्से-कहानियाँ चल रही हैं, वे हैरान करने वाली हैं। तो चलिए वही करते हैं जो हमने DeepSeek के inference engine वाले मिथकों के साथ किया था: बातचीत वाले स्पीच AI की आम मान्यताओं को उठाकर देखते हैं कि ये नए मॉडल असल में क्या दिखाते हैं।
मिथक 1: कैस्केडेड पाइपलाइन को बस कम लेटेंसी चाहिए
यह वह विश्वास था जिसे मैंने सबसे लंबे समय तक पकड़े रखा, और यह सबसे ज़्यादा गलत है। मानक आर्किटेक्चर, यानी automatic speech recognition (ASR) से LLM और फिर text-to-speech (TTS), में एक घातक खामी है जिसे कोई इंजीनियरिंग ठीक नहीं कर सकती: पहला चरण उस सिग्नल को ही मिटा देता है जिस पर बातचीत चलती है।
जब आप स्पीच को ट्रांसक्राइब करते हैं, तो शब्द रख लेते हैं और बाकी सब फेंक देते हैं। झिझक। व्यंग्य। "ठीक है" से पहले की आह। आवाज़ में वह दरार जो बताती है कि कोई रोने वाला है। आपका ASR चरण यह सब "I'm fine" जैसी एक स्ट्रिंग में बदल देता है, और आगे का LLM जान ही नहीं पाता कि यूज़र परेशान है। आप एक अलग emotion classifier जोड़ सकते हैं, अब आपके पास चौथा मॉडल है, 100ms की और देरी है, और sadness: 0.73 जैसा लेबल है, जिसे LLM अब भी एक टोकन मानता है, भावना नहीं। यह उस चैनल के सबसे अर्थपूर्ण हिस्से पर लागू किया गया lossy compression है।
एक दूसरी, ज़्यादा सूक्ष्म समस्या है: पाइपलाइन में लेटेंसी जुड़ती भी है और क्रमिक भी होती है। ASR तब तक पूरा नहीं हो सकता जब तक आप बोलना बंद न करें (या वह एंडपॉइंट का अनुमान न लगा ले), LLM तब तक शुरू नहीं हो सकता जब तक ASR खत्म न हो, और TTS तब तक शुरू नहीं हो सकता जब तक LLM टोकन न दे। इंसान ऐसे काम नहीं करते। सामने वाला जब बीच वाक्य में होता है, तब भी हम जवाब बनाना शुरू कर देते हैं, इसीलिए स्वाभाविक बातचीत में टर्न के बीच का औसत अंतराल लगभग 200 मिलीसेकंड होता है, जो इतनी तेज़ी है कि ज़्यादातर कैस्केडेड सिस्टम अपना ASR चरण भी पूरा नहीं कर पाते। एक फुल-डुप्लेक्स मॉडल, जो एक ही नेटवर्क में audio-in और audio-out को लगातार प्रोसेस करता है, पूरी कतार को ही दरकिनार कर देता है। यह रिले रेस और दो लोगों के सीधे बात करने के बीच का फर्क है।
फैसला: खारिज। कैस्केडेड पाइपलाइन पर लेटेंसी ट्यून करना गलत वेरिएबल को ऑप्टिमाइज़ करना है। आर्किटेक्चर खुद ही बॉटलनेक है।
मिथक 2: बातचीत में जो मायने रखता है, वह सब टेक्स्ट में आ जाता है
यह प्रयोग आज़माइए, जो मैंने Dessa टीम के लेख से उठाया है, क्योंकि मैंने इससे साफ उदाहरण कभी नहीं देखा। यह वाक्य ज़ोर से सात बार बोलिए, हर बार अलग शब्द पर ज़ोर देते हुए: "I didn't say she stole my CUDA code." टेक्स्ट एक जैसा है, पर सात बिल्कुल अलग मतलब निकलते हैं: आरोप से इनकार, किसी और पर इशारा, या क्रिया पर बहस। कोई भी टेक्स्ट-आधारित सिस्टम एक ही इनपुट देखता है। स्पीच-नेटिव मॉडल सात देखता है।
प्रोसोडी, यानी ज़ोर, पिच, लय और गति, भाषा पर चढ़ाई गई सजावट नहीं है। बोली जाने वाली बातचीत में यह भाषा का बड़ा हिस्सा ही है। वाक्य के बीच की हँसी वह संकेत नहीं देती जो वाक्य के बाद की हँसी देती है। बैकचैनल ("हाँ", "हम्म", "समझ गया") में कोई शाब्दिक अर्थ नहीं होता, फिर भी उनके बिना बातचीत दीवार से बात करने जैसी लगती है। अगर आपके सिस्टम का आंतरिक प्रतिनिधित्व टेक्स्ट है, तो आप पहले ही हार चुके हैं। जानकारी मॉडल में कभी प्रवेश ही नहीं करती, इसलिए आगे कितनी भी चतुराई उसे वापस नहीं ला सकती। यह UX पर लागू Nyquist theorem जैसा है: सिग्नल की बैंडविड्थ से कम सैंपलिंग करें तो aliasing स्थायी हो जाती है।
इसका एक असली सुरक्षा पहलू भी है, और यही तर्क मुझे सबसे प्रभावी लगता है। जो वॉइस असिस्टेंट "मुझे बहुत दर्द है" सपाट लहजे में सुनता है, वह उसी माध्यम में अनजान है जहाँ तात्कालिकता रहती है। Dessa टीम इसे साफ़ कहती है: जैसे-जैसे AI सिस्टम ज़्यादा स्वायत्त होते हैं, मानव वाणी की भावनात्मक सामग्री के प्रति अंधा होना सिर्फ UX की कमी नहीं, खतरा है। आप उनके मॉडल को समाधान मानें या न मानें, निदान सही है।
फैसला: खारिज, और यह कभी करीब भी नहीं था। टेक्स्ट स्पीच का एक प्रक्षेपण है, और हर प्रक्षेपण की तरह यह एक आयाम खो देता है।
मिथक 3: टर्न-टेकिंग बस voice-activity-detection की समस्या है
ज़्यादातर इंजीनियरों से पूछिए कि वॉइस असिस्टेंट को कैसे पता चलता है कि कब बोलना है, तो वे कहेंगे "endpointing": एक VAD मॉड्यूल N मिलीसेकंड खामोशी का इंतज़ार करता है, फिर काम आगे बढ़ा देता है। इसीलिए आपने जो भी वॉइस असिस्टेंट इस्तेमाल किया है, वह या तो आपके विचार के बीच में टोक देता है, या आपके खत्म करने के बाद बेचैन करने वाली चुप्पी में बैठा रहता है। "आपकी बारी है" का संकेत देने के लिए खामोशी एक बुरा प्रॉक्सी है। इंसान सोचने के लिए वाक्य के बीच रुकते हैं, न्योता देते हुए बात छोड़ते हैं, बात जारी रखनी हो तो तेज़ बोलते हैं, और बात छोड़नी हो तो धीमे पड़ जाते हैं। टर्न-टेकिंग प्रोसोडी, व्याकरण और संदर्भ के ज़रिए लगातार तय होती है। यह detect नहीं होती, predict होती है।
फुल-डुप्लेक्स मॉडल इसे पहली श्रेणी की मॉडलिंग समस्या मानते हैं। चूँकि वे एक साथ सुनते और बोलते हैं, वे इंसानी बातचीत के समय के असली वितरण को सीख सकते हैं: कब backchannel देना है, कब किसी की रुकी हुई बात पूरी करने के लिए बीच में कूदना है (एक Dessa डेमो में मॉडल वह फ़िल्म का नाम बताता है जो इंसान को याद नहीं आ रहा), और कब चुप रहना है। बाधा कोई त्रुटि-स्थिति नहीं है जिसे दबाया जाए; वह मॉडल किए जाने वाला संकेत है। यही पुनर्परिभाषा यहाँ असली योगदान है, किसी एक डेमो से ज़्यादा।
पर यहीं मैं हाइप से असहमत होना चाहूँगा, क्योंकि Hacker News के कमेंट करने वालों की बात में दम है: कई डेमो ज़रूरत से ज़्यादा उत्सुक लगते हैं। जब मॉडल इंसान का वाक्य खत्म होने से पहले हँस देता है, या एकालाप में जबरदस्ती घुस जाता है, तो लगता है कि उसने "बीच में टोकना = स्वाभाविक" कुछ ज़्यादा ही अच्छे से सीख लिया है। अनुमानित टर्न-टेकिंग जब पूरी तरह सही हो, तो अदृश्य रहती है। 80% सही हो, तो एक विनम्र आधे सेकंड की देरी से ज़्यादा चिढ़ाने वाली लगती है, क्योंकि खराब बीच-बाधा बदतमीज़ी जैसी लगती है, जबकि धीमा जवाब ऐसा नहीं लगता। बातचीत के समय के लिए uncanny valley असली है, और अब तक कोई उसे पूरी तरह पार नहीं कर पाया है।
फैसला: आधा खारिज। टर्न-टेकिंग सच में सीखने की समस्या है, threshold की नहीं। पर मौजूदा मॉडल इस तरीके के सही होने को जितना साबित करते हैं, उतना उसके हल हो जाने को नहीं।
मिथक 4: भाषा सीखने के लिए इंटरनेट-स्तर के टेक्स्ट डेटा की ज़रूरत है
यह सुनने में स्पष्ट लगता है: LLM खरबों टोकन खाते हैं, इसलिए भाषा को भी खरबों टोकन चाहिए। पर याद कीजिए कि आज तक जिस हर इंसान ने बोलना सीखा, उसने कुछ सालों के ऑडियो एक्सपोज़र से सीखा, बिना किसी टेक्स्ट के। बच्चे इसका जीता-जागता प्रमाण हैं कि डेटा की ज़रूरत LLM प्लेबुक के अनुमान से कहीं कम है। Dessa उस प्रयोग का मशीनी संस्करण है: शुरुआत से ट्रेन किया गया, कोई pretrained weights नहीं, बिल्कुल टेक्स्ट नहीं, सिर्फ़ रिकॉर्ड की गई इंसानी बातचीत पर। और टीम के दावों के अनुसार इसने एक सामान्य LLM कॉर्पस से सैकड़ों गुना कम शब्दों से भाषा सीखी।
ऑडियो को बेहतर ट्रेनिंग संकेत घोषित करने से पहले कुछ ईमानदार शर्तें। पहली, एक बोला गया शब्द अपने टेक्स्ट रूप से हज़ारों गुना ज़्यादा बाइट लेता है, और बोली गई बात कभी दोहराई नहीं जाती। एक ही वाक्य दो बार कहा जाए तो वह दो अलग डेटा हैं। तो "कम शब्द" का मतलब "कम बाइट" नहीं है; इसका मतलब है कम शब्द, जो इस बात का दावा है कि स्पीच हर शाब्दिक इकाई में कितनी जानकारी ले जाती है, स्टोरेज के अर्थ में डेटा दक्षता का नहीं। दूसरी, LLM कॉर्पस सिर्फ़ भाषा नहीं हैं। वे कोड, गणित, LaTeX और मानव ज्ञान का पूरा लिखित रिकॉर्ड हैं। सिर्फ़ स्पीच पर ट्रेन किया मॉडल अपने प्रशिक्षण आहार के हिसाब से चौंकाने वाला ज्ञान रखता है, लेकिन कोई उससे आपका pull request review करवाने नहीं जाएगा। यह उस व्यापक पैटर्न से जुड़ता है जिसे हम पहले भी कवर कर चुके हैं: बेंचमार्क और डेमो असली काम की मांगों का एक पतला हिस्सा ही पकड़ते हैं, और बातचीत का आकर्षण तर्क की गहराई से अलग क्षमता-अक्ष है।
यह नतीजा जो सच में स्थापित करता है, वह शोध के लिए वाकई दिलचस्प है: भाषा की संरचना सिर्फ़ ध्वनि से सीखी जा सकती है, जो हमें बताता है कि "भाषा" का कितना हिस्सा टेक्स्ट के नियमों में है और कितना खुद स्पीच में। इससे व्यावहारिक सवाल भी खुलते हैं: क्या स्पीच-नेटिव मॉडल ऐसी कम-संसाधन भाषाएँ उठा सकते हैं जिनमें ऑडियो तो है पर ट्रांसक्राइब्ड टेक्स्ट नहीं? यह ऐसा धागा है जिसे खींचना चाहिए, खासकर इसलिए कि कम-संसाधन भाषाओं पर काम अक्सर टेक्स्ट कॉर्पस की कमी से जूझता है।
फैसला: स्पीच-आधारित भाषा के लिए ज़्यादातर खारिज, जिसके साथ एक बड़ा डेटा सेंटर जितना बड़ा अपवाद जुड़ा है। सिर्फ़ स्पीच से सीखना काम करता है; बस वह टेक्स्ट-आधारित सीखने से अलग चीज़ को ऑप्टिमाइज़ करता है।
मिथक 5: वास्तविक आवाज़ का मतलब है स्मार्ट, या सुरक्षित, सिस्टम
यह वह मिथक है जिससे आपको सावधान रहना चाहिए, और कमेंट सेक्शन ने इसे तुरंत पहचान लिया: "यही तो impersonation के लिए है।" कठोर है, पर दिशा सही है। फ्लुएंसी और बुद्धिमत्ता अलग-अलग चीज़ें हैं, और स्पीच की फ्लुएंसी दोनों में ज़्यादा प्रभावशाली है। एक मॉडल जो आपकी सालगिरह की कहानी पर परफेक्ट भावुक टाइमिंग के साथ "ओह माय गॉड" कहता है, तकनीकी रूप से कमाल कर रहा है, पर इसका यह मतलब नहीं कि वह अच्छा तर्क करता है, तथ्य भरोसेमंद जानता है, या गर्म, सहानुभूतिपूर्ण आवाज़ में आत्मविश्वास से बातें गढ़ने से बचता है। उल्टा, अभिव्यंजक डिलीवरी उथले तर्क को छुपा सकती है, क्योंकि हम आत्मविश्वासी और भावनात्मक रूप से सजग वक्ताओं पर भरोसा करने के लिए बने हैं। ठगी की पूरी बुनियाद यही है।
खतरे का मॉडल खुद लिखा जाता है। voice cloning, फुल-डुप्लेक्स बातचीत की क्षमता, और नकली caller ID मिलकर एक धोखाधड़ी किट बनाते हैं जो उस सहज प्रवृत्ति को हरा देती है जिस पर ज़्यादातर लोग भरोसा करते हैं: "मुझे पता होता अगर वह वो नहीं होता।" एक कमेंटेटर का सुझाया उपाय अपनाने लायक है: किसी जाने-पहचाने व्यक्ति की संदिग्ध कॉल पर साझा याद से जुड़ा एक चुनौती सवाल पूछना। यह paranoid लगता है। पर यह आम प्रथा बनने वाला है। टीम की तारीफ़ बनती है कि वे व्यापक रिलीज़ से पहले सेफ्टी रिसर्चर्स को मॉडल जाँचने का खुला न्योता दे रही हैं, जो ज़्यादातर लैब नहीं करतीं। फिर भी, तकनीक खुद शाब्दिक अर्थ में dual-use है, और फ्रेमिंग कितनी भी बदल लें, यह तथ्य नहीं बदलता।
यहाँ एक लागत की कहानी भी छिपी है, जो दूसरी दिशा में, अच्छे मायने में जाती है। दावा है कि inference MacBook Pro M4 Max पर real time से तेज़ चलता है, और ट्रेनिंग एक single NVIDIA GB200 NVL72 सिस्टम पर फिट हुई। अगर ये आँकड़े सही निकले, तो यह उल्लेखनीय है: फ्रंटियर-स्तर का महसूस होने वाला बातचीत का AI जो hyperscale क्लस्टर के पीछे बंद नहीं है। लोकल inference निजता के लिए मायने रखता है (आपकी आवाज़ डिवाइस से बाहर नहीं जाती), लेटेंसी के लिए (duplex स्ट्रीम के बीच कोई नेटवर्क हॉप नहीं), और इस बात के लिए कि इस पर कौन निर्माण कर सकता है। छोटे सक्षम मॉडलों में दक्षता का रुझान वह है जिसे हमने flash-tier LLMs के साथ पहले भी चिह्नित किया है: inference की दिलचस्प गतिविधि तेज़ी से उस छोर पर जा रही है जहाँ "आपके अपने हार्डवेयर पर चलता है"।
फैसला: खारिज, और यह सूची का सबसे खतरनाक मिथक है। स्वर की यथार्थता को UI का गुण मानें, क्षमता या भरोसे का संकेत नहीं, और उसी हिसाब से अपनी निजी सुरक्षा आदतें बदलें।
इससे असल में क्या बदलता है
"अब तक का सबसे प्रामाणिक" वाले मार्केटिंग दावे हटा दें (इस शीर्षक को Hacker News पर मॉडरेट किया गया, इसकी कोई वजह रही होगी), तो भी जो बचता है वह महत्वपूर्ण है: एक end-to-end स्पीच मॉडल पाइपलाइन से मूलतः अलग चीज़ है, और ये फर्क जुड़ते जाते हैं। भावना लूप में बनी रहती है। टाइमिंग हाथ से ट्यून किए threshold की जगह सीखा हुआ व्यवहार बन जाती है। बीच में बोलना डेटा बन जाता है। इनमें से कुछ भी ASR को 50ms तेज़ बनाने से हासिल नहीं होता।
पुराने आर्किटेक्चर को शिप करने वाले के रूप में मेरा व्यावहारिक मत: कैस्केडेड पाइपलाइन मरी नहीं हैं। transactional voice interfaces के लिए, जैसे बैलेंस चेक करना, अपॉइंटमेंट बुक करना, डिवाइस नियंत्रित करना, वे ठीक हैं, debug करना आसान है, और हर चरण स्वतंत्र रूप से बदला जा सकता है। टेक्स्ट इंटरमीडिएट्स आपको लॉगिंग, redaction और policy enforcement मुफ्त में देते हैं, जो प्रोडक्शन में बेहद मायने रखता है। पर जहाँ बातचीत ही प्रोडक्ट है, जैसे ट्यूटरिंग, साथ, accessibility टूल्स, negotiation अभ्यास, वहाँ पाइपलाइन एक बंद गली है, और end-to-end ऑडियो ही वह आर्किटेक्चर है जो कभी स्वाभाविक महसूस करा सकता है। फैसला इस पर करें कि आपके यूज़र मशीन से बात कर रहे हैं या मशीन के ज़रिए।
खुले सवाल सबसे दिलचस्प हैं। जब context ऑडियो हो, तो in-context learning कितना अच्छा काम करता है? क्या ये मॉडल टेक्स्ट ट्रांसक्रिप्ट की बैसाखी के बिना लंबी बातचीत की स्थिति थाम सकते हैं? क्या भावनात्मक फ्लुएंसी विफलताओं को और नुकसानदेह बनाती है, क्योंकि यूज़र डिलीवरी पर भरोसा करते हैं? और असहज सवाल: एक बार इस स्तर की नकल किसी लैपटॉप पर लोकल चलने लगे, तो इंसानी पहचान का सत्यापन आखिर दिखेगा कैसा? जो लैब इन सवालों का ईमानदारी से जवाब देंगी, वे सबसे चमकदार डेमो रील वाली लैब से ज़्यादा मायने रखेंगी।
आवाज़ इंसान का सबसे पुराना इंटरफ़ेस है। हमने चालीस साल तक उसे टेक्स्ट के आकार के छेद में ठूँसा और फिर हैरान हुए कि यह गलत क्यों लगता है। पता चला, समस्या वह छेद ही था।


